AI 编程实时动态与要闻

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

AI 编程 Agent 公司 Factory 10 月 29 日 22:31(UTC)在 X 和官方博客发布 Droid 1.0,称这是其 agent harness 迄今最大的一次更新。核心变化是把程序化工具调用(PTC)设为默认:模型写一段 JavaScript 脚本,在沙箱里一次跑完多达上百次工具调用。官方自测 Terminal-Bench 4 中,用 GPT-6.1 Sol 通过率 57.6%(每个通过任务 $0.79),用 Claude Opus 5.5 通过率 65.2%($4.73),均高于同模型下的 Codex、Claude Code、Cursor、OpenCode 和 Devin。

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

核心要点速览

  • 程序化工具调用成默认:模型写 JavaScript 脚本,在无文件/网络/系统权限的沙箱里运行,一次请求可跑上百次工具调用,互不依赖的调用并发执行
  • 官方示例:移动并核对 151 个 Linear issue 需 312 次工具调用,直接调用约 36 次请求、310 万输入 token,用 Script 只需 2 次请求、6.1 万 token
  • Terminal-Bench 4(Factory 自测,10 月 23–28 日,每任务 3 次):GPT-6.1 Sol 下 Droid 57.6% 对 Codex 54.0%、OpenCode 51.0%、Devin 45.0%;Opus 5.5 下 Droid 65.2% 对 Cursor/OpenCode 62.1%、Devin 59.6%、Claude Code 57.6%
  • 首轮请求从 20,887 降到 13,055 token(-37%),开局工具定义从 11 个减到 2 个;新加载的 MCP 工具追加到请求末尾,不破坏 prompt cache,生产中典型请求 98% 输入命中缓存
  • 已上线:macOS/Windows 桌面版、终端 TUI,以及 Droid SDK(@factory/droid-sdk);跑分为厂商自测,尚无第三方复现
阅读全文

告别昂贵试错!NVIDIA 与 UC 伯克利提出基座模型预测法:三道门禁先验锚定 Coding Agent 强化学习潜力

对大语言模型进行代码智能体后训练(Agentic Post-Training,包括昂贵的多轮强化学习与监督微调)通常需要消耗数百万美元的 GPU 算力。然而,AI 实验室长期面临一个核心痛点:在启动昂贵的后训练之前,如何预先判断哪一个预训练基座模型(Base Checkpoint)真正具备演化为顶尖 Coding Agent 的潜力?由于基座模型缺乏工具调用规范格式,直接在 SWE-bench 上进行零样本冷启动往往因为语法格式错误而得到几乎为零的分数,无法体现真实代码理解潜力;而单轮合成补丁测试又完全无法反映模型在长程动态工程交互中的状态维持能力。来自 NVIDIA 研究院(包括 Bryan Catanzaro、Ashish Vaswani 等知名学者)与 UC 伯克利的研究团队在最新成果(arXiv:2610.10478)中提出了破局方案:将训练好的优秀 Agent 的成功执行轨迹作为前瞻信号,通过在测试沙箱中回放每一步代码变更,精准定位使代码库‘从失败翻转为测试通过’的关键决定步(Decisive Step)。团队围绕该决定步构建了三道轻量门禁:决定动作字节困惑度(Decisive-Action BPB)、补丁多选题测试(Patch MCQ)以及前缀条件 pass@K。在涵盖 10 对公开基座与后训练模型的实测中,三道门禁的排名与最终模型在 SWE-bench Verified 上的表现呈现极其精确的强一致性,为大模型选型与后训练节约了数百万美元的盲目试错成本。

核心要点速览

  • NVIDIA 与 UC 伯克利提出基座模型潜力预测法,在启动后训练前先验锚定 Coding Agent 强化学习天花板
  • 通过轨迹回放定位测试翻转的关键‘决定性步’,首创 Decisive-Action BPB、Patch MCQ 与条件 pass@K 三道轻量门禁
  • 在 10 对基座与后训练模型中精准预测 SWE-bench Verified 最终排名,节省数百万美元盲目试错算力
阅读全文
关联模型 / 智能体 / 厂商:

Aleph Alpha 开源 Kolibri-1:78B MoE / 3.46B 激活,德英主权开源权重 Apache-2.0;SWE-Verified 66.4

德国 Aleph Alpha 于 2026-10-03(统一日)发布开源权重 Kolibri / Kolibri-1(HF,Apache-2.0):78B 总参、约 3.46B 激活的德英 MoE,原生上下文 262k(外推至 1M),带 reasoning 档位与 tool calling。官方同卡:LiveCodeBench v6 85.9、SWE-Bench Verified 66.4、TerminalBench 2.1 27.7。用 aleph-alpha-inference + vLLM 自托管。

Aleph Alpha 开源 Kolibri-1:78B MoE / 3.46B 激活,德英主权开源权重 Apache-2.0;SWE-Verified 66.4

核心要点速览

  • 发布:2026-10-03;权重 Aleph-Alpha/Kolibri-1 Apache-2.0;博文 aleph-alpha.com
  • 规模:78B 总参 / ~3.46B 激活;FP8 约 78GB;原生 262k 上下文,验证至 1M
  • 编码硬指标(官方卡):LiveCodeBench v6 85.9 · SWE-Bench Verified 66.4 · TerminalBench 2.1 27.7 · HumanEval+ 92.7
  • 推理:none/low/medium/high + Hermes tool calling;pip install 'aleph-alpha-inference>=1' → vllm serve Aleph-Alpha/Kolibri-1
  • 定位:德英主权/受监管自托管;Terminal-Bench 非榜首,勿与闭源 coding 王牌直接等价
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kolibri-1⚡ Kolibri⚡ Kolibri Origin🌐 Aleph Alpha

多目标强化学习重大升级!香港科大开源 CorrGRPO:皮尔逊相关性归一化破解奖励失衡,代码与工具调用全面领先

群体相对策略优化(GRPO)作为 DeepSeek-R1 等顶尖推理模型的底层强化学习算法基石,通过在同 Prompt 的多次 Rollout 中对奖励进行去中心化与方差归一化来估算优势函数。然而在工业级实战中,智能体通常需要兼顾代码正确性、格式合规度、工具调用精准性及内容安全性等多重奖励目标(Multi-Reward)。传统 GRPO 简单累加各项奖励并按总方差归一化,导致高量纲、强相关的宏观奖励彻底压制并淹没小量纲但至关重要的精细奖励信号。香港科技大学(HKUST)团队提出 CorrGRPO(相关性归一化 GRPO),利用皮尔逊相关系数对奖励协方差矩阵进行平衡解耦,在保持中心化总奖励不变的同时,彻底消除大尺度奖励项的垄断效应。在代码生成、工具调用与 Agent 安全三大基准的大量实验中,CorrGRPO 均显著超越标准 GRPO 及现有变体方案。

多目标强化学习重大升级!香港科大开源 CorrGRPO:皮尔逊相关性归一化破解奖励失衡,代码与工具调用全面领先

核心要点速览

  • 针对 DeepSeek-R1 式 GRPO 算法在多奖励联合优化时的尺度失衡缺陷,提出基于皮尔逊相关系数的归一化方案
  • 在代码生成与单元测试强化对齐中,Pass@1 准确率较传统 GRPO 全面领先 3.2~4.8 个百分点
  • 完美兼顾性能与安全,在多步工具调用成功率提升 5.4% 的同时将越狱攻击防御率从 82.1% 推升至 93.7%
阅读全文
AD赞助内容

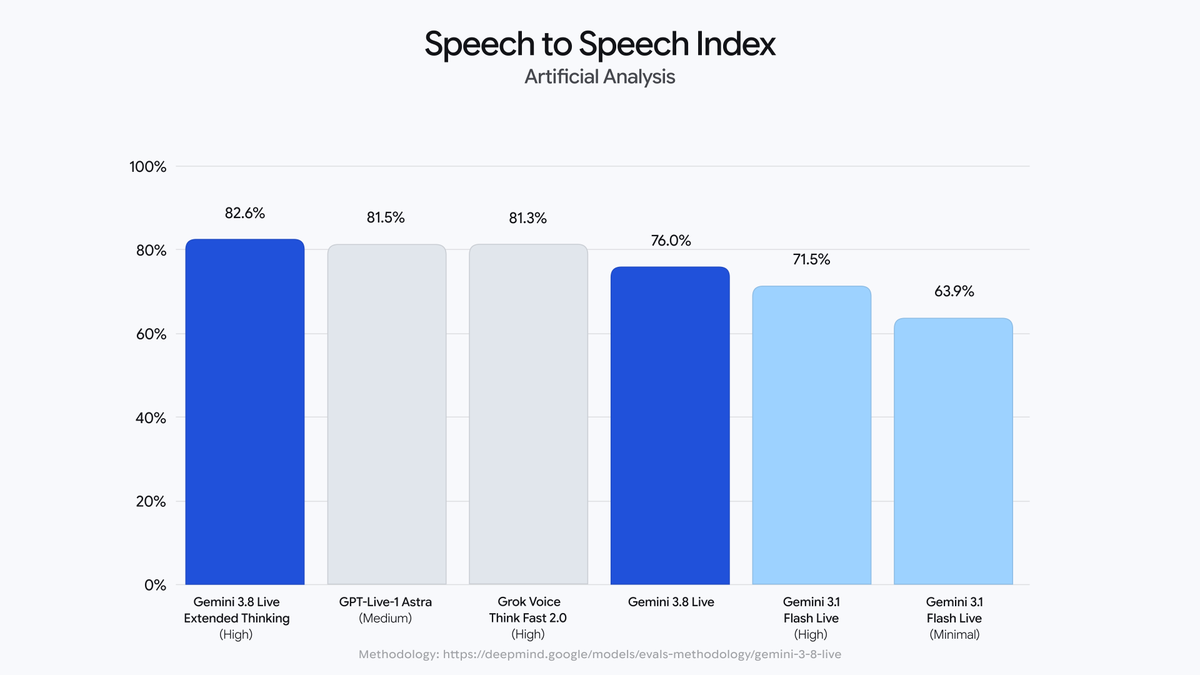
Google DeepMind 推出 Gemini 3.8 Live 与 Extended Thinking

Google DeepMind 发布 Gemini 3.8 Live 与 3.8 Live Extended Thinking,称为其最强对话式 AI。两款模型具备升级推理、近实时视觉理解、自动检测 97 种语言,以及不打断对话的后台工具调用。Extended Thinking 可叙述任务进度;现已在 Gemini App 的 Gemini Live 与 Google AI Studio 的 Gemini API 中提供。

Google DeepMind 推出 Gemini 3.8 Live 与 Extended Thinking

核心要点速览

  • Google DeepMind 发布 Gemini 3.8 Live 与 3.8 Live Extended Thinking,称为其最强对话式 AI。两款模型具备升级推理、近实时视觉理解、自动检测 97 种语言,以及不打断对话的后台工具调用。Extended Thinking 可叙述任务进度;现已在 Gemini App 的 Gemini Live 与 Google AI Studio 的 Gemini API 中提供。
阅读全文
关联模型 / 智能体 / 厂商:

OpenRouter 上线 Ling 3.0 Flash VL:124B MoE(5.5B 激活)支持图视频与视觉智能体

OpenRouter 宣布 Ling 3.0 Flash VL 上线(由 novita_labs 提供),为 124B MoE、约 5.5B 激活参数的开源档模型,原生支持图像与视频输入,并具备视觉智能体能力;提供即时与推理混合模式及工具调用,目前有免费路由。

核心要点速览

  • Ling 3.0 Flash VL 在 OpenRouter 上线,含免费档路由。
  • 124B MoE / 5.5B 激活,原生图视频输入与视觉智能体。
  • 支持混合即时/推理模式与 tool calling。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ling 3.0 Flash Vl🌐 openrouter🌐 ant-group

OpenAI:GPT-Live-1 上线 API——全双工语音智能体可边听边说,自选模型与 harness

OpenAI 开发者账号宣布 GPT-Live-1 已在 API 可用:把 ChatGPT 的自然来回对话带进应用,语音智能体可在说话时继续聆听,并搭配你选择的模型与 harness。OpenAI 工程师 Tibo 亦确认可基于同一套已服务约 10 亿 ChatGPT 用户的语音系统做全双工工具调用应用。

核心要点速览

  • GPT-Live-1 已在 OpenAI API 上线,面向可打断的全双工语音智能体。
  • 支持边听边说,并可自选底层模型与 harness。
  • 与 ChatGPT 同款语音栈对齐,适合工具调用型语音应用。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT Live 1🌐 OpenAI

vLLM:稳定版 Day-0 支持 MiniCPM5-2B,含 131K 上下文、Think/No-Think 与工具调用

vLLM(@vllm_project)宣布稳定版 Day-0 支持 OpenBMB MiniCPM5-2B:2.6B 稠密模型原生 131K 上下文,同 checkpoint 支持 Think / No-Think,并通过 vLLM 的 minicpm5 parser 提供工具调用;模型基于 stock LlamaForCausalLM,并开放训练数据。

核心要点速览

  • 引擎:稳定版 vLLM Day-0 接入 MiniCPM5-2B。
  • 能力:131K 原生上下文;同 checkpoint Think/No-Think;minicpm5 parser 工具调用。
  • 生态:stock LlamaForCausalLM 架构,权重与训练数据一并开放。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Openbmb Minicpm5 2b🌐 vllm🌐 openbmb