
AI 编程实时动态与要闻

LiberAI 发布机器人世界动作模型 Liber-0:用 220 万小时人类经验预训练,60 项零样本操作任务总成功率 36%

机器人公司 LiberAI 在官方 X 账号和技术博客发布 Liber-0,一个同时预测未来画面和动作的世界动作模型(World Action Model),用超过 220 万小时人类经验预训练,并用自研 LiberSense 手套采集的精确手部动作数据做“动作锚点”。在 GPT-6 随机提出的 60 项任务、600 次试验中,Liber-0 在没有针对这些任务采集机器人示范的情况下总成功率 36.0%,其中复杂多步任务仅 10.5%。官方未公布开源权重或 API。
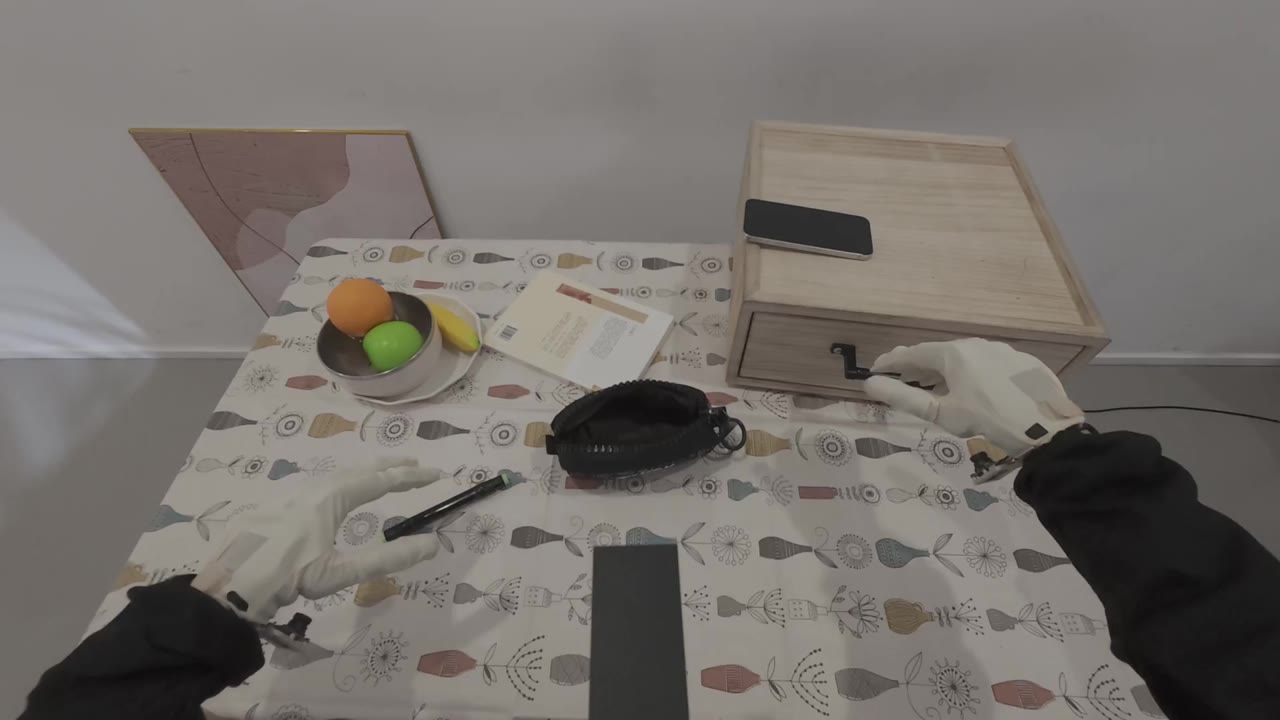
LiberAI 发布机器人世界动作模型 Liber-0:用 220 万小时人类经验预训练,60 项零样本操作任务总成功率 36%

核心要点速览

  • 零样本成绩:抓取放置 63.5%、短程非抓取操作 34.0%、复杂多步任务 10.5%,总计 36.0%(60 项任务 × 10 次)
  • 对照:把 GPT-6 Astra 单独当机器人策略,同一套任务三类成功率只有 8.3%、5.0%、1.7%,平均每步推理 87.3 秒
  • 手套数据 10k 小时的效果超过 200 倍时长(2,000k 小时)的网络人类视频,说明“有精确动作标注”比单纯堆视频更关键
  • 手套数据配合 25% 机器人示范,进度分 75.6,超过用全部机器人示范的 72.8,即少用 75% 机器人数据
  • 所有数字均为 LiberAI 自报的内部评测;官方未公布开源权重、API 或商用时间
阅读全文
关联模型 / 智能体 / 厂商:

前 NVIDIA 团队 Dream Labs 带 9000 万美元种子轮出隐身,发布机器人基础模型 Dream-1:零样本控制没见过的双臂机器人,API 每小时 3 美元起

Dream Labs 10 月 19 日宣布出隐身并完成 9000 万美元种子轮,同时上线 Dream-1 公开 API。Dream-1 是一个「世界动作模型」(WAM),把视频预测和动作预测放在一起学,官方称无需该机器人的任何演示数据,就能零样本控制带平行夹爪的双臂机器人,在仿真中跑通 27 款没见过的机型,包括 18 年前的 PR2。定价 Dream-1 每小时 3 美元、Dream-1-flash 每小时 2 美元。第三方 Robocurve 的独立评测里,Dream-1 在 RoboDojo-RC Tier 1 得 59 分,此前最佳为 48 分。官方强调仍是研究测试版,未做安全关键场景验证。

前 NVIDIA 团队 Dream Labs 带 9000 万美元种子轮出隐身,发布机器人基础模型 Dream-1:零样本控制没见过的双臂机器人,API 每小时 3 美元起

核心要点速览

  • 融资与团队:9000 万美元种子轮;创始成员 2026 年 2 月在 NVIDIA 时发表 DreamZero 论文,提出世界动作模型(WAM)。
  • 定价:Dream-1 每小时 3 美元,Dream-1-flash 每小时 2 美元;每次调用返回 1.6 秒动作,每小时约 2250 次调用,约合每次 0.0013 美元(官方口径)。
  • 泛化:仿真中零样本控制 27 款未见过的双臂机型(含 PR2);12 个站点、8 个国家的测试者跑过真机任务。
  • 跑分:Robocurve 独立评测 RoboDojo-RC Tier 1 得 59 分(此前最佳 48),单次任务成本比 Gemini 4 Argon 低 16 倍,速度比 GPT-6 Astra 快 1.7 倍;120 次运行记录全部公开。
  • 局限:输出末端执行器位姿,依赖各机器人的 IK 求解器;差异大的机型可通过微调服务 FaaS 用少量自有数据适配。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dream-1⚡ Dream-1-flash⚡ DreamZero🌐 Dream Labs🌐 Robocurve🌐 NVIDIA

告别像素重构幻觉!首个隐空间 GUI 世界动作模型发布:延迟暴降 98.9%,在线任务成功率狂飙 40.6%

近期兴起的像素级世界模型(Pixel-space World Models)试图通过预测执行后的未来屏幕画面再反向选动作,但在 GUI 环境中面临双重困境:全屏像素重构计算成本极高,且极易触发“恒等捷径”(Identity Shortcut,即预测画面倾向于维持原样而非体现动作引发的变化)。KAIST 等团队提出首个专为 GUI 智能体打造的隐空间世界动作模型(Latent World Action Model):将预测目标从全屏像素渲染转移至动作引发的隐空间动态转移,引入动作选择与预测转移双头架构及动作感知对比学习。实验显示,在线任务成功率暴增 40.6%,同时将推理延迟大幅压缩了 98.9%。

告别像素重构幻觉!首个隐空间 GUI 世界动作模型发布:延迟暴降 98.9%,在线任务成功率狂飙 40.6%

核心要点速览

  • 破除全屏重构开销与恒等捷径:将未来状态建模从高成本、易抄袭前帧的像素图像生成,重构为轻量级隐空间动态转移预测
  • 解耦双头与动作对比学习:利用多模态大模型基座支撑动作选择与未来转移双预测头,引入对比损失强迫模型捕获动作诱发的细粒度变化
  • 速度与成功率双重飞跃:离线与在线 GUI 任务成功率分别提升 31.9% 与 40.6%,推理延迟断崖式缩减 98.9%,满足实时操作需求
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Latent-WAM⚡ Pixel-World-Model⚡ Claude 3.5 Computer Use🤖 GUI Agents🤖 Desktop OS Agents🌐 KAIST🌐 Yonsei University

具身智能视觉世界模型突破!Meta FAIR 与上交发布 ProWAM:渐进稀疏子目标规划,真机操控胜率跃升至 70%

世界动作模型(World Action Models, WAMs)通过从初始观察与指令中联合预测未来的视觉动态与动作流,被视为具身机器人自主操控的核心发展路径。然而现有 WAM 架构在面对长程复杂任务时面临难以克服的算力瓶颈:逐帧自回归生成稠密视频不仅计算极度昂贵且误差累积严重,而若简单退化为仅预测单一终态帧,又完全丧失了朝向目标渐进推进的中间视觉指导。Meta FAIR 联合上海交通大学团队提出了前沿渐进式世界动作模型 ProWAM(arXiv:2610.02508):核心创新在于联合预测动作以及一组按序排列的“稀疏视觉子目标(Sparse Visual Sub-goals)”,为任务全生命周期的动作生成提供精准锚定的时空视觉脚手架。该架构通过单次前向传播将视频主干提炼的稀疏子目标特征进行高效缓存,彻底终结了重规划时重复生成完整视频的笨重开销,仅需轻量级动作去噪即可完成闭环控制。在仿真基准测试中,ProWAM 在 LIBERO-Plus 上斩获 85.8% 胜率(相对提升高达 +35.9%),在随机化 RoboTwin 上取得 75.7% 胜率,在 RoboCasa365 的 Composite-Unseen 挑战集上名列前茅;尤为关键的是,在零样本真实物理机械臂操作中,ProWAM 在陌生全新场景下达成 70.0% 的超高成功率,相对业界最强基线提升 27.3%。

具身智能视觉世界模型突破!Meta FAIR 与上交发布 ProWAM:渐进稀疏子目标规划,真机操控胜率跃升至 70%

核心要点速览

  • 提出渐进式世界动作模型 ProWAM,以有序稀疏视觉子目标(Sub-Goals)取代传统臃肿的密集视频生成
  • 单次前向传播缓存子目标高维特征,闭环重规划仅需轻量动作去噪,兼顾宏观视觉远见与毫秒级控制响应
  • LIBERO-Plus 仿真胜率达 85.8%(相对暴涨 +35.9%),真实物理机械臂零样本操控胜率从 55% 跃升至 70%
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

上海人工智能实验室开源 InternW0-Δ:首个 2 万小时跨模态机器人世界动作模型,Causal Imprint 彻底免除推理视频展开

上海人工智能实验室与 OpenDataLab 正式开源统一世界动作模型(WAM)InternW0-Δ。基于开源界规模最大的 2 万小时具身异构语料库,模型采用 Mixture-of-Transformers(MoT)架构联合视频专家与动作专家协同建模。首创“因果印记”(Causal Imprint)机制,仅凭训练期未来监督即可将动态预测表征直接注入动作网络,在推理时彻底摒弃耗时数秒的未来视频渲染展开,实机泛化表现大幅超越既有具身模型。

上海人工智能实验室开源 InternW0-Δ:首个 2 万小时跨模态机器人世界动作模型,Causal Imprint 彻底免除推理视频展开

核心要点速览

  • 2 万小时最大开源具身数据集:清洗并对齐涵盖机械臂实操、UMI 手持采集、人眼第一视角及 Ego2Robot 的 20,000+ 小时异构数据,建立统一状态-动作表征空间。
  • MoT 异构多专家协同:在冻结 VLM 的语义指引下,让视频生成专家与动作预测专家在统一注意力空间内协同计算,通过训练期几何蒸馏注入 4D 空间先验。
  • Causal Imprint 零延迟免展开:攻克传统世界动作模型在推理部署时必须花费数秒生成未来视频帧的落地死结,将未来场景变化因果压缩为隐状态直接供给动作执行,实现毫秒级端侧控制闭环。
阅读全文
关联模型 / 智能体 / 厂商:

机器人双臂协同突破:开源 DeltaWAM 差量世界动作模型,推理延迟降低 36.6% 成功率跃升

机器人具身智能联合研究团队正式发布并开源了差量世界动作模型 DeltaWAM 与流式差量记忆机制 SDM(arXiv: 2609.28811,项目主页: aigeeksgroup.github.io/DeltaWAM/)。针对现有基于预训练视频生成模型的世界动作模型(WAMs)在训练和推演时盲目预测全尺寸密集未来帧、导致大量未变化背景吞噬算力且视频大模型严重拖慢动作生成延迟的痛点,DeltaWAM 首创“稠密锚点 + 稀疏视觉差量(Visual Deltas)+ 动作流”解耦架构,单步推演延迟暴降 36.57%,在双臂协同操作权威基准 RoboTwin 上取得 85.4% 的超高成功率。

机器人双臂协同突破:开源 DeltaWAM 差量世界动作模型,推理延迟降低 36.6% 成功率跃升

核心要点速览

  • 打破传统机器人世界模型全尺寸密集逐帧预测的算力陷阱,首创视觉差量(Delta)与动作联合推演。
  • 提出流式差量记忆(SDM),仅用紧凑观测差量增量更新缓存锚点,彻底释放重型视频专家模型的推理瓶颈。
  • 训练 FLOPs 降低 17.8% 至 23.8%,单步动作生成推演延迟与计算量分别大幅减少 36.57% 与 31.55%。
  • 在权威双臂机器人基准 RoboTwin 实测中,常规场景成功率达 85.4%,高随机视觉扰动下成功率达到 83.9%。
  • 真实物理机械臂评估展现出业界顶级的操作平滑度,完整 PyTorch 代码与仿真基准已全量开源。
阅读全文
关联模型 / 智能体 / 厂商: