
机器人公司 LiberAI 在官方 X 账号和技术博客发布 Liber-0,一个同时预测未来画面和动作的世界动作模型(World Action Model),用超过 220 万小时人类经验预训练,并用自研 LiberSense 手套采集的精确手部动作数据做“动作锚点”。在 GPT-6 随机提出的 60 项任务、600 次试验中,Liber-0 在没有针对这些任务采集机器人示范的情况下总成功率 36.0%,其中复杂多步任务仅 10.5%。官方未公布开源权重或 API。
核心要点速览
- ✓零样本成绩:抓取放置 63.5%、短程非抓取操作 34.0%、复杂多步任务 10.5%,总计 36.0%(60 项任务 × 10 次)
- ✓对照:把 GPT-6 Astra 单独当机器人策略,同一套任务三类成功率只有 8.3%、5.0%、1.7%,平均每步推理 87.3 秒
- ✓手套数据 10k 小时的效果超过 200 倍时长(2,000k 小时)的网络人类视频,说明“有精确动作标注”比单纯堆视频更关键
- ✓手套数据配合 25% 机器人示范,进度分 75.6,超过用全部机器人示范的 72.8,即少用 75% 机器人数据
- ✓所有数字均为 LiberAI 自报的内部评测;官方未公布开源权重、API 或商用时间
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
机器人操作长期依赖为特定机器人、特定任务专门采集的遥操作示范,成本高、难扩展。人类视频虽然海量,但存在三道鸿沟:人和机器人身体结构不同;从视频估算的手部动作噪声大;人和机器人的摄像机视角也不一样。LiberAI 11 月 4 日发布的 Liber-0 就是想把大规模人类经验直接变成可执行的机器人技能。
架构亮点与底层机制
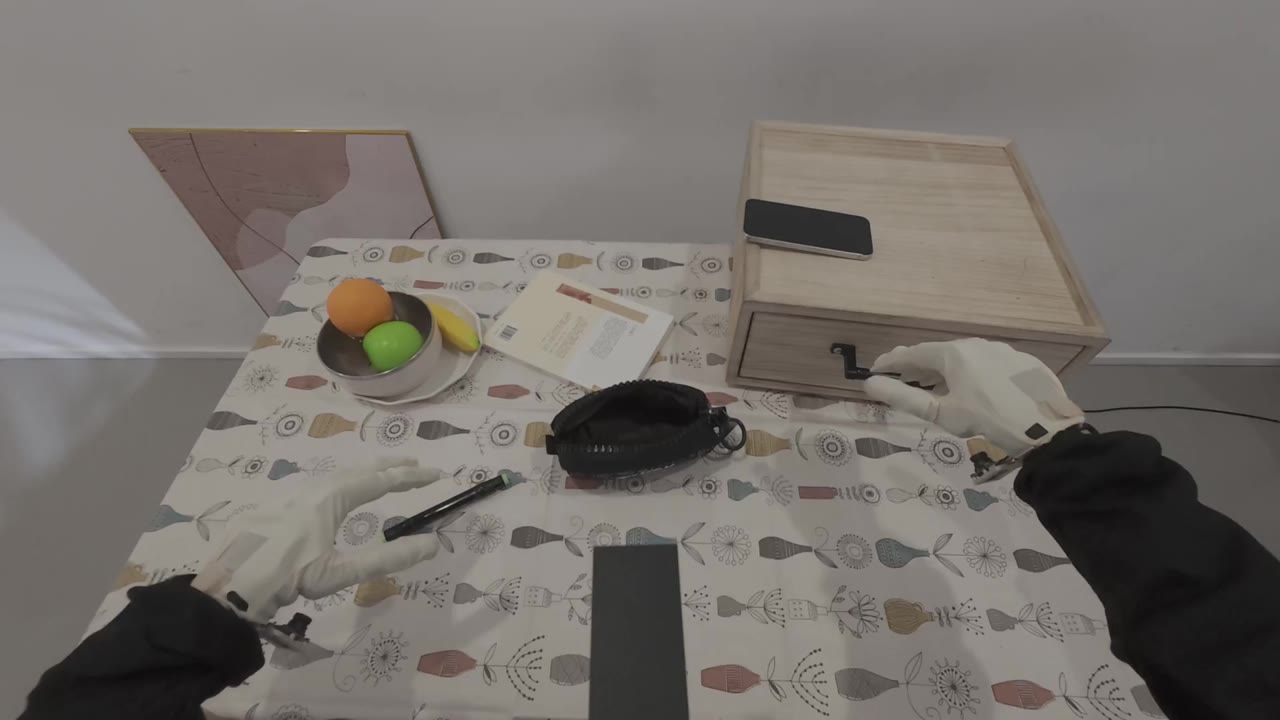
Liber-0 是世界动作模型,用 Mixture-of-Transformers 架构,让语言、视觉、动作三个专家共同预测未来画面和动作,并用“统一身体表示”把人和机器人的形态、运动学编码到同一空间。数据端用 0.3 毫米厚、131 克的 LiberSense 手套记录精确手指动作,配合第一人称和腕部相机;硬件端自研 LEO 机器人,手腕三自由度、可弯腰,视角与人类采集对齐。预训练分三段:先学通用视觉预测,再联合学画面和动作,最后加大手套和遥操作数据权重。
权威 Benchmark 与实测跑分对比
以下均为官方博客自报。GPT-6 提出的 60 项零样本任务共 600 次试验,总成功率 36.0%,多步任务 10.5%;GPT-6 Astra 单独做策略在同类任务上仅 8.3%/5.0%/1.7%。内部进度分基准上,完整配方经机器人后训练后抓取放置 83.6、非抓取 73.8。演示者从 1 人增加到 100 人(数据量不变),进度分从 60.6 升到 69.5。
开发者实战落地与开箱指南
目前只有技术博客和演示视频,官方未公布开源权重、API 或价格,开发者暂时无法直接调用。博客提到可对接 GPT-6 Astra 这类推理 Agent 规划多步任务的中间目标,并提供一个在线仿真应用,可上传自定义物体观察操作效果。做具身智能的团队更值得关注的是它的数据思路:用低成本手套规模化采集人类示范,减少对机器人遥操作数据的依赖。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察