
vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。
核心要点速览
- ✓NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
- ✓在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
- ✓在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
当开源与前沿混合专家(MoE)大模型迈入万亿参数时代——例如月之暗面(Moonshot AI)的旗舰模型 Kimi K3(据 SemiAnalysis 披露总参数量高达 2.8 万亿 / 2.8T)——在最新一代 NVIDIA GB300 NVL72 机柜级超节点上进行低延迟流式解码(Decode)时,系统瓶颈发生了根本性转移。在小批量(Low-Batch)与高交互速率(Interactivity)的 Coding Agent 场景下,GPU 算力往往并未跑满,真正的性能杀手是每一层 Transformer 中高達 23 次的细碎 CUDA 内核启动(Kernel Launches)开销,以及注意力(Attention)、MoE 专家计算与跨卡 NVLink 全互连通信(Communication)之间的同步气泡。
架构亮点与底层机制
今日 vLLM (@vllm_project) 联合 NVIDIA 正式发布由 NVIDIA CentML 核心工程师 Benjamin Chislett 主导编写的 Kimi K3 统一 CuTe DSL 解码巨型内核(Decode Megakernel),并获 SemiAnalysis (@SemiAnalysis_) 深度拆解报道:
- 12,000 行
CuTe DSL激进巨型内核融合(Aggressive Megakernel Fusion):利用 NVIDIA CUTLASS 生态的高阶CuTe DSL,将原本割裂的注意力算子、MoE 门控与专家矩阵乘(GEMM)以及跨卡 NVLink 通信原语(All-to-All / All-Reduce)激进融合进统一的持久化解码路径中。 - 单层内核数锐减 43%、单层耗时砍半:在
vLLM标准解码管线中,Kimi K3每执行一层需要启动 23 个独立 CUDA 内核、耗时 130 µs;经过 CuTe DSL 巨型内核重构后,每层仅需 13 个内核,单层耗时骤降至 69 µs(延迟削减高达 46.9%),彻底释放了GB300 NVL72的高带宽显存与 NVLink 域潜能。 - 全面兼容
DSpark投机解码与长上下文正确性校验:该融合路径不仅完整通过了严苛的数值正确性与超长上下文精度对齐测试,更与vLLM内置的DSpark投机解码(Speculative Decoding)框架无缝叠加,同时官方透露针对 DeepSeek-V4.1-Flash(vLLM PR #61868) 与 GLM-5.3 的同类巨型内核移植已在推进中。
权威 Benchmark 与实测跑分对比
根据 vLLM 官方技术博客与 SemiAnalysis 公布的 NVIDIA GB300 NVL72 实测数据:
- 单并发(Batch=1)配合 DSpark 投机解码飙至 842 tok/s:在 16 张
GB300GPU 上开启DSpark时,单请求生成速度从原版vLLM的488 tokens/s暴涨至 842 tokens/s(提速 1.73 倍)。 - 纯自回归解码(无投机)全批次加速:在
Batch=1(无投机)下,8 卡GB300吞吐达 193.3 tok/s(提速 1.58 倍),16 卡达 256.4 tok/s(提速 1.88 倍);在高并发Batch=64下,8 卡总吞吐达 2,375.9 tok/s(提速 1.31 倍),16 卡高达 3,606.1 tok/s(提速 1.62 倍)。 - SemiAnalysis AgentX 交互速率暴涨 1.8 倍:在模拟真实多轮编码与工具调用的 SemiAnalysis AgentX 负载上,
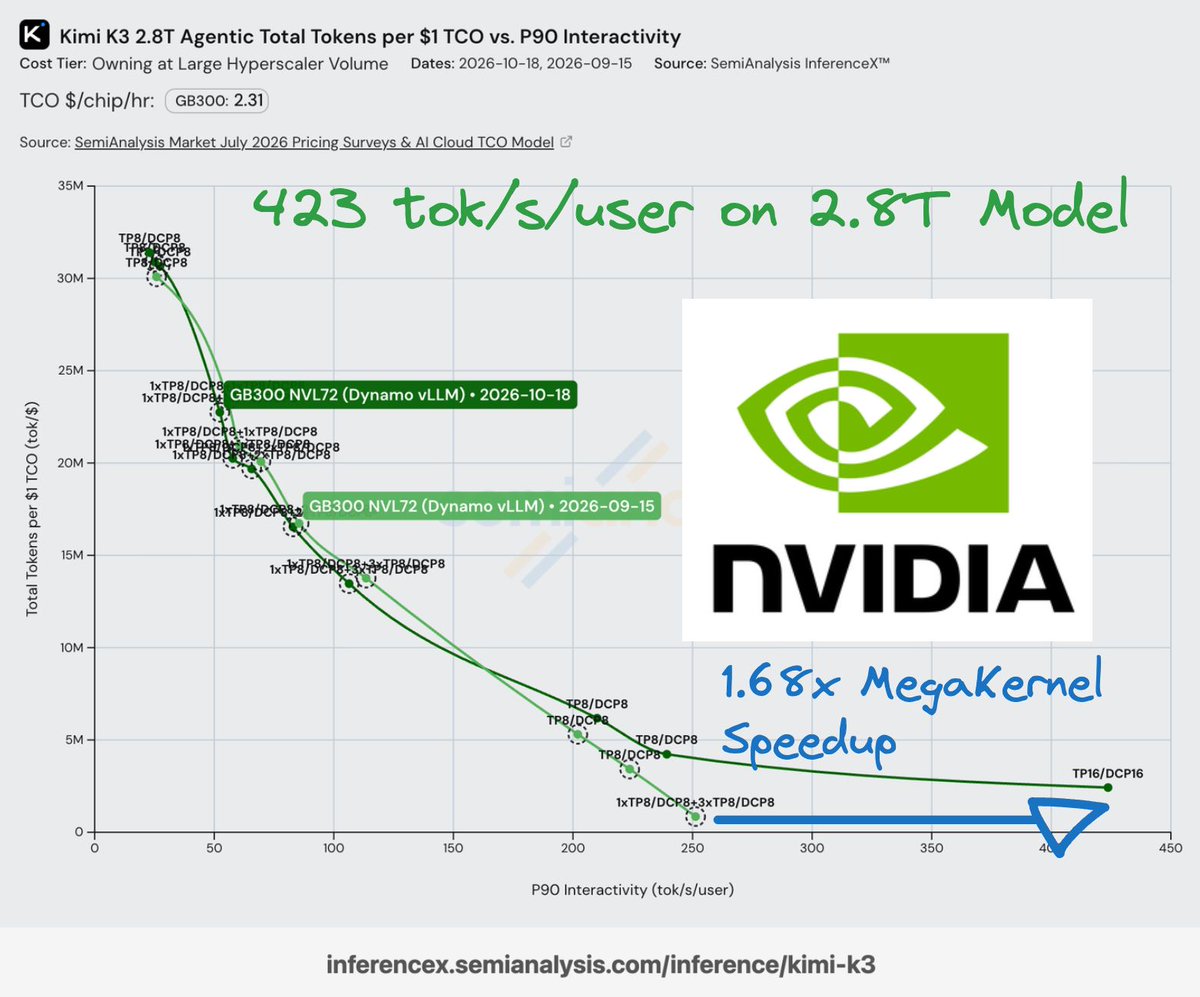
vLLM官方 16 卡实测将 P90 单用户交互吞吐(P90 Interactivity)从 223.7 tok/s/user 拉升至 403.2 tok/s/user(最高达 1.8 倍跃升);SemiAnalysis独立实测更记录到在相同硬件配置下跑出 423 tok/s/user(1.68 倍同硬件加速) 的惊人交互体验。
开发者实战落地与开箱指南
该 CuTe DSL 巨型内核优化已作为上游特性直接合入 vLLM 主干。拥有 NVIDIA GB200 / GB300 NVL72 机柜集群的云厂商与企业 Infra 团队,可直接参考 vLLM 官方技术报告(https://vllm.ai/blog/2026-10-16-kimi-k3-megakernel)拉取最新源码并启用 DSpark 投机解码部署 Kimi K3,同时可关注 vLLM PR #61868 跟踪即将落地的 DeepSeek-V4.1-Flash 与 GLM-5.3 融合内核支持。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察