

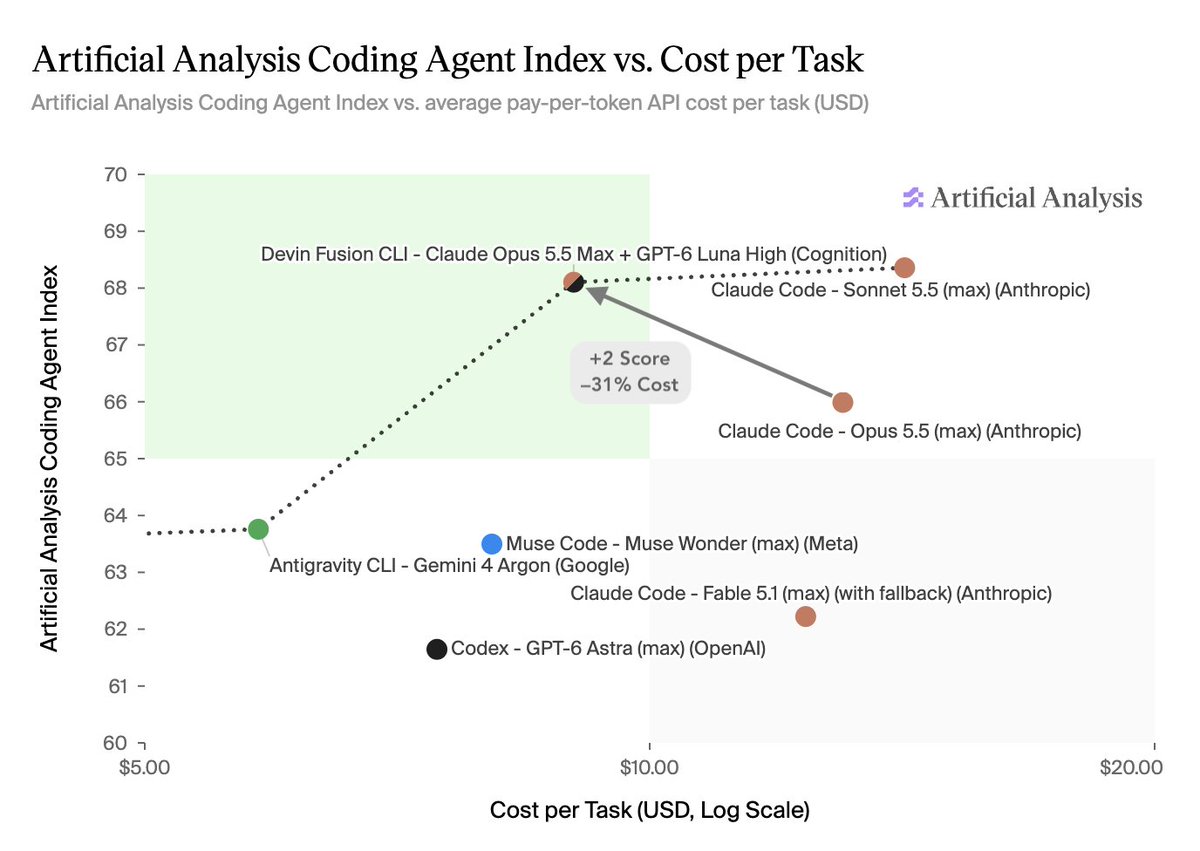
Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。
核心要点速览
- ✓总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
- ✓与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
- ✓成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
- ✓此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
- ✓官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
开发者 3 秒速决决策指标
Claude Code 高频使用:比较订阅额度与 API 账单
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
编码智能体的账单越来越贵:前沿模型能力强,但长任务里大量 token 花在读代码、跑测试这类不需要顶级智能的步骤上。简单的「按难度路由」又有两个问题:任务难不难往往要读完代码才知道,中途换模型还会打断提示词缓存。Cognition 的 Fusion 就是为此设计的双模型框架,9 月 11 日上线,10 月 19 日更新了 Artificial Analysis 成绩。
架构亮点与底层机制
Fusion 同时运行两个各自保有上下文和工具的智能体。主控(lead)用前沿模型,负责规划、处理歧义和审查;执行助手(sidekick)用更便宜的模型,按主控给出的任务说明去读代码、改代码、跑测试再汇报。两者只交换任务说明、结果和反馈,不互传完整对话,因此都能充分利用缓存。Cognition 还发现,更贵但更省 token 的模型反而可能让整体更便宜,并会针对每种模型组合单独调整说明粒度和是否允许执行方反驳。
权威 Benchmark 与实测跑分对比
据 Artificial Analysis 网站数据,Opus 5.5 Max + GPT-6 Luna High 的 Fusion 总分 68.1,三项为 DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1。第二名 Muse Code + Muse Wonder Full 为 68.0,差距只有 0.1 分,基本可视为并列;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。「比 Claude Code + Opus 5.5 每任务便宜 31%」来自 Cognition 博客,属于厂商口径。
开发者实战落地与开箱指南
安装 Devin CLI:curl -fsSL https://cli.devin.ai/install.sh | bash,选择 Fusion 后分别指定主控和执行模型,官方推荐 Opus 5.5 + GPT-6 Luna。适合长时间、改动多的仓库任务;如果主要做短小修改,单模型可能更简单。建议在自己的代码库上对比每任务成本,而不只看每百万 token 单价。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察