

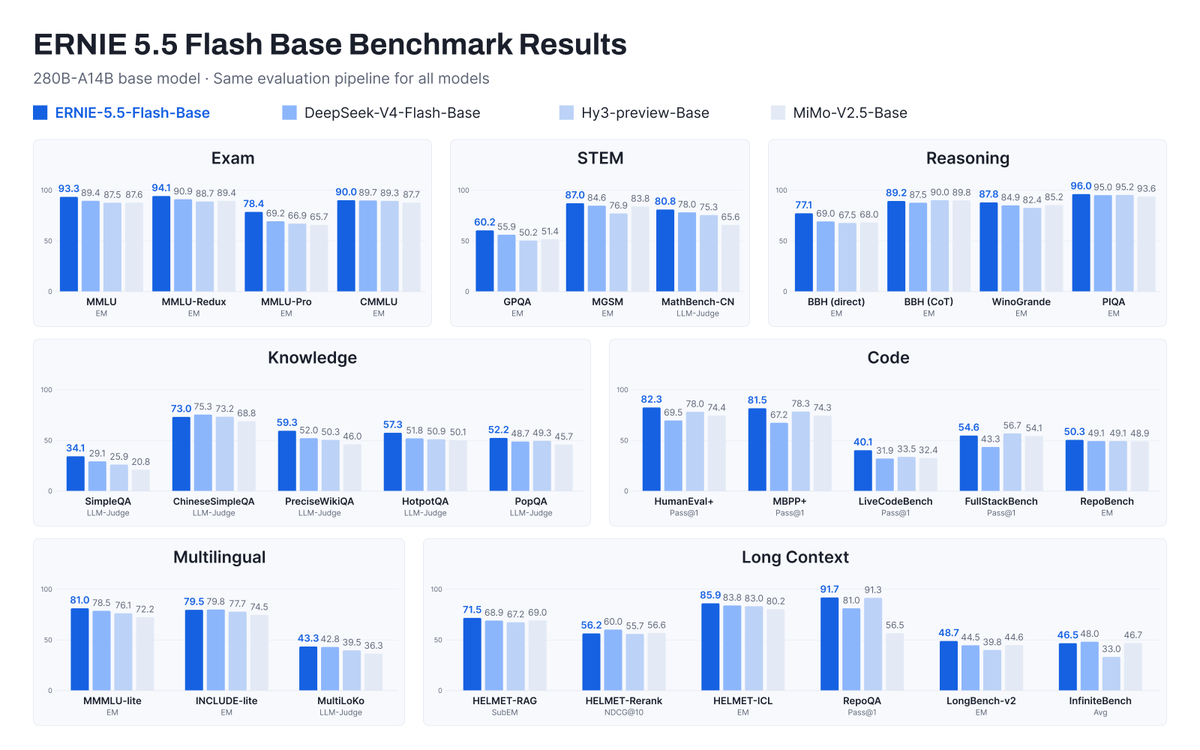
百度 11 月 5 日通过官网与 @BaiduResearch 宣布开源 ERNIE-5.5-Flash-Base:预训练结束点、未经中段/后训练的纯文本 MoE 基座,总参 280B、每 token 激活 14B,预训练 33.5T、训练上下文最长 128K,微调与推理支持 1M。Hugging Face / ModelScope 提供 FP8 与 BF16。官方统一评测口径下 MMLU 93.3、HumanEval+ 82.3、LiveCodeBench 40.1;后训练版 ERNIE 5.5 Flash「随后发布」。许可为自定义协议(排除欧盟/英国/韩国;相关营收超 5000 万美元需另行书面授权)。
核心要点速览
- ✓11 月 5 日开源预训练结束点基座:280B 总参 / 14B 激活,非对话成品模型
- ✓预训练 33.5T;训练上下文最长 128K,微调与推理支持 1M 上下文
- ✓厂商统一评测:MMLU 93.3、HumanEval+ 82.3、LiveCodeBench 40.1(对比 DeepSeek-V4-Flash-Base 等)
- ✓架构要点:37 层 HCA + 6 层 MLA-DSA、Multi-Router Latent MoE(512 专家 top-10 + 1 共享)
- ✓许可非 Apache:排除欧盟/英国/韩国;相关年营收超 5000 万美元需百度书面授权
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
开源权重常是后训练对话版,二次预训练与公平对比成本高。百度 11 月 5 日放出 ERNIE-5.5-Flash-Base:预训练结束点纯文本基座,方便领域适配、指令微调与 RL;后训练版「随后发布」,当前不是聊天成品。
架构亮点与底层机制
280B 总参、每 token 激活 14B;43 层(1 稠密 + 42 MoE),512 专家 top-10 加 1 共享。注意力为 37 层 HCA(每 128 token 压成一条缓存)与 6 层 MLA+DSA。另有 Multi-Router、VHA、ECHO 等。权重提供 FP8/BF16,文档含 SGLang、vLLM 示例。
权威 Benchmark 与实测跑分对比
以下为百度统一评测管线的厂商口径,对比同类基座。考试:MMLU 93.3、MMLU-Pro 78.4。代码:HumanEval+ 82.3、LiveCodeBench 40.1。长文:RepoQA 91.7、LongBench-v2 48.7。第三方复现未在此断言;不编造额外跑分。
开发者实战落地与开箱指南
下载:Hugging Face baidu/ERNIE-5.5-Flash-Base、ModelScope 与官网博文。基座走 completions,需 BOS。许可为自定义协议:排除欧盟/英国/韩国;相关年营收超 5000 万美元须书面授权。部署前读 LICENSE。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察