AI 编程实时动态与要闻

商汤发布日日新 SenseNova 6.8 Flash 正式版:主打长期记忆与主动交互的办公智能体,可生成动态 PPT、动态海报和可编辑 Blender 3D 工程

商汤 11 月 2 日晚发布多模态智能体模型日日新 SenseNova 6.8 Flash 正式版,重点升级两块:一是长期记忆和主动交互,能跨任务、跨会话记住用户目标与约束,在信息变化时主动提醒;二是设计生成,覆盖 Web、SVG、Three.js、Blender、动态 PPT 和动态海报,并可接入 Figma。模型已上线 SenseNova Studio、商汤小浣熊和 SenseNova Token Plan;官方 X 账号称 Token Plan 可免费试用,每 5 小时 1500 次 API 请求。官方称其在智能体协作、数据分析和演示生成上超过部分国际前沿模型,但未在公告中列出具体分数。

商汤发布日日新 SenseNova 6.8 Flash 正式版:主打长期记忆与主动交互的办公智能体,可生成动态 PPT、动态海报和可编辑 Blender 3D 工程

核心要点速览

  • 正式版于 11 月 2 日晚发布,定位为多模态智能体模型,主攻办公协作和设计交付
  • 长期记忆加主动交互:跨会话记住目标、约束和偏好,相关信息变化时主动提出调整建议(官方演示基于小浣熊内部研发版)
  • 设计能力覆盖 Web、SVG、Three.js、Blender、动态 PPT、动态海报,输出可继续编辑的 PPTX 和 Blender 工程,并可接入 Figma
  • 渠道:SenseNova Studio、商汤小浣熊、SenseNova Token Plan;官方 X 称 Token Plan 每 5 小时 1500 次免费 API 请求
  • 官方只称在智能体协作、数据分析、演示生成上超过部分国际前沿模型,公告未给具体分数,暂无独立评测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova 6.8 Flash⚡ SenseNova Loop-9B-Preview🤖 Raccoon🌐 SenseTime

DeepSeek Harness 上线 Creator Mode:用一句话让 Agent 生成可用插件,官方放出 7 个演示 Prompt

DeepSeek 旗下开源 Agent 应用 DeepSeek Harness(MIT 协议)11 月 2 日在 X 官方账号发布 Creator Mode:用户用自然语言描述想要的插件,Agent 把它做成可直接使用的插件,演示包括 3D 地标馆、Transformer 3D 可视化、视频剪辑台和论文阅读器。官方同时在 cdn.deepseek.com 公开了 7 个中英双语演示 Prompt,并提醒部分插件经过多轮对话打磨,单条 Prompt 未必能完全复现视频效果。原帖约 2 万赞、169 万次浏览。官方未公布任何跑分。

DeepSeek Harness 上线 Creator Mode:用一句话让 Agent 生成可用插件,官方放出 7 个演示 Prompt

核心要点速览

  • Creator Mode:用自然语言描述想要的插件,Agent 生成可直接使用的插件,从设计工作台到沙盒游戏、3D LLM 可视化。
  • 官方公开 7 个演示 Prompt:3D 地标馆、Transformer 3D 演示、5 种界面风格切换、海报工作台、视频剪辑台、论文阅读器、会话 token 统计。
  • 入口已进入 v0.2.1-rc.5(10 月 30 日预发布):插件管理页新增「让 Agent 创建插件」,保留草稿进入创造模式。
  • GitHub 仓库 约 27 万星、MIT 协议;Harness 目前仍处于预览期。
  • 官方未公布任何跑分或成功率数据;原帖约 2 万赞、169 万次浏览。
阅读全文
关联模型 / 智能体 / 厂商:

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

月之暗面 Kimi 官方账号 10 月 30 日 03:14(UTC)发布 3D Make,称 Kimi 可连接 Blender 和 CAD 等工具来建模、组装场景和开发游戏,已在 kimi.ai 和 Kimi Work 上线。官方同步发布的 3D 教程说明,K3.1 Pro 经过专门训练,通过 Python 脚本操作 3D 软件,即使没有 MCP 支持的专业软件也能纳入工作流;人物、动物等网格模型则自动调用 Tripo 等扩散模型生成。需要本地软件的插件仅在 Kimi Work 中可用。

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

核心要点速览

  • 上线范围:3D Make 已在 kimi.ai 和 Kimi Work 提供,依赖本地软件的插件仅限 Kimi Work
  • 两种建模路线:参数化建模由 K3.1 Pro 写 Python 脚本完成(家具、机械件、建筑),网格建模自动调用 Tripo、Meshy、Hyper3D 等服务
  • 引擎适配:官方称已适配 Unreal Engine、Unity 和 Godot,可导入模型、搭场景、逐步实现玩法
  • 官方案例:K3.1 Pro 发布视频里的天宫场景用 Unreal Engine 5.8 制作,源模型合计 3600 万个三角形,用 Nanite 和 Lumen 渲染
  • 跑分:官方未公布 3D 相关基准,教程也承认部分任务需要多轮修改,骨骼绑定和复杂材质仍是短板
阅读全文

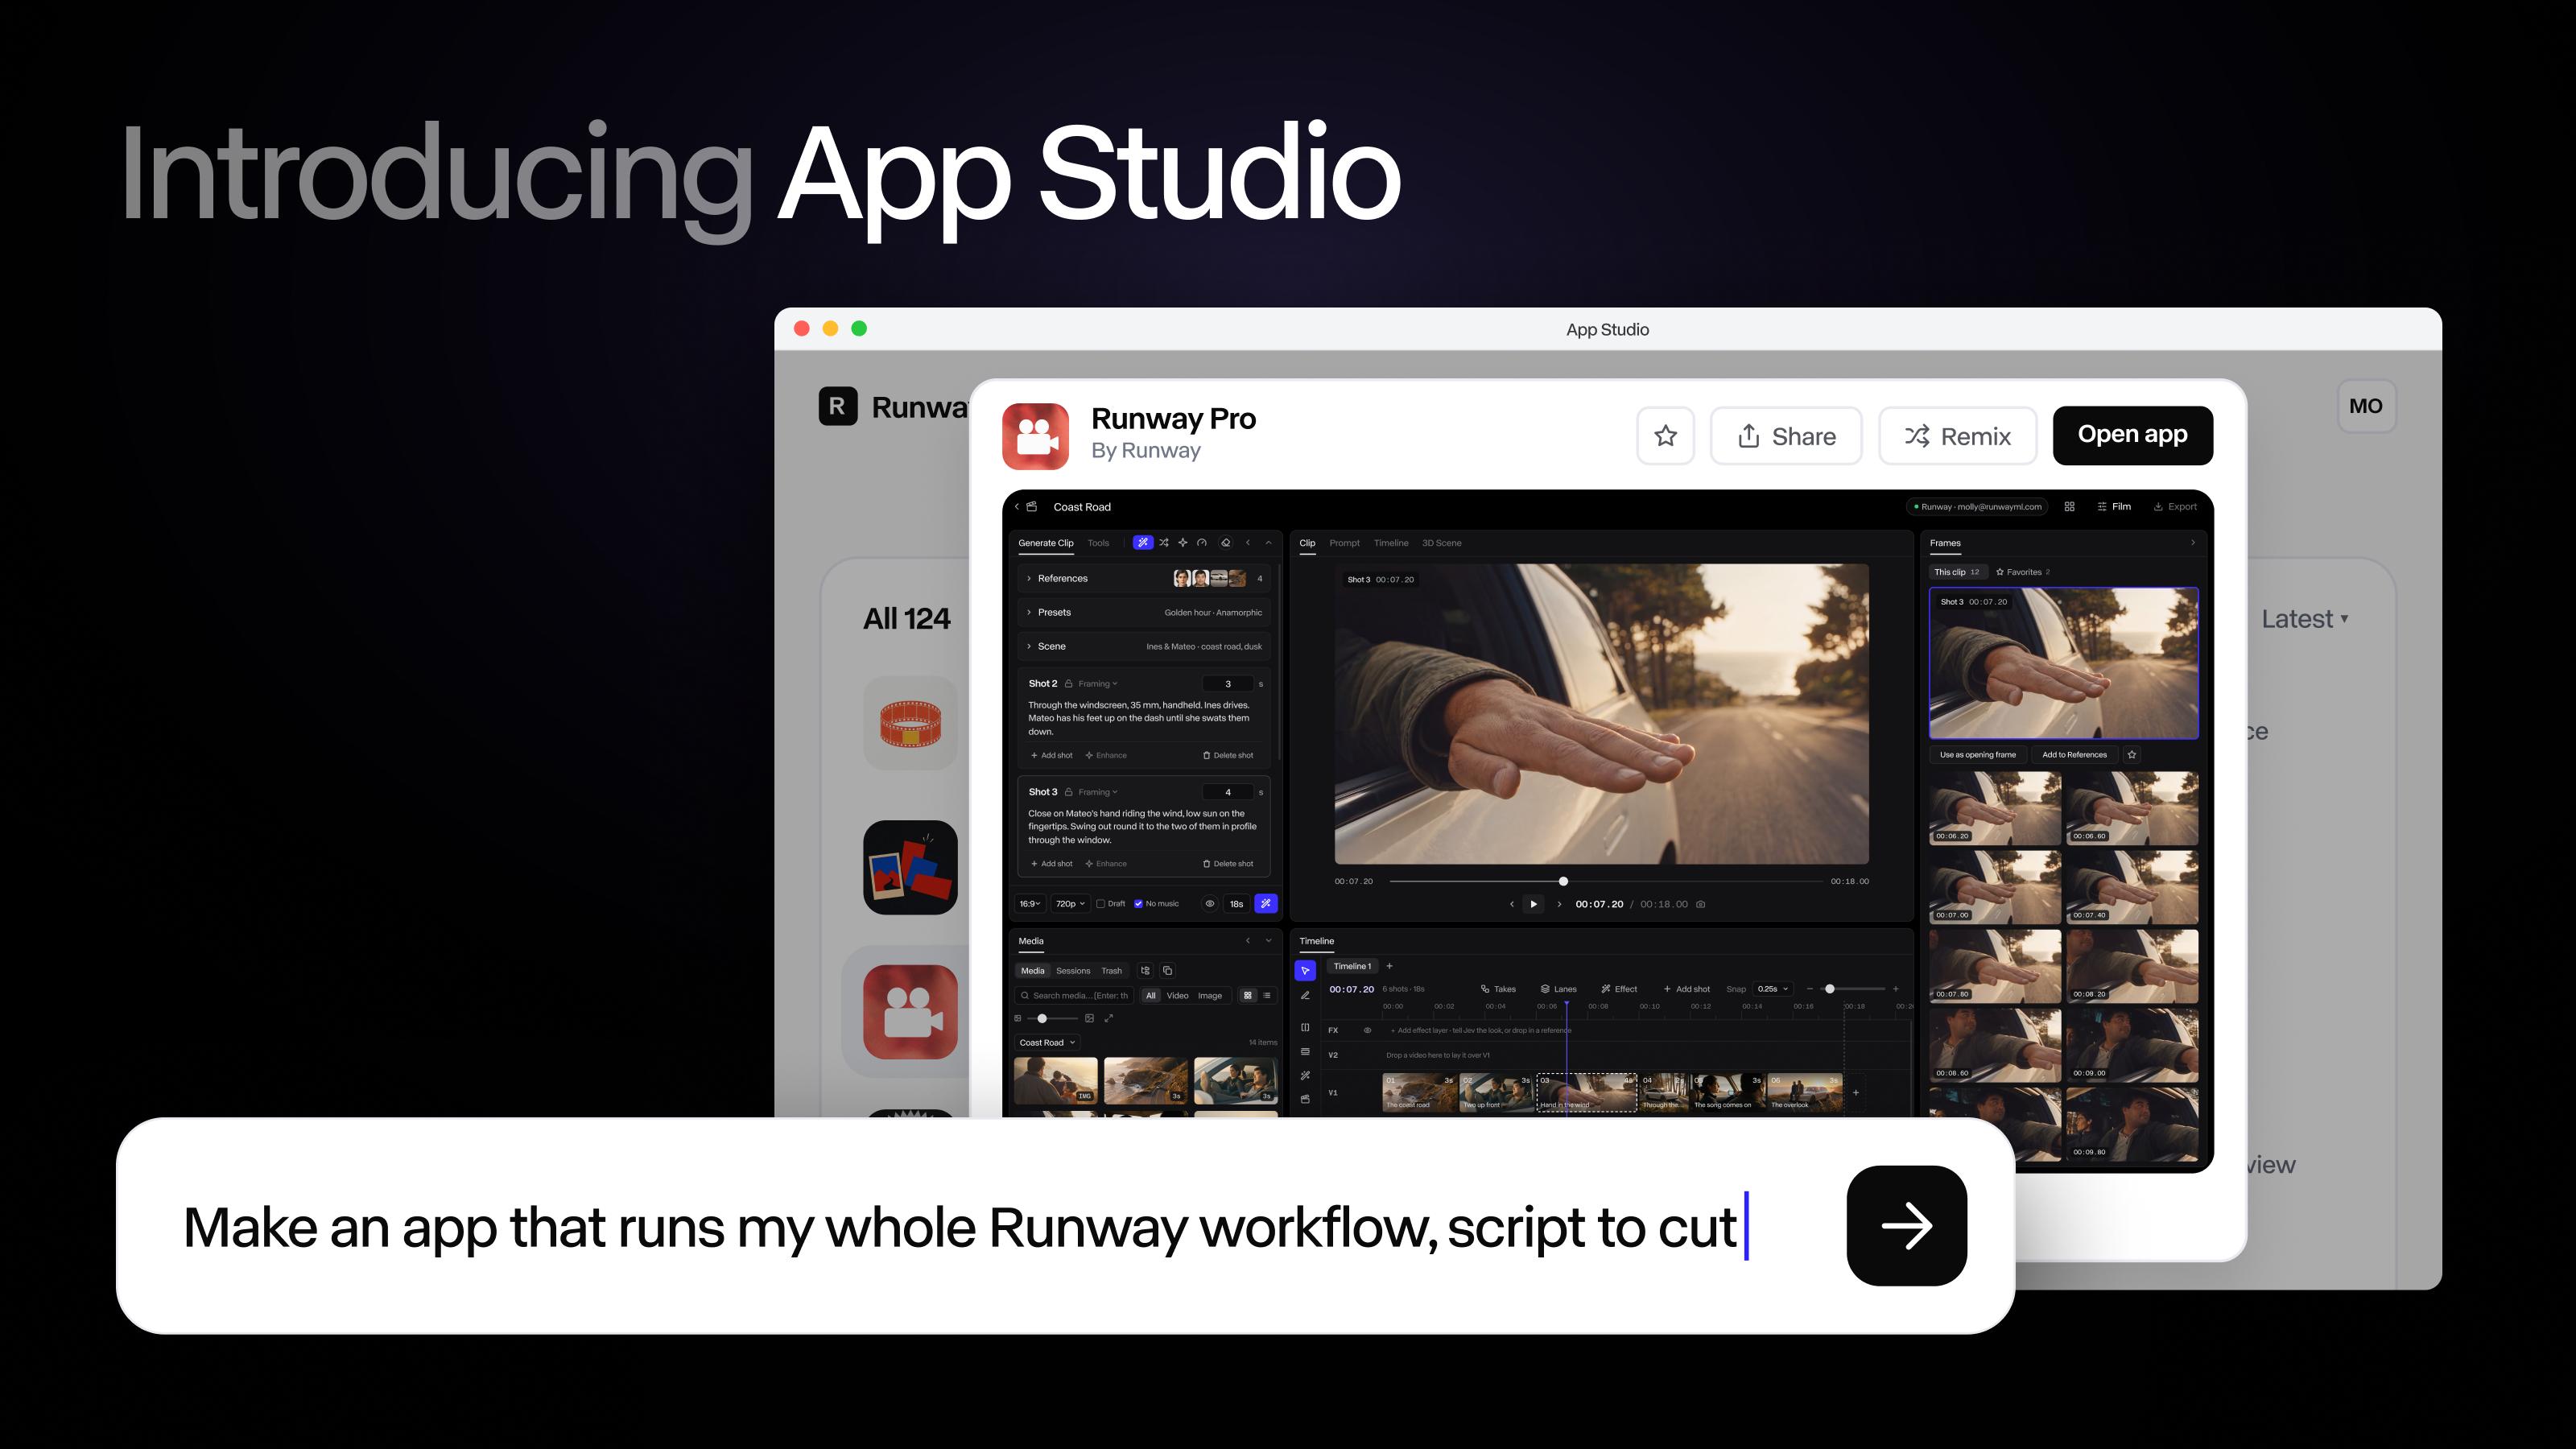
Runway 推出 App Studio:用自然语言描述就能生成自带界面的创意应用,调用 Runway 图像、视频、音频模型和品牌资产

Runway 10 月 26 日在官方博客发布 App Studio:用户用自然语言描述想要的工具,App Studio 会编写、测试并部署一个带独立界面的应用,用 Runway 的图像、视频、音频模型,结合团队的 Brand Kit、Workflow 和素材生成内容。已有的 Agent 会话或 Workflow 可一键转成应用;应用默认私有,可分享给团队或发布公开链接,访客用自己的额度运行。首发自带 Character Swap、AutoComp、3D Camera Control 等内置应用。所有付费套餐即日可用,不另收费,构建和运行都从现有 Runway 额度扣除。

Runway 推出 App Studio:用自然语言描述就能生成自带界面的创意应用,调用 Runway 图像、视频、音频模型和品牌资产

核心要点速览

  • 定价:所有付费套餐即日可用,无需加购;构建、运行和托管都从现有 Runway 额度扣除,公开链接的访客用自己的额度生成
  • 首发 6 个内置应用:Character Swap(换角色)、AutoComp(替换商品并保持包装准确)、Product Portfolio、3D Camera Control、Precise Edit 和可定制的 Runway Pro,都可直接用或二次改造
  • 一键转换:已有的 Agent 会话或 Workflow 可锁定提示词、模型链和参数,变成只暴露必要输入的应用;代码对想检查的人可见,支持预览和回滚
  • 企业管控:应用沿用账号的模型开关,管理员可按工作区关闭 App Studio、禁止公开链接、查看全部应用用量;企业应用链接必须登录 Runway 账号
  • 早期用户(Runway 口径):建筑事务所 KPF 做了把效果图变成带运镜视频的应用,设计伙伴在早期访问中共做了数十个定制应用
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Kimi 官方预告视频露出 Kimi K3.1 型号:Kimi Code 终端显示 K3.1 thinking: high,演示 Three.js 3D 场景生成

2026-10-23(UTC 01:41,SGT 09:41),Kimi 官方账号 @Kimi_Moonshot 发布一段 24 秒、复古 CRT 电脑风格的纯视频帖,没有任何文字。视频开头的 Kimi Code 终端清楚显示「Model: Kimi K3.1」「Version: 2.2.0」,状态栏为「Kimi K3.1 thinking: high」,并提示「Kimi Code Desktop is here」;随后用户输入「Build a complex procedural 3D scene in Three.js.」,模型调用 Write 工具生成 ./scene.js。这是 Kimi K3.1 型号首次由官方素材露出。官方没有文字说明,也没有公布发布日期、跑分、价格或参数,因此它是预告,不等于已发布。

Kimi 官方预告视频露出 Kimi K3.1 型号:Kimi Code 终端显示 K3.1 thinking: high,演示 Three.js 3D 场景生成

核心要点速览

  • 官方预告视频中,Kimi Code 终端显示「Model: Kimi K3.1」,状态栏为「Kimi K3.1 thinking: high」,这是 K3.1 型号首次由官方素材露出
  • 视频同时露出 Kimi Code 2.2.0 版本号,并提示「Kimi Code Desktop is here」,可用 /desktop 命令或访问 kimi.com/code 安装
  • 演示任务是「Build a complex procedural 3D scene in Three.js.」,模型用 Write 工具生成 ./scene.js,全片约 24 秒
  • 官方帖无文字,发布日期、跑分、价格和参数均官方未公布,应视为预告,不是正式发布;截至 SGT 10-23 晚,该帖约 163 万展示、1.75 万点赞(X 公开数据)
阅读全文

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

来自新加坡国立大学(NUS)、香港中文大学(深圳)等机构的研究团队在 arXiv:2610.28630 正式发布视频生成渲染框架 SolarRenderer。针对当前 3D 游戏引擎灰模、姿态骨骼、深度图与点云难以极速转化为高保真视觉视频的难题,SolarRenderer 基于冻结的 MiniMax-H3 33B 基础视频模型,引入轻量化控制 LoRA 与 4 步生成 LoRA。利用结构引导分布匹配算法,仅需 4 步去噪即可完成高质量渲染(比传统 50 步采样提速 12.3 倍),并提出块因果(Block-Causal)变体,成功实现 768p 高清视频的毫秒级实时流式生成,为下一代神经游戏引擎与虚拟制片树立了全新标杆。

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

核心要点速览

  • SolarRenderer(arXiv:2610.28630)发布,实现基于粗糙 3D 几何(灰模、骨骼、深度、网格)的高保真视频极速渲染
  • 冻结 MiniMax-H3 33B 视频底座,仅微调轻量 Control LoRA 与 4-step LoRA,保持基座生成能力的同时强化几何控制
  • 仅需 4 步去噪采样即可完成高保真视频渲染,生成速度较传统 50 步扩散采样提速惊人的 12.3 倍
  • 研发块因果(Block-Causal)注意力流式架构,在工业级 GPU 上实现 768p 分辨率视频实时连续生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniMax-H3⚡ SolarRenderer

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

多所顶尖研究机构在 arXiv:2610.23986 中正式发布首个面向真实世界参考的视觉智能体 3D 创作评测基准 BlenderWorld。基准涵盖程序化建模、着色材质编写、空间布局与灯光模拟等 223 项真实工业级任务,接入 Blender 软件全自动沙盒环境。实测显示 GPT-6 Astra 以 79.9 分综合得分问鼎全球榜首(完美完成率达 42.2%),Opus-5 斩获 73.0 分,而开源模型 DeepSeek-V4.1-Flash 斩获 65.7 分超越众多大尺寸基线。

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

核心要点速览

  • 多所顶尖机构发布首个面向真实世界 3D 资产创作的工业评测基准 BlenderWorld(arXiv:2610.23986),涵盖 223 项全自动 Blender 任务
  • GPT-6-Astra 以 79.9 分与 42.2% 完美率强势领跑全球榜首,Opus-5 斩获 73.0 分位居第二
  • 开源旗舰 DeepSeek-V4.1-Flash 斩获 65.7 分登顶开源第一,并在多模态子任务中以 65.5 分追平商业旗舰 GPT-5.6-Sol
  • 揭示截然不同的 Agent 求解流派:GPT 倾向于前瞻性规划(39.9K Token),而 DeepSeek 依靠高频工具迭代检查(单任务 168 次工具调用)
阅读全文
关联模型 / 智能体 / 厂商:

UCSD 开源 3D 具身探索智能体 ACT3D:纯单目第一人称交互学习,超越 Gemini 3.6 Flash

加利福尼亚大学圣迭戈分校(UCSD)研究团队在 arXiv:2610.21783 中推出 3D 空间主动探索与推理智能体 ACT3D。针对传统 3D 具身模型依赖昂贵稠密多视角图像、多模态视频流或重型点云编码的痛点,该研究完整保留单目视觉语言模型(VLM)的原生单帧第一人称编码,将 3D 环境作为动作与交互观测场。经结果驱动强化学习(RL)优化后,在六大 3D 评测基准上取得 53.2% 的平均准确率(较基座 Qwen 跃升 22.0%),一举超越商业旗舰 Gemini 3.6 Flash,且输入帧数节省 50%~70%。

UCSD 开源 3D 具身探索智能体 ACT3D:纯单目第一人称交互学习,超越 Gemini 3.6 Flash

核心要点速览

  • UCSD 联合佐治亚理工发布 3D 主动交互智能体 ACT3D(arXiv:2610.21783),纯单目第一人称图像输入打破传统多视角堆砌
  • 以结果驱动强化学习(RL)优化视角探索,在无路径先验监督下自主习得问题条件化寻路与遮挡消除策略
  • 在六大 3D 基准上取得 53.2% 平均准确率,较基座模型提升 22.0%,超越商业旗舰 Gemini 3.6 Flash 且输入帧数节省 50%~70%
  • 在严重遮挡的复杂 3D 推理任务中增益高达 16.3%,未见场景泛化提升 5.9%,为低成本具身导航提供高效算法架构
阅读全文
关联模型 / 智能体 / 厂商:

Skyfall AI 发布工程世界模型 SKY-001:文字或草图直接生成可执行 CAD 建模步骤,官方称 CAD 任务比 GPT-6 Astra 快 51 倍、便宜 150 倍

由 Maluuba(已被微软收购)原班团队创办的 Skyfall AI 于 10 月 19 日发布研究预览版 SKY-001,自称首个「工程世界模型」。它不做下一个 token 预测,而是从文字或一张 2D 图出发,先并行生成几种粗略 3D 方案,再递归拆成零件树,逐个零件画 2D 草图、拉伸成 3D,最后按层级组装,可在 Autodesk Fusion 等 CAD 软件中查看。官方自测 3D CAD 任务:IoU 79.7%(GPT-6 Astra 79.1%),单例 3.9 秒、0.005 美元(Astra 199 秒、0.75 美元)。目前仅开放候补名单,商用部署目标是 2027 年初;所有跑分均为厂商自测,暂无独立复现。

Skyfall AI 发布工程世界模型 SKY-001:文字或草图直接生成可执行 CAD 建模步骤,官方称 CAD 任务比 GPT-6 Astra 快 51 倍、便宜 150 倍

核心要点速览

  • 3D CAD 自测:SKY-001 IoU 79.7%、3.9 秒、0.005 美元/例;GPT-6 Astra 79.1%、199 秒、0.75 美元;Opus 5.5 69.4%;Grok 4.7 未完成任何样例(官方口径)。
  • BIM 自测:SKY-001 IoU 43.6%、1.22 秒、约 0.0024 美元/例;最佳 LLM 为 Gemini 3.8 Flash 42.3%;相对 GPT-6 Astra 快 118 倍、便宜 188 倍(官方口径)。
  • 四阶段流程:并行方案探索 → 递归扩散式 3D 拆解 → 2D 到 3D 潜空间建模 → 层级组装,演示中 Jaguar E-Type 拆出 103 个末级零件、139 个节点。
  • 可用性:研究预览,仅候补名单;新闻稿称商用部署目标 2027 年初,官方未公布参数量、训练数据和 API 定价。
  • 团队:Maluuba 创始人 Sam Pasupalak、Kaheer Suleman、Sumit Pasupalak,投资方含 Fidelity、Touring Capital、M13、iNovia Capital。
阅读全文

Viggle 发布 JST-2 物理原生世界基础模型:约 1 秒生成 3D 场景、单张图出可动画角色

Viggle 10 月 19 日发布 JST-2。它不在像素或视频空间里学习,而是把世界表示为 3D 空间中的持久「原子」(Physics-Native Tokens),用一套架构同时生成场景、角色和动作。官方称在 NVIDIA B200 上约 1 秒生成一个 3D 场景,推理成本低于 0.01 美元,最多保留 64 个输入视角作为空间上下文;角色无需单独绑骨即可动画。现已在浏览器端 PINOC 免费试用,并提供 API 和 MCP。

Viggle 发布 JST-2 物理原生世界基础模型:约 1 秒生成 3D 场景、单张图出可动画角色

核心要点速览

  • 场景生成:约 1 秒/场景(NVIDIA B200,不含网络延迟),推理成本低于 0.01 美元;官方对比 Marble 约 5–6 分钟(厂商口径)。
  • 空间上下文:最多 64 个输入视角,可逐个视角实时扩展世界,输出 3D Gaussian splats 在浏览器本地渲染。
  • 角色盲测(厂商自测):Average Score 对 Meshy 7.1 为 58.4%、对 Tripo H3.1 为 73.2%;脸部质量分别为 63.0% 和 82.0%(50% 表示持平)。
  • 动作盲测(厂商自测):文本生成动作对 Cartwheel Swing 74.8%、对 HY-Motion-1.0 80.0%;视频转动作对 DeepMotion Animate 3D 89.1%。
  • 接入方式:PINOC 浏览器端免费试用,另有 API 和 MCP,可接 Codex、Claude Code 等 agent;下一代 JST-3 计划用学习到的物理替代规则式碰撞与物体交互。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

港大与南洋理工开源智能体 3D 场景生成系统 Scene-Designer:设计与批判双 Agent 闭环,HF 获 29 赞

从自然语言生成完整、自洽且物理可用的 3D 室内场景一直受困于通用大模型缺乏专业空间设计与多维审查经验。香港大学与南洋理工大学团队开源 Scene-Designer(arXiv:2610.23121,登顶 Hugging Face 热门论文获 29 赞)。该系统创新构建“设计智能体(Designer Agent)”与“批判智能体(Critique Agent)”双代理交互闭环,分别学习空间设计与布局挑刺经验,在室内场景合理性、功能可用性与美学布局评测中显著击败 Holodeck 与 Chat-3D。

港大与南洋理工开源智能体 3D 场景生成系统 Scene-Designer:设计与批判双 Agent 闭环,HF 获 29 赞

核心要点速览

  • 港大与南洋理工开源智能体 3D 场景生成系统 Scene-Designer(arXiv:2610.23121),获 Hugging Face 29 赞
  • 首创“设计智能体”与“批判智能体”双 Agent 协同闭环,分别学习空间布局与人体工学审查挑刺经验
  • 相比 Holodeck 与 Chat-3D,将室内 3D 物体空间穿模与碰撞干涉率大幅降低 60% 以上
  • 在盲测专家评审中取得超过 78% 的人类偏好胜率,并使多约束复杂指令对齐率提升 34 个百分点
阅读全文
关联模型 / 智能体 / 厂商:

同济与腾讯提出 3D 世界模型视角解耦表征 GeoState:分离相机畸变与场景演变,Waymo 跨帧预测零尺度漂移

现有 3D 世界模型多直接采用几何基础模型(GFM)特征作为状态,但视角依赖性导致相机运动与场景演变相互纠缠,长链路外推极易发生尺度漂移崩溃。同济大学与腾讯团队发表 GeoState(arXiv:2610.22343,项目主页上线)。该框架利用场景 Tokenizer 将多视角几何特征聚合为视角解耦的世界状态,自回归模型仅推演绝对场景状态,在 Waymo 自动驾驶长程深度预测中全程保持单一上下文尺度,且零样本泛化至 KITTI 与 nuScenes。

同济与腾讯提出 3D 世界模型视角解耦表征 GeoState:分离相机畸变与场景演变,Waymo 跨帧预测零尺度漂移

核心要点速览

  • 同济大学与腾讯团队提出 3D 世界模型视角解耦表征 GeoState(arXiv:2610.22343),根本性解决 GFM 特征视点依赖造成的长程尺度漂移
  • 通过场景 Tokenizer 将环视几何特征聚合为视角解耦状态,自回归模型推演物理演化,几何解码器按需响应目标相机光线查询
  • 在 Waymo 自动驾驶长程深度预测(t+0.2s 至 t+2.0s)中全程维持单一上下文尺度,全面超越 DINO-Foresight 与 VGGT-World
  • 展现出强大的跨传感器泛化能力,零样本无缝迁移至 KITTI 与 nuScenes 复杂路况
阅读全文
关联模型 / 智能体 / 厂商:

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

当前 LLM 能否在复杂连续空间操作中精确预测离散物理世界的演变?南加州大学(USC)、UCLA 与 CMU 联合发布 Grid-Bench(arXiv:2610.22312,GitHub: grid-bench/Grid-Bench)。该基准基于 8 种离散几何变换规则,测试 2D/3D/4D 网格在 0 至 64 步长事件链下的全状态精确预测。对 GPT-5.6 Sol、Claude 5 Sonnet、GLM-5、Kimi K2.5 等 6 款顶尖模型的评测表明:在 64 步长轨迹下,开源与中型模型完整状态精确率几乎归零,唯闭源旗舰维持断层领先。

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

核心要点速览

  • 南加州大学、UCLA 与 CMU 联合发布可执行多维空间推理基准 Grid-Bench(arXiv:2610.22312),跨越 2D/3D/4D 网格与 8 大几何规则
  • 涵盖 8,928 组可执行测试实例,评测历史步长从 T=0 延伸至极端复杂的 T=64 步连续离散世界演变
  • 在 T=16 步中程推演中,GPT-5.6 Sol(98.0% 单元准度)与 Claude 5 Sonnet(96.8%)保持领先,中型模型精确世界命中率跌至个位数
  • 在 T=64 步极限长链下,GLM-5 与 Kimi K2.5 完全精确世界命中率归零,证实长程离散空间推演必须外挂确定性状态机
阅读全文
关联模型 / 智能体 / 厂商:

4D/3D 视觉与自回归视频扩散加速突破:Gen4P 单次前馈 4D 感知、SUPRA-TEX 超对齐材质生成与港科大 ForcingBooster 削减 50% 去噪计算

三维与四维视觉生成迎来三项底层革新:Gen4P(arXiv:2610.22371)将预训练视频生成模型改造为无需迭代去噪的单次前馈 4D 感知器,在 WorldTrack 基准全面超越 MonST3R 与 Any4D;华科与华为团队推出 SUPRA-TEX(arXiv:2610.22352),将 DTC-Tex 渲染 PBR PSNR 推高至 32.08 dB(超越 TRELLIS.2 的 28.60 dB);港科大 ForcingBooster(arXiv:2610.12625)通过自适应分块去噪将自回归视频扩散 Patch NFE 砍半(-50.19%),实现无损画质下 1.30 倍端到端加速。

4D/3D 视觉与自回归视频扩散加速突破:Gen4P 单次前馈 4D 感知、SUPRA-TEX 超对齐材质生成与港科大 ForcingBooster 削减 50% 去噪计算

核心要点速览

  • Gen4P(arXiv:2610.22371)将预训练视频生成器转化为无需迭代去噪的单次前馈 4D 感知器,在 WorldTrack 基准(ADT 91.93 APD / 0.112 EPE)全面超越 MonST3R、Any4D 与 OpenD4RT
  • 华科与华为 SUPRA-TEX(arXiv:2610.22352)结合 MLLM 光照剥离、只读 3D VAE 隐空间锚点与交错流 Transformer,在 DTC-Tex 上斩获 32.08 dB PBR PSNR(超越 TRELLIS.2 的 28.60 dB 与 Hunyuan3D 2.1 的 26.80 dB)
  • 港科大 ForcingBooster(arXiv:2610.12625)提出自适应分块去噪,在 Causal Forcing 上削减 50.19% Patch NFE,实现 1.30 倍端到端加速(11.15s 降至 8.56s)且语义分数无损(72.20 vs 72.21)
  • ForcingBooster 已在 Wan2.1 14B、LingBot-World-V2 与 LongLive 等主流自回归视频扩散架构上完成通用性验证
阅读全文
关联模型 / 智能体 / 厂商:

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

针对前馈式 3D 高斯泼溅(3DGS)在大视角跨越下渲染质量骤降以及免训练扩散生成式压缩显存算力开销过大的痛点,今日两项重磅视觉与图形学成果给出突破:浙江大学周晓巍、鲍虎军、彭思达团队开源 InfiniSplat v2(arXiv:2610.20341,HF 118 赞),通过冻结几何分支解耦几何与属性预测并引入大角度目标视图监督,在 6 大三维数据集上将平均 LPIPS 与 DISTS 误差分别大幅降低 25.8% 与 32.9%;以色列理工学院推出 H-DDCM(arXiv:2610.18125),用隐式随机哈达玛(Hadamard)字典替代稠密高斯码本,将计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时流式生成视频压缩。

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

核心要点速览

  • 浙江大学开源 InfiniSplat v2(HF 118 赞):通过冻结几何分支解耦几何与属性预测并结合大角度视图监督,在 6 大三维数据集上将有位姿前馈平均 LPIPS 与 DISTS 分别降低 25.8% 与 32.9%
  • 在无位姿(Pose-Free)设定下 InfiniSplat v2 同样以平均 LPIPS 0.3026 / DISTS 0.1341 击败 WorldMirror 2.0(0.3757 / 0.1935)与 AnySplat
  • 以色列理工提出 H-DDCM:用隐式快速哈达玛变换字典将免训练扩散压缩的计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时长视频压缩
阅读全文
关联模型 / 智能体 / 厂商: