AI 编程实时动态与要闻

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA

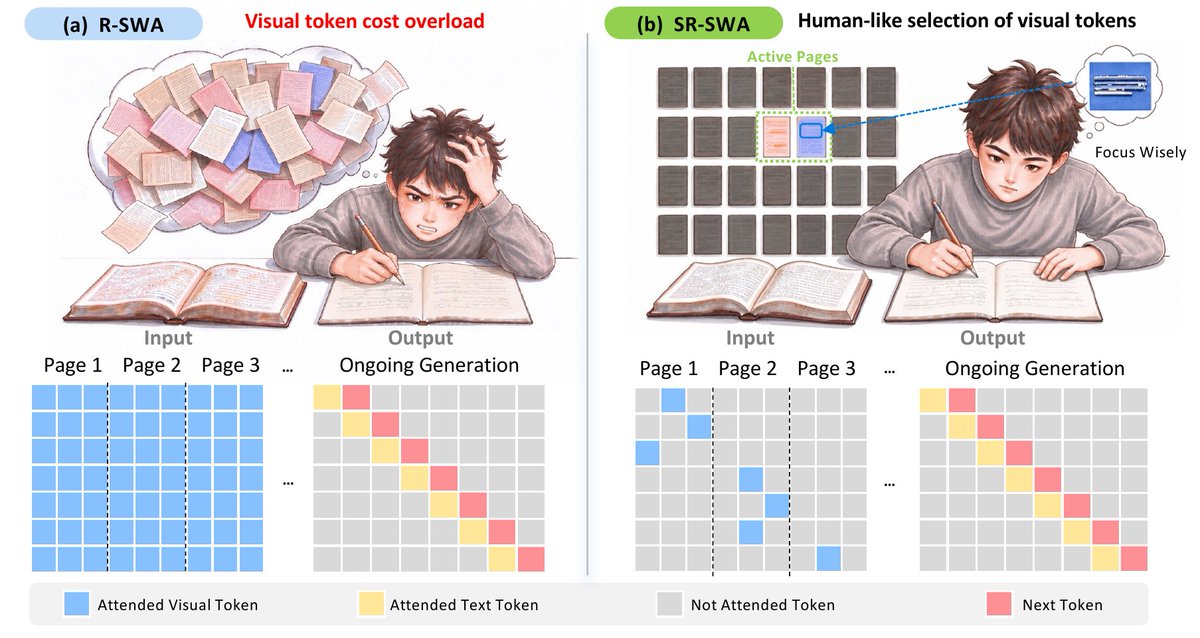
百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

百度官方账号 @Baidu_Inc 10 月 27 日宣布开源 Unlimited OCR 2,以 MIT 协议发布在 Hugging Face。新的 SR-SWA 稀疏参考滑窗注意力把图文注意力压缩到固定大小的参考集合,官方称可在有限上下文内解析任意长度文档,在几十页的 MPDocBench 得 84.6、上百页的 MarathonDocBench 得 77.1,均为厂商自测。

百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

核心要点速览

  • SR-SWA 把超长序列的图文注意力压缩到固定大小的参考集合(如 512 token),官方称每步解码延迟和显存几乎不随页数增长
  • 官方口径:MPDocBench 总分 84.6,比次优的 Qwen3.8-Max(78.3)高 6.3 分
  • 官方口径:MarathonDocBench 总分 77.1,比次优的 Kimi-K3(33.7)高 43.3 分;一代 Unlimited-OCR 在该榜为 0
  • 权重以 MIT 协议发布在 Hugging Face,约 3.3B 参数(按 HF 权重统计),支持 Transformers 和定制版 SGLang 部署
  • 所有跑分均为百度自测,尚无第三方复现
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Unlimited OCR 2⚡ Unlimited-OCR⚡ DeepSeek-OCR🌐 Baidu

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

Cloudflare 10 月 26 日在官方博客发布事故报告:8 月 27 日至 9 月 9 日,Workers AI 上的 GLM-5.3(@cf/zai-org/glm-5.3)对超过 681,280 token 的长提示,有 155 条回复混入了其他用户刚发过的请求内容,且都返回 HTTP 200。原因是 prefill 节点 KV 缓存池小于 1,048,576 token 的上下文窗口,叠加 SGLang 在 prefill/decode 分离模式下处理超长请求的漏洞。Cloudflare 称未发现恶意利用,已修复并建议运营方升级到 SGLang v0.5.22 或更高版本。

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

核心要点速览

  • 影响范围:2026-08-27 至 09-09 共 155 条回复受影响,均为超过 681,280 token 的提示;Cloudflare 确认 Workers AI 其他模型未受影响
  • 根因 1:GLM-5.3 上下文 1,048,576 token,但 prefill KV 池只有 681,280 token;修复后池容量约 204 万 token,约为上下文的 2 倍
  • 根因 2:SGLang 把超长请求标记为拒绝并换成 1 token 占位,却没中止,decode 节点读到了未被覆盖的旧缓存页
  • 响应:9 月 8 日经 HackerOne 收到 Knostic 的 Gadi Evron 报告,9 月 9 日宣布事故后 40 分钟内下线模型,当天 19:40 UTC 恢复
  • 行动建议:自建 SGLang 的团队升级到 v0.5.22 或更高版本,并直接核对 KV 池大小与上下文长度
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Z.ai GLM 5.3🌐 cloudflare🌐 zai
AD赞助内容

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文

前 Anthropic 研究员创办的 Mirendil 发布首个模型 Fern:从零预训练,上下文最长 1000 万 token

Mirendil 10 月 26 日发布首个模型 Fern,基于自研 Mirendil-Base(0.1–0.5T 参数)从零预训练,上下文窗口最长约 1000 万 token,约等于 50 万行代码或数天的 Agent 轨迹。Fern 0.1 只做了一轮短后训练,主打审计训练数据、看日志排查训练故障、通读 Agent 轨迹等 AI 研发场景。官方口径:SWE-Bench Verified 73.4%、RULER 单针检索在 10M 长度仍为 100%,但多跳问答在 10M 降到 45%。目前仅开放早期申请,未公布价格和权重。

前 Anthropic 研究员创办的 Mirendil 发布首个模型 Fern:从零预训练,上下文最长 1000 万 token

核心要点速览

  • 规模与上下文(官方口径):Mirendil-Base 0.1–0.5T 参数,Fern 上下文最长约 10.2M token(约 23 MB 代码、约 50 万行,接近 Megatron-LM 体量),见 官方博客
  • 编码跑分(Mirendil 自测,OpenCode 单次尝试):SWE-Bench Verified 73.4、SWE-Bench Pro v2-Hard 76.5、SWE Atlas QnA 53.2、DeepSWE v1.1 44.2、Terminal-Bench 4.0 仅 6.1;同表 Claude Opus 5.5 分别为 98.2/100.0/66.4/74.2/66.4
  • RULER 长上下文(官方口径):单针检索 32K 到 10M 全为 100%;多跳问答 HotpotQA 从 32K 的 65% 降到 10M 的 45%,10M 档每格只有 20 个样本
  • 研发成本(官方口径):Mirendil-Base 由 1 名研究员加 Agent 在 3.5 个月内完成,总算力不到 1000 万美元,Agent 写了 99% 以上的代码,见 预训练复盘
  • 可用性:Fern 是三款模型中最小的一款,Base-Large(0.5–2T)与 Base-XL(2–10T)仍在预训练;目前只能 申请早期访问,价格和权重均未公布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Fern 0.1⚡ Mirendil-Base🌐 Mirendil

BOSS 直聘南北阁实验室开源 Nanbeige4.3-33B:33B 稠密模型、512K 上下文、Apache 2.0,官方称 Terminal-Bench 2.1 达 80.9 超过 Qwen3.8-27B

BOSS 直聘(看准科技)旗下南北阁大模型实验室 @nanbeige 在 UTC 2026-10-25 12:11 发布 Nanbeige4.3-33B(原帖),模型和 Base 版已在 Hugging Face 以 Apache 2.0 开放权重(模型卡)。这是一个 Llama 架构的 33B 稠密模型,支持 512K 上下文,定位为 Nanbeige4.3 系列的「教师模型」,后续会蒸馏出 Nanbeige4.3-3B 等小模型。官方模型卡在同一套 harness、最高思考强度下对比 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B:Terminal-Bench 2.1 为 80.9(Qwen3.8-27B 73.0),DeepSWE 65.5(42.5),但 SWE-Bench Pro 60.3 略低于 Qwen 的 61.7,GDPval 84.8 也低于 86.4。以上均为官方自测成绩,尚无第三方复现。

核心要点速览

  • 官方来源:@nanbeige X 原帖 与 Hugging Face 模型卡,抓取时原帖约 616 赞、79 转发、3.8 万浏览
  • 规格:33B 稠密、Llama 架构、512K 上下文、Apache 2.0,同时开放 Base 版
  • 官方自测编码:Terminal-Bench 2.1 80.9、Terminal-Bench 4.0 23.8、DeepSWE 65.5、SWE-Bench Pro 60.3(Qwen3.8-27B 分别为 73.0、6.3、42.5、61.7)
  • 官方自测协作类:Automation Bench 54.2、JobBench 44.8、GDPval 84.8(Qwen3.8-27B 为 38.3、34.5、86.4)
  • 部署:支持 Transformers、SGLang、vLLM,官方示例用 4 卡张量并行;后续将蒸馏 Nanbeige4.3-3B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nanbeige4.3-33B⚡ Qwen3.8-27B⚡ Gemma4-31B⚡ Muse-Glimmer-30B🌐 Nanbeige🌐 BOSS Zhipin🌐 Kanzhun

Google 发布 Gemini API CLI(gemini-api)实验预览:零依赖 Go 二进制,让 Claude Code、Codex、Cursor 等编码 Agent 直接出图、出视频、转写并调度托管 Agent

Google AI Studio 团队发布 Gemini API CLI(命令名 gemini-api)实验预览版。它是一个无状态、零依赖的 Go 单文件,支持 macOS、Linux、Windows,Apache 2.0 开源。任何有 shell 权限的编码 Agent 配好 GEMINI_API_KEY 后,就能用一条命令调用文本推理、图像/视频/音乐/语音生成、文件与 YouTube 分析、音视频转写,以及 Deep Research 等托管 Agent。媒体结果直接写到磁盘、只把文件路径打印到 stdout,避免把 base64 塞进上下文。官方说明它是实验项目,不属于受支持的 Google 产品。

Google 发布 Gemini API CLI(gemini-api)实验预览:零依赖 Go 二进制,让 Claude Code、Codex、Cursor 等编码 Agent 直接出图、出视频、转写并调度托管 Agent

核心要点速览

  • 默认模型(官方 README):generate/analyze/transcribe 用 gemini-3.8-flash,image 用 gemini-nano-banana-2.1,video 用 gemini-omni-1.1-flash,music 用 lyria-3.5,tts 用 gemini-3.8-flash-tts
  • 安装:macOS/Linux 一行 curl 脚本、Windows 用 PowerShell 脚本,或 go install;GitHub 最新版本为 v0.4.3(2026-10-19 发布)
  • 面向 Agent 的机器接口:--usage 输出 KDL 命令树、--schema 输出 JSON Schema、--dry-run 离线校验且隐去凭据、--output-format json/toon、内置 --jq
  • 退出码区分 4 种情况:0 成功、1 运行/API 失败、2 用法或校验错误、3 鉴权失败;--agent-mode 输出结构化 JSON 错误
  • 还能管理托管 Agent 的沙箱环境、服务端凭据、Webhook 和 cron 触发器;Files API 上传文件保留 48 小时
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini 3.8 Flash⚡ Gemini Nano Banana 2.1⚡ Gemini Omni 1.1 Flash⚡ Lyria 3.5⚡ Gemini 3.8 Flash TTS🤖 Gemini API CLI🤖 Claude Code🤖 Codex🤖 Cursor🤖 Antigravity🤖 Deep Research🌐 Google

Ollama 原生支持 Recursive Flint 40B:首个 2.5B 激活参数轻量 MoE 编程智能体模型,MacBook Pro 跑出 125+ tok/s

由 Richard Socher 创办的 Recursive 正式开源 39.8B(40B)混合专家(MoE)编程智能体模型 Flint(RecursiveSI/flint),采用 Apache 2.0 协议并在 Ollama(ollama run flint)与 llama.cpp 全面开箱即用。该模型每 Token 仅激活 2.5B 参数,拥有 262K 超长上下文,在 M4 Pro MacBook Pro 上可实现 125+ tokens/秒的超高速本地推理。在 SWE-bench Verified 取得 74.2%、SWE-bench Pro v2 达到 89.7%,成为 50B 以下端侧运行最强编程智能体底座。

Ollama 原生支持 Recursive Flint 40B:首个 2.5B 激活参数轻量 MoE 编程智能体模型,MacBook Pro 跑出 125+ tok/s

核心要点速览

  • Flint 采用 49 层 Transformer 架构(2 层密集层 + 47 层 MoE 层),总参数 39.8B,每 Token 激活仅 2.5B 参数
  • 原生配备 262,144 tokens(256K)超长上下文窗口,支持端到端仓库级代码理解与跨文件缺陷定位
  • 本地推理性能极佳,M4 Pro MacBook Pro 达 125+ tok/s,64GB RTX Spark 可达 150+ tok/s
  • 在 SWE-bench Verified 取得 74.2%,SWE-bench Pro v2 达 89.7%,LiveCodeBench v6 斩获 80.3%,支持 ollama run flint 一键拉取
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

前沿 AI 初创公司 Inception 联合创始人 Stefano Ermon 宣布正式推出新一代扩散架构大语言模型 Mercury 3。模型在 NVIDIA GPU 上实现高达 1,068 Token/秒的超高生成吞吐,参数量达到前代 Mercury 1 的 40 倍并支持 100 万(1M)Token 原生上下文。在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 基准上全面对标前沿闭源基线,输入/输出百万 Token 标准定价为 0.20 / 0.70 美元(上线期半价优惠仅需 0.10 / 0.35 美元)。

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

核心要点速览

  • Inception 联合创始人 Stefano Ermon 正式发布扩散架构大模型 Mercury 3,在 NVIDIA GPU 上实现 1,068 Token/秒的超高吞吐
  • 模型参数扩充至 Mercury 1 的 40 倍,支持 100 万原生超长上下文(4 倍于 Mercury 2.5),标准定价百万输入/输出仅 0.20 / 0.70 美元
  • 在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 测试中表现亮眼,基准综合智能达到前代 3 倍且同步上线 OpenRouter
  • 彻底摆脱自回归逐字预测瓶颈,以并行扩散去噪实现亚秒级长文本代码生成,极大优化高并发 Agent 运行效率
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

192 万浏览引爆开发者圈!开源编程智能体 OpenCode 宣布免费开放 GLM 5.3 Flash 与 1M 上下文 Reflection Beam

高人气开源终端编程智能体 OpenCode(@opencode)连续发布重磅福利:正式向全量开发者免费开放智谱高速编码模型 GLM 5.3 Flash 以及 Reflection AI 最新开源的 501B/23B MoE 旗舰模型 Beam(支持完整 100 万 Token 上下文窗口)。其中 GLM 5.3 Flash 免费官宣推文在 X 平台单日狂揽逾 192 万次浏览与 1.75 万点赞,成为近期最受开发者追捧的零成本 AI 编程组合。

192 万浏览引爆开发者圈!开源编程智能体 OpenCode 宣布免费开放 GLM 5.3 Flash 与 1M 上下文 Reflection Beam

核心要点速览

  • 单推文狂揽 192 万浏览:OpenCode 宣布免费开放 GLM 5.3 Flash 引爆全球开发者社区,获 1.75 万点赞与 4100+ 收藏
  • 同步免费上线 1M 上下文 Beam:接入最新开源的 501B/23B 稀疏 MoE 旗舰 Reflection Beam(Terminal-Bench 2.1 达 80.1%),开放完整 100 万 Token 窗口
  • 零成本双剑合璧:开发者可在 OpenCode 终端内无缝切换 GLM 5.3 Flash(高频极速迭代)与 Beam 1M(全仓库跨文件重构)
阅读全文
关联模型 / 智能体 / 厂商:

破解 Agent 上下文遗忘症!KAIST 提出 RunningTab:首创环境侧标签页重构工作区长程交互

在实际软件工程与知识密集型交付任务中,自主 Coding Agent 通常以‘直接工作区交互(Direct Workspace Interaction, DWI)’的范式运作:通过终端命令直接检索、读取并修改本地代码库中的海量文件。然而,随着交互步数的拉长,Agent 极易遭遇严重的上下文失忆——初期提取的子任务需求被后续的大段文件内容挤出上下文窗口,而列出但尚未打开的潜在关键文件(Candidates)以及已读取证据的追溯链条(Provenances)也会随着模型滑动上下文丢失,导致 Agent 频繁出现漏解需求、死循环甚至‘在核心需求未完成前草率交付’的严重缺陷。韩国科学技术院(KAIST)的研究团队在最新研究(arXiv:2610.10444)中提出了创新框架 RunningTab。RunningTab 颠覆了依赖 Agent 自身注意力记忆或内部草稿纸(Scratchpad)的传统做法,首创了由执行环境托管的‘环境侧动态标签页(Environment-Side Tab)’。该标签页在交互全流程中独立追踪三大要素:结构化需求待办清单(Requirements)、带文件溯源的已读内容片段(Provenances)以及已罗列但未阅读的候选文件栈(Candidates)。在 Agent 尝试交付产物时,环境侧自动触发‘完成前置校验(Finish Check)’门禁,强制验证所有需求是否闭环。在 Workspace-Bench、TheAgentCompany 和 OfficeQA Pro 三大高难度真实工作区基准评测中,RunningTab 全面碾压原生 DWI 与自反思基线,在 TCR@70 指标上实现断崖式领先,论文与相关实现现已公开发布。

破解 Agent 上下文遗忘症!KAIST 提出 RunningTab:首创环境侧标签页重构工作区长程交互

核心要点速览

  • KAIST 提出 RunningTab 框架,首创环境侧动态标签页,彻底根治 Coding Agent 长程工作区上下文遗忘缺陷
  • 独立追踪需求待办、代码证据溯源与候选文件栈三大流,配备强制完成检查门禁杜绝草率交付
  • 在 Workspace-Bench 等三大基准上大幅超越原生基线,TCR@70 评分飙升至 25.67,消融实实验证实环境托管的必要性
阅读全文
关联模型 / 智能体 / 厂商:
⚡ RunningTab⚡ Direct Workspace Interaction⚡ Workspace-Bench🤖 RunningTab-Agent🤖 Finish-Checker🌐 KAIST🌐 Hugging Face🌐 TheAgentCompany

告别死板文本总结!香港科大与阿里提出 REMORY:残差记忆机制突破 5.2% 极限压缩,长程智能体不迷路

随着自主智能体(Autonomous Agents)在复杂网页操作、终端交互和超长程多步推理中的广泛应用,上下文窗口与推理成本的恶性膨胀已成为工业落地的最大路障。传统做法依赖‘自然语言文本总结(Textual Summarization)’或‘硬性剪枝(Token Pruning)’来压缩历史交互,但这两种方式不仅损耗大量关键细节与细粒度状态变量,还会在模型多次读取汇总时引发‘语义退化与失忆循环’。香港科技大学(HKUST)与阿里巴巴联合研究团队在最新研究(arXiv:2610.11287)中提出了颠覆性的 REMORY 框架。REMORY 创新性地在序列维度(Sequence Dimension)构建了‘残差记忆连接(Residual Connection)’:它将有损的宏观自然语言摘要作为‘主干通路’,同时通过轻量化模型学习一组高密度的软记忆向量(Soft Memory Tokens)作为‘残差通路’,专门捕捉摘要中丢失的细粒度操作细节、工具调用返回值与局部上下文关联。实测显示,REMORY 仅需占用完整上下文 5.2% 的输入位置,就能在 BrowseComp 复杂网页交互与 Terminal-Bench 2.1 长程终端基准上达到近乎等同于完整上下文的推理准确率,同时将智能体的重复尝试与死循环工具报错率削减逾 40%。

核心要点速览

  • 港科大与阿里联合提出 REMORY,在序列维度构建残差记忆连接(Residual Connection),攻克智能体长程上下文膨胀难题
  • 仅占用 5.2% 的 Token 位置即达到完整无损上下文 97.2% 的基准表现,在 Terminal-Bench 上使重复报错骤降 41.5%
  • 免侵入式即插即用集成,首字生成延迟(TTFT)降低 73.8%,为企业级长程 Agent 降本增效树立新标准
阅读全文
关联模型 / 智能体 / 厂商: