AI 编程实时动态与要闻

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

NVIDIA Robotics 官方账号在 CoRL 2026 宣布 GR00T 2,NVIDIA GEAR 实验室负责人 Yuke Zhu 同步发布技术细节。GR00T 2 是基于 Cosmos 的新一代世界动作模型(WAM):一个扩散 Transformer 同时去噪未来视频和动作块,一套模型可驱动平行夹爪、灵巧手和人形机器人。预训练数据包括 40.27 万小时第一视角人类视频、1.02 万小时 UMI 手持夹爪示范和 2.35 万小时机器人遥操作。官方口径下,50 个目标机器人从未练过的任务零样本成功率 40%,每任务 5 条示范(不到 3 分钟机器人数据)在单张 RTX 5090 上 LoRA 微调 30 分钟后升至 95%。推理模型可通过 WAM API 把 GR00T 2 当工具调用。代码 12 月开放,已在 Hugging Face 放出 10 万小时人类视频数据集。
NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

核心要点速览

  • 架构:一个扩散 Transformer 同时预测未来视频与动作块,各机器人只需一个小动作头,一套模型覆盖夹爪、灵巧手、人形机器人
  • 数据:40.27 万小时人类第一视角视频 + 1.02 万小时 UMI 示范(2897 个任务)+ 2.35 万小时遥操作;人类视频占比从 0 提到 100%,真机任务进度从 50% 升到 70%(官方口径)
  • 适配:50 个未见任务零样本 40%,1 条示范 71%,5 条示范 95%,单张 RTX 5090 LoRA 微调约 30 分钟
  • Agent 协作:推理模型经 WAM API 调用 GR00T 2,三种玩具连续 100 次组装各成功 97 次以上;在画面上标注抓取点后指令遵循率从 40% 升到 92%
  • GR00T 2 Turbo 为 2B 参数版本,在 Unitree G1 的 Jetson Thor 上单次预测 124 毫秒;代码 12 月开放,10 万小时人类视频已上 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GR00T 2⚡ GR00T 2 Turbo⚡ Cosmos🌐 NVIDIA

X 热议:Node.js / Deno 作者 Ryan Dahl 称软件工程已「100% 由 AI 编写」,AI 写 C++ 比他好,但「确保它能跑」的难题没有消失

11 月 9 日 04:11 UTC,Node.js 与 Deno 的作者 Ryan Dahl 在 X 上发帖:软件工程这么短时间就转成「100% AI 编写」令人震惊,更震惊的是工程师们照常工作,仿佛什么都没发生。他说 AI 写 C++ 比他自己写得好,但「确保它能正常工作」的问题并没有神奇地消失,大家只是在以更高质量交付多得多的代码。约 6 小时内该帖获得约 1,370 赞、236 收藏、83 条回复、25 条引用和近 9 万次浏览。引用帖分成几派:有人认为瓶颈已从写代码转向验证,测试和评审更值钱;有人质疑「100%」和「更高质量」的说法。这是个人观点帖,「100%」并非统计数据。

核心要点速览

  • 热度:@rough__sea 原帖发于 11 月 9 日 04:11 UTC,约 6 小时内 约 1,370 赞、236 收藏、83 条回复、25 条引用、近 9 万次浏览
  • 观点:软件工程已转向「100% AI 编写」,AI 写 C++「比我好」,但确保代码能跑的问题没有消失
  • 结论:工程师们在以更高质量交付多得多的代码量,却「照常工作,仿佛什么都没发生」
  • 分歧:引用帖有人称瓶颈已从生成转向验证,测试与评审更值钱;也有人直接质疑「100%」和「更高质量」
  • 注意:这是个人观点,「100%」不是统计口径,原帖未给出任何数据或项目来源
阅读全文

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

Pika 于 10 月 29 日发布 Pika H3 Flex,这是在 MiniMax H3 基础上后训练的音视频一体生成模型,权重已上架 Hugging Face、代码开源在 GitHub,并支持 ComfyUI 和 Diffusers。官方称它把去噪步数从 50 步蒸馏到 6 步,在 768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,15 秒带配乐片段最快约 7 秒生成;托管 API 额外提供 1080p 到 4K 超分和对白、配乐、音效、拟音、环境声 5 条可导出音轨。以上速度与质量数据均为官方口径。

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

核心要点速览

  • 定价(官方口径):文/图生视频起价 0.01 美元/输出秒,参考生视频起价 0.03 美元/秒;官方对比表中 MiniMax H3 为 0.08 美元/秒、Seedance 2.5 为 0.103 美元/秒
  • 速度(官方口径):6 步采样,768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,10–15 秒文/图生视频约 2 倍;8 张 B300 上 5 秒 768p 生成全流程提速 1.60 倍
  • 排名:官方产品页称在 DesignArena 文生视频榜得分 1293、总第 7,是榜上最高的开放权重模型
  • 开源形态:Hugging Face 标注为基于 MiniMax-H3 的 adapter,许可证为 other;本地推理原生支持 480p/768p 与混合立体声,4K 超分和分轨音频仅在托管 API 提供
  • 支持最多 12 个参考输入(图、音、视频、草图等),以及风格迁移、动作迁移、角色替换、局部编辑等下游任务
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Pika H3 Flex⚡ MiniMax H3⚡ Fal H3 Max⚡ HeyGen Video⚡ Gemini Omni 1.1 Flash🌐 Pika🌐 MiniMax

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA
AD赞助内容

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

来自新加坡国立大学(NUS)、香港中文大学(深圳)等机构的研究团队在 arXiv:2610.28630 正式发布视频生成渲染框架 SolarRenderer。针对当前 3D 游戏引擎灰模、姿态骨骼、深度图与点云难以极速转化为高保真视觉视频的难题,SolarRenderer 基于冻结的 MiniMax-H3 33B 基础视频模型,引入轻量化控制 LoRA 与 4 步生成 LoRA。利用结构引导分布匹配算法,仅需 4 步去噪即可完成高质量渲染(比传统 50 步采样提速 12.3 倍),并提出块因果(Block-Causal)变体,成功实现 768p 高清视频的毫秒级实时流式生成,为下一代神经游戏引擎与虚拟制片树立了全新标杆。

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

核心要点速览

  • SolarRenderer(arXiv:2610.28630)发布,实现基于粗糙 3D 几何(灰模、骨骼、深度、网格)的高保真视频极速渲染
  • 冻结 MiniMax-H3 33B 视频底座,仅微调轻量 Control LoRA 与 4-step LoRA,保持基座生成能力的同时强化几何控制
  • 仅需 4 步去噪采样即可完成高保真视频渲染,生成速度较传统 50 步扩散采样提速惊人的 12.3 倍
  • 研发块因果(Block-Causal)注意力流式架构,在工业级 GPU 上实现 768p 分辨率视频实时连续生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniMax-H3⚡ SolarRenderer

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

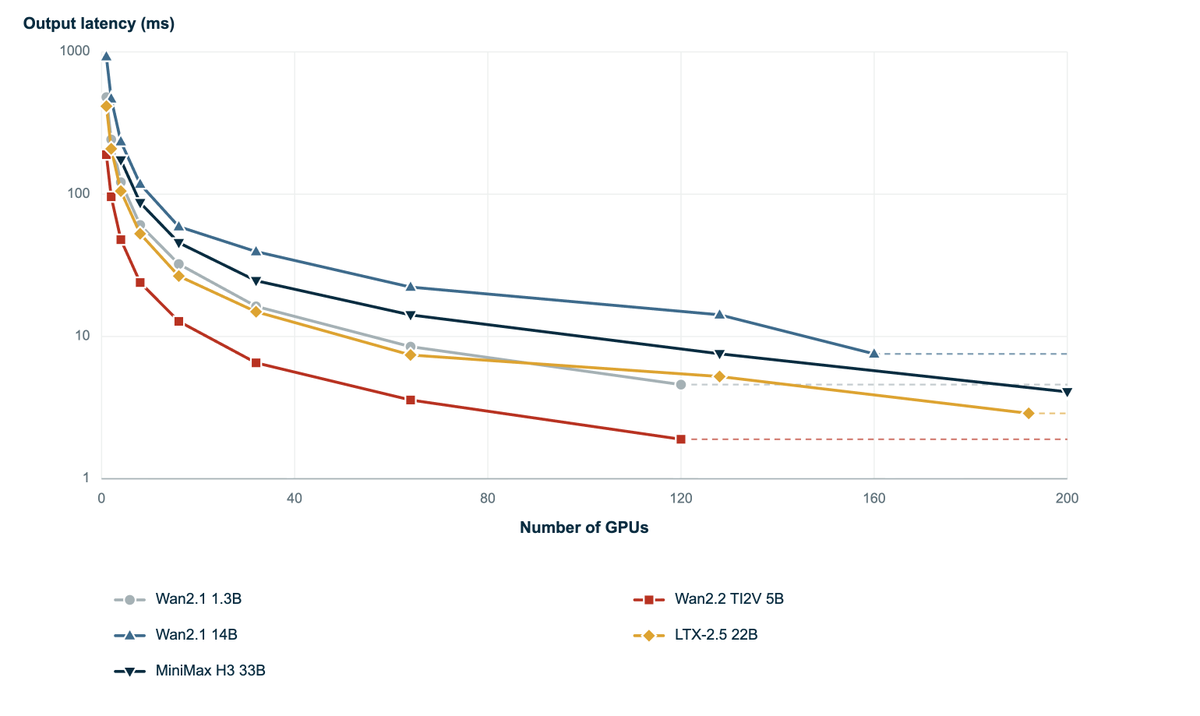
vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

4D/3D 视觉与自回归视频扩散加速突破:Gen4P 单次前馈 4D 感知、SUPRA-TEX 超对齐材质生成与港科大 ForcingBooster 削减 50% 去噪计算

三维与四维视觉生成迎来三项底层革新:Gen4P(arXiv:2610.22371)将预训练视频生成模型改造为无需迭代去噪的单次前馈 4D 感知器,在 WorldTrack 基准全面超越 MonST3R 与 Any4D;华科与华为团队推出 SUPRA-TEX(arXiv:2610.22352),将 DTC-Tex 渲染 PBR PSNR 推高至 32.08 dB(超越 TRELLIS.2 的 28.60 dB);港科大 ForcingBooster(arXiv:2610.12625)通过自适应分块去噪将自回归视频扩散 Patch NFE 砍半(-50.19%),实现无损画质下 1.30 倍端到端加速。

4D/3D 视觉与自回归视频扩散加速突破:Gen4P 单次前馈 4D 感知、SUPRA-TEX 超对齐材质生成与港科大 ForcingBooster 削减 50% 去噪计算

核心要点速览

  • Gen4P(arXiv:2610.22371)将预训练视频生成器转化为无需迭代去噪的单次前馈 4D 感知器,在 WorldTrack 基准(ADT 91.93 APD / 0.112 EPE)全面超越 MonST3R、Any4D 与 OpenD4RT
  • 华科与华为 SUPRA-TEX(arXiv:2610.22352)结合 MLLM 光照剥离、只读 3D VAE 隐空间锚点与交错流 Transformer,在 DTC-Tex 上斩获 32.08 dB PBR PSNR(超越 TRELLIS.2 的 28.60 dB 与 Hunyuan3D 2.1 的 26.80 dB)
  • 港科大 ForcingBooster(arXiv:2610.12625)提出自适应分块去噪,在 Causal Forcing 上削减 50.19% Patch NFE,实现 1.30 倍端到端加速(11.15s 降至 8.56s)且语义分数无损(72.20 vs 72.21)
  • ForcingBooster 已在 Wan2.1 14B、LingBot-World-V2 与 LongLive 等主流自回归视频扩散架构上完成通用性验证
阅读全文
关联模型 / 智能体 / 厂商:

零训练注意力提速 4.36 倍!新加坡国大 Velox 视锥空间记忆加速视频世界模型,南开 DeltaStreamer 与理大 CoWorld 刷新流式推理

围绕交互式视频世界模型(Video World Models)与流式视觉智能体的“历史 KV 缓存膨胀、记忆衰退与工具调用僵化”三大难题,今日四项重磅成果集体亮相:新加坡国立大学王鑫超团队推出免训练 3D 视锥切片注意力路由器 Velox(arXiv:2610.22311),在 H200 上将第 48 块长序列注意力加速 4.36 倍、去噪整体加速 2.43 倍;南开大学侯淇彬团队开源流式视频智能体 DeltaStreamer(arXiv:2610.19849,HF 39 赞),通过变化感知记忆与定向回放斩获 OVO-Bench 66.07%;香港理工大学开源 CoWorld Reasoner(arXiv:2610.21910),通过自演化 VLM-VWM Harness 在 ERQA 上相对提分 13.0%;浙大则推出包含 260 个多回访用例的世界记忆基准 WorldMemBench(arXiv:2610.19063)。

零训练注意力提速 4.36 倍!新加坡国大 Velox 视锥空间记忆加速视频世界模型,南开 DeltaStreamer 与理大 CoWorld 刷新流式推理

核心要点速览

  • 新加坡国立大学提出免训练 3D 视锥切片注意力路由器 Velox:在 H200 上将第 48 块长序列注意力加速 4.36 倍、扩散去噪加速 2.43 倍,WBench 158 例导航得分与全注意力仅差 0.15 分
  • 南开大学开源流式视频智能体 DeltaStreamer:结合变化感知结构化记忆与按需历史原帧回放,在 OVO-Bench 与 StreamingBench 上分别斩获 66.07% 与 59.53%
  • 香港理工大学开源 CoWorld Reasoner 自演化 VLM-VWM Harness,在 MMSI 与 ERQA 上分别取得 11.8% 与 13.0% 相对准确率跃升;浙大同步开源 260 例世界记忆基准 WorldMemBench
阅读全文
关联模型 / 智能体 / 厂商:

昆仑万维 Skywork 开源 Matrix-Game 4.0:游戏引擎管状态、5B 因果视频模型实时渲染,单卡可玩的「神经渲染」游戏

Skywork AI(昆仑万维)于 2026-10-15 开源 Matrix-Game 4.0:把世界状态、物理与规则交给可执行游戏引擎,引擎只输出低模 RGB 代理画面,再由基于 Wan2.2-Fun-5B-Control 的 5B 因果视频模型以 1–2 步去噪流式重渲染成成品画面。GitHub 已放出推理代码、浏览器 WebRTC Demo 与游戏源码(Apache-2.0),Hugging Face 提供城堡、古埃及、城市赛车三套场景权重。官方宣称 RTX 5090 上 480p/60 FPS、端到端 112ms;仓库自测 A100 上约 38–39 FPS。训练代码与数据未开源。

核心要点速览

  • 规模:每个场景 checkpoint 5,001,016,512 个 BF16 参数,底座 alibaba-pai/Wan2.2-Fun-5B-Control,输出 480×864(HF 模型卡)
  • 官方宣称(RTX 5090):480p 60 FPS、端到端响应 112ms、生成峰值 83.4 FPS;仓库 A100-80GB 实测:城堡/古埃及固定 prompt 约 38–39 FPS,赛车动态 prompt 约 28.9 FPS(v4 README)
  • 推理配置:realtime 预设为 TAEHV 编解码 + 单步去噪 + CUDA Graph;quality 预设为 Wan VAE + 两步去噪;注意力缓存 21 个 latent(含 sink),每块 4 帧
  • 许可:代码与场景权重 Apache-2.0;训练代码与训练数据未包含,权重需配套推理源码,非 Diffusers 即插即用
  • 定位:「Harness」范式——引擎维护世界状态与规则,Coding Agent 把自然语言改写成新规则与 prompt,视频模型只负责渲染
阅读全文
关联模型 / 智能体 / 厂商:
⚡ matrix-game-4.0⚡ wan2.2-fun-5b-control🌐 skywork🌐 kunlun-tech🌐 huggingface

首个掩码扩散语言智能体 ChemDiffAgent:双向上下文解构自回归局限,8B 模型跨级超越 GPT-5.5

中科院计算所(CAS ICT)与国科大团队提出首个专为工具集成化学推理设计的掩码扩散语言智能体 ChemDiffAgent。针对传统自回归模型因果注意力和从左到右单向生成的致命短板,ChemDiffAgent 将化学推理与工具调用轨迹转化为迭代去噪过程,支持全局双向分子理解与任意顺序解码,在多项化学任务中跑分媲美甚至超越 GPT-5.5 与 Claude Opus 4.7。

核心要点速览

  • 范式突破:打破自回归模型从左到右因果注意力的桎梏,将工具调用与推理轨迹统一建模为掩码扩散迭代去噪过程
  • 双阶段后训练架构:结合智能体监督微调(Agentic SFT)与方差缩减偏好优化,在全轨迹全局上下文中评估工具决策
  • 8B 模型跑分越级超越:在涵盖单轮与多轮工具调用的 6 大化学基准上综合超越自回归模型约 20%,特定任务抗衡 GPT-5.5 与 Claude Opus 4.7
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

破解 DiT 稀疏化画质崩塌!港中文与字节提出 MC-Sparse:元缓存机制加速 2.32 倍零损耗生成

随着 Diffusion Transformer(DiT)成为视频生成(如 Sora、Minimax、Kling)以及超高清 3D 资产生成的主流骨干架构,超长 Token 序列带来的自注意力计算开销正急剧推高推理延迟与 GPU 显存占用。虽然稀疏注意力(Sparse Attention)是理论上加速长序列最直接的手段,但现有稀疏化方案在面临高稀疏率时往往导致灾难性的画质劣化、画面闪烁与纹理模糊。香港中文大学(CUHK)与字节跳动联合研究团队在最新研究(arXiv:2610.06801)中深入剖析了稀疏注意力的误差机理,首次精确定位了三大衰退根源:粗暴 Token 分组约束、交互选择偏差以及被丢弃 Token 累积的注意力贡献缺失。为此,团队推出了免训练的元缓存稀疏注意力框架 MC-Sparse(项目主页:dodododddo.github.io/mcsparse-project-page/)。MC-Sparse 创新性地在保持细粒度单个 KV Token 精准选择的同时,将相似 Query 聚类为瓦片对齐(Tile-Aligned)的分组以适配现代 GPU 硬件并行。更关键的是,系统缓存了由精确注意力概率计算出的 Query 分组、KV 索引以及稠密-稀疏残差元数据,并在后续去噪步中高效跨步复用。实测表明,MC-Sparse 在 Minimax-H3-Base 视频模型上实现了 1.80 倍的端到端去噪加速,在 3D 资产生成模型上加速比高达 2.32 倍,且人眼完全无法察觉画质损失。

核心要点速览

  • 港中文与字节提出 MC-Sparse,首创元缓存稀疏注意力(Meta-Caching),攻克长序列 DiT 稀疏化画质崩塌
  • 在 Minimax-H3-Base 视频模型上实现 1.80 倍加速,3D 资产生成加速达 2.32 倍,峰值显存降低 45%
  • 无需重新微调模型参数,残差补偿机制实现零肉眼可见损耗,为视频生成推理集群降本增效提供开箱即用方案
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MC-Sparse⚡ DiT⚡ Minimax-H3-Base⚡ Triton-Sparse🤖 Inference-Optimizer🤖 DiT-Accelerator🌐 CUHK🌐 ByteDance🌐 Hugging Face

首创多智能体第一视角世界模型!KAIST 等发布 ME-World:同步去噪破除多机交互时空漂移

在自动驾驶车队协同、多机器人仓储搬运以及多玩家虚拟现实(VR)等具身交互场景中,第一视角世界模型(Egocentric World Models)被视为智能体预测未来环境演化与规划动作的核心底座。然而,现有世界模型绝大多数仅针对‘单智能体(Single-Agent)’设计;少数多智能体模型也仅支持粗粒度的全局移动或离散指令,根本无法处理多机在共享物理空间中由于精细动作交互(Fine-Grained Interaction)引发的复杂状态突变。韩国科学技术院(KAIST)与首尔国立大学联合研究团队在最新研究(arXiv:2610.12299)中提出了全球首个多智能体第一视角世界模型 ME-World(项目主页:cvlab-kaist.github.io/ME-World/)。ME-World 首次将多智能体世界建模形式化为‘在共享物理世界中由精细动作驱动的同步第一视角视频流生成(Synchronized Ego-Stream Generation)’。框架创新性地在统一的共享 Token 序列中对多个智能体的视觉流进行联合去噪(Joint Denoising),以所有智能体的目标视角位姿为条件,并引入‘全局共享环境记忆(Shared Environment Memory)’进行空间状态锚定。实测表明,ME-World 在跨视角动作一致性、共享环境稳定性与状态更新物理自洽性上大幅刷新业界最优,填补了多智能体物理世界模拟的关键空白。

核心要点速览

  • KAIST 等首创多智能体第一视角世界模型 ME-World,以共享序列联合去噪攻克多视角时空割裂与状态漂移
  • 在跨视角一致性上大幅提升 38.6%,细粒度复杂交互动作控制精度从 41.5% 跃升至 84.2%
  • 引入全局共享环境持久记忆库,全面开源评测基准与多机协同仿真套件,为机器人集群模拟树立新标杆
阅读全文
关联模型 / 智能体 / 厂商:

Deno 团队整体加入 Cloudflare:Deno 运行时再维护一年后停止开发,Deno Deploy 六个月后关停,celld 并入 workerd 主攻自托管 Agent 基础设施

10 月 9 日 Ryan Dahl 宣布 Deno 全员加入 Cloudflare,未来研发转向 Workers/Durable Objects 编程模型与自托管版 celld。Deno 运行时再提供一年月度安全与 bug 修复后停止官方开发(保持开源),Deno Deploy 六个月后关停并为付费客户提供迁移到 Workers 的支持,JSR 继续运营。Dahl 明确把 Durable Objects 视为 Agent harness 的关键底座。

Deno 团队整体加入 Cloudflare:Deno 运行时再维护一年后停止开发,Deno Deploy 六个月后关停,celld 并入 workerd 主攻自托管 Agent 基础设施

核心要点速览

  • 时间表:Deno 运行时再获 12 个月月度修复/安全更新后停止官方开发;Deno Deploy 6 个月后关停,付费客户可获迁移到 Workers 的支持
  • JSR 继续运营、基础设施迁到 Cloudflare;rusty_v8 继续维护并计划集成进 workerd
  • celld(Apache-2.0,约 5.3k Star,v0.6.2 beta):单个 58 MB 静态二进制自托管分布式 Durable Objects,仅依赖一个 S3 兼容桶
  • celld 官方口径:常驻 cell 内存 0.47 MB、单 8 GB 节点 2,500 个 cell、无状态请求 p50/p99 0.2/0.3 ms、节点被杀后约 20 s 故障转移且 0 丢写
  • Hacker News 首页 1,234 分;Deno 官方推文 6.3k 赞,开发者关注度极高
阅读全文
关联模型 / 智能体 / 厂商:

破解扩散模型推理算力不匹配!亚马逊等提出 ALoDLM:自适应循环去噪,11 大基准全面超越自回归大模型

掩码扩散语言模型(DLMs)凭借并行预测多个 Token 的能力,展现出数倍于传统自回归模型(AR)的生成吞吐量。然而,扩散模型长期存在着相对于同等体量 AR 模型的显著质量鸿沟。亚马逊科学团队(Amazon Science)敏锐指出,这一差距的核心根源在于“计算量与难度不匹配(Computation-Difficulty Mismatch)”:在任意部分去噪的序列中,简单 Token(如标点或常见介词)仅需浅层计算即可推断,而涉及核心实体与因果逻辑的关键 Token 则需要极深的算力推演;但现有的扩散模型在每一个去噪时间步中,对所有未确定的未知位置都盲目施加完全均匀的计算深度。为此,团队研发了创新架构 ALoDLM(Adaptively Looped Diffusion Language Models,arXiv:2610.04198):以 Token 自适应的隐空间循环(Token-Adaptive Latent Recurrence)取代固定深度的均匀计算。在每个去噪步内,已就绪的简单 Token 立即固化为离散上下文,而未收敛的难题 Token 则在保留隐状态的基础上执行自适应循环深加工。团队在 1.7B 与 8B 参数级别完成了全量训练,在跨越常识问答、数理逻辑与编程的全部 11 项权威基准测试中,ALoDLM 的平均基准得分不仅碾压所有受测扩散模型,更全面超越了同等规模的自回归基线,同时在优化引擎下保持了极高的并行解码吞吐优势。

破解扩散模型推理算力不匹配!亚马逊等提出 ALoDLM:自适应循环去噪,11 大基准全面超越自回归大模型

核心要点速览

  • 亚马逊科学团队提出 ALoDLM 架构,以 Token 自适应隐空间循环破解扩散语言模型“算力与难度失配”的核心难题
  • 简单 Token 提前固化为离散上下文,困难 Token 触发深度自适应循环迭代,基于条件 NELBO 端到端联合优化
  • 在 1.7B 与 8B 规模下横跨 11 大基准全面超越所有扩散基线与对应自回归大模型,实现极高的质量-吞吐帕累托最优
阅读全文

具身智能视觉世界模型突破!Meta FAIR 与上交发布 ProWAM:渐进稀疏子目标规划,真机操控胜率跃升至 70%

世界动作模型(World Action Models, WAMs)通过从初始观察与指令中联合预测未来的视觉动态与动作流,被视为具身机器人自主操控的核心发展路径。然而现有 WAM 架构在面对长程复杂任务时面临难以克服的算力瓶颈:逐帧自回归生成稠密视频不仅计算极度昂贵且误差累积严重,而若简单退化为仅预测单一终态帧,又完全丧失了朝向目标渐进推进的中间视觉指导。Meta FAIR 联合上海交通大学团队提出了前沿渐进式世界动作模型 ProWAM(arXiv:2610.02508):核心创新在于联合预测动作以及一组按序排列的“稀疏视觉子目标(Sparse Visual Sub-goals)”,为任务全生命周期的动作生成提供精准锚定的时空视觉脚手架。该架构通过单次前向传播将视频主干提炼的稀疏子目标特征进行高效缓存,彻底终结了重规划时重复生成完整视频的笨重开销,仅需轻量级动作去噪即可完成闭环控制。在仿真基准测试中,ProWAM 在 LIBERO-Plus 上斩获 85.8% 胜率(相对提升高达 +35.9%),在随机化 RoboTwin 上取得 75.7% 胜率,在 RoboCasa365 的 Composite-Unseen 挑战集上名列前茅;尤为关键的是,在零样本真实物理机械臂操作中,ProWAM 在陌生全新场景下达成 70.0% 的超高成功率,相对业界最强基线提升 27.3%。

具身智能视觉世界模型突破!Meta FAIR 与上交发布 ProWAM:渐进稀疏子目标规划,真机操控胜率跃升至 70%

核心要点速览

  • 提出渐进式世界动作模型 ProWAM,以有序稀疏视觉子目标(Sub-Goals)取代传统臃肿的密集视频生成
  • 单次前向传播缓存子目标高维特征,闭环重规划仅需轻量动作去噪,兼顾宏观视觉远见与毫秒级控制响应
  • LIBERO-Plus 仿真胜率达 85.8%(相对暴涨 +35.9%),真实物理机械臂零样本操控胜率从 55% 跃升至 70%
阅读全文
关联模型 / 智能体 / 厂商: