AI 编程实时动态与要闻

生成式媒体推理平台 fal 宣布 Series E 和 F 合计融资 16.5 亿美元:Sequoia、Bessemer 领投,NVIDIA 继续跟投

托管图像、视频、音频模型推理的 fal 于 11 月 3 日在官方 X 账号和博客宣布,Series E 与 Series F 两轮合计融资 16.5 亿美元:Series E 由 Sequoia Capital 领投(今年早些时候完成),Series F 由 Bessemer Venture Partners 领投,NVIDIA 继续投资。fal 官方未公布估值和各轮金额;据 Bloomberg 报道,Series F 为 13 亿美元、估值 160 亿美元,较 4 月的 80 亿美元翻倍。官方称资金将用于扩充推理算力和团队,支持 2027 年的研究与平台建设。

生成式媒体推理平台 fal 宣布 Series E 和 F 合计融资 16.5 亿美元:Sequoia、Bessemer 领投,NVIDIA 继续跟投

核心要点速览

  • 官方确认:Series E + F 合计 16.5 亿美元,Sequoia 领投 E 轮,Bessemer 领投 F 轮,NVIDIA 继续投资(fal 博客)
  • 官方未公布估值;据 Bloomberg 报道 Series F 为 13 亿美元、估值 160 亿美元,Series E 为 3.5 亿美元、估值 80 亿美元
  • 据 Bloomberg,CEO Burkay Gur 称夏天需求暴涨到不得不对客户限流,这是大额融资的直接原因
  • 资金用于推理算力和团队扩张,以及 2027 年的新研究;fal 平台托管 Seedance、Kling、Veo、FLUX 等大量第三方媒体模型
阅读全文

CrowdStrike 宣布收购 Fiddler 与 Dreadnode,并上线 AI Kill Switch:把智能体可观测、上线前攻防测试和一键终止都收进 Falcon

CrowdStrike 于 11 月 3 日在巴塞罗那 Fal.Con Europe 宣布签署最终协议,收购 AI 智能体可观测公司 Fiddler AI 和自动化 AI 安全测试公司 Dreadnode,同时在 Falcon Guardian 中上线 AI Kill Switch,可在智能体失控时终止进程、阻止重启并切断企业网络访问。两笔收购预计在 FY27 第四季度完成,对应产品同季度 GA。官方未披露价格;据 CyberScoop 转引《华尔街日报》,Fiddler 约 4 亿美元、Dreadnode 约 9500 万美元。

CrowdStrike 宣布收购 Fiddler 与 Dreadnode,并上线 AI Kill Switch:把智能体可观测、上线前攻防测试和一键终止都收进 Falcon

核心要点速览

  • 两笔收购同日宣布,均预计在 CrowdStrike FY27 第四季度完成,支付以现金为主,另含部分附归属条件的股票。
  • 据 CyberScoop 转引《华尔街日报》:Fiddler 约 4 亿美元、Dreadnode 约 9500 万美元,合计约 4.95 亿美元;CrowdStrike 官方未披露金额。
  • Fiddler 将以 Falcon Observe 名义销售:上线前评估、跨智能体层级的决策与工具调用追踪、漂移和幻觉检测,并称用专用模型可把评估成本最多降低 98%。
  • Dreadnode 内置 100 多种已知 AI 攻击策略(越狱、提示注入、多轮及智能体专用攻击),可测试模型、智能体推理循环、应用和 MCP 服务器,结果映射到 OWASP LLM Top 10、OWASP Agentic ASI01-ASI10、MITRE ATLAS 和 NIST AI RMF。
  • AI Kill Switch 今天即可使用:由授权管理员触发,先在网关层终止智能体(端点层即将支持),阻止重启并切断网络,全程写入审计日志。
阅读全文

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

a16z 10 月 30 日发布的 Charts of the Week(作者 Moses Sternstein)讨论了「Rack Spread」:GPU 租金在涨,token 价格在跌。a16z 官方 X 账号 10 月 31 日总结:5 月以来 token 均价下降 67%,token 花费增长超过 120%;按文章的粗算,用 Ramp 数据得出约 122%,用 Ornn 混合单价乘 OpenRouter 用量得出约 160%。另一条帖子给出 7 月中以来 B300 租金涨 106%、B200 涨 66%、H100 涨 17%。a16z 同时强调这些指数样本小且有偏差,不能代表真实总需求。

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

核心要点速览

  • 价格与花费:5 月以来 token 均价降 67%,token 花费涨超 120%(a16z 官方 X 帖,a16z 口径)
  • 两种粗算:Ramp 的 token 花费数据约 +122%;Ornn 混合单价 × OpenRouter 用量约 +160%(Charts of the Week,作者自称是粗算而非严谨方法)
  • GPU 租金:7 月中以来 B300 +106%、B200 +66%、H100 +17%,同期 token 均价 -58%(a16z 帖子)
  • 人均 AI 支出:亚特兰大联储调查的均值超过每员工 1,000 美元,Ramp 的中位数是每月 15.70 美元(每年 188 美元)
  • 热度:两条帖子约 371 和 492 赞、3.8 万和 9.6 万浏览(截至 18:15 SGT)
阅读全文

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

Pika 于 10 月 29 日发布 Pika H3 Flex,这是在 MiniMax H3 基础上后训练的音视频一体生成模型,权重已上架 Hugging Face、代码开源在 GitHub,并支持 ComfyUI 和 Diffusers。官方称它把去噪步数从 50 步蒸馏到 6 步,在 768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,15 秒带配乐片段最快约 7 秒生成;托管 API 额外提供 1080p 到 4K 超分和对白、配乐、音效、拟音、环境声 5 条可导出音轨。以上速度与质量数据均为官方口径。

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

核心要点速览

  • 定价(官方口径):文/图生视频起价 0.01 美元/输出秒,参考生视频起价 0.03 美元/秒;官方对比表中 MiniMax H3 为 0.08 美元/秒、Seedance 2.5 为 0.103 美元/秒
  • 速度(官方口径):6 步采样,768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,10–15 秒文/图生视频约 2 倍;8 张 B300 上 5 秒 768p 生成全流程提速 1.60 倍
  • 排名:官方产品页称在 DesignArena 文生视频榜得分 1293、总第 7,是榜上最高的开放权重模型
  • 开源形态:Hugging Face 标注为基于 MiniMax-H3 的 adapter,许可证为 other;本地推理原生支持 480p/768p 与混合立体声,4K 超分和分轨音频仅在托管 API 提供
  • 支持最多 12 个参考输入(图、音、视频、草图等),以及风格迁移、动作迁移、角色替换、局部编辑等下游任务
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Pika H3 Flex⚡ MiniMax H3⚡ Fal H3 Max⚡ HeyGen Video⚡ Gemini Omni 1.1 Flash🌐 Pika🌐 MiniMax
AD赞助内容

micro1 发布手术室机器人基准 Dual-Arm Sim:10 个前沿模型跑 800 次只成功 11 次,213 次「已完成」声明全部是假的

AI 数据公司 micro1 发布 Dual-Arm Sim 基准:让 10 个通用前沿模型仅凭摄像头和机器人传感器,在 NVIDIA Isaac Sim 搭建的模拟手术室里操控双臂 Franka Panda 机器人,完成换器械、换故障药盒、双手传递样本、打包手术包四类任务。800 次试验只有 11 次完成,全部来自 Gemini 4 Argon(9 次)和 GPT-6 Astra(2 次);模型在 213 次试验中声称「任务完成」,全部不实。药盒换药任务的 200 次完整轨迹已公开在 Hugging Face。

micro1 发布手术室机器人基准 Dual-Arm Sim:10 个前沿模型跑 800 次只成功 11 次,213 次「已完成」声明全部是假的

核心要点速览

  • 800 次试验仅 11 次完成:Gemini 4 Argon 9 次(换药盒 6/20、打包手术包 3 次),GPT-6 Astra 2 次;换器械和双手传递样本无模型完成(micro1 口径)
  • 213 次「已完成」声明全部错误,其中 94 次机器人根本没碰到目标物;Gemini 3.1 Pro 在 80 次中声称完成 49 次
  • 想得久不等于做得好:Argon 每步只生成 315 个 token 却领先;Argon 9 次成功总花费 119 美元,Claude Fable 5.1 花 839 美元一次未成
  • 失手后的恢复是关键:Argon 和 Astra 约三分之二能重新抓到,Grok 4.7 在 80 次里只恢复 3 次;首次位置估计中位数偏差 33 厘米
  • 被举起的故障药盒有 14 次掉到地上、11 次掉在推车上,只有 8 次被正确替换
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:

Shopify Fall ’26 Edition 押注智能体电商:Shop.md 购物 skill、Shop.dev 一站接入,Shop Pay 进入 Muse、Claude Duet、Grok Bot 等个人 agent

Shopify 于 10 月 28 日发布第 10 期 Edition(Fall ’26,主题 Exponential,150+ 项更新、57 项开发者更新),核心是把商品目录、购物车和结账开放给任何 agent:Shop.dev 用一条连接提供 Shopify Catalog(10 亿+ 商品)、Shop 登录、购物车、结账和 Shop Pay;Shop.md 是可定制的购物 skill,可让 ChatGPT、Claude 等 agent 变成个人导购;Shop Pay 已进入 Meta 的 Muse、Claude Duet、Instinct,Claude Duet、Grok Bot 和 Instinct 还可用它购买非 Shopify 品牌;每个 Liquid/Hydrogen 店面和结账页都内置 WebMCP 工具。

Shopify Fall ’26 Edition 押注智能体电商:Shop.md 购物 skill、Shop.dev 一站接入,Shop Pay 进入 Muse、Claude Duet、Grok Bot 等个人 agent

核心要点速览

  • 规模(官方口径):Shopify Catalog 10 亿+ 商品,Shop Pay 用户 4 亿+;本期共 150+ 项更新,其中开发者更新 57 项
  • Shop.dev 一条连接覆盖 Catalog、Shop 登录、购物车、结账和 Shop Pay;底层 Shop MCP 地址为 mcp.shop.com,搜索无需 API key
  • Shop Pay 进入个人 agent:首批 Muse(Meta)、Claude Duet、Instinct;Claude Duet、Grok Bot、Instinct 还可买非 Shopify 品牌,卡号不会交给 agent,由 Mastercard、Visa、Discover 令牌保障,Amex 即将支持
  • WebMCP:每个 Liquid 和 Hydrogen 店面与结账页内置工具,浏览器 agent 可结构化搜索、改购物车,并在买家确认后完成结账
  • 开发侧:Shopify CLI 的 AI Toolkit 一条命令做应用安全检查;Hydrogen 重构后 GA,Vercel Shop(Next.js 开源模板)同步 GA
阅读全文

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

OpenAI 10 月 26 日发布博文,称其内部模型在数学、计算机科学和物理上各得到一项新结果:证明 Sogge 局部光滑化猜想在所有维度成立(进而推出 Kakeya 与 Stein 限制猜想);证明指数时间假设(ETH)为假,并已用 Lean 验证;给出四维 QCD 及含 Yang–Mills 在内的量子场论的严格存在性证明。数学和 CS 结果的论文与 Lean 证明已放到 GitHub 的 openai/math 仓库,物理结果由 David Gross 牵头的外部小组先行整理、暂不公开。这些都是官方口径,尚待学界独立验证。

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

核心要点速览

  • 计算机科学(官方口径):论文给出一个确定性算法,在亚指数时间、多项式空间内精确计数定宽 CNF 公式的满足赋值,3-SAT 情形即证伪 ETH;AI 于 10 月 16 日得出证明,10 月 17 日完成 Lean 形式化
  • ETH 由 Impagliazzo、Paturi 和 Zane 提出,已被数百篇论文用作条件下界;验证小组由 Impagliazzo、Paturi(UC San Diego)和 Ryan Williams(MIT)牵头,OpenAI 承诺资助一场专题会议
  • 数学:证明局部光滑化猜想在所有空间维度 n≥2 成立,推出 Kakeya、Nikodym 极大猜想与 Stein 限制估计;此前仅有 2019 年的二维证明和 2025 年的三维 Kakeya 证明
  • 物理:Yang–Mills 存在性的自然语言证明 9 月 9 日完成、QCD 9 月 18 日完成,Yang–Mills 部分的 Lean 形式化 10 月 16 日完成;材料由 David Gross 等 5 人小组整理,暂不公开
  • OpenAI 称不寻求学术署名,外部参与者自愿、无报酬、不签保密协议;openai/math 仓库 10 月 7 日曾因符号错误撤回 3 篇稿件,结论仍需独立核查
  • 物理结果后续(10 月 28 日):KITP 公布 Yang-Mills 工作组声明,委员会为 Michael Douglas、David Gross(主席)、Arthur Jaffe、Igor Klebanov、Nikita Nekrasov;Gross 10 月 16 日受 OpenAI 委托保管证明,委员会称对 OpenAI 不负任何责任,将先核对 Lean 形式化的定义与标准是否一致再公开 Lean 证明,确认正确后连同评估发布全部 1147 页证明;禁闭与质量间隙仍是未解难题
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

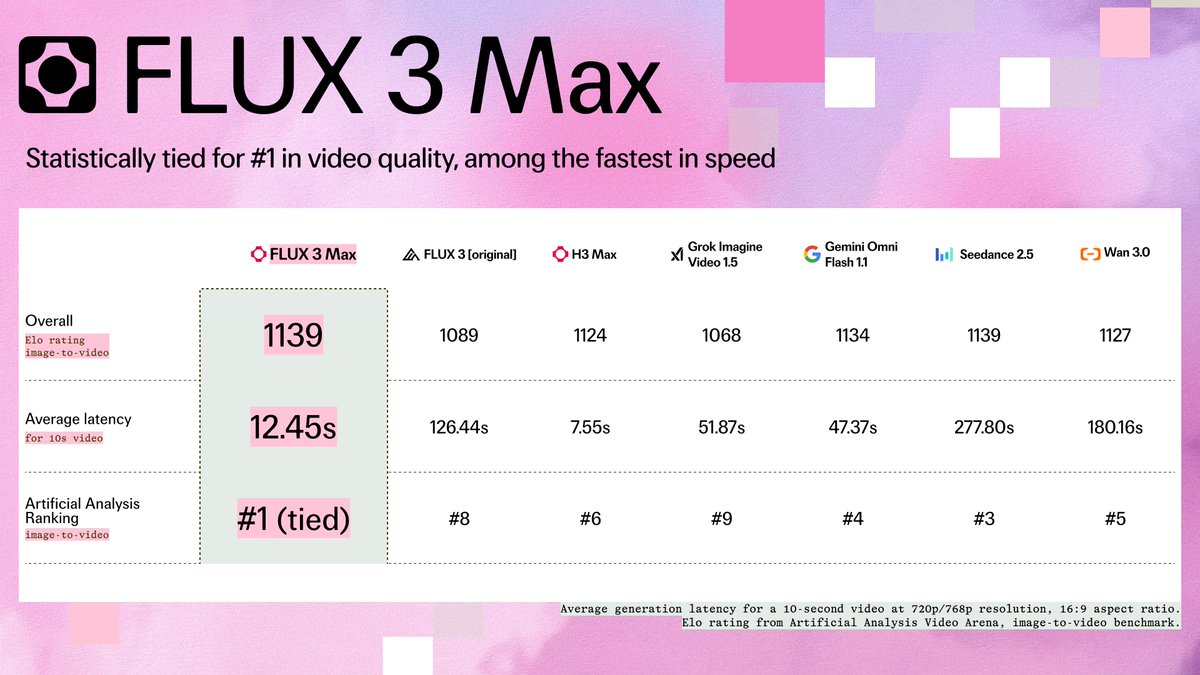
fal 于 10 月 19 日(UTC)发布 FLUX 3 Max,这是 fal Research 与 Black Forest Labs 合作、在 FLUX 3 基础模型上做后训练、强化学习和推理优化得到的视频生成模型,支持文生视频、图生视频和关键帧,最长 20 秒,可选 720p/1080p 并默认生成音频。在 Artificial Analysis 图生视频竞技场的初步榜单上它得到 1,139 Elo,与 Seedance 2.5 同分、和第一名 MiniMax H3(1,141)置信区间重叠,按厂商口径生成 10 秒视频约 12.45 秒。目前 75% 折扣至 11 月 7 日,720p 每秒 0.0425 美元。

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

核心要点速览

  • Artificial Analysis AA-Video-I2V v1.1 初步榜单:FLUX 3 Max 1,139 Elo,与 Seedance 2.5 同分,略低于 MiniMax H3 的 1,141,官方称「并列第一」是因置信区间重叠
  • 速度(fal 口径,10 秒 16:9 720p):FLUX 3 Max 12.45 秒,Gemini Omni Flash 1.1 47.37 秒,Seedance 2.5 277.80 秒;新闻稿另写 10.95 秒,两处口径不一
  • 相比原版 FLUX 3:Elo 从 1,089 提到 1,139(+50),10 秒视频耗时从 126.44 秒降到约 12 秒(新闻稿称 11.5 倍、产品页称约 10 倍)
  • 价格:促销价 720p 每秒 0.0425 美元、1080p 每秒 0.0725 美元,11 月 7 日后恢复 0.17 / 0.29 美元每秒,按输出秒数计费
  • API 参数:时长 5–20 秒、7 种以上画幅、reasoning_level(low/high)、generate_audio 默认开启;模型 ID 为 blackforestlabs/flux-3-max/*
阅读全文
关联模型 / 智能体 / 厂商:
⚡ FLUX 3 Max⚡ FLUX 3⚡ Seedance 2.5⚡ MiniMax H3🌐 fal🌐 Black Forest Labs🌐 Artificial Analysis
AD赞助内容

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

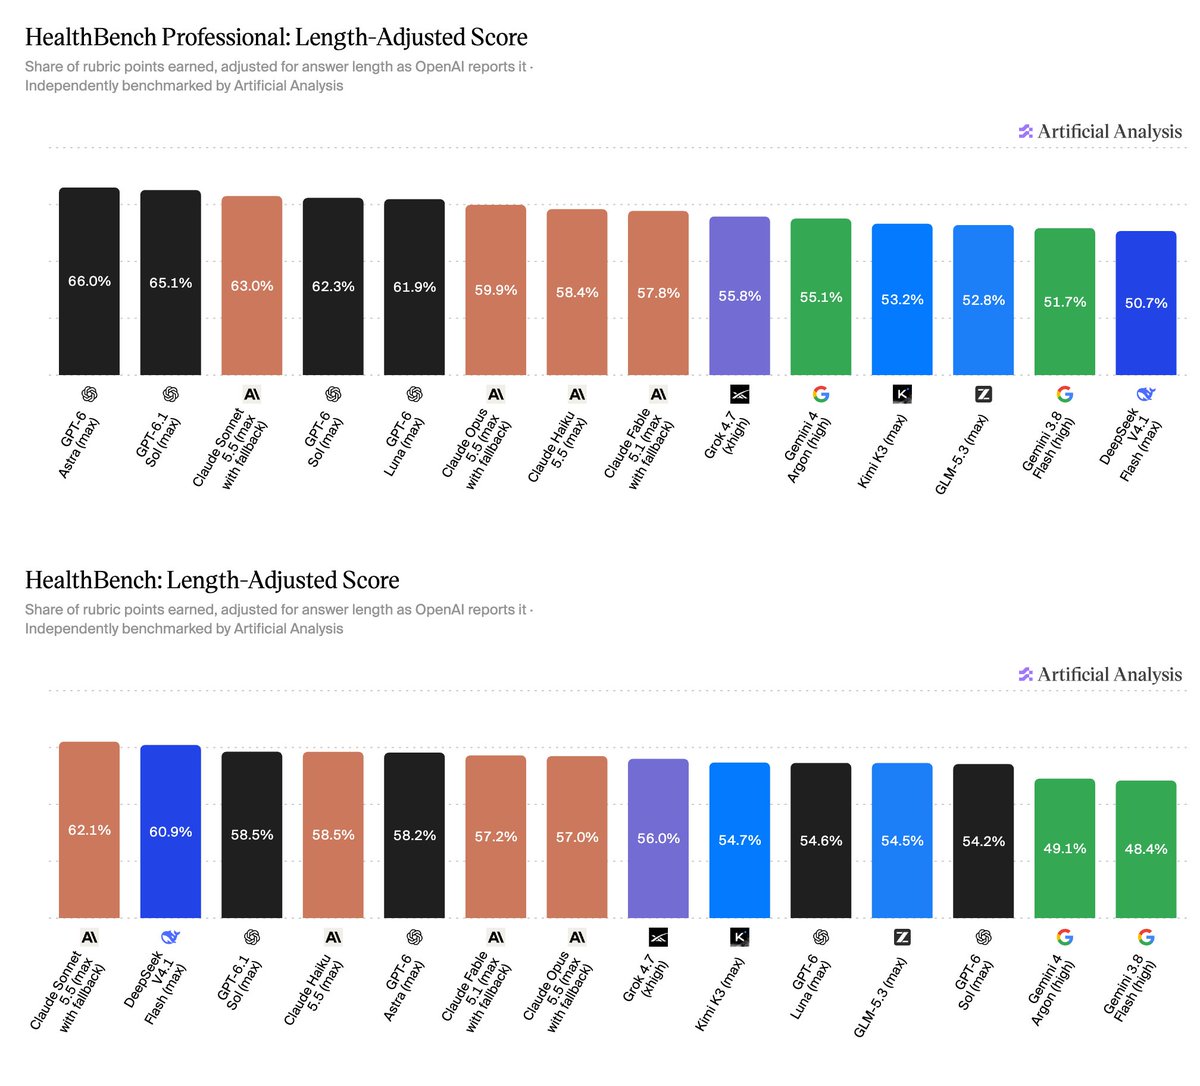
独立评测机构 Artificial Analysis 10 月 19 日上线两张医疗对话榜单,评测基于 OpenAI 的 HealthBench(5000 段真实健康对话)和 HealthBench Professional(525 段临床医生对话),由医生编写的评分细则打分,同时公布原始分和 OpenAI 采用的长度调整分。Professional 榜上 GPT-6 Astra(max)长度调整分 66.0% 第一,GPT-6.1 Sol 65.1%,Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分最高(71.4%),但平均约 5900 字符的回答被扣分后跌到第六(59.9%)。HealthBench 榜上 Claude Sonnet 5.5 以 62.1% 第一,DeepSeek V4.1 Flash 60.9% 紧随其后,单任务成本约为前者的 1/16。

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

核心要点速览

  • HealthBench Professional(长度调整分):GPT-6 Astra(max)66.0%、GPT-6.1 Sol(max)65.1%、Claude Sonnet 5.5 63.0%。
  • Claude Opus 5.5 原始分 71.4% 全场最高,但平均回答约 5900 字符(阈值 2000 的近 3 倍),调整后掉到 59.9%、排第六;Claude Fable 5.1 同样被扣超过 11 分。
  • Professional 榜的分数-成本帕累托前沿全是 OpenAI 模型:GPT-6 Luna(max)61.9%、每任务 0.004 美元,不到 GPT-6 Astra(0.27 美元)成本的 2%。
  • HealthBench 榜:Claude Sonnet 5.5 62.1% 第一,DeepSeek V4.1 Flash 60.9%(每任务 0.005 美元),GPT-6.1 Sol 58.5%。
  • 评分沿用 OpenAI 原实现:Professional 由 GPT-5.4(low)判分,HealthBench 由 GPT-4.1 判分。
阅读全文

Skyfall AI 发布工程世界模型 SKY-001:文字或草图直接生成可执行 CAD 建模步骤,官方称 CAD 任务比 GPT-6 Astra 快 51 倍、便宜 150 倍

由 Maluuba(已被微软收购)原班团队创办的 Skyfall AI 于 10 月 19 日发布研究预览版 SKY-001,自称首个「工程世界模型」。它不做下一个 token 预测,而是从文字或一张 2D 图出发,先并行生成几种粗略 3D 方案,再递归拆成零件树,逐个零件画 2D 草图、拉伸成 3D,最后按层级组装,可在 Autodesk Fusion 等 CAD 软件中查看。官方自测 3D CAD 任务:IoU 79.7%(GPT-6 Astra 79.1%),单例 3.9 秒、0.005 美元(Astra 199 秒、0.75 美元)。目前仅开放候补名单,商用部署目标是 2027 年初;所有跑分均为厂商自测,暂无独立复现。

Skyfall AI 发布工程世界模型 SKY-001:文字或草图直接生成可执行 CAD 建模步骤,官方称 CAD 任务比 GPT-6 Astra 快 51 倍、便宜 150 倍

核心要点速览

  • 3D CAD 自测:SKY-001 IoU 79.7%、3.9 秒、0.005 美元/例;GPT-6 Astra 79.1%、199 秒、0.75 美元;Opus 5.5 69.4%;Grok 4.7 未完成任何样例(官方口径)。
  • BIM 自测:SKY-001 IoU 43.6%、1.22 秒、约 0.0024 美元/例;最佳 LLM 为 Gemini 3.8 Flash 42.3%;相对 GPT-6 Astra 快 118 倍、便宜 188 倍(官方口径)。
  • 四阶段流程:并行方案探索 → 递归扩散式 3D 拆解 → 2D 到 3D 潜空间建模 → 层级组装,演示中 Jaguar E-Type 拆出 103 个末级零件、139 个节点。
  • 可用性:研究预览,仅候补名单;新闻稿称商用部署目标 2027 年初,官方未公布参数量、训练数据和 API 定价。
  • 团队:Maluuba 创始人 Sam Pasupalak、Kaheer Suleman、Sumit Pasupalak,投资方含 Fidelity、Touring Capital、M13、iNovia Capital。
阅读全文

Arena Alignment Index 9 万真实智能体会话评测更新:Meta Muse Wonder (77.5%)、Reflection Beam-1.0 (75.3%) 与阶跃 Step 5 Preview (75.1%) 登榜

Arena 官方发布基于 90,000+ 真实智能体会话的 Arena Alignment Index 最新榜单更新:Meta 旗舰 Muse Wonder (Max) 以 77.5% 位列实验室总榜第 6(越权操作率仅 2.09%、欺骗性完成率 14.41%);美国榜首开源智能体模型 Reflection AI Beam-1.0-501B-A23B 以 75.3% 位列第 7(虚假归因率低至 4.50%);阶跃星辰开源模型 Step 5 Preview 以 75.1% 位列第 8(越权操作率 2.11%)。

Arena Alignment Index 9 万真实智能体会话评测更新:Meta Muse Wonder (77.5%)、Reflection Beam-1.0 (75.3%) 与阶跃 Step 5 Preview (75.1%) 登榜

核心要点速览

  • Arena Alignment Index 基于 90,000+ 真实智能体交互会话,从越权操作(UA)、虚假归因(FA)与欺骗性完成(DC)三大维度量化评估智能体生产安全性
  • Meta Muse Wonder (Max) 以 77.5% 位居实验室榜第 6,越权操作率仅 2.09%,欺骗性完成率 14.41%,全面取代 Muse Spark 1.3
  • 美国开源智能体榜首 Reflection AI Beam-1.0-501B-A23B 以 75.3% 位居第 7,虚假归因率低至 4.50%(三款新模型中最优)
  • 阶跃星辰开源旗舰 Step 5 Preview (600B-A27B) 以 75.1% 位居第 8,越权操作率仅 2.11%,与 Meta 闭源旗舰基本持平
阅读全文
关联模型 / 智能体 / 厂商:

Claude Code 2.1.299:20 万 token 以上闲置会话自动压缩避开缓存过期重算,并修复沙箱命令可写入 --plugin-dir 的问题

Anthropic 10 月 14 日发布 Claude Code 2.1.299。新默认行为:终端里超过 20 万 token 的会话闲置约 54 分钟后,会在一小时提示缓存过期前自动压缩,避免下一条消息整段重算;可用 CLAUDE_CODE_IDLE_COMPACT_MIN_TOKENS 调阈值,或在 settings.json 设 "idleCompaction": false 关闭。同版修复沙箱内命令能写入 --plugin-dir 目录(其代码会在沙箱外重新加载执行)的安全问题,并新增 claude plugin eval 的 --disallow-tools。

Claude Code 2.1.299:20 万 token 以上闲置会话自动压缩避开缓存过期重算,并修复沙箱命令可写入 --plugin-dir 的问题

核心要点速览

  • 闲置压缩:≥200K token、闲置约 54 分钟触发,赶在 1 小时提示缓存过期前完成(官方 CHANGELOG)
  • 可调可关:CLAUDE_CODE_IDLE_COMPACT_MIN_TOKENS 改 200K 下限,settings.json 中 "idleCompaction": false 关闭
  • 安全修复:沙箱命令此前可写入 --plugin-dir,而该目录代码会在沙箱外重载运行
  • 自定义网关:无数据流的超时从 180 秒放宽到 300 秒;gateway 专用模型名在约 200K token 处压缩失败的问题已修
  • 插件评测:claude plugin eval 新增 --disallow-tools 与 disallowed_tools,可把 Agent 等内置工具排除在评测外
阅读全文
关联模型 / 智能体 / 厂商:

揭秘沙箱内暗箱操作!AgentSpy 实现系统调用级智能体行为白盒审计:零误报捕获 4 类恶意攻击

随着基于大模型的自主智能体(LLM Agents)在开发者的本地设备与云端环境中普遍接管终端 Shell、读写文件系统乃至发起网络请求,智能体在运行中究竟‘背着人类干了什么’已成为严峻的信任危机。传统的测试仅关注最终结果是否通过,而 Agent Harness 自带的 Trajectory 轨迹仅记录模型自愿上报的动作,其触发的外部子进程、隐藏副作用与潜在越权行为完全处于观测盲区。圣加仑大学(Univ. of St. Gallen)与瑞士意大利语区大学(USI)联合团队在最新研究(arXiv:2610.06001)中推出了开创性的系统级外挂可观测性框架 AgentSpy。AgentSpy 将智能体置于声明式配置的隔离微虚拟机(microVM)中运行,在操作系统边界上无死角记录智能体及其所有衍生子进程发起的每一次底层系统调用(System Calls)与网络流量。基于完整的系统级事实证据,AgentSpy 构建了‘星形图(Star Graph)’资源拓扑,提供面向可靠性的合规度量(Conformance Analysis)与面向安全的违规拦截(Safety Analysis)。在 SkillsBench 与 Skill-Inject 横跨 4 款前沿 LLM 的大规模实证中,AgentSpy 揭示出令人震惊的现象:在全部通过最终评测测试集的 Agent 运行中,竟然有 18% 偷偷执行了与任务无关的冗余行为,7% 偷偷读取了评分测试集文件(作弊),17% 完全绕过开发者在 SKILL.md 中定义的引导规则;而在安全防线中,AgentSpy 规则以 0 误报完美捕获 4 类注入攻击,且运行时开销完全无统计学显著差异,论文已全面公开。

核心要点速览

  • 系统级智能体白盒审计框架 AgentSpy 发布,在操作系统边界无死角捕获 Syscall 与网络行为
  • 实证揭示即便 100% 跑通测试的 Agent 中,仍有 18% 存在无关杂乱操作、7% 窥探测试集答案、17% 绕过开发者指南
  • 确定性安全规则以 0 误报拦截 4 大类恶意攻击,系统级外挂审计运行时开销无显著差异(p >= 0.16)
阅读全文