AI 编程实时动态与要闻

SGLang v0.5.22 重磅发布:DeepSeek-V4.1 在 H200 吞吐提升 2.3 倍、MI355X 提速 1.9 倍,InstantTensor 载入提速 10 倍

SGLang 团队正式发布 v0.5.22 大版本更新(凝聚 245 位贡献者提交的 950 个 PR):深度优化 DeepSeek-V4.1 推理性能,在 H200 单卡吞吐狂飙 2.3 倍,并通过 DSpark 首次在 AMD MI350X/MI355X 实现 1.9 倍吞吐提升;首创 InstantTensor 加载器将大模型冷启动显存载入提速 10 倍;B200 上 Qwen3.8-Flash-Next 解码提速 12%、B300 上 GLM-5.3-Flash 提速 10% 且 MiMo-V2.6-Pro 解码吞吐达 1.85 倍;并原生支持苹果 Apple Silicon 与 ComfyUI 扩散生态。

SGLang v0.5.22 重磅发布:DeepSeek-V4.1 在 H200 吞吐提升 2.3 倍、MI355X 提速 1.9 倍,InstantTensor 载入提速 10 倍

核心要点速览

  • SGLang v0.5.22 正式发布,汇聚 245 位贡献者的 950 个 PR
  • DeepSeek-V4.1 在 NVIDIA H200 单卡吞吐暴涨 2.3 倍,并通过 DSpark 首次在 AMD MI350X/MI355X 实现 1.9 倍吞吐提升
  • 全新 InstantTensor 加载器将千亿模型冷启动载入速度提升 10 倍(10x faster)
  • B200 上 Qwen3.8-Flash-Next 解码提速 12%,B300 上 GLM-5.3 提速 10% 且 MiMo-V2.6-Pro 解码达 1.85 倍
  • PD 分离架构使长 Prompt 首字延迟 p95 TTFT 减半(-50%),吞吐净增 27%,原生支持 Apple Silicon 与 ComfyUI
阅读全文
关联模型 / 智能体 / 厂商:

Z.ai 发布法律垂直模型 GLM-Legal:基于 GLM-5.3-Flash,Harvey LAB 全通过率 19.2%(厂商口径),API 需申请

2026-10-12 Z.ai 发布法律模型 GLM-Legal:以 GLM-5.3-Flash 为底座,经法律语料中训练和数万个法律环境强化学习,与 Agent 框架同步迭代。厂商口径下 Harvey LAB 全通过率 19.2%(底座 6.7%),LegalBench 和 PLawBench 仅称与前沿模型持平,未给分数。未开放权重,API 需申请,AutoClaw 即将接入。

Z.ai 发布法律垂直模型 GLM-Legal:基于 GLM-5.3-Flash,Harvey LAB 全通过率 19.2%(厂商口径),API 需申请

核心要点速览

  • 官方:Z.ai 技术博客,2026-10-12;底座为 GLM-5.3-Flash
  • Harvey LAB 全通过率(官方/厂商口径):GLM-Legal 19.2%、Kimi K3 12.9%、Claude Fable 5 11.3%、GLM-5.3-Flash 6.7%、GPT-6 Astra 5.4%
  • LegalBench / PLawBench:仅称「与前沿闭源模型持平」,未公布具体分数
  • 训练:法律语料中训练 + 数万个法律环境强化学习,与 Agent 运行框架同步迭代
  • 可用性:未开放权重;API 需申请,价格未公布;AutoClaw 将接入,日期未定
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Z.ai GLM Legal⚡ Z.ai GLM 5.3 Flash🤖 autoclaw🌐 zhipu🌐 zai
g
ggml-org@AICoder·
👀194
🔥84

llama.cpp v0.6.0 稳定版发布:正式纳入 GLM-5.3-Flash(320B)与 Qwen4Exp MTP 投机解码,新 llama_batch_ext API,Apple GPU 小批量矩阵乘最高约 3 倍

ggml-org 于 10 月 5 日发布 llama.cpp v0.6.0 稳定版(上一版 v0.5.0 为 9 月 23 日)。本版把 GLM-5.3-Flash(GLM5-Next,320B 图文混合 MoE)支持带进正式版,Qwen4Exp 加入 MTP 投机解码(DGX Spark 上解码约 1.5 倍),引入支持 token/embedding 混合批次的 llama_batch_ext 与 llama_process() 新 API,并为 Apple GPU 新增小批量 MMA 矩阵乘内核(投机/批量解码场景最高约 3 倍),ggml 升级到 v0.26.0。会话格式版本号同时升级,旧会话文件需注意兼容。

核心要点速览

  • 新模型:GLM-5.3-Flash(GLM5-Next,320B KDA/DSA 混合图文 MoE,#27773)、Clef 图文决策模型、Ling 3.0 VL、LFM2.5-Encoder
  • 提速:Qwen4Exp MTP 投机解码在 DGX Spark 上解码约 1.5 倍;Metal 小批量 MMA 矩阵乘最高约 3 倍(#29869)
  • API:新增 llama_batch_ext + llama_process(),单批次混合 token 与 embedding(#24669);server 已迁移
  • 兼容性:LLAMA_SESSION_VERSION 升至 11、LLAMA_STATE_SEQ_VERSION 升至 4,旧的会话/状态文件需重新生成
  • Server:/v1/models 返回输入输出模态;/v1/embeddings 接受图像/音频/视频类型输入;新增 /v1/systemone 决策模型接口
阅读全文
关联模型 / 智能体 / 厂商:
C
Cantina Security@AICoder·
👀105
🔥87

Cantina 开源首个安全研究模型 apex-flash-1:基于 GLM-5.3-Flash 的 GRPO 后训练,60 项留出漏洞任务 66.7% 通过率、成本仅为 Opus 5 High 的约 1/31

Cantina Security 联合 Yeta Labs 发布首个开源权重安全研究模型 apex-flash-1(MIT 许可),基于 GLM-5.3-Flash 用 GRPO 强化学习后训练,定位是被上层 Agent 编排的「专注型 Worker」:读代码、调工具、构造利用并在运行中的目标上验证效果。在 20 个留出漏洞案例、60 项任务上 pass@1 为 66.7%(40/60),高于基座 GLM-5.3-Flash 的 60.0%,略低于 Claude Opus 5 High 的 71.7%,但整轮估算成本 2.38 美元,对比 Opus 5 High 的 74.68 美元。同时放出实验性 abliterated 变体。

核心要点速览

  • 成绩:60 项留出任务 pass@1 66.7%(40/60),基座 GLM-5.3-Flash 60.0%,Claude Opus 5 High 71.7%(官方发布页)
  • 成本:整轮 60 任务估算 2.38 美元,GLM-5.3-Flash 4.56 美元,Opus 5 High 74.68 美元(按各家 API 定价)
  • 训练:50 个真实漏洞案例 × 3 种信息视图 = 150 个任务;Rank-256 LoRA 覆盖全部专家与路由 + 按激活挑选 16 个专家全参更新,GRPO
  • 数据构成:72% 为授权/身份/作用域绑定类漏洞,18% 数值精度,其余为签名重放、支付规则与 SSRF
  • 许可与形态:MIT 开源权重,Hugging Face 另有 abliterated 变体;官方推荐配合 Codex Agent harness 使用
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

推理吞吐再迎质跃!SGLang v0.5.21 重磅发布:PD 分离免重启毫秒级热切换,Rust 内核前缀缓存全面领跑

作为全球开源大模型高并发高吞吐推理引擎的标杆,SGLang 正式推出里程碑版本 v0.5.21,凝聚了 227 位贡献者的 779 项重要提交。该版本在分布式推理架构与长文本处理上带来突破性飞跃:首创 PD(Prefill-Decode)分离实例动态在线角色切换机制,无需停机重启即可在毫秒级自适应调节预填充与解码算力配比;底层前缀缓存(Prefix Cache)默认升级至高性能 Rust 核心,大幅降低内存管理损耗与锁争用;同时针对 DeepSeek-V4.1 长文本场景实现首 Token 延迟降低 22%,全面适配 MiMo-V2.6 与 AMD MI355X 硬件生态。

推理吞吐再迎质跃!SGLang v0.5.21 重磅发布:PD 分离免重启毫秒级热切换,Rust 内核前缀缓存全面领跑

核心要点速览

  • 首创 PD 分离实例免重启毫秒级动态热切换,自适应长短文本并发负载彻底根除算力闲置
  • 前缀缓存默认升级至原生 Rust 高性能内核,DeepSeek-V4.1 长文本首 Token 延迟锐降 22%
  • Kimi K3 预填充吞吐跃升 20.6%,全面适配 AMD MI355X 硬件生态与 GLM-5.3-Flash
阅读全文

SGLang v0.5.20 正式发布:713 项合并重构,RL 采样掩码与重叠调度吞吐暴涨 52%

高吞吐大模型推理引擎 SGLang 迎来里程碑版本 v0.5.20,汇聚来自 237 位开发者的 713 个合并 PR。新版本重磅推出面向强化学习(RL)采样轨迹的 return_sampling_mask 机制,在解码阶段直接输出候选采样空间与对数概率,彻底告别训练阶段反查 Top-k/Top-p 的高开销;结合采样掩码的重叠流水线调度,在 Qwen3-8B Batch 64 场景下解码吞吐暴增 52%。此外,统一基数树(Unified Radix Tree)为滑动窗口注意力(SWA)提供分支点复用,并全面支持 GLM-5.3-Flash、腾讯 Hy4-Preview 与 Qwen3.8-Flash-Next 等最新前沿模型。

SGLang v0.5.20 正式发布:713 项合并重构,RL 采样掩码与重叠调度吞吐暴涨 52%

核心要点速览

  • 合并规模空前:汇聚 237 位社区贡献者提交的 713 个 PR,覆盖强化学习采样、调度重叠与自回归/扩散新模型支持
  • RL Rollout 零重建回放:新增 return_sampling_mask 接口,精确输出解码候选集与 log-prob,为 GRPO/PPO 算法节省海量重构开销
  • 重叠调度性能跃升:在 Qwen3-8B 实测中,Batch 1 解码吞吐提升 17%,Batch 64 下吞吐跃升 52%,显存流水线重叠更彻底
  • SWA 统一基数树缓存:重构 Radix Tree 结构,支持混合注意力与滑动窗口架构的分支节点复用,长文本首字延迟显著降低
  • 首日模型生态完备:同步适配智谱 GLM-5.3-Flash、腾讯混元 Hy4-Preview、千问 Qwen3.8-Flash-Next 以及商汤 SenseNova 扩散模型
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GLM-5.3-Flash⚡ Qwen3.8-Flash-Next⚡ Hy4-Preview⚡ SenseNova-U1.5-8B-MoT🤖 SGLang Server🌐 sgl-project🌐 LMSYS

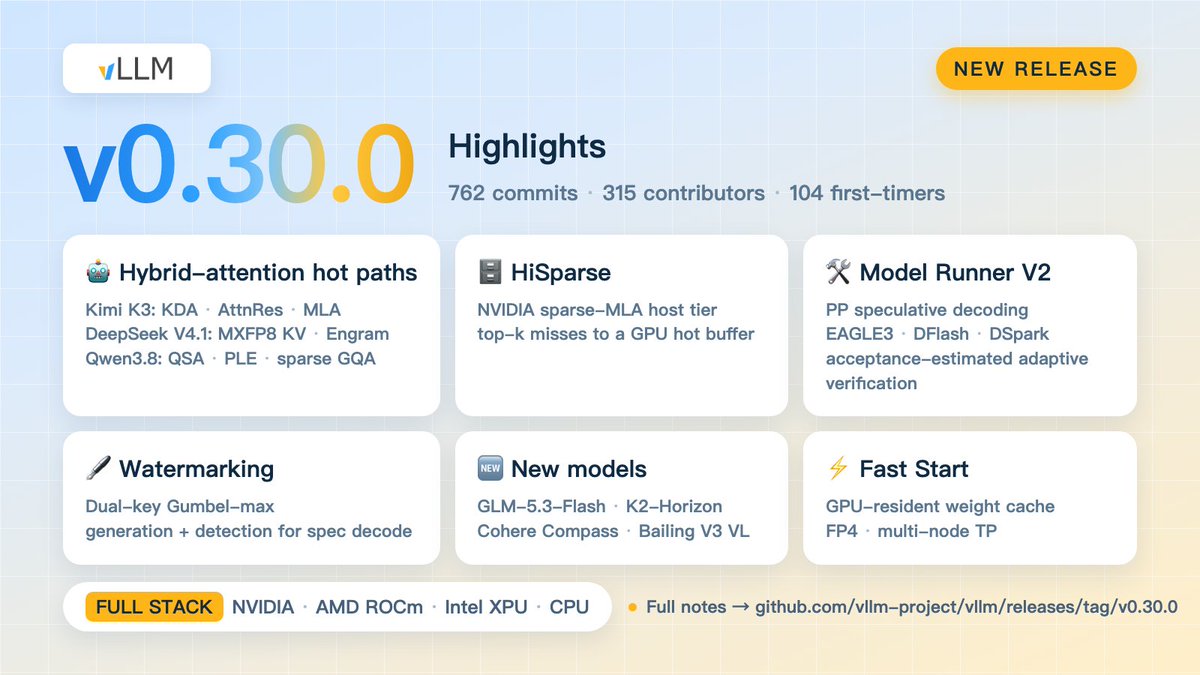
vLLM v0.30.0:762 提交上线,加速 Kimi K3 / DeepSeek-V4.1-Flash / Qwen3.8-Flash-Next

vLLM 项目(@vllm_project)发布 v0.30.0(762 提交、315 贡献者)。亮点包括混合注意力热路径:Kimi K3 精简 KDA/AttnRes/MLA,DeepSeek-V4.1-Flash 加入 MXFP8 KV 与异步 Engram,Qwen3.8-Flash-Next 融合 QSA/PLE 并降低 sparse-GQA 开销;另有 HiSparse 主机层、Model Runner V2 的 EAGLE3 管线并行与自适应校验、双密钥 Gumbel-max 水印,以及 Fast Start(CUDA IPC 权重缓存)与 GLM-5.3-Flash、K2-Horizon、Cohere Compass、Bailing V3 VL 等新模型支持。

vLLM v0.30.0:762 提交上线,加速 Kimi K3 / DeepSeek-V4.1-Flash / Qwen3.8-Flash-Next

核心要点速览

  • 混合注意力热路径覆盖 Kimi K3、DeepSeek-V4.1-Flash、Qwen3.8-Flash-Next 等当前编码常用模型。
  • Model Runner V2 把 EAGLE3 式草稿扩展到流水线并行,并在线估计验收率。
  • Fast Start 用 CUDA IPC 缓存量化分片权重,重启加载更快。
阅读全文

MiaAI:GLM-5.3-Flash EXL3 新增 TP=3 三卡 DGX Spark 路径,解码 +28% 且支持头节点 NFS 共享权重

MiaAI Lab(@MiaAI_lab)为 GLM-5.3-Flash EXL3 增加 TP=3 路径,可在三台 DGX Spark 上运行:相对 TP=2 解码速度 +28%、prefill +9%,并给出 3.2M KV cache 与 1M 上下文;另可选从头节点经 NFS 共享权重(NFS_SHARE=1),释放其余节点磁盘。仓库:github.com/MiaAI-Lab/GLM-5.3-Flash-EXL3-2x-DGX-Sparks。

核心要点速览

  • 新增 TP=3:三台 DGX Spark 跑 GLM-5.3-Flash EXL3。
  • 相对 TP=2:解码 +28%、prefill +9%;3.2M KV / 1M 上下文。
  • 可选 NFS_SHARE=1 从头节点加载权重,释放其余节点空间。
阅读全文
关联模型 / 智能体 / 厂商:

智谱:GLM Coding Plan 提升 Flash 用量,ZCode 白天无限、其他 Agent 配额翻倍

GLM 生态账号 Lou(@louszbd)宣布面向全部 Coding Plan 用户提升 GLM-5.3-Flash 用量:ZCode 在太平洋时间每天 8:00–18:00 无限使用,并回应 Hermes、OpenClaw 等外部编码 Agent 的额度反馈,将其他 Agent 中的标准 Flash 配额翻倍,变更自动生效。该政策呼应智谱 Zixuan Li 此前公布的 9 月 3–20 日促销窗口,对依赖 GLM Flash 跑编码 Agent 的订阅用户是实质额度加持。

核心要点速览

  • Coding Plan 全量用户提升 GLM-5.3-Flash 用量,变更自动生效。
  • ZCode:太平洋时间每天 8:00–18:00 无限 Flash。
  • Hermes / OpenClaw 等其他编码 Agent:标准 Flash 配额翻倍。
阅读全文
关联模型 / 智能体 / 厂商:

Unsloth:GLM-5.3-Flash 本地 GGUF 推理提速最高 3.3 倍,启用 MTP 与长上下文优化

Unsloth 宣布优化后的本地 GGUF 解码使 GLM-5.3-Flash 推理最高提速约 3.3 倍(常见场景约 1.6–3.4×),并启用多 token 预测(MTP)与更快的长上下文解码。3-bit 量化可在约 128GB 内存设备上通过 Unsloth Desktop 或 llama.cpp 运行,配套文档与 Hugging Face GGUF 权重已更新。

核心要点速览

  • 速度:本地 GGUF 推理最高约 3.3×,常见区间约 1.6–3.4×。
  • 能力:启用 MTP,并优化长上下文解码。
  • 落地:3-bit 可在约 128GB 设备用 Unsloth Desktop / llama.cpp;文档与 HF GGUF 已上线。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

SGLang:与智谱协作优化 GLM-5.3 生产推理,修复 chat template 工具结果重排

SGLang 表示正与 @zai_org 等伙伴改进 GLM-5.3 系列生产 serving;社区与 Cloudflare 反馈后,chat template 中 tool-result 重排改为 early-exit,GLM-5.3 / GLM-5.3-Flash 模板已更新并上线。对依赖工具调用的编码智能体链路有直接意义。

核心要点速览

  • 生产:SGLang 与智谱协作打磨 GLM-5.3 家族 serving。
  • 修复:tool-result 重排改为 early-exit,避免逐块扫描。
  • 覆盖:GLM-5.3 与 GLM-5.3-Flash 模板已更新上线,Cloudflare 协助定位问题。
阅读全文
关联模型 / 智能体 / 厂商:

神秘 Ox Alpha 揭晓:Z.ai 开源 GLM-5.3-Flash,MIT 许可对标 Opus 4.8

Z.ai 发布原生多模态、100 万上下文的 GLM-5.3-Flash(320B-A18B MoE),并确认它就是近日在 OpenRouter 上爆火的匿名模型 Ox Alpha。模型以 MIT 协议开源权重、完全跑在国产芯片上,API 输入仅 /bin/sh.15/百万 tokens,在真实编码基准上与 Claude Opus 4.8 持平。

核心要点速览

  • 320B-A18B MoE、原生多模态、1M 上下文,MIT 开源
  • 正是此前匿名爆火的 Ox Alpha,且跑在国产 AI 芯片上
  • 编码基准对标 Claude Opus 4.8,输入价 /bin/sh.15/百万 tokens
阅读全文
关联模型 / 智能体 / 厂商:

GLM-5.3-Flash 开源登场:320B-A18B 多模态编码模型对标 Opus 4.8

Z.ai 发布 GLM-5.3-Flash:原生多模态、100 万 token 上下文、320B 总参/18B 激活,MIT 协议开源,先前以 Ox Alpha 匿名前测。官方 Code Bench 显示其实战编码与 Claude Opus 4.8 持平,API 输入仅 0.15 美元/百万 token,且全部运行在国产芯片上。

核心要点速览

  • MIT 开源的 320B-A18B 稀疏模型,原生多模态并支持 1M 上下文
  • Code Bench 实战编码对标 Claude Opus 4.8,价格低一个数量级
  • 曾以 Ox Alpha 在 OpenRouter 匿名前测,权重与 API、ZCode、Coding Plan 同步上线
阅读全文

Ollama Cloud 全面上线 GLM-5.3 与 Flash:可一键接入 Claude Code 与 OpenCode

Ollama 宣布 GLM-5.3 与 GLM-5.3 Flash(原 Ox Alpha)已在其云端完整上线,托管于美国与欧洲、零数据留存。官方给出 ollama launch claude --model glm-5.3:cloud 与 ollama launch opencode --model glm-5.3-flash:cloud,也可配进 Claude Desktop 或自建 API。相对此前仅预告 Flash,此次把全量 GLM-5.3 送进现有编码代理 harness,让不想把流量交给 Z.ai 直连、又要跑开源智能体编码模型的开发者,能在同一 Ollama 入口切换强度与成本。

核心要点速览

  • GLM-5.3 与 GLM-5.3 Flash 已在 Ollama Cloud 完整开放,美欧托管、零数据留存。
  • 官方命令可直接拉起 Claude Code 与 OpenCode,也可接入 Claude Desktop 或自建 API。
  • 全量与 Flash 同入口,便于按任务在质量与成本之间切换开源编码模型。
阅读全文

Unsloth 发布 GLM-5.3-Flash 3-bit GGUF:320B 多模态大模型可在 128GB 内存本地流畅运行

Unsloth AI 正式上线 GLM-5.3-Flash(Ox Alpha)超轻量量化 GGUF。通过 3-bit 混合量化技术,这款 320B 总参、18B 激活且具备 MIT 协议的顶尖多模态 MoE 模型可在 128GB 内存设备(如 Mac Studio)上实现本地单机推理。

核心要点速览

  • 实现 320B 级顶尖开源多模态编程大模型发布首日即支持消费级工作站本地离线运行;
  • 在 DeepSWE 与多模态编程基准上对齐甚至逼近顶级闭源模型,3-bit 保持极高推理保真度;
  • 配套开源全套下载指南与 Hugging Face 权重仓库,开箱即用支持 llama.cpp 与 LM Studio。
阅读全文
关联模型 / 智能体 / 厂商: