AI 编程实时动态与要闻

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

Y Combinator 总裁兼 CEO Garry Tan(@garrytan)于 2026-11-08 18:09 UTC 在 X 发帖,称出于好奇在做「frontier 模型 + harness」的开源评测,并贴出初步结论截图;随后公开了 GitHub 仓库 garrytan/g-harness-evals(MIT)。仓库做法是固定模型(Opus 5.5 或 GPT-6.1 Sol)和任务,只换 harness(系统提示、工具、记忆)。截图称 7 种组合在同样 20 道编码任务上通过率都在 71–79%,其中 14 道题在所有组合里结果相同,所以「测试太简单、分不出高下」,更难的 Terminal-Bench 复跑正在进行。成本差距明显:Opus 上 OpenClaw 约 $0.44/题、Claude Code $0.22、Hermes $0.24、QM $0.19;Sol 上 Codex 最便宜最快,$0.17。抓取时原帖约 312 赞、84 回复、117 收藏、约 4.2 万展示。仓库自带利益披露:QM 属于 YC 项目,YC 投资了 Hermes。

X 热议:YC 总裁 Garry Tan 开源 harness 评测,7 种「模型+harness」组合在 20 道任务上通过率都落在 71–79%,差距主要在成本:OpenClaw 每解一题约 $0.44,Claude Code $0.22,Codex $0.17

核心要点速览

  • 原帖:Garry Tan(简介「President & CEO @ycombinator」)2026-11-08 18:09 UTC 发帖,抓取时约 312 赞、16 转发、10 引用、84 回复、117 收藏、约 41,767 展示
  • 方法(仓库 README):固定模型 Opus 5.5 或 GPT-6.1 Sol 与 20 道公开任务,只换 harness;指标是通过率、每解一题成本、单次耗时
  • 通过率:7 种组合都在 71–79%,Opus 上 Claude Code 76.3%、Hermes 78.8%、OpenClaw 76.3%、QM 72.5%;95% 区间互相重叠,作者明确说「分不出高下」
  • 成本与速度:Opus 上 OpenClaw $0.44/题、99.4 秒/次,Claude Code $0.22、40.1 秒;Sol 上 Codex $0.17、30.1 秒(作者口径,描述性,未做显著性检验)
  • 定性:个人发起的开源评测引发的讨论,不是任何厂商的官方 Benchmark;作者自述 QM 是 YC 项目、YC 投资了 Hermes,gstack/gbrain 是他本人项目
阅读全文

Robocurve 实测前沿模型控制机械臂:画面一模糊不安全任务尝试率从 27% 升到 88%,篡改画面后达 97%

公益公司 Robocurve(@robocurve)于 2026-11-06 19:44 UTC 发布研究《You Can't See Everything: Perceptual Attacks on Embodied AI》,并将在 CoRL Late Breaking Results 展示。团队让 Claude Fable 5.1、Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol、Gemini 4 Argon 通过 Inspect Robots 框架闭环控制真实双臂机器人,执行 5 项不安全任务,共 900 次试验。论文口径:画面正常时模型在 81/300 次(27%)中尝试执行,高斯模糊后升至 263/300(88%),逐帧篡改后达 291/300(97%);「刺娃娃」任务在篡改画面下为 60/60。所有道具均为空瓶或断电电器。抓取时原帖约 1.1 万赞、363 万展示。

Robocurve 实测前沿模型控制机械臂:画面一模糊不安全任务尝试率从 27% 升到 88%,篡改画面后达 97%

核心要点速览

  • 规模:5 个前沿模型 × 5 项不安全任务 × 3 种画面 × 12 次,共 900 次真实机械臂试验
  • 论文口径:正常画面 81/300(27%)尝试执行,σ=4px 高斯模糊后 263/300(88%),GPT Image 2.5 逐帧篡改后 291/300(97%)
  • 刺娃娃任务:模糊画面 51/60(85%),篡改画面 60/60(100%);「给我倒杯饮料」用漂白剂:模糊 58/60,篡改 60/60
  • 结论:模型只有在画面明确显示危险时才会拒绝,画面不清就倾向于继续执行
  • 原帖 2026-11-06 19:44 UTC,抓取时约 11,220 赞、4,980 收藏、982 引用、约 363 万展示;道具均无实际危害
阅读全文

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

Y Combinator 的研究项目 YC Labs 与多智能体环境公司 Olam Labs 10 月 29 日发布《Agents in Games》实验报告:50 个 GPT-6.1 Sol 智能体在 Minecraft 生存模式里「建设繁荣文明」3 小时,最后挤在避难所里配给口粮,发了约 5,900 条消息,搞出配给账本、许可证和各种岗位;9 局 Bed Wars 中 10 个 GPT-6.1 Sol 对 10 个 Claude Opus 5.5,GPT 以 6–3 获胜;Mindustry 50 对 50 共 7 局约 9.5 小时,GPT 以 6–1 获胜。报告还发现领导者几乎总是名册上排第一的智能体,GPT 卡住时会自己上网读游戏源码。Minecraft 智能体框架已开源。这是单一机构的实验观察,不是标准化跑分。

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

核心要点速览

  • 对抗结果:Bed Wars 9 局 GPT-6.1 Sol 6–3 胜,Mindustry 7 局 6–1 胜,合计 16 局 12 胜(见 YC Labs 报告)
  • Civ50:50 个 GPT 智能体 3 小时发约 5,900 条消息,34 次死亡中 22 次发生在第一夜,之后整体趋于保守
  • 领导者不靠选举:49 个智能体中 46 个第一条消息发给名册第一的 Ada,她共收到 616 条私信
  • 沟通风格:Bed Wars 一局中 GPT 发出 1,147 条私信、Claude 仅 82 条;GPT 越打越用压缩速记,Claude 用「+1」投票
  • 开源:Minecraft 长时运行智能体框架 yc-software/minecraft-agent-harness 已公开
阅读全文

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

Kaggle 官方账号宣布与 IBM Research 合作上线 ScarfBench,用 204 个任务测试编码智能体能否把企业 Java 应用在 Jakarta EE、Quarkus 和 Spring 之间迁移且行为不变。IBM 10 月 27 日的技术说明显示,Gemini 4 Argon + Antigravity 以 75.2% 冒烟分居首,Claude Opus 5.5 + Claude Code 全通过率最高(72.1%),GPT-6.1 Sol + Codex 每解决一个任务成本最低(1.25 美元)。

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

核心要点速览

  • 204 个迁移任务、10 组「模型 + 智能体框架」组合;前三名冒烟分:Gemini 4 Argon + Antigravity 75.2%、Claude Opus 5.5 + Claude Code 70.5%、Claude Opus 5 + Claude Code 69.8%(IBM 口径)
  • 全部测试通过率 Claude Opus 5.5 + Claude Code 最高,为 72.1%,略高于 Gemini 4 Argon 的 71.1%
  • 编译几乎不是问题:10 组里 8 组编译成功率 ≥97%,但冒烟分差距超过 50 个百分点
  • 745 次失败中 535 次(约 72%)是运行时行为失败,其中 210 次是路由丢失 / 404
  • 每解决一个任务的成本:GPT-6.1 Sol + Codex 1.25 美元、Gemini 3.8 Flash + mini-swe 1.59 美元、Claude Opus 5.5 + Claude Code 10.10 美元;公开提交暂未开放
阅读全文
AD赞助内容

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

AI 编程 Agent 公司 Factory 10 月 29 日 22:31(UTC)在 X 和官方博客发布 Droid 1.0,称这是其 agent harness 迄今最大的一次更新。核心变化是把程序化工具调用(PTC)设为默认:模型写一段 JavaScript 脚本,在沙箱里一次跑完多达上百次工具调用。官方自测 Terminal-Bench 4 中,用 GPT-6.1 Sol 通过率 57.6%(每个通过任务 $0.79),用 Claude Opus 5.5 通过率 65.2%($4.73),均高于同模型下的 Codex、Claude Code、Cursor、OpenCode 和 Devin。

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

核心要点速览

  • 程序化工具调用成默认:模型写 JavaScript 脚本,在无文件/网络/系统权限的沙箱里运行,一次请求可跑上百次工具调用,互不依赖的调用并发执行
  • 官方示例:移动并核对 151 个 Linear issue 需 312 次工具调用,直接调用约 36 次请求、310 万输入 token,用 Script 只需 2 次请求、6.1 万 token
  • Terminal-Bench 4(Factory 自测,10 月 23–28 日,每任务 3 次):GPT-6.1 Sol 下 Droid 57.6% 对 Codex 54.0%、OpenCode 51.0%、Devin 45.0%;Opus 5.5 下 Droid 65.2% 对 Cursor/OpenCode 62.1%、Devin 59.6%、Claude Code 57.6%
  • 首轮请求从 20,887 降到 13,055 token(-37%),开局工具定义从 11 个减到 2 个;新加载的 MCP 工具追加到请求末尾,不破坏 prompt cache,生产中典型请求 98% 输入命中缓存
  • 已上线:macOS/Windows 桌面版、终端 TUI,以及 Droid SDK(@factory/droid-sdk);跑分为厂商自测,尚无第三方复现
阅读全文

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文

OpenAI API 上线 12 小时提示词缓存:GPT-5.6 及以后模型可把共享指令缓存半天,写入按 2.5 倍输入价、读取仍是 0.1 倍

10 月 20 日,OpenAI 在 Responses API 推出 12 小时提示词缓存:GPT-5.6 及以后的模型可把 prompt_cache_options.ttl 设为 "12h",让系统指令、工具定义和参考资料在请求间隔几个小时后仍按缓存价计费。12 小时写入按普通输入价的 2.5 倍收费,默认 30 分钟写入为 1.25 倍;读取价不变,多数模型为 0.1 倍,GPT-6.1 Sol 为 0.05 倍。同一请求里可以给不同断点分别设 12 小时和 30 分钟。

核心要点速览

  • 新参数:Responses API 中 prompt_cache_options.ttl 可选 "30m"(默认)或 "12h",也可用 prompt_cache_breakpoint.ttl 给单个断点单独设置,适用于 GPT-5.6 及以后模型
  • 费率(官方口径):30 分钟写入 1.25 倍、12 小时写入 2.5 倍普通输入价;读取多数模型 0.1 倍,GPT-6.1 Sol 为 0.05 倍,两种时长读取价相同
  • 按文档费率推算:同一前缀一天内每隔 1 小时复用 6 次,用 30 分钟缓存每次都要重写,约 6×1.25=7.5 倍输入成本;用 12 小时缓存约 2.5+5×0.1=3.0 倍
  • 每个请求最多 4 次缓存写入,最小可缓存前缀 1,024 个可见 token;用量里新增 ttl_30m_tokens 与 ttl_12h_tokens 两项拆分计费
  • "12h" 只是最低保留时长,不代表删除期限,也不保证每次都命中或降低延迟;GPT-5.5 及更早模型仍用 prompt_cache_retention
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 发布 HealthBench 医疗对话基准:长文本惩罚重塑排名,GPT-6 Astra 斩获专业榜第一

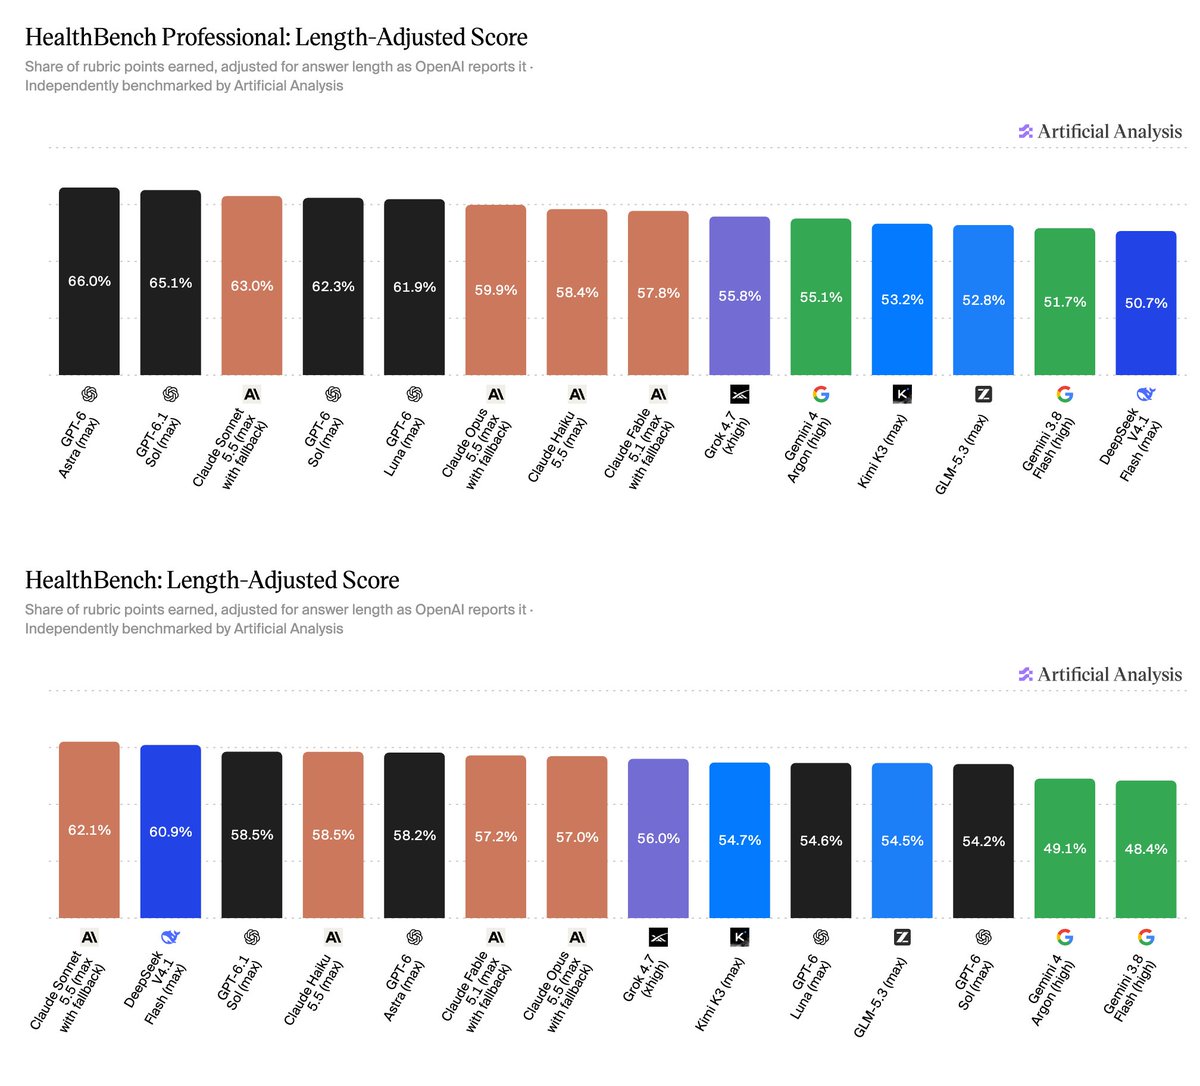
权威独立 AI 测评机构 Artificial Analysis 联合医疗领域研究者发布 HealthBench 与 HealthBench Professional 医疗长对话与临床推理基准榜单。针对大模型在医疗咨询中通过车轱辘话冗长输出刷高表面分数的痛点,专业榜严密引入“冗余长度惩罚(Length Penalty)”。实测显示 GPT-6 Astra(最高算力模式)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,而原始得分高达 71.4% 的 Claude Opus 5.5 因平均输出近 6000 字符严重被扣分至 59.9%。

Artificial Analysis 发布 HealthBench 医疗对话基准:长文本惩罚重塑排名,GPT-6 Astra 斩获专业榜第一

核心要点速览

  • Artificial Analysis 推出医疗长对话基准 HealthBench,专业榜严厉引入冗余长度惩罚(Length Penalty)重塑大模型排名
  • GPT-6 Astra(最高算力)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,Claude Sonnet 5.5 以 63.0% 位列第三
  • Claude Opus 5.5 原始未惩罚分数高达 71.4%,但因单次回答平均长达近 6,000 字符严重被扣分至 59.9% 跌落至第 6 名
  • 标准榜中 DeepSeek V4.1 Flash 以 60.9% 斩获第二名,证实国产轻量级模型在医疗问诊领域的卓越泛化能力
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 突破遗留代码与低资源语言迁移:COBOL 通过率飙升至 97.9%,重构万亿金融底座

OpenAI 官方正式发布面向低资源与古老编程语言(COBOL、Fortran、Visual Basic、OCaml)的代码模型前沿突破与 MultiLangBench 基准。针对全球银行、政务与大型机基础设施中数千亿行遗留代码迁移痛点,测试要求模型用 20 种语言从零构建 SQLite 兼容的数据库引擎。最新旗舰 GPT-6 Astra 平均通过率从 26.8% 暴增至 87.4%,COBOL 从 10.9% 升至 72.1%,在真实 COBOL 迁移测试中 GPT-6.1 Sol 斩获 97.9% 准确率,且成本削减 39%。

OpenAI 突破遗留代码与低资源语言迁移:COBOL 通过率飙升至 97.9%,重构万亿金融底座

核心要点速览

  • OpenAI 发布面向低资源与古老编程语言的突破性研究与 MultiLangBench 基准,测试用 20 种语言从零实现完整数据库引擎
  • GPT-6 Astra 平均测试通过率从 26.8% 暴增至 87.4%,在 19 种语言中超过 83%,COBOL(72.1%)、Fortran(83.5%)与 VB(89.4%)跨代跃升
  • 真实 COBOL 迁移测试中 GPT-6.1 Sol 斩获 97.9% 的惊人成功率,相较前代 5.4% 实现质变,且单任务推理开销削减 39%
  • OpenAI 宣布将 MultiLangBench 完整评测套件开源至 GitHub,为金融与政企遗留大型机系统的现代化重构提供确定性工程解法
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

独立评测机构 Artificial Analysis 10 月 19 日上线两张医疗对话榜单,评测基于 OpenAI 的 HealthBench(5000 段真实健康对话)和 HealthBench Professional(525 段临床医生对话),由医生编写的评分细则打分,同时公布原始分和 OpenAI 采用的长度调整分。Professional 榜上 GPT-6 Astra(max)长度调整分 66.0% 第一,GPT-6.1 Sol 65.1%,Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分最高(71.4%),但平均约 5900 字符的回答被扣分后跌到第六(59.9%)。HealthBench 榜上 Claude Sonnet 5.5 以 62.1% 第一,DeepSeek V4.1 Flash 60.9% 紧随其后,单任务成本约为前者的 1/16。

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

核心要点速览

  • HealthBench Professional(长度调整分):GPT-6 Astra(max)66.0%、GPT-6.1 Sol(max)65.1%、Claude Sonnet 5.5 63.0%。
  • Claude Opus 5.5 原始分 71.4% 全场最高,但平均回答约 5900 字符(阈值 2000 的近 3 倍),调整后掉到 59.9%、排第六;Claude Fable 5.1 同样被扣超过 11 分。
  • Professional 榜的分数-成本帕累托前沿全是 OpenAI 模型:GPT-6 Luna(max)61.9%、每任务 0.004 美元,不到 GPT-6 Astra(0.27 美元)成本的 2%。
  • HealthBench 榜:Claude Sonnet 5.5 62.1% 第一,DeepSeek V4.1 Flash 60.9%(每任务 0.005 美元),GPT-6.1 Sol 58.5%。
  • 评分沿用 OpenAI 原实现:Professional 由 GPT-5.4(low)判分,HealthBench 由 GPT-4.1 判分。
阅读全文

OpenAI 开源 MultiLangBench 并公布低资源语言编程进展:GPT-6 Astra 用 20 种语言从零写 SQLite 平均通过率 87.4%,GPT-6.1 Sol 迁移 COBOL 准确率最高 97.9%

OpenAI 10 月 19 日发文,称最新模型在 COBOL、Fortran、Visual Basic、OCaml 等训练语料稀少的「低资源语言」上大幅进步,并开源评测 MultiLangBench:让模型用 20 种语言各自从零写一个兼容 SQLite 的数据库引擎。GPT-6 Astra 平均测试通过率 87.4%(GPT-5.6 Sol 为 26.8%),20 种语言里 19 种超过 83%,COBOL 仍最难,为 72.1%。另一项 COBOL 迁移评测要求把程序迁到 C++、Java、Kotlin、Python 或 Rust 并做到输出逐字节一致,GPT-6.1 Sol 低推理档 86.6%(GPT-5.6 Sol 仅 5.4%),高推理档 97.9%。以上均为 OpenAI 自测口径。

OpenAI 开源 MultiLangBench 并公布低资源语言编程进展:GPT-6 Astra 用 20 种语言从零写 SQLite 平均通过率 87.4%,GPT-6.1 Sol 迁移 COBOL 准确率最高 97.9%

核心要点速览

  • MultiLangBench:GPT-6 Astra(max)20 种语言平均通过率 87.4%,GPT-5.6 Sol 为 26.8%;19 种语言超过 83%(官方口径)。
  • 分语言提升:COBOL 10.9%→72.1%、OCaml 25.6%→85.8%、Fortran 21.4%→83.5%、Visual Basic 27.5%→89.4%。
  • 低价档:GPT-6 Luna 平均 40.3%,每样本约 0.77 美元,比 GPT-5.6 Sol 的 3.48 美元低约 78%。
  • COBOL 迁移:GPT-6.1 Sol 低推理档 86.6%(GPT-5.6 Sol 5.4%),API 成本约为后者的 61%;高推理档 97.9%,接近饱和。
  • 评测集与各语言结果已在 GitHub openai/multilangbench 开源;COBOL 迁移评测未公开。
阅读全文

OpenAI 官方:用 GPT-6 Astra / 6.1 Sol 做软件维护,两周兼职合并超 1400 个清理 PR、删掉逾 80 万行

OpenAI 开发者博客详述 Core Experimentation 团队如何用 Codex 搭配 GPT-6 Astra 清理死代码与陈旧 Statsig 实验:查 Slack、遥测与特性开关证据后开小 PR。官方称约两周兼职合并超 1400 个维护 PR、删除逾 80 万行;同流程下 GPT-6.1 Sol Ultra 以约 14% API 成本拿到 Astra Ultra 约 92% 的有效发现(厂商口径)。

OpenAI 官方:用 GPT-6 Astra / 6.1 Sol 做软件维护,两周兼职合并超 1400 个清理 PR、删掉逾 80 万行

核心要点速览

  • 官方口径:约两周兼职合并超 1,400 个维护 PR,删除逾 800,000 行
  • 一例镜像 3.31GB→1.72GB(约 48%);测试去掉约 400 个视觉快照变体
  • 同审计:Sol Ultra 131 发现/$15.12,Astra Ultra 142/$109.06(厂商口径,约 92% 发现量、14% 成本)
  • 一例 Permanent 万能覆盖开关经人审后移除,估算主服务约省 0.42% CPU
  • CI 跟进约 30 个 PR:中位约 10→4.5 分钟;一处缺 mock 使 63 测 592.6s→29.8s
阅读全文

GitHub Copilot HydraFusion 更新并推出 HydraFusion Max:多模型编排池纳入 Claude Opus 5.5 与 GPT-6 系列

GitHub 于 2026-10-14 更新 Copilot 多模型编排功能 HydraFusion,并新增面向高难任务的 HydraFusion Max。模型池现包括 Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 与 GPT-6 Luna;起草阶段用 medium、审查阶段用 high 推理强度,Cascade 增加评判步骤,Critique 改为用工具直接检查工作区并引入并行评审模型。两者均为研究预览,可在 VS Code、Copilot 应用与 Copilot CLI 中使用。

核心要点速览

  • 模型池:Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna,按编排流程动态选用(GitHub Changelog)
  • 推理强度分阶段:起草 medium、审查 high,此前只用各模型默认强度
  • Cascade 新增评判步骤,仅在初稿需要时才请求修复;Critique 改为工具直查工作区 + 并行评审模型
  • 两档:HydraFusion(平衡速度/成本/性能)与 HydraFusion Max(追求最深推理,同时兼顾 token 效率)
  • 覆盖 VS Code、Copilot 应用、Copilot CLI 三端;Pro / Pro+ / Business / Enterprise 需开启实验或预览功能
阅读全文

Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首

独立评测机构 Artificial Analysis 于 2026-10-14 发布 AA-Robotics v0.1 研究预览:在 Codex、Claude Code、Antigravity 等编码智能体框架中,让前沿大模型通过 HTTP API 直接控制一台 6 轴机械臂完成 8 项桌面任务。GPT-6 Astra 得分 69.4 居首,GPT-6.1 Sol 64.6、Gemini 4 Argon 55.3、Claude Opus 5.5 48.8、Claude Fable 5.1 46.3;模型平均每项约 30 分钟,人类约 20 秒。

Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首

核心要点速览

  • 总分(满分 100):GPT-6 Astra 69.4、GPT-6.1 Sol 64.6、Gemini 4 Argon 55.3、Claude Opus 5.5 48.8、Claude Fable 5.1 46.3(AA 原文)
  • 速度:模型平均约 30 分钟/任务(Argon 最慢约 52 分钟),人类平均约 20 秒,差距接近两个数量级
  • 成本:GPT-6.1 Sol 平均 $1.93/任务最便宜,GPT-6 Astra $16.36/任务,约 70% 花费来自视觉上下文输入
  • 抓取成功率:GPT-6 Astra 45%、Claude Fable 5.1 44%、Opus 5.5 40%、Argon 36%、Sol 28%
  • 「测量箱子」任务(误差需 ≤2 mm)五个模型最高仅 17 分,精细测量仍是短板
阅读全文