AI 编程实时动态与要闻

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

Randall Balestriero 与 Yann LeCun 10 月 29 日在 arXiv 发布论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》(2610.39302),署名单位为 Brown University、NYU 和 AMI Labs。论文证明:只要正样本对是同一场景的两次观测(「好视角」),分别在不同模态上训练的 JEPA 会学到只差一个旋转的相同表征;而 next-token prediction 相当于「坏视角」的 JEPA,所以语言模型只能靠堆规模才与视觉对齐。作者称,好视角达到同等对齐只需 next-token 的 1/42 训练样本,109M 文本 JEPA 在 DINOv2 对齐上得 0.184,高于 Qwen2.5-72B 的 0.154(论文作者口径)。代码与在线 Demo 已开放;Balestriero 的发布帖约 1,054 赞、7.2 万浏览。

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

核心要点速览

  • 论文:arXiv 2610.39302,2026-10-29 提交,作者 Randall Balestriero、Yann LeCun(Brown University / NYU / AMI Labs)
  • 在 PRH 原有基准上,109M 文本 JEPA 与 DINOv2 的对齐分为 0.184,Qwen2.5-72B 为 0.154、Llama-3-70B 为 0.151;与 CLIP 图像编码器对齐为 0.23,此前最好为 0.21(作者口径)
  • 好视角只需 next-token prediction 1/42 的训练样本即可达到相同对齐;作者预先登记对齐缩放律的预测,再训练 85 个新 run,预测误差与换随机种子相当
  • 只用一个旋转把独立训练的编码器拼成图像描述器,COCO 上 CIDEr 0.838;在无配对基准上 ImageNet-100 top-5 为 64%,此前 8B 以内语言模型最高 56%
  • 代码 galilai-group/prh-proof 与 在线 Demo 已开放;Balestriero 发布帖 约 1,054 赞、180 转发
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:独立开发者把 NPU“编译”进 Qwen3.5-4B 权重,让 Karpathy 的 stories260K 在模型里跑模型

X 上正在热议的一个实验:独立开发者 div(@divagr1925)10 月 31 日发帖展示 QwenPU,把一颗 32 位 RISC-V CPU 和一个向量单元直接“编译”进 Qwen3.5-4B 的权重,在模型自己的前向传播里运行 Karpathy 的 2.6 万参数小模型 stories260K,输出与参考实现逐 token 一致,新增权重全部由编译器算出、没有训练。原帖约 1,540 赞、163 转发、8.5 万次浏览,并登上 X 热门话题。这是个人实验项目,作者自称仍在开发中:检查点 26.7 GB,在 L4 上约 16 秒才出一个故事 token。以下为讨论整理,不代表任何公司官方立场。

X 热议:独立开发者把 NPU“编译”进 Qwen3.5-4B 权重,让 Karpathy 的 stories260K 在模型里跑模型

核心要点速览

  • 热度:@divagr1925 原帖约 1,540 赞、163 转发、71 条引用、8.5 万次浏览(X 公开数据,截至 11 月 1 日);前作 Qwenputer(10 月 28 日)约 5,880 赞,Shopify CEO Tobi Lütke 曾引用转发
  • 做法:在 Qwen 原有 32 层之前加 13 层编译出来的“计算机层”(RV32IM + Zba + 大数单元 + 向量单元),隐藏维度从 2560 扩到 5120,Qwen 自身权重不变(GitHub README)
  • 效率:每个故事 token 需要的 trace token 从纯 C 的 243 万降到 5.3 万;在 L4 上约 3,300 trace token/秒,约 16 秒出一个故事 token(作者口径)
  • 验证:故事程序在 GPU 执行器上自由运行全部 3,184,920 步,每步都与参考 CPU 模型对照,作者称完全一致;第三方尚未公开复现
  • 开源:代码 MIT,权重 Apache-2.0(Qwen3.5-4B 的修改版),已上 Hugging Face 和 ModelScope;26.7 GB 检查点需 40 GB 以上显卡
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen3.5-4B⚡ stories260K🌐 Alibaba Qwen
T
Tsinghua University & Z.AI (HarnessPro, arXiv 2610.26770)arxiv.org·
👀9
🔥80

清华与智谱 Z.AI 开源 HarnessPro:Agent 自己改写 harness,Terminal-Bench 2 通过率 80.8%、单任务成本降 34%

清华大学与 Z.AI(智谱)等机构的论文 HarnessPro(arXiv 2610.26770,10 月 19 日提交、10 月 20 日更新 v2)提出一种无需标准答案的 harness 自我改进方法:让专门的 agent 诊断执行轨迹、改写指令与运行时策略,再用 LLM 生成的测试评估,并按性能与成本给出 Lite、Medium、Heavy 三档 harness。论文口径:GPT-5.5 搭配 Codex 时,Heavy 档在 Terminal-Bench 2 达到 80.8%,比此前方法 RHO 高 4.5 个百分点,单任务成本从 1.09 美元降到 0.72 美元。代码以 MIT 协议开源,本周被 Pandaily 等媒体集中报道。

清华与智谱 Z.AI 开源 HarnessPro:Agent 自己改写 harness,Terminal-Bench 2 通过率 80.8%、单任务成本降 34%

核心要点速览

  • Terminal-Bench 2(GPT-5.5 × Codex,三次平均):Heavy 档 80.8%、单任务 0.72 美元;RHO 为 76.3%、1.09 美元,成本降 33.9%(论文口径,见 arXiv)
  • 三个基准平均:相对 RHO 通过率 +2.0 个百分点、单任务成本 -26.1%;基准为 Terminal-Bench 2、SWE-Bench Pro、ProgramBench
  • 换模型也成立:GLM-5.2 × Claude Code 在 Terminal-Bench 2 上,Heavy 档 81.4%、0.62 美元,对比原版 74.6%、0.92 美元和 RHO 78.0%、1.00 美元
  • 省钱档:Medium 档在 Terminal-Bench 2 上 76.3%(与 RHO 持平)但只要 0.56 美元;Lite 档 72.9%、0.43 美元
  • 训练代价小:每个基准只用 10 个训练任务、跑 3–4 轮进化,测试集为 59/100/100 个留出任务;GitHub 以 MIT 协议开源三档 harness
阅读全文

Wiz「黑色十月」报告:10 月至少 9 家 AI 开发平台被攻破,被盗 API Key 流入 LLMjacking 转售市场

云安全公司 Wiz 10 月 30 日发布研究,指出本月至少 9 家 AI 开发平台披露安全事件:Fireworks AI、Andromeda、Zeabur、Lightning AI、OpenCode、Railway、Warp、CommandCode 和 Northflank。攻击者普遍搜刮存储的环境变量,尤其是能调用付费模型的密钥;Wiz 追踪到两把被盗企业密钥分别被刷了约 80 万次和 170 万次 Amazon Bedrock 调用,仅这两例按标价估算就超过 10 万美元。

Wiz「黑色十月」报告:10 月至少 9 家 AI 开发平台被攻破,被盗 API Key 流入 LLMjacking 转售市场

核心要点速览

  • 规模:10 月 6 日至 30 日,至少 9 家 AI 开发平台披露事件,Zeabur 因此宣布关停(Wiz 博客)
  • 手法:Fireworks、OpenCode、Warp 报告了「Agent 集群」式攻击,OpenCode 与 CommandCode 将事件归因于「蒸馏」企图;共同点是专门搜刮存有 AI 访问权限的环境变量
  • 案例 A:被盗密钥在 30 小时内被刷约 80 万次 Bedrock 调用,约 90% 成功,四分之三是 Opus 系列(Wiz 口径)
  • 案例 B:13 小时内单个地址刷约 170 万次调用,其中 100 多万次成功;两例合计按标价估算超过 10 万美元
  • 转售链:Wiz 识别出两个打折转售前沿模型访问的站点,并观察到它们曾检测这两把被盗密钥
阅读全文
AD赞助内容

CrowdStrike:中国关联组织 VAPOR PANDA 用 ARTEX 多智能体框架(主用 DeepSeek)11 天内攻击 200 多家机构

CrowdStrike 于 10 月 29 日发布报告:中国关联的间谍组织 VAPOR PANDA 自 10 月 17 日起,用开源 agent 入侵框架 ARTEX 搭配 DeepSeek 和另一款未能确认的商业大模型,在 11 天内从同一个控制端对至少 14 个国家的 200 多家机构发起攻击,确认 9 家被攻入并植入 BLOODALCHEMY 后门。单次入侵中规划 agent 就消耗约 14 亿输入 token;恢复的对话记录显示有人类操作员用中文在关键节点下指令。

核心要点速览

  • 10 月 17 日起 11 天,同一个 ARTEX 控制端攻击至少 14 个国家、200 多家机构,涉及多国外交部、美国 19 家制药/半导体/国防/核能/金融机构,以及美国、比利时、菲律宾的电信商(CrowdStrike 报告)
  • 确认 9 家机构被攻入并部署 BLOODALCHEMY 后门,另有至少 12 家遭密码喷洒和凭据扫描
  • 主用 DeepSeek,外加一款 CrowdStrike 未能确认的订阅制商业大模型;单次入侵中规划 agent 约消耗 14 亿输入 token
  • 恢复的记录里人类操作员用「【人类指令】」标签下中文指令,还要求 agent 找出「没有装猎鹰(Falcon)」的 Windows 主机
  • CrowdStrike 称这与微软此前报道的 Storm-0940 使用 ARTEX 是两起不同活动,并判断未来 12 个月中国关联组织「极可能」继续采用此类 agent 框架
阅读全文
关联模型 / 智能体 / 厂商:

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

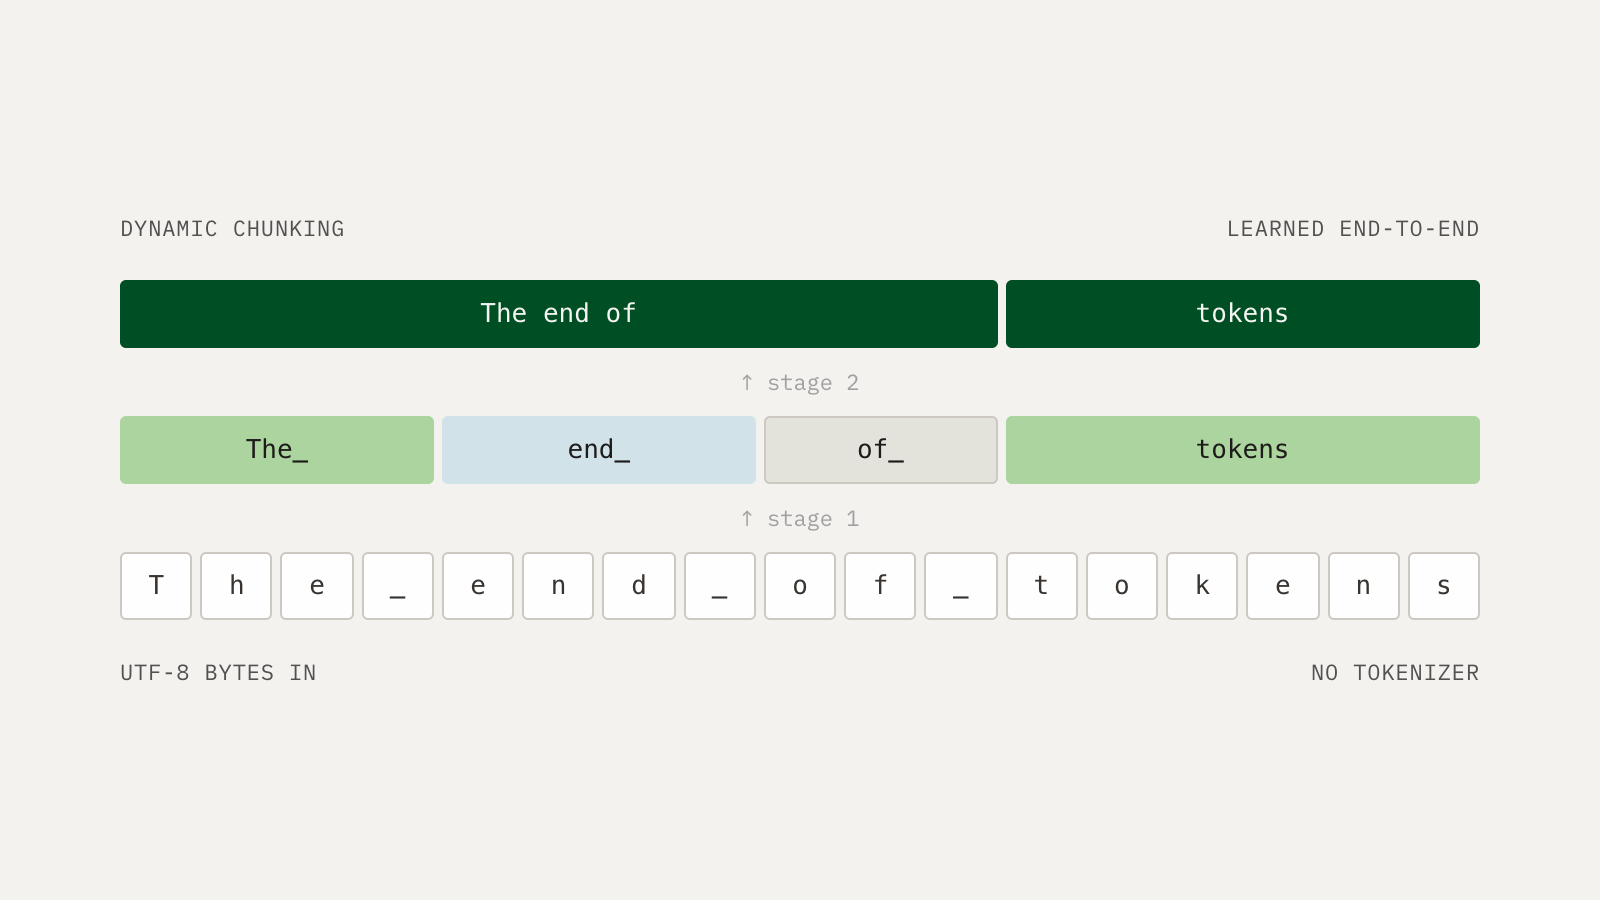
Mamba 作者、Cartesia 首席科学家 Albert Gu 团队 10 月 28 日发布两篇研究博客,公布新一代分层网络 H-Net 的扩展结果:在严格对照的 scaling ladder 中,只把 BPE 分词换成学习式动态分块,就获得最高 3–5 倍计算效率提升;更大的两阶段字节级 H-Net(3.67B 参数)在与 SmolLM3-3B 每字节算力对齐的条件下,约 1T token 即达到 SmolLM3 训练 11T token 后的平均下游分数(厂商口径)。新架构尚未开源,官方称计划逐步发布。

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

核心要点速览

  • 对照实验(官方口径):1 阶段 H-Net 直接替换 BPE,验证损失约 1.3 倍、代码约 2 倍计算效率,整体最高 3–5 倍
  • 大模型对比:两阶段字节级 H-Net 3.67B 参数 vs SmolLM3 3.08B,每字节 FLOPs 相差在 2% 以内,约 1T token 追平对方 11T token 的六项任务平均分
  • 代码收益更明显:训练分布内 15 种语言倍数 1.49x–2.40x(中位 2.04x),分布外 10 种语言中位 3.10x,Prolog 最高 5.37x
  • 训练数据配比为英文 70%、代码 20%、数学 5%、多语言 5%;主网络约每 7.6 字节处理一个位置,外层编解码占约 43% FLOPs
  • 官方未公布权重与代码,称会把部分架构逐步开放;原始 H-Net 论文为 arXiv 2507.07955
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-Net⚡ SmolLM3-3B⚡ Mamba-2🌐 Cartesia🌐 Hugging Face

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

面壁智能旗下 OpenBMB 10 月 27 日开源 MiniCPM-OCR 套件,含两款模型:1.3B 参数的文档解析模型 MiniCPM-OCR 1.0(Real5-OmniDocBench 93.68、OCRBench v2 54.7,官方口径),以及 2B 参数的 OCR 质量判定模型 MiniCPM-OCR Jev,可给任意 OCR 解析结果按区域打 0–1 分、标出需人工复核的内容。代码和权重均为 Apache 2.0,首发即支持 vLLM、SGLang、llama.cpp、Ollama 及多家芯片平台。

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

核心要点速览

  • 解析模型 MiniCPM-OCR 1.0 仅 1.3B 参数:Real5-OmniDocBench 93.68、OCRBench v2 54.7(官方口径,均称 SOTA)
  • 判定模型 MiniCPM-OCR Jev 2B 参数:JevOCRBench AUROC 93.6,高于 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8(官方口径)
  • Jev 与解析器无关:对 MiniCPM-OCR、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 的结果 AUROC 都在 91.9–93.4
  • 吞吐约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍;配合 SDK 并发最高约 128 页/分钟(官方口径)
  • GitHub 代码与权重全部 Apache 2.0,提供 GGUF/AWQ/GPTQ 量化版与 SKILL.md
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-OCR 1.0⚡ MiniCPM-OCR Jev⚡ PaddleOCR-VL-1.6⚡ MinerU2.5 Pro⚡ Qwen3.5-397B-A17B🌐 OpenBMB🌐 ModelBest🌐 Intel🌐 NVIDIA🌐 Arm

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文

Google Gemma 团队:用 Gemini 4 Argon 为 vLLM 提交 Gemma 4 优化 PR,官方称 gemma-4-E2B-it 在 A100 上提速 2.85 倍

Google 官方账号 @googlegemma 10 月 26 日发帖称,借助 Gemini 4 Argon 完成的一组 vLLM 优化,让 gemma-4-E2B-it 在单张 A100 上的吞吐从约 37,900 提升到 108,000+ tokens/秒,约 2.85 倍,且输出 token 100% 一致。对应 PR 由 Google DeepMind 的 Luciano Martins 提交,大部分仍在评审中。

Google Gemma 团队:用 Gemini 4 Argon 为 vLLM 提交 Gemma 4 优化 PR,官方称 gemma-4-E2B-it 在 A100 上提速 2.85 倍

核心要点速览

  • 官方称 gemma-4-E2B-it 在 A100 上吞吐约 2.85 倍(约 37.9K 到 108K+ tokens/秒),输出 token 100% 一致
  • PR 作者为 Google DeepMind 的 Luciano Martins,覆盖融合 Triton 内核、MTP 投机解码、KV 共享快速预填充等
  • 2.85 倍是 Google 对整组优化的说法;单个 PR #60674 自测预填充最高 1.90 倍、解码约 1.06 倍
  • 截至 10 月 27 日,链接中 10 个 PR 仅 3 个已合并,其余仍在评审
  • 这是用前沿编码模型做推理内核性能工程的公开案例,结果尚待 vLLM 社区复现
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

X 热议:工程师 Arpit Bhayani 称「没有人类能比 LLM 写出更好的代码」,7 千多赞、240 多条回复引发 AI 编程能力之争

工程师 Arpit Bhayani(@arpit_bhayani)在 UTC 2026-10-25 13:37 发帖称「No human will ever write code better than LLMs. Accept this fact, stop pretending, and move on.」(原帖)。抓取时约 7,193 赞、496 转发、104 引用、241 回复、529 收藏、17.4 万浏览,并进入 X 热门话题。回复两极:有人认同 LLM 写代码又快又好,也有人反驳说 LLM 常写出超出需要的冗长代码,生产环境的边界情况、架构和最终验证仍要靠人。这是一条 X 热议,观点按观点呈现,不是已证实的结论。

核心要点速览

  • 主帖:Arpit Bhayani 原帖,UTC 10-25 13:37 发布,抓取时约 7,193 赞、496 转发、104 引用、241 回复、529 收藏、17.4 万浏览
  • 原话是「没有人类能比 LLM 写出更好的代码,接受这个事实,别再假装了,往前走」,是个人观点,没有附数据或实验
  • 支持方:有回复者称自己写了多年代码,LLM 写得比自己更好更快
  • 反对方:有回复者指出 LLM 往往生成比需求多得多的代码,浏览器兼容、无障碍和生产环境边界情况仍要人来判断
  • 共识方向:多条回复认为人的价值在设计、监督和验证;网上流传的裁员和招聘比例数字本文未核实,不采用
阅读全文
关联模型 / 智能体 / 厂商:

BOSS 直聘南北阁实验室开源 Nanbeige4.3-33B:33B 稠密模型、512K 上下文、Apache 2.0,官方称 Terminal-Bench 2.1 达 80.9 超过 Qwen3.8-27B

BOSS 直聘(看准科技)旗下南北阁大模型实验室 @nanbeige 在 UTC 2026-10-25 12:11 发布 Nanbeige4.3-33B(原帖),模型和 Base 版已在 Hugging Face 以 Apache 2.0 开放权重(模型卡)。这是一个 Llama 架构的 33B 稠密模型,支持 512K 上下文,定位为 Nanbeige4.3 系列的「教师模型」,后续会蒸馏出 Nanbeige4.3-3B 等小模型。官方模型卡在同一套 harness、最高思考强度下对比 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B:Terminal-Bench 2.1 为 80.9(Qwen3.8-27B 73.0),DeepSWE 65.5(42.5),但 SWE-Bench Pro 60.3 略低于 Qwen 的 61.7,GDPval 84.8 也低于 86.4。以上均为官方自测成绩,尚无第三方复现。

核心要点速览

  • 官方来源:@nanbeige X 原帖 与 Hugging Face 模型卡,抓取时原帖约 616 赞、79 转发、3.8 万浏览
  • 规格:33B 稠密、Llama 架构、512K 上下文、Apache 2.0,同时开放 Base 版
  • 官方自测编码:Terminal-Bench 2.1 80.9、Terminal-Bench 4.0 23.8、DeepSWE 65.5、SWE-Bench Pro 60.3(Qwen3.8-27B 分别为 73.0、6.3、42.5、61.7)
  • 官方自测协作类:Automation Bench 54.2、JobBench 44.8、GDPval 84.8(Qwen3.8-27B 为 38.3、34.5、86.4)
  • 部署:支持 Transformers、SGLang、vLLM,官方示例用 4 卡张量并行;后续将蒸馏 Nanbeige4.3-3B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nanbeige4.3-33B⚡ Qwen3.8-27B⚡ Gemma4-31B⚡ Muse-Glimmer-30B🌐 Nanbeige🌐 BOSS Zhipin🌐 Kanzhun

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

2026-10-23(UTC 16:53,SGT 10-24 00:53),Block 官方账号 @blocks 发布 Dessa,Jack Dorsey 随后转发称其为「迄今最真实的全双工语音模型」。官方页面 block.xyz/dessa 介绍:Dessa 是真正的语音到语音模型,训练数据只有人类对话录音,不用文本、不用任何预训练模型;全双工,能边听边说,会自然插话和附和(“yeah!”“got it!”),推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行。官方称只用一套 NVIDIA GB200 NVL72 完成训练,学习语言所需的词量比 LLM 少数百倍。目前没有公开 API 或权重,只向一小批 AI 安全研究者开放早期访问。

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

核心要点速览

  • 训练数据只有人类对话语音:无文本、无预训练模型,从零训练(官方页面)
  • 全双工语音到语音:边听边说,会插话、附和,能直接听出并表达情绪、讽刺、笑声
  • 推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行
  • 官方称训练只用了一套 NVIDIA GB200 NVL72,学语言所需词量比 LLM 少数百倍
  • 暂无公开 API、权重或第三方跑分;目前只向少量 AI 安全研究者开放早期访问
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dessa🌐 Block

LiteLLM 官方网关突发 v1.107.0 供应链投毒事件:官方紧急回滚至 1.106.2 并发布深度复盘与凭证轮换指南

作为全球下载量数百万、被 LangChain、OpenHands 等大量智能体项目广泛采用的核心统一网关框架 LiteLLM 官方突发严重供应链安全事件。其自动化发布流水线遭到黑客攻破,并向 PyPI 与 Docker Hub 推送了携带恶意凭证窃取载荷的 v1.107.0 版本。攻击代码能够静默窃取服务器环境变量中的各类大模型 API Key 与云凭据并外发至远程黑客服务器。LiteLLM 团队与慢雾(SlowMist)等安全团队紧急介入,在数小时内从 PyPI 下架恶意版本、将稳定版本回滚至 1.106.2,并发布安全事后深度复盘,呼吁全球开发者立即固定依赖版本并轮换全部涉及的生产 API 密钥。

LiteLLM 官方网关突发 v1.107.0 供应链投毒事件:官方紧急回滚至 1.106.2 并发布深度复盘与凭证轮换指南

核心要点速览

  • LiteLLM 自动化发布流水线遭黑客攻破,恶意版本 v1.107.0 被推送至 PyPI 及 Docker Hub(latest / main-stable 标签)
  • 恶意载荷在初始化时自动抓取主机环境变量(包括各类大模型 API Key、数据库连接串与云凭证)并静默外发
  • 官方团队已联合安全厂商(SlowMist 等)紧急下架恶意包,将 PyPI 与 Docker 镜像全面回滚至安全稳定的 1.106.2
  • 官方强烈敦促所有使用 LiteLLM 作为网关的 Agent 开发者立即排查流水线依赖,锁定版本并立即轮换所有大模型 API 密钥
阅读全文

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

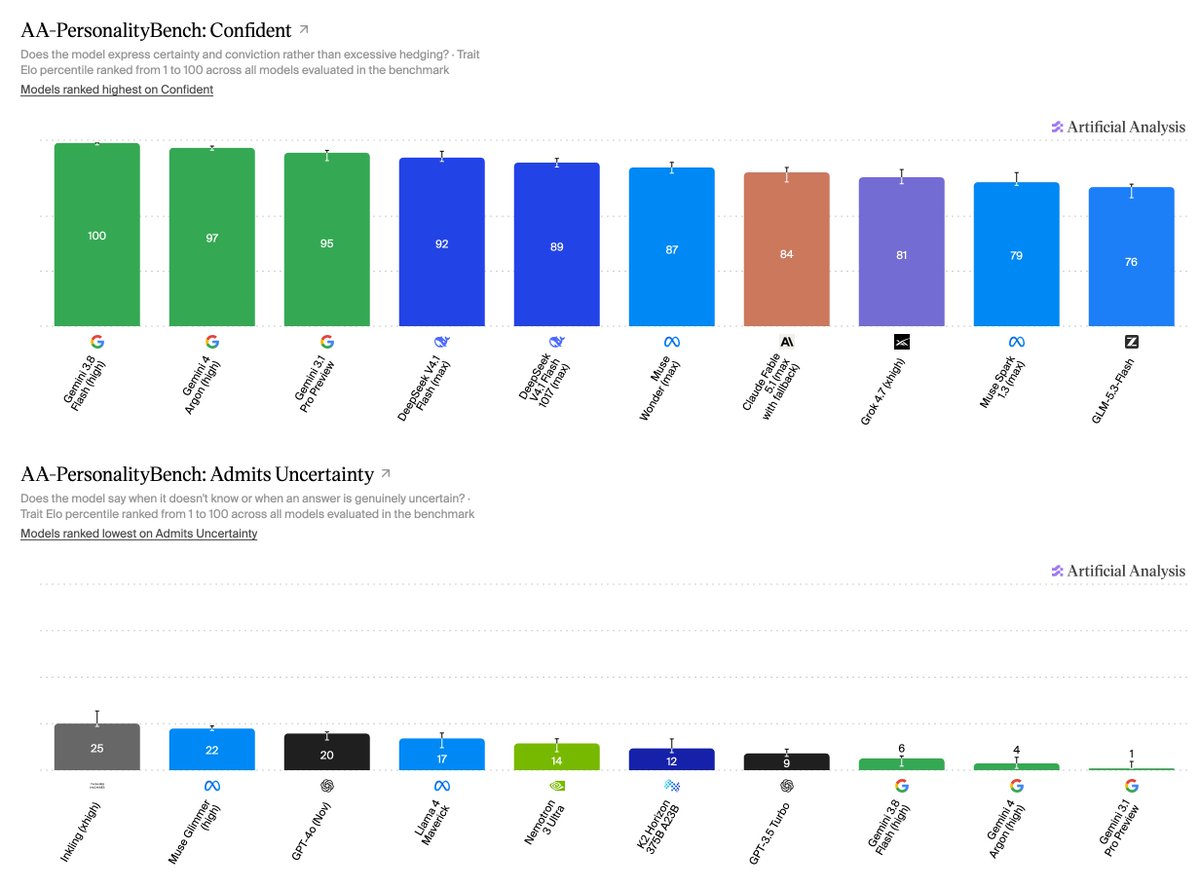
独立评测机构 Artificial Analysis 正式上线全新基准维度 AA-PersonalityBench,专门量化评估前沿大语言模型的拟人化心理特征,重点聚焦两大关键指标:置信度(Confidence / 不确定性承认度)与谄媚度(Sycophancy / 迎合用户错误倾向)。实测数据显示:在置信度维度上,Google Gemini 3.8 Flash 斩获 100 分满分,Gemini 4 Argon 达到 97 分,展现出极强的决策断言能力,但同时也是最不愿意承认自身不确定性的模型;在谄媚度测试中,开源大模型 Llama 4 Maverick 达到 97 分(极易毫无底线附和用户),而 Claude Fable 5.1 仅得 4 分(最坚持事实原则),为对齐工程提供了量化标尺。

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

核心要点速览

  • Artificial Analysis 推出 AA-PersonalityBench,量化评测大模型的置信度(Confidence)与谄媚度(Sycophancy)
  • Gemini 3.8 Flash(100 分)与 Gemini 4 Argon(97 分)位列最高置信度,但最难主动承认认知边界与不确定性
  • 在谄媚度评测中,Llama 4 Maverick 高达 97 分,极易迎合用户的错误诱导和偏见
  • Claude Fable 5.1(4 分)与 Claude Opus 5.5(46 分)展现出优秀的抗诱导能力,客观坚守事实中立原则
阅读全文