AI 编程实时动态与要闻

X 热议:Anthropic 平台工程负责人称团队起步时没有 Rust 工程师,由 Claude 写代码把 Messages API 整体移植到 Rust,CPU 约省 40–50%

Anthropic 平台工程负责人 Katelyn Lesse 在 Latent Space 播客(10 月 27 日上线)中说,上周已全量上线用 Rust 写的 Messages API:原系统是吃 CPU 的 Python 单体,团队起步时「一个 Rust 开发都没有」,人负责系统设计和验证,Claude 写实现,再用影子流量比对新旧两套输出。她给出的粗略数字是 CPU 少约 40–50%,首 token 延迟改善约 10–20%。这段片段被 Somi(@somi_ai)剪出后在 X 上获得 1,000+ 点赞、约 14 万次浏览,swyx 等人转引,讨论焦点是「别搞大重写」这条老经验是否已经过时。以下观点属于 X 讨论,数字为 Lesse 口头估算,Anthropic 尚未发布书面工程报告。

X 热议:Anthropic 平台工程负责人称团队起步时没有 Rust 工程师,由 Claude 写代码把 Messages API 整体移植到 Rust,CPU 约省 40–50%

核心要点速览

  • 一手来源是 Latent Space 播客节目《How Anthropic ships Claude with Claude》中 Katelyn Lesse 的口述,「56:05 Rebuilding the Messages API in Rust」一段
  • Lesse 说迁移起因是用量暴涨后 CPU 成了瓶颈,CPU 需要提前做容量规划,Anthropic 内部研究沙箱、产品沙箱、CI 等都在争同一池 CPU
  • 做法是一次性 fork 整个 API 的 Rust 版本,跑影子流量对比 Python 与 Rust 的输出一致后逐步切换,刻意不在移植中加新功能
  • 她估算 CPU 节省约 40–50%,首 token 延迟改善约 10–20%,长时任务改善更大;这些是播客中的口头粗略数字,非正式基准
  • X 上 Somi 称「别搞大重写」的建议已死,swyx 说 Anthropic「把整个后端 vibecode 成了 Rust」;后者是夸张说法,Lesse 只谈到 Messages API
阅读全文
关联模型 / 智能体 / 厂商:

告别像素重构幻觉!首个隐空间 GUI 世界动作模型发布:延迟暴降 98.9%,在线任务成功率狂飙 40.6%

近期兴起的像素级世界模型(Pixel-space World Models)试图通过预测执行后的未来屏幕画面再反向选动作,但在 GUI 环境中面临双重困境:全屏像素重构计算成本极高,且极易触发“恒等捷径”(Identity Shortcut,即预测画面倾向于维持原样而非体现动作引发的变化)。KAIST 等团队提出首个专为 GUI 智能体打造的隐空间世界动作模型(Latent World Action Model):将预测目标从全屏像素渲染转移至动作引发的隐空间动态转移,引入动作选择与预测转移双头架构及动作感知对比学习。实验显示,在线任务成功率暴增 40.6%,同时将推理延迟大幅压缩了 98.9%。

告别像素重构幻觉!首个隐空间 GUI 世界动作模型发布:延迟暴降 98.9%,在线任务成功率狂飙 40.6%

核心要点速览

  • 破除全屏重构开销与恒等捷径:将未来状态建模从高成本、易抄袭前帧的像素图像生成,重构为轻量级隐空间动态转移预测
  • 解耦双头与动作对比学习:利用多模态大模型基座支撑动作选择与未来转移双预测头,引入对比损失强迫模型捕获动作诱发的细粒度变化
  • 速度与成功率双重飞跃:离线与在线 GUI 任务成功率分别提升 31.9% 与 40.6%,推理延迟断崖式缩减 98.9%,满足实时操作需求
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Latent-WAM⚡ Pixel-World-Model⚡ Claude 3.5 Computer Use🤖 GUI Agents🤖 Desktop OS Agents🌐 KAIST🌐 Yonsei University
A
AMI Labs / H-JEPA@kevinghst/H-JEPA·
👀156
🔥88

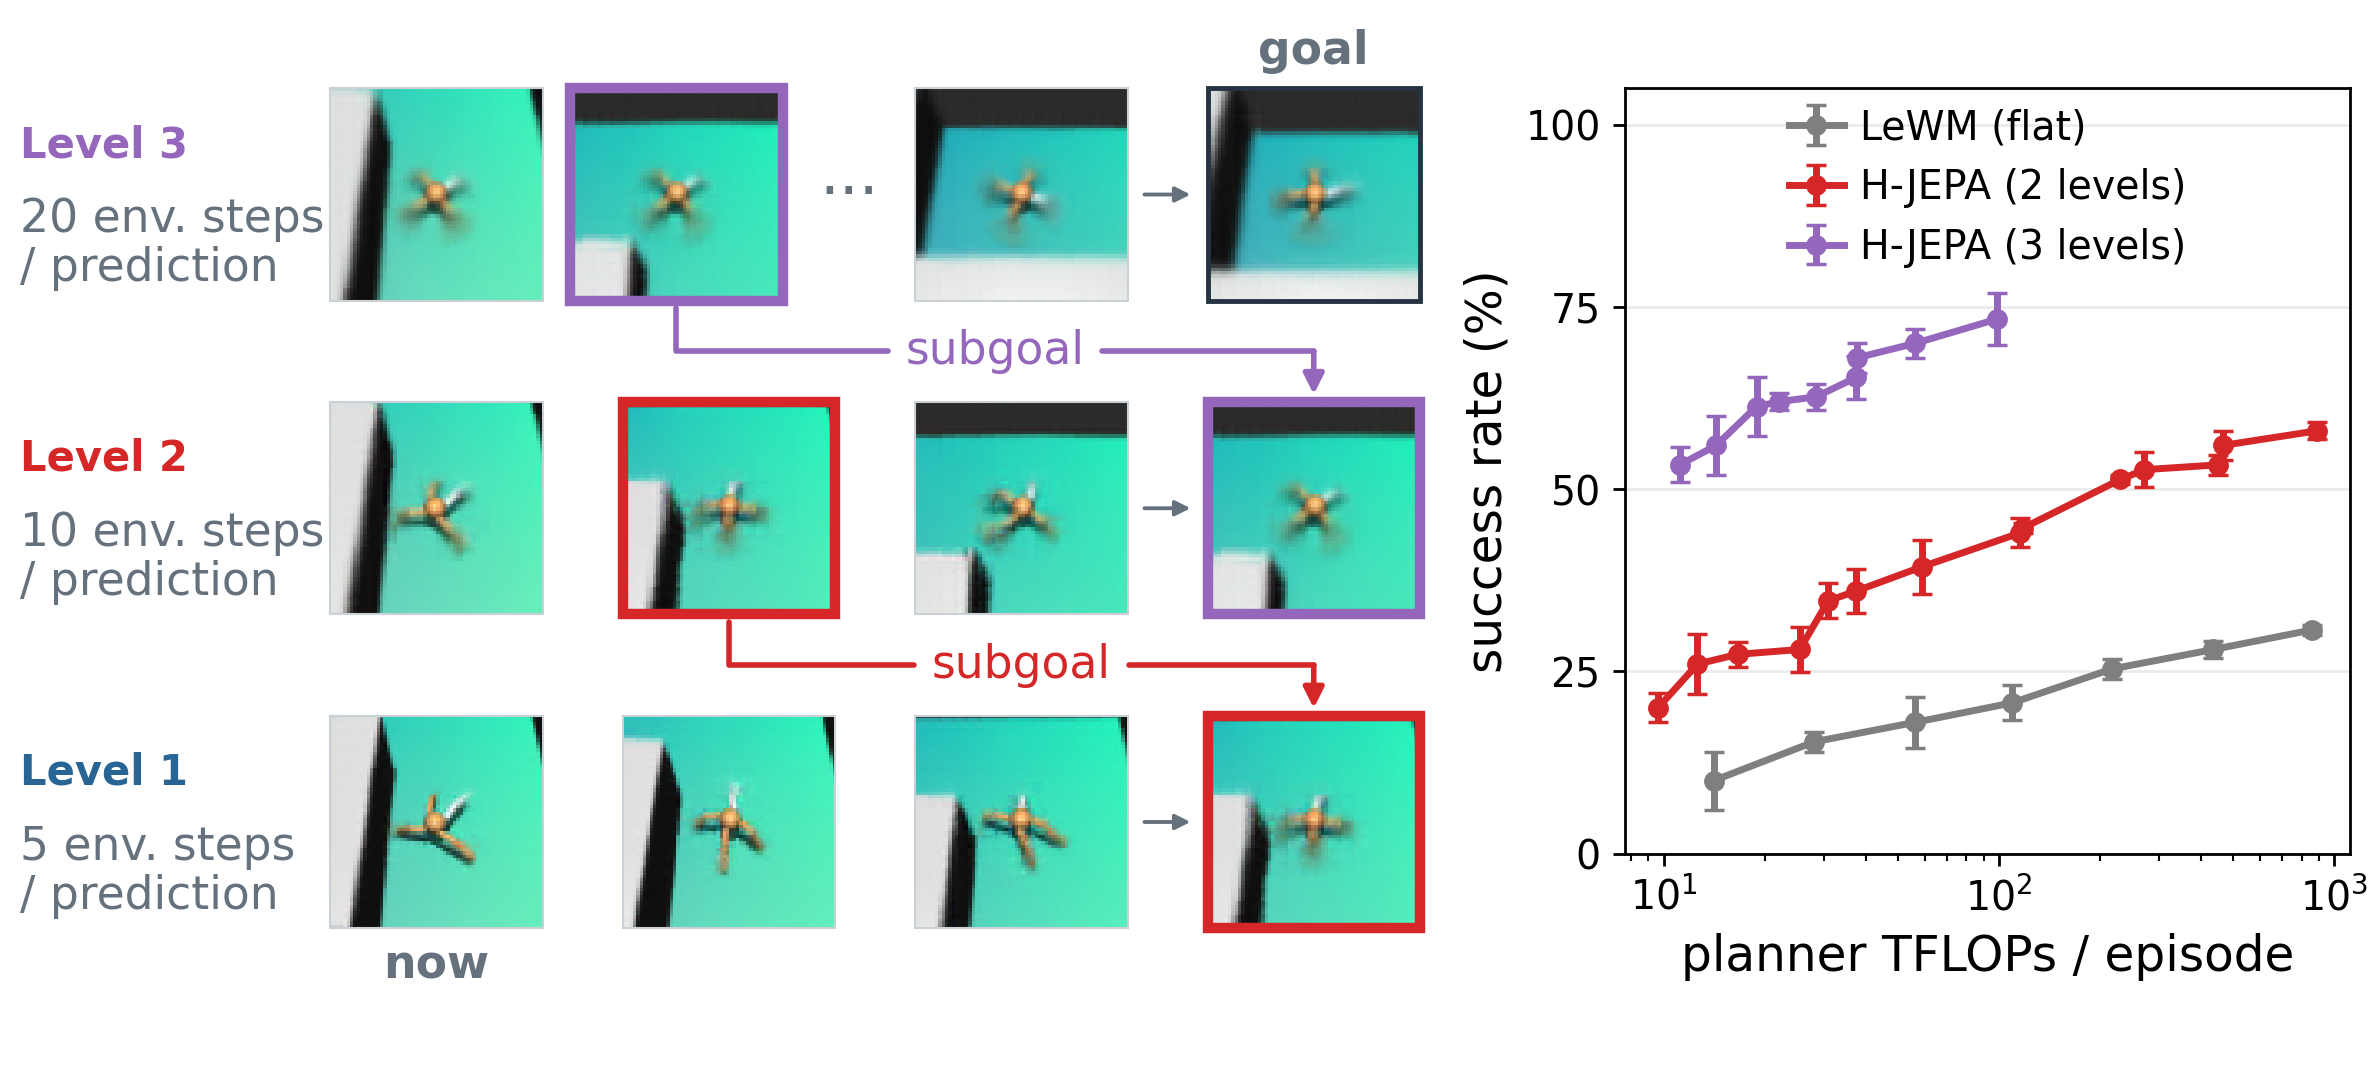
LeCun 的 AMI Labs 开源 H-JEPA:分层世界模型在 Visual AntMaze 上把规划成功率从 18% 提到 73%

Yann LeCun 参与创立的 Advanced Machine Intelligence(AMI Labs)联合 NYU、INRIA Paris、Brown 发布 H-JEPA(arXiv 2610.06805),一次端到端训练多层动作条件 JEPA 世界模型,每层在自己的潜空间里预测更远的未来,规划时自上而下下发子目标。论文口径:三层模型在 Visual AntMaze 成功率 73.3%,单层 LeWM 为 18.0%,规划算力反而更低。训练与评测代码(MIT 协议)以及 93 个 checkpoint 已在 GitHub / Hugging Face 公开。

LeCun 的 AMI Labs 开源 H-JEPA:分层世界模型在 Visual AntMaze 上把规划成功率从 18% 提到 73%

核心要点速览

  • Visual AntMaze:三层 H-JEPA 成功率 73.3%±3.5,单层 LeWM 18.0%±3.5(论文口径,三个种子),且规划 FLOPs 更低(arXiv 2610.06805)
  • FourRoom Distractors:三层 H-JEPA 96.0%,单层 LeWM 40.7%;AntMaze 上接近同深度 HWM(共享潜空间的分层基线)的 2 倍
  • 子目标跟踪代价单调性 0.89–1.00,全程目标代价仅 0.48–0.75,说明分层把长任务拆成了更好优化的子问题
  • 反例:Push-T 三层模型因短 episode 只能用到 LeWM 58% 的训练样本而失效;真实机器人 DROID 必须加逆动力学损失,否则表征坍缩、得分为 0
  • 开源 MIT 代码 + Hugging Face 93 个 checkpoint(约 12.4 GB,覆盖 AntMaze/FourRoom/Cube/Push-T/DROID)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-JEPA⚡ LeWorldModel (LeWM)⚡ V-JEPA 2🌐 AMI Labs🌐 NYU🌐 INRIA🌐 Brown University

单次前向迸发双重思维!最新研究证实大模型存在线性叠加态:引导式解码实现单步并发生成双故事

长期以来,深度神经网络普遍被视作极端非线性(Non-linear)的黑盒映射函数。然而最新前沿可解释性研究《Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs》(arXiv:2609.29845,社区超百赞)给出了颠覆性的数学与实证发现:Transformer 底座在本质上展现出惊人的“叠加线性性(Linear Superposition)”——当向模型线性组合输入两条完全独立的文本流时,输出的预测 Logits 严格呈现为两组独立下一个 Token 分布的线性叠加态!虽然该天然线性在自回归预训练后期因过度饱和会有所衰退,但研究证明仅需轻量级低秩微调即可完全恢复该叠加特性。团队更进一步设计了引导式解码算法(Guided Decoding),在单次模型前向计算(Single Forward Pass)中即可无损解耦出两条连贯独立的长文本续写,为大模型推理并发度拓展开启了全新的理论大门。

单次前向迸发双重思维!最新研究证实大模型存在线性叠加态:引导式解码实现单步并发生成双故事

核心要点速览

  • 提出并严格证明大模型“叠加线性假设(Superposition Linearity Hypothesis)”,颠覆传统黑盒非线性认知
  • 证实轻量级微调能够几乎完全弥合线性混合输入与独立输出平均分布之间的 KL 散度
  • 研发引导式解码机制(Guided Decoding),首次实现在单次前向传播中并发产出两套完整独立的连贯生成
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

比萨大学开源 SAE 潜空间词性表征研究:打破单义神经元假说,证明语法特征呈紧凑稀疏簇分布

比萨大学计算语言学实验室(CoLingLab)联合发布论文并在 GitHub 开源核心实验套件,针对大语言模型可解释性研究中的核心工具稀疏自编码器(SAE)展开严格实证。研究以词性(Part-of-Speech, PoS)形态句法作为受控基准,系统性探究语言模型内部的语法结构究竟由孤立单义神经元编码还是由结构化特征群承载。实验证明:词性特征能够从 SAE 激活中极高精度恢复,且不可归结为词汇记忆;但语法分类绝非“单潜变量对应单类别”,而是由高度紧凑且具有类别特异性的稀疏潜变量群(Compact Groups)共同表征,且在未见测试数据上保持高度稳定。

比萨大学开源 SAE 潜空间词性表征研究:打破单义神经元假说,证明语法特征呈紧凑稀疏簇分布

核心要点速览

  • 打破单义神话:证明语言模型中的形态句法知识并未映射为“一个潜变量对应一个语法标签”,单义性假设在抽象语法层并不成立
  • 稀疏群聚表征:各类词性由高度紧凑的稀疏潜变量簇(Compact Latent Clusters)承载,且开放词类(名词/动词)与封闭词类(介词/代词)表征机制差异显著
  • 非词汇性记忆:严格对照实验证实,SAE 对词性的高可恢复性(High Recoverability)来自深层句法抽象,绝非单纯对高频词汇的记忆过拟合
  • 泛化泛用稳定性:提炼出的词性稀疏特征群在独立测试集(Held-Out Data)上表现出高度鲁棒性,近缘语法范畴之间呈现清晰可解释的特征重叠
  • 完全开源交付:官方开源端到端激活提取管线、探测分类器与分析脚本,支持对主流开源 SAE 进行快速复现与可视化
阅读全文
关联模型 / 智能体 / 厂商:

Latent Space:用超 200 亿 token 压测 Astra,称可在约每小时 <$6 完成 AI 工程全流程

Latent Space 称投入超过 200 亿 token,用 GPT-6 Astra 覆盖选型训练、标注与主动学习、管道饱和、日志可观测、一键部署调试,以及多子智能体编排等 AI 工程任务,并称可在约每小时低于 6 美元的成本下完成严肃工作流,远不止演示级 Blender/游戏用例。

核心要点速览

  • 实测覆盖训练选模、标注/主动学习、管道饱和、日志与一键部署调试。
  • 可编排并评估运行其他模型的子智能体,单线程连贯性可达数十亿 token。
  • 成本叙事:严肃 AI 工程负载约 <$6/小时,附 latent.space/p/astra 长文。
阅读全文
关联模型 / 智能体 / 厂商:

Swyx 发表万字长文解析 Agentic Coding 肌肉记忆演进:从行内补全到终端多智能体编排

知名 AI 技术播客 Latent Space 主理人 Swyx 发表长文,剖析 2026 年开发者心智模型的剧烈演进。他指出,随着复合 AI 系统(Compound AI Systems)和 MCP 协议的成熟,高阶开发者的日常肌肉记忆正从传统的单行 Tab 补全全面转向「终端 Harness 委派多子 Agent 闭环交付」,代码审查能力成为核心生产力分水岭。

核心要点速览

  • Swyx 分析 2026 年开发者 AI 编程肌肉记忆的关键转变;
  • 复合 AI 系统(Compound AI Systems)取代单一 Prompt 成为软件工程主力;
  • 终端多子 Agent 委派与自动化测试闭环成为高阶开发团队标配。
阅读全文