AI 编程实时动态与要闻

GitHub Copilot 接入 JetBrains Air:通过 ACP 在 IDE 本地或云端隔离环境跑编码任务,直接用 Copilot 订阅

GitHub 11 月 3 日在官方 changelog 宣布,GitHub Copilot 已可在 JetBrains Air 中使用。集成基于 Agent Client Protocol(ACP),开发者可以在 Air 的代理选择器里选 Copilot,委派编码任务、并行跟踪多个会话并在代码旁审查改动。任务既可在 JetBrains IDE 本地跑,也可通过 Air Teams 在云端隔离环境跑,用的是 Copilot 订阅额度而不是 JetBrains AI 点数。
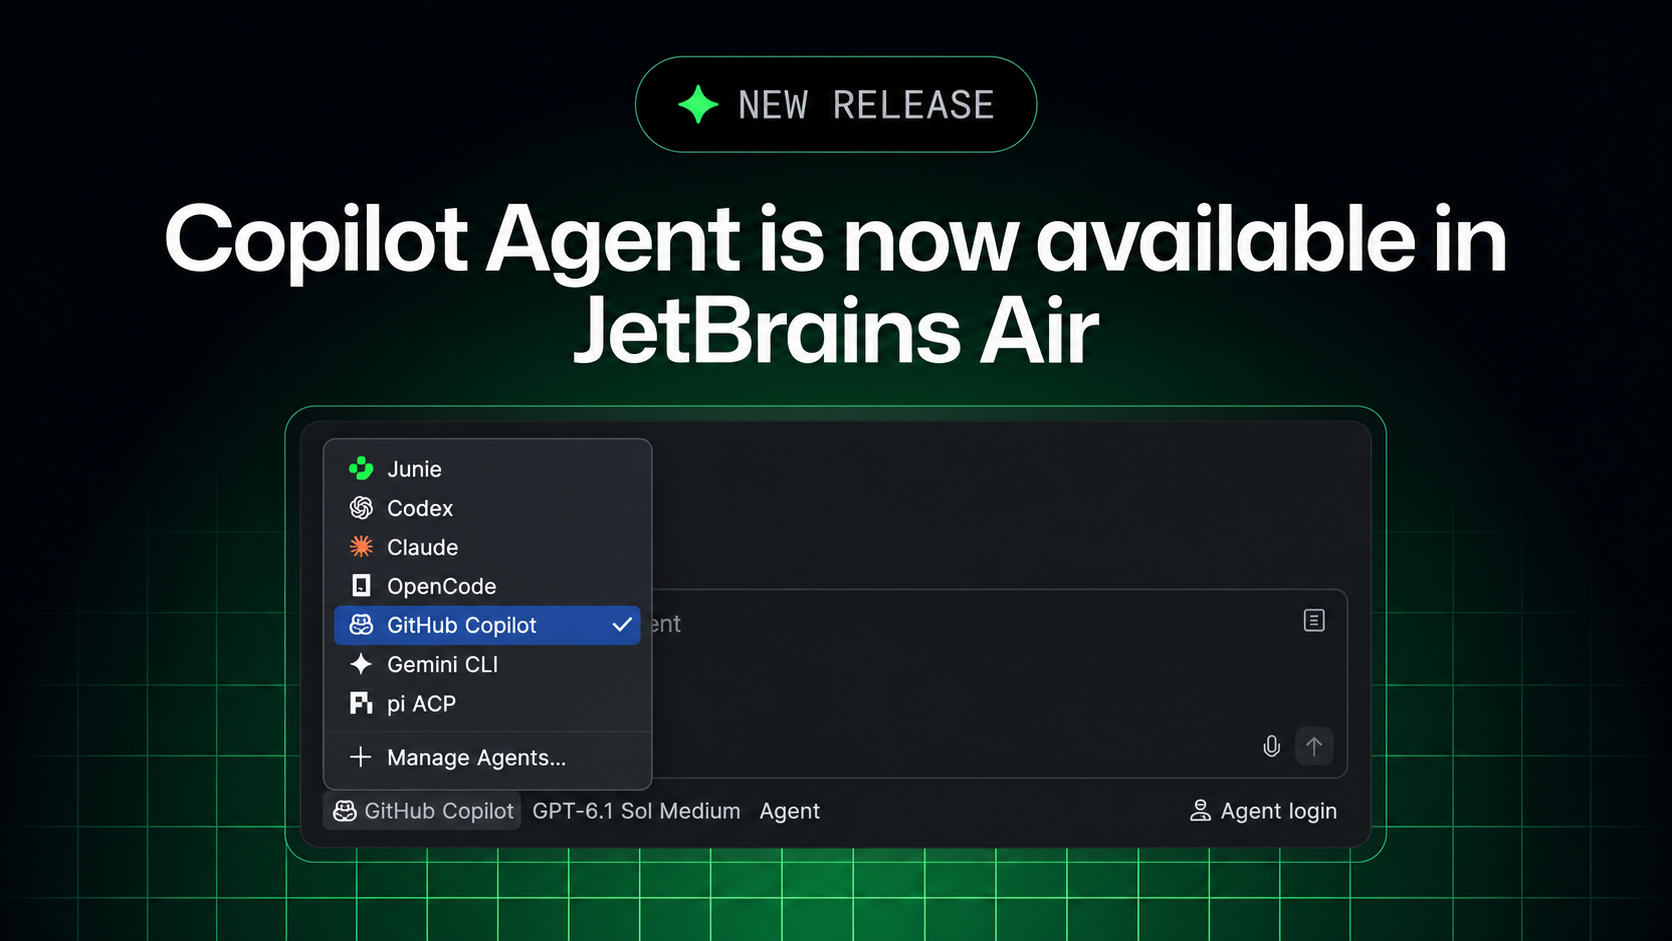
GitHub Copilot 接入 JetBrains Air:通过 ACP 在 IDE 本地或云端隔离环境跑编码任务,直接用 Copilot 订阅

核心要点速览

  • Copilot 出现在 JetBrains Air 的代理选择器里,连上已有 Copilot 账号即可用于编码任务
  • 集成基于 Agent Client Protocol(ACP),可与原有 GitHub Copilot 插件并行使用
  • 支持并行跟踪多个代理会话,并利用项目上下文和 IDE 工具在代码旁审查改动
  • 云端任务通过 Air Teams 运行,每个任务在全新虚拟机的 Docker 容器里执行,流量经代理,任务之间不保留状态
  • 云任务消耗 Copilot 订阅而非 JetBrains AI 点数;但 Air 的分析不统计 Copilot 用量,管理员也不能在 Air 内设 Copilot 消费上限
阅读全文

OpenAI 公布自主漏洞挖掘流水线:用未发布的网络安全模型一次跑出 948 个 Linux 内核提权漏洞并生成补丁,API 成本 121 万美元

OpenAI 11 月 4 日发布研究文章《A thousand fewer paths to root》:其自主漏洞发现、验证、利用和补丁生成流水线在 10 月中旬用一款即将推出的网络安全模型扫描 Linux 内核,复现 1,724 个漏洞,做出 948 个不同的本地提权(LPE)漏洞利用和补丁,总 API 成本 1,213,430 美元,约合每个 1,279 美元;已向维护者发出数百份报告与补丁。

OpenAI 公布自主漏洞挖掘流水线:用未发布的网络安全模型一次跑出 948 个 Linux 内核提权漏洞并生成补丁,API 成本 121 万美元

核心要点速览

  • 流水线五步:发现、动态复现、可利用性评估、补丁生成、人工审核
  • 2,308 个候选发现中复现 1,724 个,产出 291 个信息泄露 PoC 与 948 个不同 LPE
  • 总成本 1,213,430 美元;按 Pwn2Own、TyphoonPWN 历史赏金估算价值 1,890 万至 6,630 万美元
  • 同一流程下新模型找到的新 LPE 是 7 月 GPT-5.6 Sol 那轮(166 个)的 5 倍以上
  • 智能体使用了至少 10 种此前未知的 Linux 利用技术,细节出于安全考虑未公开
阅读全文
关联模型 / 智能体 / 厂商:

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

Ricursive Intelligence 于 11 月 4 日(UTC 18:24)发布首个模型 Ripple-65B Preview,并在 Hugging Face 以 Apache 2.0 开源指令版(BF16、NVFP4)和基座版。官方模型卡显示:65B 稠密 Transformer、12T token 预训练、最长 1M 上下文,自报 TerminalBench 2.1 80.5、SWE-bench Pro v2.0 Hard 79.1、DeepSWE 1.1 44.3,在编码 Agent 任务上超过参数大得多的美国开源模型;可在 DGX Spark 等本地硬件运行。CEO Anna Goldie 称成本约为此前同类 SOTA 的十分之一。

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

核心要点速览

  • Ripple-65B Preview 为 65B 稠密模型,80 层、d_model 5120 的“窄而深”结构,从 Olmo 3 基线改为类 Gemma 3N 架构。
  • 预训练 12T token(8K 序列),后训练含中训练、长上下文、SFT 与混合领域 RL,支持最长 1M 上下文。
  • 自报 TerminalBench 2.1 80.5,高于 Reflection Beam 501B(80.1)、Muse Spark Open 816B(76.4);但 SWE-bench Verified 76.5、DeepSWE 1.1 44.3 并非全面领先。
  • 官方称核心团队从 1 人扩到 5 人,代码计算效率相对 Olmo 3 提升 16 倍;2×B200 上约 250 tok/s。
  • Hugging Face 提供 BF16、NVFP4、基座版和 DFlash2 投机解码模型,许可均为 Apache 2.0。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ripple-65B Preview⚡ Reflection Beam 501B⚡ Muse Spark Open⚡ Nemotron 3 Ultra🌐 Ricursive Intelligence🌐 NVIDIA

webAI 开源 TwIL-8B:8.8B 推理小模型,LiveCodeBench 81.6、MATH-500 98.2,非商用许可

webAI CEO David Stout 于 11 月 4 日(UTC 17:37)在 X 上宣布开源 TwIL-8B。官方 Hugging Face 模型卡显示:它基于 IBM Granite 4.2 8B,经全参数 SFT、GRPO/DAPO 强化学习和长度感知 RL 训练,分 balanced 与 verbose 两个版本;自报 LiveCodeBench 81.6(verbose)、MATH-500 98.2、IFBench 74.4,约为前沿模型 93%/92% 的水平,但 GPQA Diamond 仅 70.2。提供 4.98 GiB 的 Q4_K_M GGUF,可在本地运行;许可为 webAI 非商用协议。

webAI 开源 TwIL-8B:8.8B 推理小模型,LiveCodeBench 81.6、MATH-500 98.2,非商用许可

核心要点速览

  • TwIL-8B 共 8.79B 参数,基于 IBM ibm-granite/granite-4.2-8b,上下文 131,072 tokens,仅英文、文本到文本。
  • 自报成绩:MATH-500 98.2、AIME 2025 88.3、LiveCodeBench 81.6(verbose)、IFBench 74.4(verbose);GPQA Diamond 70.2 明显落后 Qwen3.5-9B(81.7)。
  • balanced 版在 AIME 2026 平均每题约 19.5k 输出 tokens,比 Qwen3.5-9B 的 31.2k 少约 38%,但仍约为 GPT-5.5 的 4 倍。
  • 所有分数为 webAI 内部测评,竞品分数直接引用公开数据、未重跑;未测 SWE-bench、工具调用和 Agent 任务。
  • 许可为 webAI Non-Commercial License 1.0,不能直接商用;GGUF Q4_K_M 约 4.98 GiB,可用 llama.cpp 本地运行。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ TwIL-8B⚡ Granite 4.2 8B⚡ Qwen3.5-9B⚡ Gemma 4 31B🌐 webAI🌐 IBM
AD赞助内容

Conductor 宣布加入 Meta:多编码智能体协作工具团队并入 MSL,Conductor Cloud 11 月 20 日关停

Conductor 的 Charlie Holtz 于 11 月 4 日(UTC 18:18)在 X 上宣布 Conductor 加入 Meta,将与 Nat Friedman、Alexandr Wang 在 Meta Superintelligence Labs(MSL)打造“下一代界面”。官方公告给出时间表:11 月 4 日起停止新用户注册、Pro 功能对现有用户免费;11 月 13 日 Cloud 只读并给活跃订阅者退款;11 月 20 日 Cloud 关停并开始删除云端数据;本地版持续更新新模型和关键修复到 2027 年初。交易金额未披露。

Conductor 宣布加入 Meta:多编码智能体协作工具团队并入 MSL,Conductor Cloud 11 月 20 日关停

核心要点速览

  • Conductor 是 2025 年 7 月上线的工具,用来同时调度多个编码智能体(底层跑 Claude Code、Codex、Cursor、OpenCode 等第一方智能体),官网称有 10 万+ 开发者使用。
  • 团队将进入 Meta Superintelligence Labs,与 Nat Friedman、Alexandr Wang 合作;新产品官方只说“明年初”推出,细节未公布。
  • 关键日期:11/4 停止注册与下载、11/13 Cloud 只读并退款、11/20 Cloud 关停并开始删除数据,本地版维护到 2027 年初。
  • 迁移方式:在云端工作区上右键选择 Transfer to local,或在 Settings → Account → Export data 导出全部数据。
  • 交易金额未披露;同一天 HumanLayer 也宣布加入 Factory,编码智能体工具赛道正在快速整合。
阅读全文

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

Axiom 于 11 月 4 日(X 官方账号 UTC 17:13 发帖,帖子浏览超 200 万)发布整部 Stacks Project 的 Lean 形式化。这部约 7500 页的代数几何开源参考书由 Johan de Jong 于 2005 年发起,形式化后约 1600 万行代码,官方称是迄今最大的一体化、可复用形式化数学库。工作由分层协调的 AI 智能体集群完成,过程中发现了原文数十处需要局部修正的命题,并给出反例。成果开源,可在 stacks.axiommath.ai 对照原文浏览。

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

核心要点速览

  • 规模:约 7500 页原文、约 1600 万行 Lean 代码,官方称是最大的一体化可复用形式化数学库(厂商自述)。
  • 方法:分层 AI 智能体集群并行翻译命题、在 Mathlib 中查找已有抽象、构造证明,并用多智能体审计和与原文的语义交叉检查保证命题忠实。
  • 发现:系统找出原文数十处需修正的命题,包括缺失假设、正特征下的边界情况,并为错误处构造了显式反例。
  • 保留 Stacks 永久标签结构,每个 Lean 声明都能对应回原文;stacks.axiommath.ai 提供对照阅读和依赖图。
  • 这是 Axiom 继 10 月 27 日发布有限单群分类(CFSG)形式化之后的又一大型发布;按 de Jong 的要求,修正内容不直接提交到上游仓库。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Vercel CEO Guillermo Rauch 喊话「拥有你自己的智能」,呼吁本地模型继续普及、自己掌握 Agent 的 harness 与数据

Vercel CEO Guillermo Rauch 11 月 1 日在 X 上发帖:「拥有你自己的智能。任何反对这一点的人都有东西要卖给你(也许是把你自己的智能再卖回给你)。」他认为本地模型需要继续普及,超大模型暂时跑不了本地,所以最好的选择是保持选择权:自己掌握 harness、数据、连接和运行时,也就是自己的 Agent,并拥抱开源。帖子约 12 小时内获得约 2500 赞、12.8 万浏览,100 多条引用,讨论集中在本地与云端如何取舍。

核心要点速览

  • 这是 Rauch 的个人观点帖,不是 Vercel 官方公告或产品发布。
  • 原帖(2026-11-01 21:08 UTC)约 2533 赞、255 转发、266 回复、107 引用、12.8 万浏览,581 次收藏(抓取时数据)。
  • 核心主张:本地模型要继续普及;在超大模型跑不了本地之前,保持选择权,自己掌握 harness、数据、连接、运行时和 Agent,拥抱开源。
  • Maple AI 联合创始人兼 CEO Mark(@marksuman)引用回应:会是混合形态,云端永远更强,未来要把本地优先的 AI 和私有云配合起来。
  • 工程师 Shantanu Goel(@shantanugoel)引用称「Guillermo 说出了多数人不愿说的真话」,约 37 赞。
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

Google DeepMind 于 10 月 31 日宣布,与英国政府、Google Cloud 和 Faculty 共同开发的规划审查工具 PlanAssist(基于 Gemini)将新增开放给 12 个英格兰地方规划机构,参与总数达到 15 个,进入为期 12 个月的 Beta 阶段并处理真实申请。官方称,在 Barnet、Camden、Dorset 三地的早期试点中,规划官员花在住宅类申请评估上的平均时间下降 58%,超过 70% 的 AI 草拟报告无需修改即获通过;最终决定仍由规划官员作出。

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

核心要点速览

  • 规模:从 3 个试点地方政府扩到 15 个,新增 12 个分三批接入,Beta 期 12 个月(DeepMind 博客)
  • 效率:试点中住宅类申请的官员评估时间平均下降 58%(官方/厂商口径,DeepMind 在 X 上写作「最多 58%」)
  • 质量:超过 70% 的 AI 草拟报告被官员直接批准、无需修改(官方口径)
  • 英国政府称,配合新规,住宅类常规申请处理时间可从 8 周减半到 4 周;计划 2027 年向英格兰所有地方政府开放(GOV.UK)
阅读全文
关联模型 / 智能体 / 厂商:

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

开源编码智能体 OpenCode 背后的 Anomaly 发布语音输入工具 Hex 3.0 稳定版:按住快捷键说话、松开即粘贴到光标处,语音识别在本机完成,内存占用从约 900MB 降到约 160MB,并新增词汇表、hex 命令行和可选的 OpenCode 改写。

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

核心要点速览

  • Hex v3.0.0 于 10 月 31 日 00:38 UTC 在 GitHub 发布,MIT 协议、Rust 编写,仓库约 1,557 星(发布说明)
  • 官方口径:本地模型内存占用从约 900MB 降到约 160MB;2.3.0 起边说边转写,2 分钟口述松键后约 0.1 秒出字(RTX 5070 Ti)
  • 支持 macOS 15+(Apple 芯片)、Windows x64/ARM64、Linux x64/ARM64,Linux 新增 .deb/.rpm 包
  • 3.0 不自动从 2.3.1 升级,设置、历史和模型需重新下载;语音动作和口令功能被移除
  • @opencode 的发布帖约 2,400 赞、1,600 收藏、10 万+浏览(原帖)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Parakeet⚡ Whisper🤖 OpenCode🤖 Hex🌐 Anomaly

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

Stripe 联合创始人 John Collison 的 Cheeky Pint 播客 10 月 29 日上线 Sam Altman 专访。谈到内存短缺时,Altman 说很多人以为开源模型加本地推理就能绕开算力紧张,但从全球配置角度看,让每个人电脑里放着一堆稀缺 DRAM、只有约 5% 的时间在用「相当糟糕」,供给紧张时应追求云端的最大利用率。pubity 转述这段话的帖子获得 2.6 万多点赞、800 多万次浏览,大量用户反驳称 PC 内存并非只为 AI 服务,本地模型还关乎隐私和离线可用。以下按观点讨论整理,不代表已证实结论。

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

核心要点速览

  • 出处:Cheeky Pint 播客 10 月 29 日 Sam Altman 专访,官方文字稿可查,原话含「being used 5% of the time」
  • Altman 的论点:DRAM 供给紧张时,放在个人电脑里的内存利用率低,云端数据中心可持续服务多用户,应追求最大利用率
  • 热度(X API,10 月 31 日 13:06 SGT 读取):pubity 帖 26,124 赞、8,557 条引用、5,210 条回复、约 806 万次浏览
  • 主要反驳:PC 内存还要跑系统、浏览器和游戏;本地模型让数据留在本机;也有人指出这与 OpenAI 的云端商业模式一致
  • 5% 这个数字 Altman 未解释口径,媒体建议当作粗略估计而非测量值
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Epoch AI 实验:开源权重模型 GLM 5.3 利用“补丁空窗期”自主攻破 6 个 Firefox 版本,每个约 1000 美元

Epoch AI 10 月 29 日发布报告:在刻意简化、模拟低水平攻击者的设置下,Z.ai 8 月发布的开源权重模型 GLM 5.3 读取已公开但尚未推送给用户的安全修复,自主为 9 月 17 日至 10 月 26 日的 6 个 Firefox 版本写出“打开网页即可读取本地文件”的攻击链,每个版本边际成本约 1000 美元,最快 12 小时完成。Mozilla 已在 10 月 27 日的 Firefox 159.0 中修复其中一个此前未公开的漏洞。

Epoch AI 实验:开源权重模型 GLM 5.3 利用“补丁空窗期”自主攻破 6 个 Firefox 版本,每个约 1000 美元

核心要点速览

  • 6/6:9 月 17 日至 10 月 26 日发布的 6 个 Firefox 版本全部被攻破,只用各版本发布时已公开的信息(Epoch 报告)
  • 每个版本边际成本约 1000 美元,给了 48 小时上限,最快 12 小时;含环境搭建在内的 Firefox 研究总花费超过 10 万美元
  • 模型还每次都自行重新发现一个未公开漏洞,Mozilla 已在 10 月 27 日的 Firefox 159.0 中修复
  • 通过官方和第三方 API 调用全程没有触发任何拒答或安全拦截
  • 同样方法花约 10 万美元尝试 Chrome 未成功,Epoch 说明这不代表 Chrome 安全
阅读全文
关联模型 / 智能体 / 厂商:

OpenCode 2.2.3 内置 Claude Agent 提供方:用自己的 Claude Code 登录(含订阅)在 OpenCode 里跑 Claude 模型

开源编程 agent OpenCode 于 10 月 30 日 09:55(UTC)发布 v2.2.3,新增内置的「Claude Agent」提供方:安装 Claude Code 并运行 claude auth login 后,在 /connect 里选择 Claude Agent,即可用自己的 Claude Code 登录(订阅、API key 或云账号均可)调用 Claude 模型。它通过 Anthropic 公开的 Claude Agent SDK 运行用户本机的 claude 程序,但关掉 Claude Code 自带工具,改用 OpenCode 自己的工具和权限系统。发布前几小时,OpenCode 团队成员 dax(@thdxr)在 X 上预告「如果能在 opencode 里用你的 Claude 订阅呢」,获约 2,300 赞。

核心要点速览

  • v2.2.3 于 10 月 30 日 09:55(UTC)发布,首条亮点即「在 OpenCode 中使用 Claude Code」,对应 PR #58782(发布说明)
  • 用法三步:安装 Claude Code,运行 claude auth login,在 /connect 中选择 Claude Agent;可用 OPENCODE_CLAUDE_PATH 指定 claude 路径
  • 设计文档称:只用公开 SDK,不读取 Claude Code 保存的登录信息,也不拦截或修改其请求;订阅、API key、云账号登录都能用(设计文档)
  • Claude Code 自带工具、CLAUDE.md、hooks、MCP、技能、自动压缩和自动记忆全部关闭,统一走 OpenCode 的工具、权限和压缩;每个会话一个 claude 进程,空闲 5 分钟停止
  • dax(@thdxr)的预告帖约 2,300 赞、280 条回复(原帖);官方未公布任何性能对比
阅读全文
关联模型 / 智能体 / 厂商:

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

月之暗面 Kimi 官方账号 10 月 30 日 03:14(UTC)发布 3D Make,称 Kimi 可连接 Blender 和 CAD 等工具来建模、组装场景和开发游戏,已在 kimi.ai 和 Kimi Work 上线。官方同步发布的 3D 教程说明,K3.1 Pro 经过专门训练,通过 Python 脚本操作 3D 软件,即使没有 MCP 支持的专业软件也能纳入工作流;人物、动物等网格模型则自动调用 Tripo 等扩散模型生成。需要本地软件的插件仅在 Kimi Work 中可用。

Kimi 推出 3D Make:K3.1 Pro 可直接操作 Blender、CAD 和 Unreal/Unity/Godot 引擎建模、搭场景、做游戏

核心要点速览

  • 上线范围:3D Make 已在 kimi.ai 和 Kimi Work 提供,依赖本地软件的插件仅限 Kimi Work
  • 两种建模路线:参数化建模由 K3.1 Pro 写 Python 脚本完成(家具、机械件、建筑),网格建模自动调用 Tripo、Meshy、Hyper3D 等服务
  • 引擎适配:官方称已适配 Unreal Engine、Unity 和 Godot,可导入模型、搭场景、逐步实现玩法
  • 官方案例:K3.1 Pro 发布视频里的天宫场景用 Unreal Engine 5.8 制作,源模型合计 3600 万个三角形,用 Nanite 和 Lumen 渲染
  • 跑分:官方未公布 3D 相关基准,教程也承认部分任务需要多轮修改,骨骼绑定和复杂材质仍是短板
阅读全文

阿里云首届国际云栖大会落地阿姆斯特丹:开通荷兰公共云区域,引入 Agent 沙箱等智能体服务,JetBrains 探索用 Qwen 驱动 Junie

10 月 29 日,阿里云在阿姆斯特丹举办首届国际云栖大会(Apsara Conference),宣布开通荷兰首个公共云区域(两座数据中心),这是其在欧洲的第四个区域。阿里云同时计划把 ACS Agent Sandbox、Agent Security Center、AI Security Guardrails 2.0、Agentic SOC 和 STAROps 等智能体服务引入该区域,并发布新一代 Apsara Stack 混合云。合作方面,JetBrains 正与阿里云探索用 Qwen 模型驱动其 AI 编码助手 Junie,覆盖云端和本地两种场景。

阿里云首届国际云栖大会落地阿姆斯特丹:开通荷兰公共云区域,引入 Agent 沙箱等智能体服务,JetBrains 探索用 Qwen 驱动 Junie

核心要点速览

  • 荷兰区域含 2 座数据中心,是阿里云继法兰克福、伦敦、巴黎之后的第 4 个欧洲区域;全球达 32 个区域、109 个可用区(官方口径)
  • 计划引入 5 项智能体服务:ACS Agent Sandbox(硬件级隔离)、Agent Security Center、AI Security Guardrails 2.0、Agentic SOC、STAROps
  • 新一代 Apsara Stack 提供 80 多个云与 AI 产品,官方称 AI 运维准确率 92.5%、自动化率 70%
  • JetBrains 与阿里云探索用 Qwen 驱动 Junie,可选区域内云端或完全本地运行;orq.ai、Monks、Magnific、Idea.ai 也接入了阿里模型
  • 未来 12 个月计划在芬兰建首个区域,并扩建德国、法国数据中心;属于此前宣布的 530 亿美元 AI 与云基础设施投入
阅读全文
关联模型 / 智能体 / 厂商: