AI 编程实时动态与要闻

Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

11 月 8 日(北京时间 11 月 9 日早上),独立评测机构 Artificial Analysis 发布决策模型榜单 Decision Index 第二版。新版把头号指标换成同时看「答对没有」和「置信度准不准」的 Decision Score,私有数据占比从 v1 的 25% 提到 45%,新增 1,500 份私有文档的 AA-Paperclip 和测一致性的 AA-Symmetry。决策模型中 Nace AI 的 Drex Max v1.1 与 Fastino 的 GLiDE v1.2 同为 73 分,Drex Max 以小数微弱领先,Base Labs 的 Mammoth 27B 72 分。通用大模型 Claude Haiku 5.5 (Max) 77 分、GPT-6 Luna (Max) 76 分更高,但每百万任务成本分别为 6,240 和 1,530 美元,远高于 Drex Max 的 102 美元。
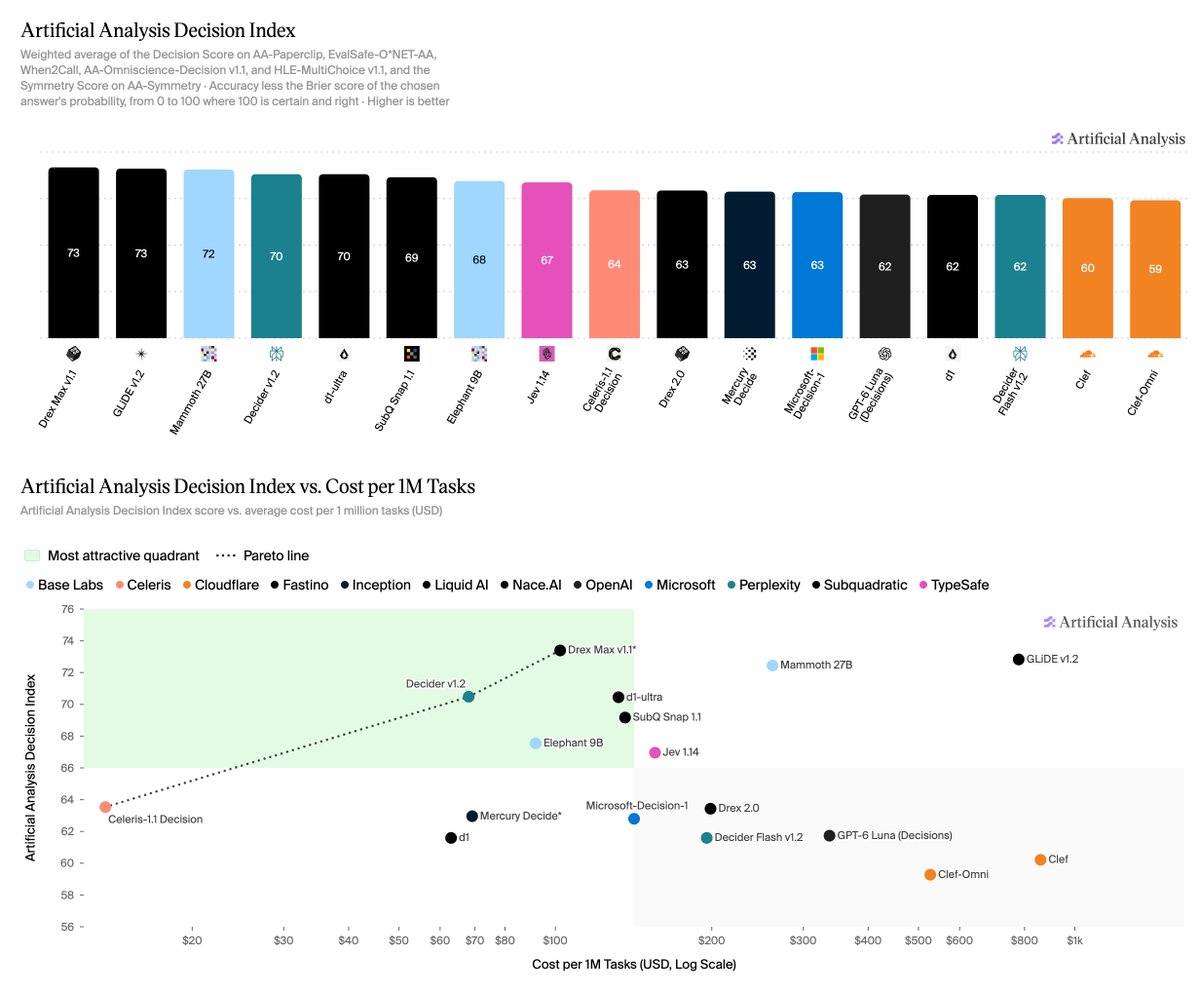
Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

核心要点速览

  • 新指标(官方榜单):单题得分 = 50 ×(1 + c −(p − c)²),整体等于 50 ×(1 + 准确率 − Brier 分数),答对必高于 50、答错必低于 50,置信度在各自半区内拉开差距
  • 权重重排:AA-Paperclip 30%、AA-Symmetry 15%、EvalSafe-O*NET-AA 15%、AA-Omniscience-Decision v1.1 15%、HLE-MultiChoice v1.1 15%、NVIDIA When2Call 10%(v1 为 25%),饱和的 WildGuardTest 被移除
  • 决策模型前三(官方口径):Drex Max v1.1 73、GLiDE v1.2 73、Mammoth 27B 72;通用模型 Claude Haiku 5.5 (Max) 77、GPT-6 Luna (Max) 76
  • 成本差距超 60 倍:Celeris-1.1 Decision 每百万任务 14 美元、Drex Max v1.1 102 美元、Clef 859 美元;GLiDE v1.2 每道题重复计费输入,成本 780 美元,约为 Drex Max 的 8 倍
  • 速度:Celeris-1.1 Decision 单任务 56 毫秒、Elephant 9B 70 毫秒;GPT-6 Luna (Max) 11.34 秒、Claude Haiku 5.5 (Max) 32.65 秒
阅读全文
关联模型 / 智能体 / 厂商:

Kakao 开源 Kanana-2-v-decide-3b:3.67B 多模态决策模型,输出概率/选择/分数,厂商口径 Decision Index 均值 61.23

Kakao 于 2026-11-06 在 Hugging Face 开源 Kanana-2-v-decide-3b-2611(约 3.67B),基于 Kanana-2-v-3b:不生成自然语言,只返回 choice / noul / score 及概率。厂商口径:Kanana Decision Bench 72.50;Decision Index+Vision 均值 61.23;H200 单卡平均 <0.04 秒,称较 GPT-6 Luna 约快 43 倍。Kanana Open License 可商用。

Kakao 开源 Kanana-2-v-decide-3b:3.67B 多模态决策模型,输出概率/选择/分数,厂商口径 Decision Index 均值 61.23

核心要点速览

  • 官方:HF 开源 kakaocorp/kanana-2-v-decide-3b-2611(~3.67B),Kanana Open License 可商用
  • 形态:嵌入相似度 + softmax;输出 choice / noul / score,不生成句子
  • 厂商口径:Kanana Decision Bench 72.50;Decision Index+Vision 均值 61.23
  • 厂商口径:H200x1 平均 <0.04s,称较 GPT-6 Luna 约快 43 倍
  • 上手:transformers system_one / pipeline("decision") 或 HTTP System One
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kanana-2-v-decide-3b-2611⚡ Kanana-2-v-3b⚡ GPT-6 Luna🤖 Agent decision / tool selection🌐 Kakao

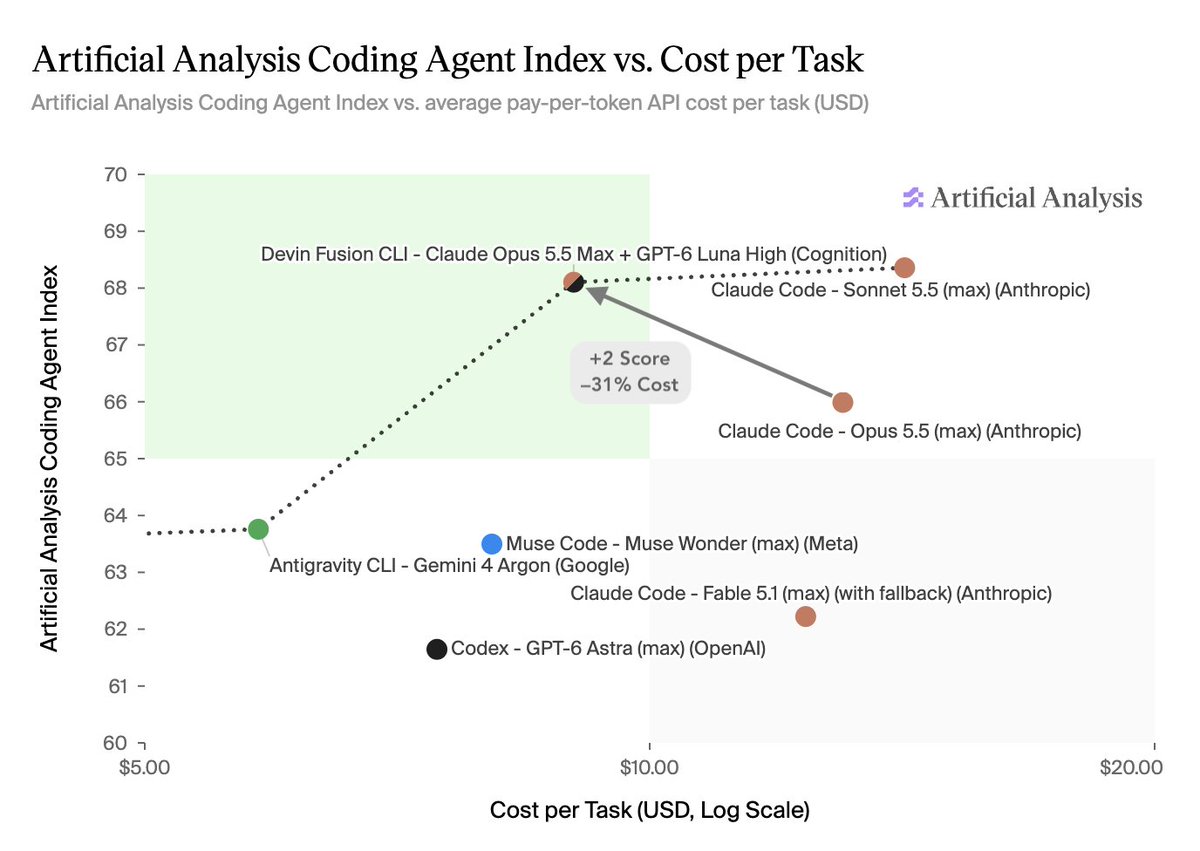
Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文
AD赞助内容

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

Inception 10 月 19 日发布 Mercury 3,称其为迄今最强的扩散式大语言模型(dLLM)。官方口径:参数规模是 Mercury 1 的 40 倍以上,输出速度 1068 token/秒,上下文从 Mercury 2.5 的 26 万扩到 100 万 token,在 GPQA Diamond、IFBench、SWE-Bench Atlas 等基准上超过 GPT-6 Luna 与 Claude Haiku 5.5(均为 medium 档)。标价每百万输入 0.20 美元、输出 0.70 美元,首发五折。已上线 Inception API、OpenRouter、Baseten 和 Vercel AI Gateway,兼容 OpenAI API。跑分均为厂商自测,暂无独立复现。

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

核心要点速览

  • 速度:输出 1068 token/秒,官方对比表中 GPT-6 Luna 约 130、Haiku 5.5 约 240(厂商口径)。
  • 跑分:GPQA Diamond 89.23、IFBench 76.84、SWE-Bench Atlas 51.08,均高于 Luna 与 Haiku 5.5;但 DeepSWE v1 46.31 低于 Haiku 5.5 的 51.62,MRCR v2 也落后 Haiku。
  • 规模与上下文:参数是 Mercury 1 的 40 倍以上,上下文 100 万 token(Mercury 2.5 为 26 万)。
  • 价格:标价输入 $0.20/M、输出 $0.70/M,首发五折为 $0.10/$0.35,缓存输入再打 1 折;新 API key 赠 1 亿 token。
  • 渠道:Inception API、OpenRouter、Baseten、Vercel AI Gateway,OpenAI API 兼容,可直接替换。
阅读全文
关联模型 / 智能体 / 厂商:

GitHub Copilot HydraFusion 更新并推出 HydraFusion Max:多模型编排池纳入 Claude Opus 5.5 与 GPT-6 系列

GitHub 于 2026-10-14 更新 Copilot 多模型编排功能 HydraFusion,并新增面向高难任务的 HydraFusion Max。模型池现包括 Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 与 GPT-6 Luna;起草阶段用 medium、审查阶段用 high 推理强度,Cascade 增加评判步骤,Critique 改为用工具直接检查工作区并引入并行评审模型。两者均为研究预览,可在 VS Code、Copilot 应用与 Copilot CLI 中使用。

核心要点速览

  • 模型池:Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna,按编排流程动态选用(GitHub Changelog)
  • 推理强度分阶段:起草 medium、审查 high,此前只用各模型默认强度
  • Cascade 新增评判步骤,仅在初稿需要时才请求修复;Critique 改为工具直查工作区 + 并行评审模型
  • 两档:HydraFusion(平衡速度/成本/性能)与 HydraFusion Max(追求最深推理,同时兼顾 token 效率)
  • 覆盖 VS Code、Copilot 应用、Copilot CLI 三端;Pro / Pro+ / Business / Enterprise 需开启实验或预览功能
阅读全文

GPT-5.5 今日退出 ChatGPT、ChatGPT Work 与 Codex:ChatGPT 登录用户需改用 gpt-6-sol / gpt-6-luna,API 不受影响

按 OpenAI 官方模型文档,GPT-5.5 自 2026-10-14 起在 ChatGPT、ChatGPT Work 与 Codex 的全部套餐下线,OpenAI API 不受影响。用 ChatGPT 登录 Codex 的 Plus、Pro、Business、Enterprise、Edu 用户应改选 gpt-6-sol,Free 与 Go 用户在桌面端改选 gpt-6-luna;复杂编码推荐 gpt-6.1-sol。写死 gpt-5.5 的 config.toml、自定义 agent、定时任务和脚本需要立即修改。

核心要点速览

  • 生效日 2026-10-14:GPT-5.5 退出 ChatGPT、ChatGPT Work、Codex 全部套餐(含 Business/Enterprise/Edu),OpenAI API 不受影响
  • 替代:Plus/Pro/Business/Enterprise/Edu 选 gpt-6-sol;Free/Go 在桌面端选 gpt-6-luna(均为“可用时”)
  • 复杂编码与 agent 工作流官方推荐 gpt-6.1-sol,官方口径接近 GPT-6 Astra、标准价为 Astra 的 1/5
  • 需检查的 4 处:config.toml 的 model、codex exec -m、自定义 agent、定时任务/脚本
  • Enterprise/Edu 中新模型默认关闭需管理员启用;GPT-5.6 Sol/Terra/Luna 在过渡期仍可用
阅读全文

OpenAI 宣布 GPT-4o、GPT-4o mini、GPT-4.1、GPT-4.1 mini 将于 2027 年 1 月 14 日下线 API,官方替代为 gpt-6-luna

OpenAI 10 月 14 日在 API 弃用页公告:GPT-4o(2024-08-06、2024-11-20 快照)、GPT-4o mini(2024-07-18)、GPT-4.1 与 GPT-4.1 mini(2025-04-14)将于 2027 年 1 月 14 日从 API 移除,基于这些模型的微调版本同日停用,官方推荐统一迁移到 gpt-6-luna。按官方标准价,gpt-6-luna 为输入 $0.10、输出 $0.50/百万 token,远低于 GPT-4o 的 $2.50/$10。

OpenAI 宣布 GPT-4o、GPT-4o mini、GPT-4.1、GPT-4.1 mini 将于 2027 年 1 月 14 日下线 API,官方替代为 gpt-6-luna

核心要点速览

  • 下线日期:2027 年 1 月 14 日,距公告约 3 个月;涉及 5 个快照:gpt-4o-2024-08-06、gpt-4o-2024-11-20、gpt-4o-mini-2024-07-18、gpt-4.1-2025-04-14、gpt-4.1-mini-2025-04-14(官方弃用页)
  • 微调模型同步停用:基于上述底座的 fine-tune 与底座同日下线,且现有客户 2027 年 1 月 6 日起已无法新建微调任务
  • 价格对比(官方标准价,每百万 token 输入/输出):gpt-6-luna $0.10/$0.50;GPT-4o $2.50/$10;GPT-4.1 $2.00/$8.00;GPT-4.1 mini $0.40/$1.60;GPT-4o mini $0.15/$0.60(定价页)
  • 可编程监控:调用 GET /v1/models 读取每个模型的 shutdown_date 字段即可在 CI 里提前报警
  • 这是 10 月第二批弃用:10 月 23 日已有 gpt-4o-2024-05-13、o4-mini 等旧快照下线,4 月 1 日还将下线 gpt-5.3-codex 与 gpt-5.1
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI API 10 月 23 日批量下线 12 个旧模型:o4-mini、o3-mini、gpt-4o-2024-05-13、gpt-image-1 在列,迁移窗口仅剩 12 天

OpenAI 官方 Deprecations 页面显示,4 月 22 日宣布弃用的一批旧快照将于 2026 年 10 月 23 日在 API 中停止服务,涉及 gpt-3.5-turbo-0125、gpt-4-0613、gpt-4-turbo、gpt-4.1-nano、gpt-4o-2024-05-13、gpt-image-1、o1、o1-pro、o3-mini、o4-mini 等 12 个快照及其别名,另有 5 类微调模型同日下线。官方替代为 gpt-5.6-sol / terra / luna 与 gpt-image-2.5。社区 #keep4o 呼吁保留 GPT-4o 快照的讨论今日再度升温。

核心要点速览

  • 12 个快照 + 别名同日下线:o4-mini、o3-mini、o1、o1-pro、gpt-4-turbo、gpt-4、gpt-3.5-turbo 等别名也会一起失效(官方 Deprecations)
  • 停服日 2026-10-23,距今 12 天;4 月 22 日公告,满足官方 GA 模型「至少 6 个月」通知期
  • 替代映射:o4-mini / gpt-3.5 → gpt-5.6-terra;gpt-4 系 / o1 / o3-mini / gpt-4o-2024-05-13 → gpt-5.6-sol;o1-pro → gpt-5.6-sol(reasoning.mode: pro);gpt-4.1-nano → gpt-5.6-luna
  • gpt-image-1 改用 gpt-image-2.5-sunburst 或 -flare;ft-gpt-4、ft-gpt-3.5-turbo、ft-o4-mini 等 5 类微调模型同日下线,需在新基座重训
  • 下一批:12 月 1 日 gpt-image-1.5 / 1-mini,12 月 11 日 gpt-5 首代快照与 o3 / o3-pro
阅读全文
关联模型 / 智能体 / 厂商:

Pine Computer 发布“给 AI 用的云电脑”:事件推送替代截图轮询,GPT-5.6 Luna 在 SaaS-Bench v1.1 检查点得分 78.3% 超过 Opus 5 + Claude Code,单任务模型成本约 $1.02

Pine AI 于 10 月 9 日发布 Pine Computer 私测版:一套面向 AI 的云端虚拟电脑 + Harness + 运行时,应用通过 API 提交任务,系统跨浏览器、文件和 Shell 执行。核心机制是让操作系统、浏览器和应用主动把“发生了什么变化”推给模型(类似 epoll),而不是反复截图。官方公布 SaaS-Bench v1.1(106 个任务、23 个应用)上 GPT-5.6 Luna 检查点得分 78.3%,高于 Opus 5 + Claude Code 的 74.3%,但完整解决率 27.4% 低于后者的 31.1%。

Pine Computer 发布“给 AI 用的云电脑”:事件推送替代截图轮询,GPT-5.6 Luna 在 SaaS-Bench v1.1 检查点得分 78.3% 超过 Opus 5 + Claude Code,单任务模型成本约 $1.02

核心要点速览

  • SaaS-Bench v1.1 检查点得分:Pine + GPT-5.6 Luna 78.3% vs Opus 5 + Claude Code 74.3% vs GPT-5.6 Sol + Codex 71.1%
  • 完整解决率反而落后:27.4% vs 31.1%(Claude Code)/ 29.2%(Codex)
  • 单任务模型 Token 成本:约 $1.02 vs $26.50(Opus 5 + Claude Code)/ $20.50(GPT-5.6 Sol + Codex),不含基础设施费
  • 新电脑启动 数秒,大量状态恢复约 15 秒,暂停后恢复 <1 秒
  • 官方帖约 9.98 万次曝光、250+ 赞、120 转发;目前仅私测,可加入等候名单
阅读全文
AD赞助内容

GPT-6 全量登陆 ChatGPT 并上线 Intelligent UI:回答变成可交互图表与小工具,付费用 Sol、免费用 Luna

OpenAI 于 10 月 7 日宣布 GPT-6 在 ChatGPT 全球推送,并同步上线 Intelligent UI:模型会自行判断何时用图示、交互图表、表单、可点按钮或内嵌小工具(计算器、小游戏、分账器)代替纯文本作答。Plus/Pro/Business/Enterprise 当天可用(GPT-6 Sol),Go 与免费用户 10 月 8 日跟进(GPT-6 Luna)。OpenAI 称 GPT-6 可边思考边先给出部分答案,等待时间缩短 44%。

核心要点速览

  • 分层:Plus / Pro / Business / Enterprise 10 月 7 日起用 GPT-6 Sol;Go 与免费档 10 月 8 日起用更高效的 GPT-6 Luna(OpenAI 官方发布)
  • 边想边答:思考过程中先返回部分答案,OpenAI 称等待时间缩短 44%,内部测试中困难网页搜索表现优于 GPT-5.6(The Decoder)
  • Intelligent UI 输出:图示、交互图表、可编辑图、表单、可点按钮,以及按需生成的内嵌工具(储蓄计算器、复古小游戏、分账器);视觉密度可在个性化设置里调低(TechCrunch)
  • 安全:OpenAI 表示 GPT-6 对绕过安全训练的攻击抵抗力更强(The Verge)
  • 竞品对照:Google 已在 5 月为 Gemini 推出类似的生成式界面功能,ChatGPT 这次把它做成面向全部用户的默认能力
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI Decisions API 开启公测:gpt-6-luna 驱动的 /v1/decisions 返回判定/选择/打分三类类型化答案,速度约为 Responses API 的 10 倍,仅按输入 $0.10/百万 token 计费

OpenAI API 更新日志显示,2026-10-06 Decisions API 以 gpt-6-luna 进入公测:独立端点 POST /v1/decisions 接收文本/图片与一组问题,返回带概率的 predicate、choice、score 三种类型化答案,官方称比 Responses API 快约 10 倍;只收输入费 $0.10/1M token,无输出与缓存费,支持 ZDR 与 HIPAA,预计数周内 GA。

OpenAI Decisions API 开启公测:gpt-6-luna 驱动的 /v1/decisions 返回判定/选择/打分三类类型化答案,速度约为 Responses API 的 10 倍,仅按输入 $0.10/百万 token 计费

核心要点速览

  • 速度:官方称返回类型化答案比 Responses API 快约 10 倍(Decisions 指南)
  • 价格:仅收输入 $0.10/1M token,无输出、缓存读/写费用;同模型走常规接口为输入 $0.10、输出 $0.50/1M
  • 3 种问题类型:predicate 返回 0–1 概率;choice 返回选项 + probabilities + confidence;score 返回有序等级的概率加权分
  • 合规:支持 ZDR 与 HIPAA,数据驻留覆盖美国与欧洲(EEA + 瑞士),预计数周内 GA
  • 限制:目前仅 gpt-6-luna;图片必须内联 base64,不支持 HTTPS 图片 URL 与 file_id
阅读全文
关联模型 / 智能体 / 厂商:

进化代码搜索降本 97%!斯坦福与新国大开源 FrugalEvo:强弱双模型协同配前缀缓存,仅花 $0.55 击败 $50 智能体群

类似于 AlphaEvolve 的 LLM 引导程序进化算法(Program Evolution)在算法优化与硬核运筹求解(如圆盘打包 Circle Packing、张量算子加速)中展现出强悍探索力。然而现有进化框架往往不计成本地以固定迭代轮次为目标,极度依赖昂贵的前沿旗舰模型,单个复杂问题的求解往往消耗数十至上百美元。来自新加坡国立大学、斯坦福大学与香港科技大学的研究团队提出了业界首个成本感知(Cost-Aware)的程序进化框架 FrugalEvo(arXiv:2610.03675):彻底摒弃单纯追求无上限迭代的做法,转而追求“单位 Token 成本的收益最大化”。FrugalEvo 采用非对称双模型分工架构——由高智力昂贵模型负责探索高维解题策略,由廉价极速模型负责具体代码实现与局部迭代微调;同时精心设计缓存友好型进化管线,最大化复用跨进化步的前缀 KV 缓存。团队还提出了针对预算感知的新评测指标 BA-AUC。在 10 项数理与系统优化任务及 ALE-Bench-Lite 上,FrugalEvo 全面超越 OpenEvolve、AdaEvolve 和 EvoX;在圆盘打包测试中,使用 GPT-5.6 Terra/Luna 仅花费 1.68 美元,使用 GLM-5.3/Flash 甚至仅花费 0.55 美元,便彻底战胜了平均花费 50 美元的多智能体系统(如 CORAL、SwarmResearch),成本骤降 97%~99%。

进化代码搜索降本 97%!斯坦福与新国大开源 FrugalEvo:强弱双模型协同配前缀缓存,仅花 $0.55 击败 $50 智能体群

核心要点速览

  • 提出业界首个成本感知(Cost-Aware)程序进化框架 FrugalEvo,打破传统代码进化算法不计成本的迭代盲区
  • 首创非对称强弱双模型协同分工与前缀 KV 缓存最大化复用,建立新标杆评测指标 BA-AUC
  • 在经典圆盘打包任务中仅花费 $0.55~$1.68 达成 SOTA,战胜平均花费 $50 的多智能体系统,成本暴降 97%~99%
阅读全文

Zed 1.21.0:Agent Panel BYOK 接通 Claude Opus 5.5 与 GPT-6 Astra/Sol/Luna,默认防休眠跑长程 Agent

Zed Industries 于 2026-09-23 发布编辑器 Zed v1.21.0。AI 侧:Agent Panel 支持用自有 Anthropic/OpenAI Key 的 BYOK——Claude Opus 5.5,以及 GPT-6 Astra / Sol / Luna;SuperGrok 订阅可直接登录使用 Grok;新增 DeepSeek Flash 4.1 与 Mistral 通道下的 Z.ai GLM;默认开启 agent.prevent_idle_sleep,长程 Agent 回合时阻止系统空闲休眠。另有语言服务器命令选择器、showDocument 打开文件/URL、语法高亮与 Markdown 代码块渲染加速,以及 ACP 兼容与异步任务唤醒改进。适合已把日常编辑放在 Zed、又要在面板里直接跑前沿模型的开发者。

Zed 1.21.0:Agent Panel BYOK 接通 Claude Opus 5.5 与 GPT-6 Astra/Sol/Luna,默认防休眠跑长程 Agent

核心要点速览

阅读全文

Vercel AI SDK @ai-sdk/openai 4.0.78:GPT-6 Sol/Luna 支持 reasoningEffortUpdate 设为 none

Vercel AI SDK 于 2026-09-26 发布 @ai-sdk/[email protected]:请求级与(经 system message 定位的)消息级 reasoningEffortUpdate 现允许 'none',以便在 GPT-6 Sol/Luna 对话中途关闭推理;更新值会对照模型支持的 effort 集合校验——不支持的请求级更新告警并省略,不支持的历史/消息级更新则拒绝。同批 @ai-sdk/[email protected] 与 @ai-sdk/[email protected] 跟随依赖升级。

Vercel AI SDK @ai-sdk/openai 4.0.78:GPT-6 Sol/Luna 支持 reasoningEffortUpdate 设为 none

核心要点速览

阅读全文