AI 编程实时动态与要闻

Hyperstition 开源 Hyperkernel:递归 megakernel 生成器,厂商口径 DeepSeek v4.1 Flash 低延迟推理多项超 NVIDIA 公布 vLLM

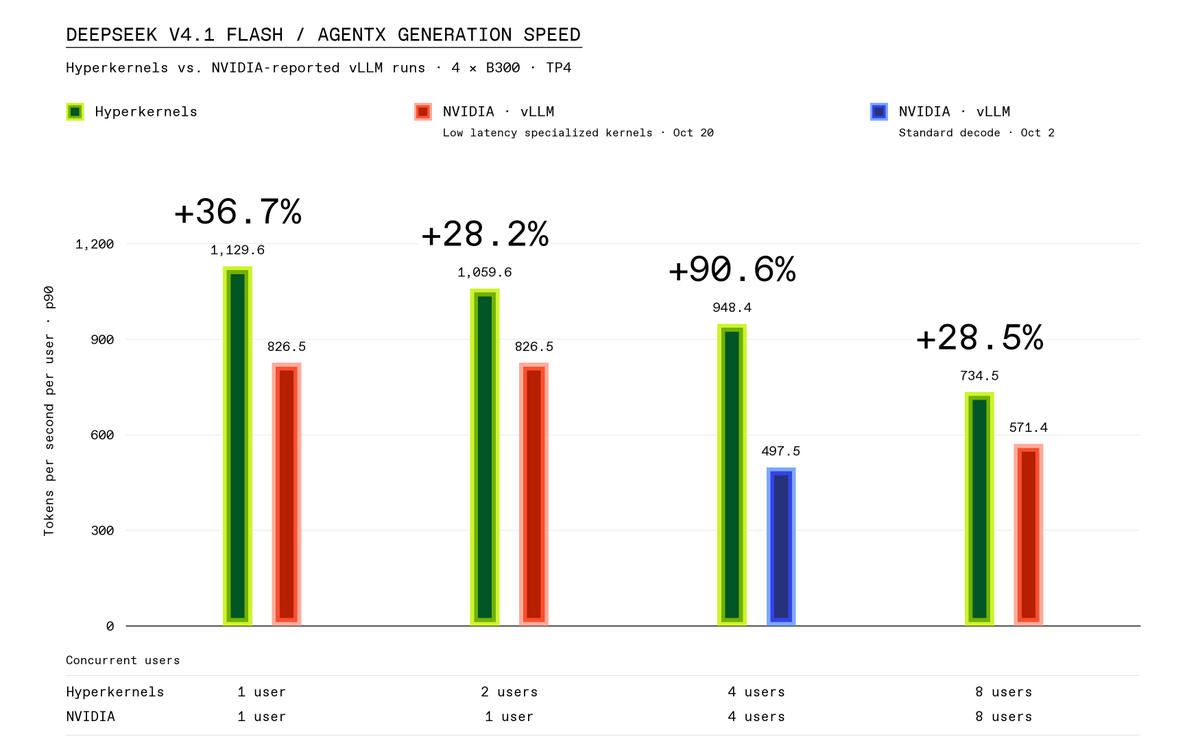
2026-11-05,Hyperstition 开源 Hyperkernel 首批生成 megakernel(Hyperserve):单次 launch 覆盖推理到机器人等场景;官方对照 NVIDIA 公布 vLLM 等给出多项加速,仓库 Alpha、面向 B300。
Hyperstition 开源 Hyperkernel:递归 megakernel 生成器,厂商口径 DeepSeek v4.1 Flash 低延迟推理多项超 NVIDIA 公布 vLLM

核心要点速览

  • 官方:@hyperstition_cc 2026-11-05;GitHub Hyperstitioncc/Hyperkernel(MIT,Alpha)
  • 厂商口径:DeepSeek v4.1 Flash C1 人均生成速度较 NVIDIA 公布 vLLM 高约 36.7%;C4 相对 AgentX 高约 90.6%
  • π₀-FAST 约 94 ms vs 约 243 ms;Matrix-Game 约 37.4 vs 11.6 FPS(约 3.2×)
  • CLI:hyperserve llm|drive|dna|world;需自备权重与 B300/R580+
  • 非独立第三方复测;完整栈与 Kimi/GLM serving 计划数周内开源
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

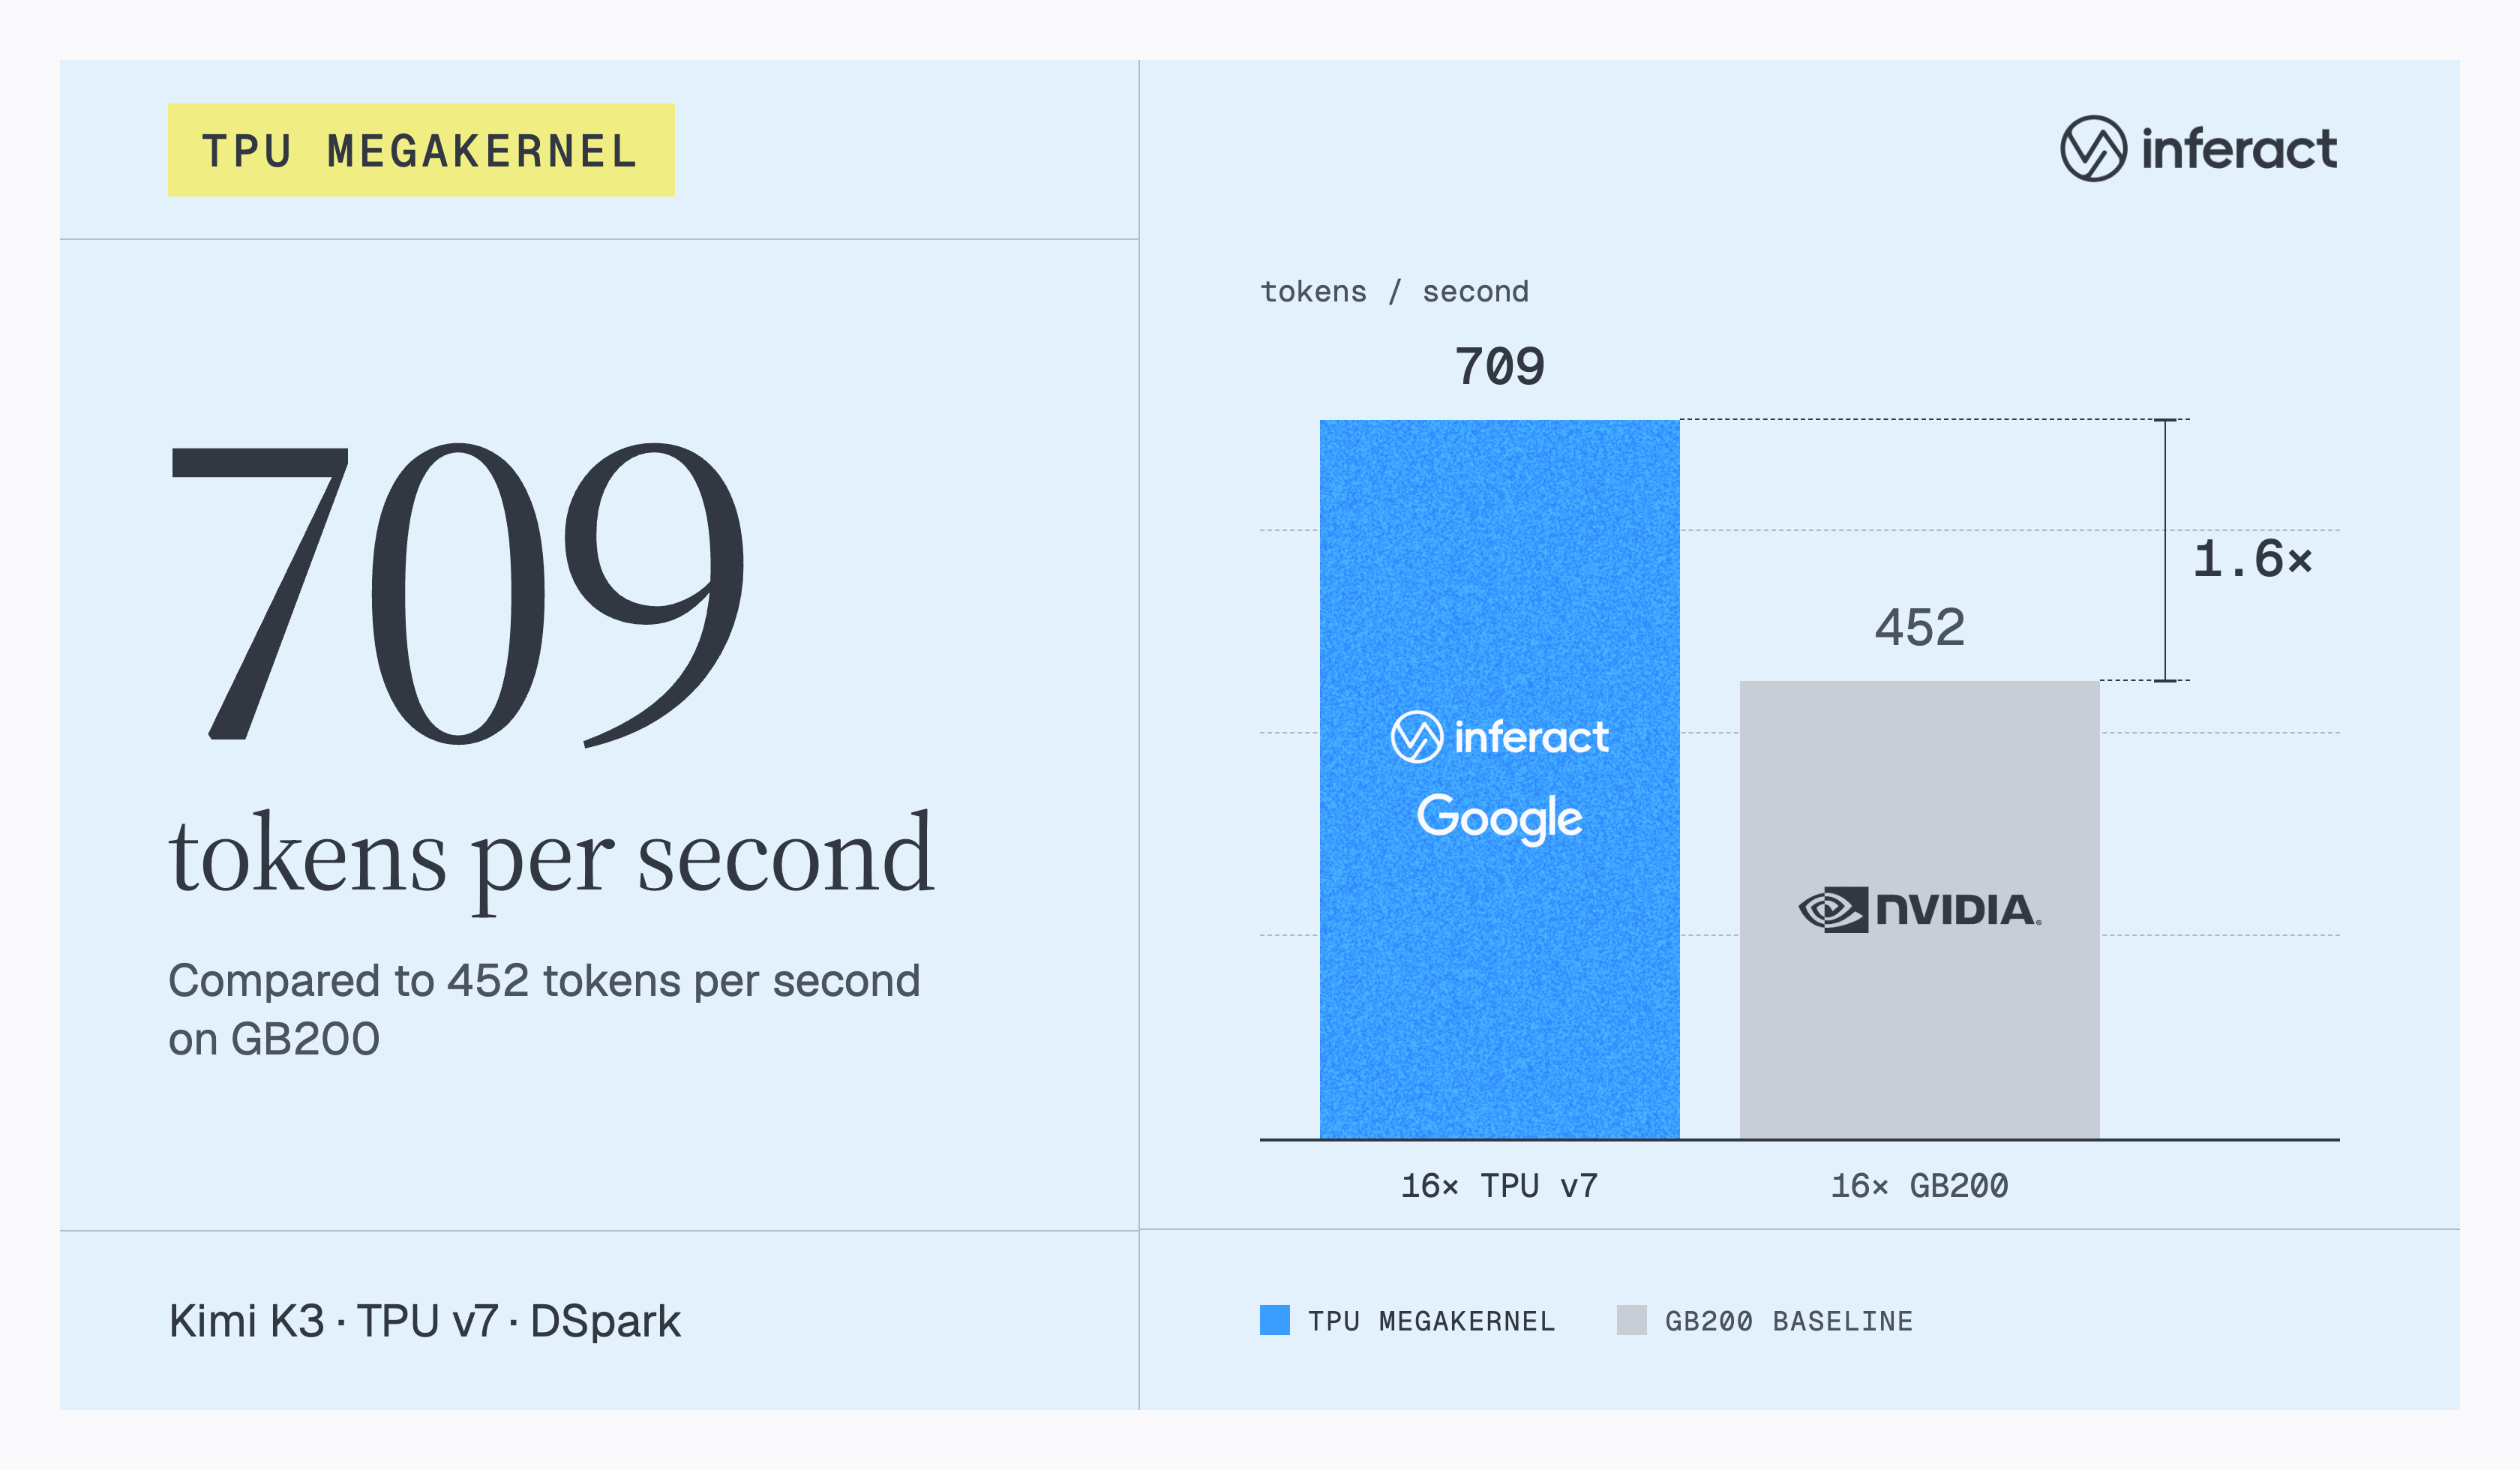
Inferact(vLLM 核心团队衍生公司)于 2026-09-23 发布并开源面向 TPU v7 的推理巨内核仓库 inferact/tpu-megakernels。官方博客显示,在 DSpark 推测解码(acceptance length=6)的低并发设定下,Kimi K3 在 16×TPU v7 Ironwood 上达到 709 tok/s,对照 16×GB200 基线 452 tok/s;关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×。整套 Kimi K3 的 92 层 MoE 解码被收敛进单一 Pallas 内核。

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

核心要点速览

  • 官方数字(Inferact 自测,非第三方复现):Kimi K3 + DSpark 在 16×TPU v7 上 709 tok/s,对照 16×GB200 452 tok/s(acceptance length=6)
  • 关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×;Qwen 3.8 27B 在 4×TPU v7 上报 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)
  • 架构要点:92 层 MoE 装进 单一 Pallas 巨核,跨层 weight prefetch,吃满 TPU 大容量 VMEM
  • 开源仓库:Inferact/tpu-megakernels(Apache-2.0),配套深度文:700 TPS on Kimi K3
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容