
2026-11-05,Hyperstition 开源 Hyperkernel 首批生成 megakernel(Hyperserve):单次 launch 覆盖推理到机器人等场景;官方对照 NVIDIA 公布 vLLM 等给出多项加速,仓库 Alpha、面向 B300。
核心要点速览
- ✓官方:@hyperstition_cc 2026-11-05;GitHub Hyperstitioncc/Hyperkernel(MIT,Alpha)
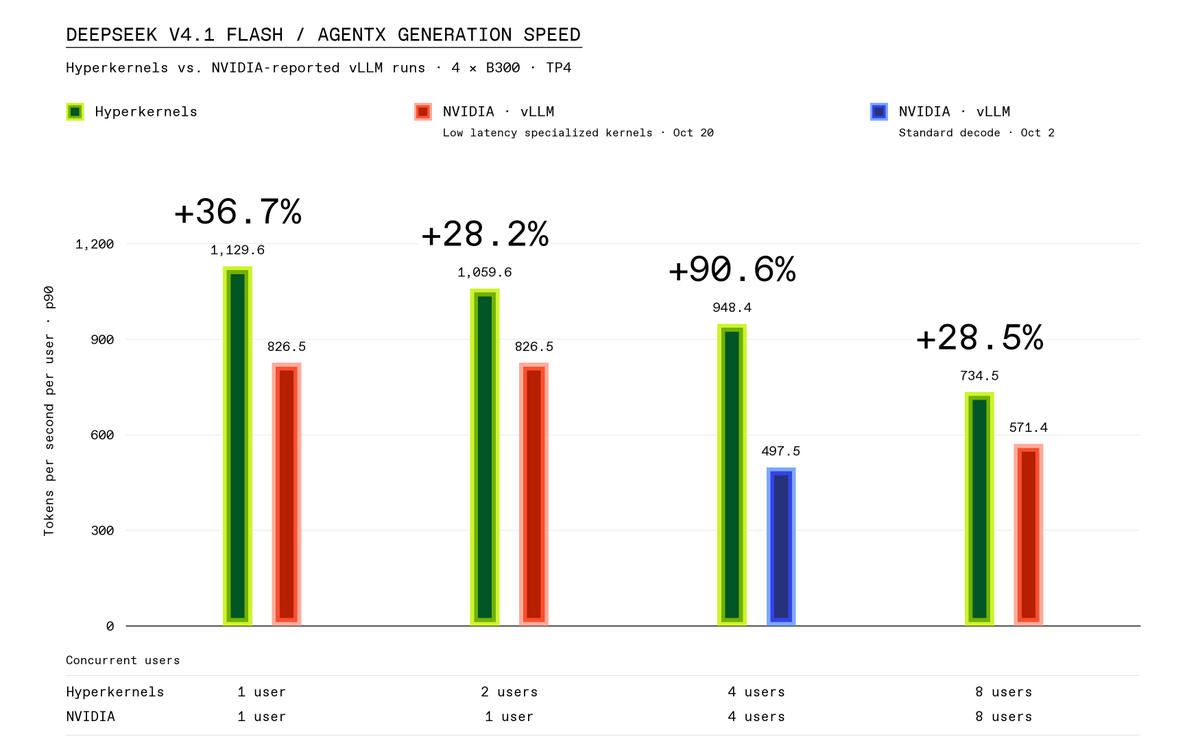
- ✓厂商口径:DeepSeek v4.1 Flash C1 人均生成速度较 NVIDIA 公布 vLLM 高约 36.7%;C4 相对 AgentX 高约 90.6%
- ✓π₀-FAST 约 94 ms vs 约 243 ms;Matrix-Game 约 37.4 vs 11.6 FPS(约 3.2×)
- ✓CLI:hyperserve llm|drive|dna|world;需自备权重与 B300/R580+
- ✓非独立第三方复测;完整栈与 Kimi/GLM serving 计划数周内开源
开发者 3 秒速决决策指标
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
非常规 GPU 负载常被多 kernel 启动与主机同步拖慢。Hyperstition 于 2026-11-05 开源 Hyperkernel:约 20 天自研的递归 megakernel 生成器,首批公开生成好的 megakernel(Hyperserve)。
架构亮点与底层机制
官方称单次 kernel launch 覆盖整段前向;机器人/基因组/语音等可在约 50 分钟内生成。CLI:hyperserve <llm|drive|dna|world>,面向 NVIDIA B300,需 Rust 与 R580+,权重自备。MIT,仓库 Alpha。
权威 Benchmark 与实测跑分对比
均为厂商口径、对照其引用的 NVIDIA 公布 vLLM 等:DeepSeek v4.1 Flash C1 人均生成速度高约 36.7%,C4 相对 AgentX 高约 90.6%;π₀-FAST 约 94 ms vs 约 243 ms;Matrix-Game 约 37.4 vs 11.6 FPS。非独立复测。
开发者实战落地与开箱指南
github.com/Hyperstitioncc/Hyperkernel。cargo build --release 后按 README 运行。注意 Alpha、绑 B300、无内置权重;完整栈与 Kimi/GLM serving 计划数周内开源。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察