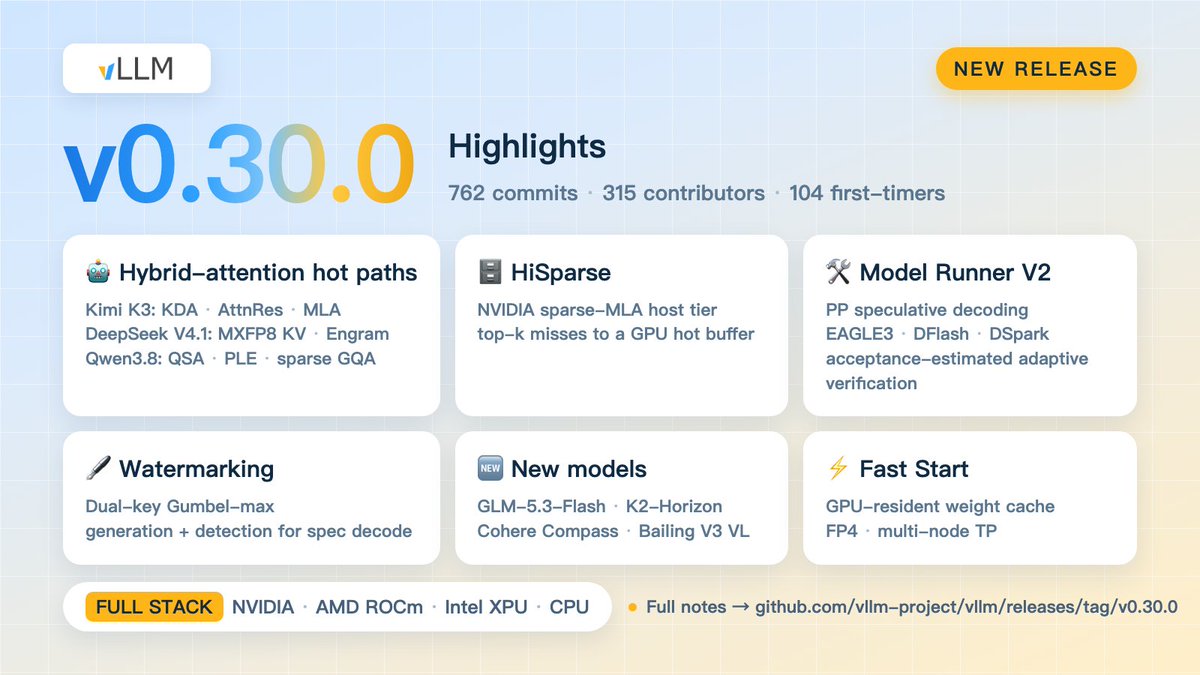
vLLM v0.32.0 发布:814 次提交,内置 /v1/systemone 结构化决策接口,NVFP4 低精度 KV 覆盖更多 GPU,多 API worker 短请求吞吐提升 43–85%
vLLM 于 10 月 18 日发布 v0.32.0,363 位贡献者(121 位新人)提交 814 次。重点包括默认提供的 POST /v1/systemone 结构化决策接口与通用 hf 工具/推理解析器;NVFP4 KV 缓存扩展到 SM8x/SM90/SM12x,GLM-5.x 在 SM100 默认 FP8 KV;Model Runner V2 新增 GPU n-gram 投机与 Elastic EP,并成为 ROCm 默认;修复 3 个安全公告并收紧 CORS 默认值,同时放弃 Python 3.10。

核心要点速览
- 规模:814 次提交、363 位贡献者(121 位新人),见 Release 说明。
- 结构化决策:新增并默认开启
POST /v1/systemone,回答 choice/score 类问题,已支持Cloudflare/clef-omni、LiquidAI/d1-3B等模型;--tool-call-parser hf读取权重自带的 response_template,免写专用解析器。 - 低精度 KV:GLM-5.x 在 SM100 默认 FP8 KV,每卡 KV 显存减半、吞吐 +2.3–5.5%,代价是 TTFT 增加 7–11%(PR 内基准,官方口径);ROCm 新增 4-bit KV,密度约为 FP8 的 2 倍。
- 服务提速:
--api-server-count大于 1 时按最少负载分配连接,短请求 req/s 提升 43–85%(Qwen3-0.6B、32 输入/1 输出 token 的 PR 基准)。 - 破坏性变更:移除 Python 3.10 支持、CORS 默认不再放行所有来源、移除 cascade attention,
max_tokens不再从上下文窗口预留。
关联模型 / 智能体 / 厂商: