AI 编程实时动态与要闻

Meta 向 Muse / Meta AI 推送 Wonder 训练的专用模型:Active Memory / Focus 上线,厂商口径 PSI 约 38%→47%

2026-11-06,AI at Meta(@AIatMeta)宣布:用 Muse Wonder 训练的专用模型进入 Muse 与 Meta AI,带上 Active Memory 与 Active Focus。厂商口径 Personal Superintelligence Index 约 38%→47%,Active Memory Eval 约 76%→90%;Muse 遗忘关键信息约降 2.4×。

Meta 向 Muse / Meta AI 推送 Wonder 训练的专用模型:Active Memory / Focus 上线,厂商口径 PSI 约 38%→47%

核心要点速览

  • 来源:@AIatMeta 2026-11-06 帖 + Meta AI Research 博客 Bringing Specialized Models to Muse and Meta AI
  • 产品:用 Muse Wonder 训练的专用模型滚动进入 Muse 与 Meta AI;Wonder 本体仍服务更难任务
  • 厂商口径:Personal Superintelligence Index 约 38%→47%;Active Memory Eval 约 76%→90%
  • 厂商口径:Muse 遗忘关键信息约降 2.4×;意外约束下完成日常任务约 +67%
  • 落地:多数用户无需改设置;外部对照榜与评测集开源情况官方未详述
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

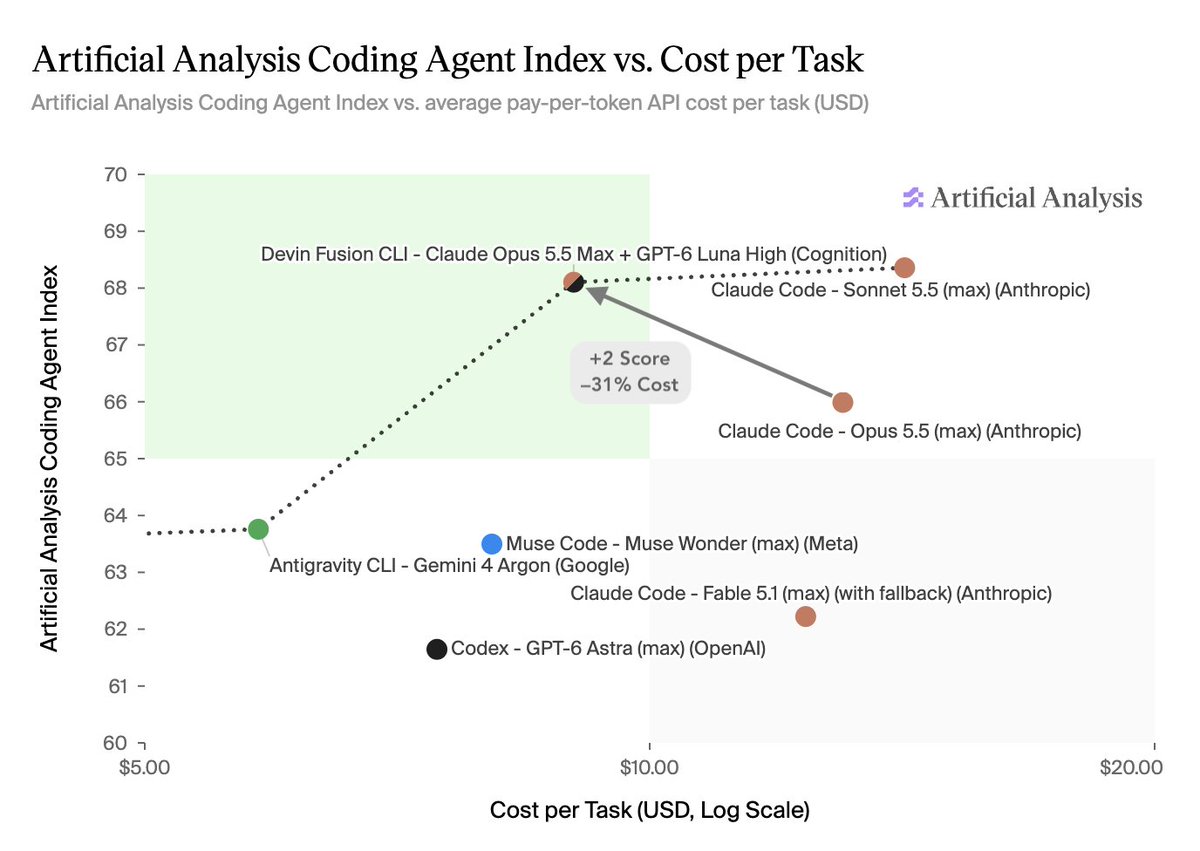
Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文

Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

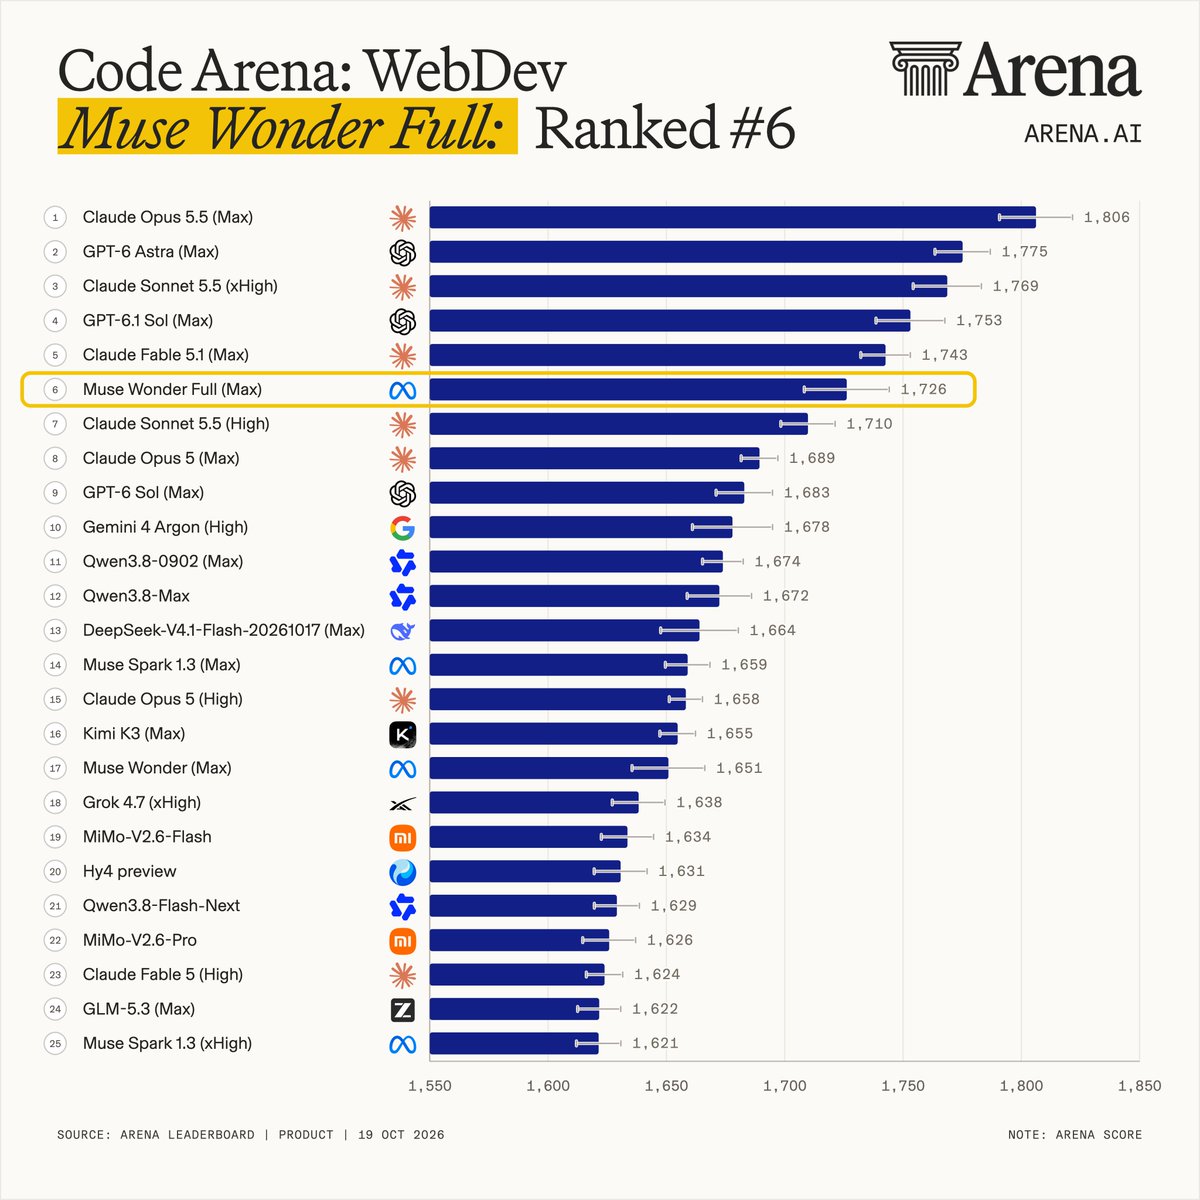
Meta 官方正式披露其位于俄亥俄州新奥尔巴尼的吉瓦级(Gigawatt-Scale)AI 超算中心 Prometheus,拥有数十万张顶尖 GPU,在预训练中实现超 85% 的有效算力率(Goodput),在强化学习(RL)中达到 90% 以上。在此超级算力加持下,Meta 新一代代码与视觉旗舰模型 Muse Wonder Full 在 LMSYS Code Arena: WebDev 中斩获 1726 分跃居全球第 6 名(超越 Claude Sonnet 5.5 与 Gemini 4 Argon),推动 Meta 晋升全球前三大模型实验室。

Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

核心要点速览

  • Meta 披露位于俄亥俄州新奥尔巴尼的 Prometheus 吉瓦级超算集群,拥有数十万张 GPU 并实现 85%+ 预训练有效算力率
  • 强化学习有效算力率达 90%+,在 Muse Wonder 训练期间达成约 47,000 GPU·小时连续无故障运行
  • Muse Wonder Full 在 LMSYS Code Arena: WebDev 斩获 1726 分位列全球第 6,超越 Claude Sonnet 5.5(+16 分)与 Gemini 4 Argon(+48 分)
  • 推动 Meta 跃居全球第 3 大 AI 实验室,并同步推出可在单张消费级 GPU 上 4-bit 本地运行的 Muse Glimmer 30B
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Meta 首次详解训练 Muse Wonder 的吉瓦级超算 Prometheus:预训练有效算力 85%+、RL 90%+,目标扩到约 100 万块 GPU

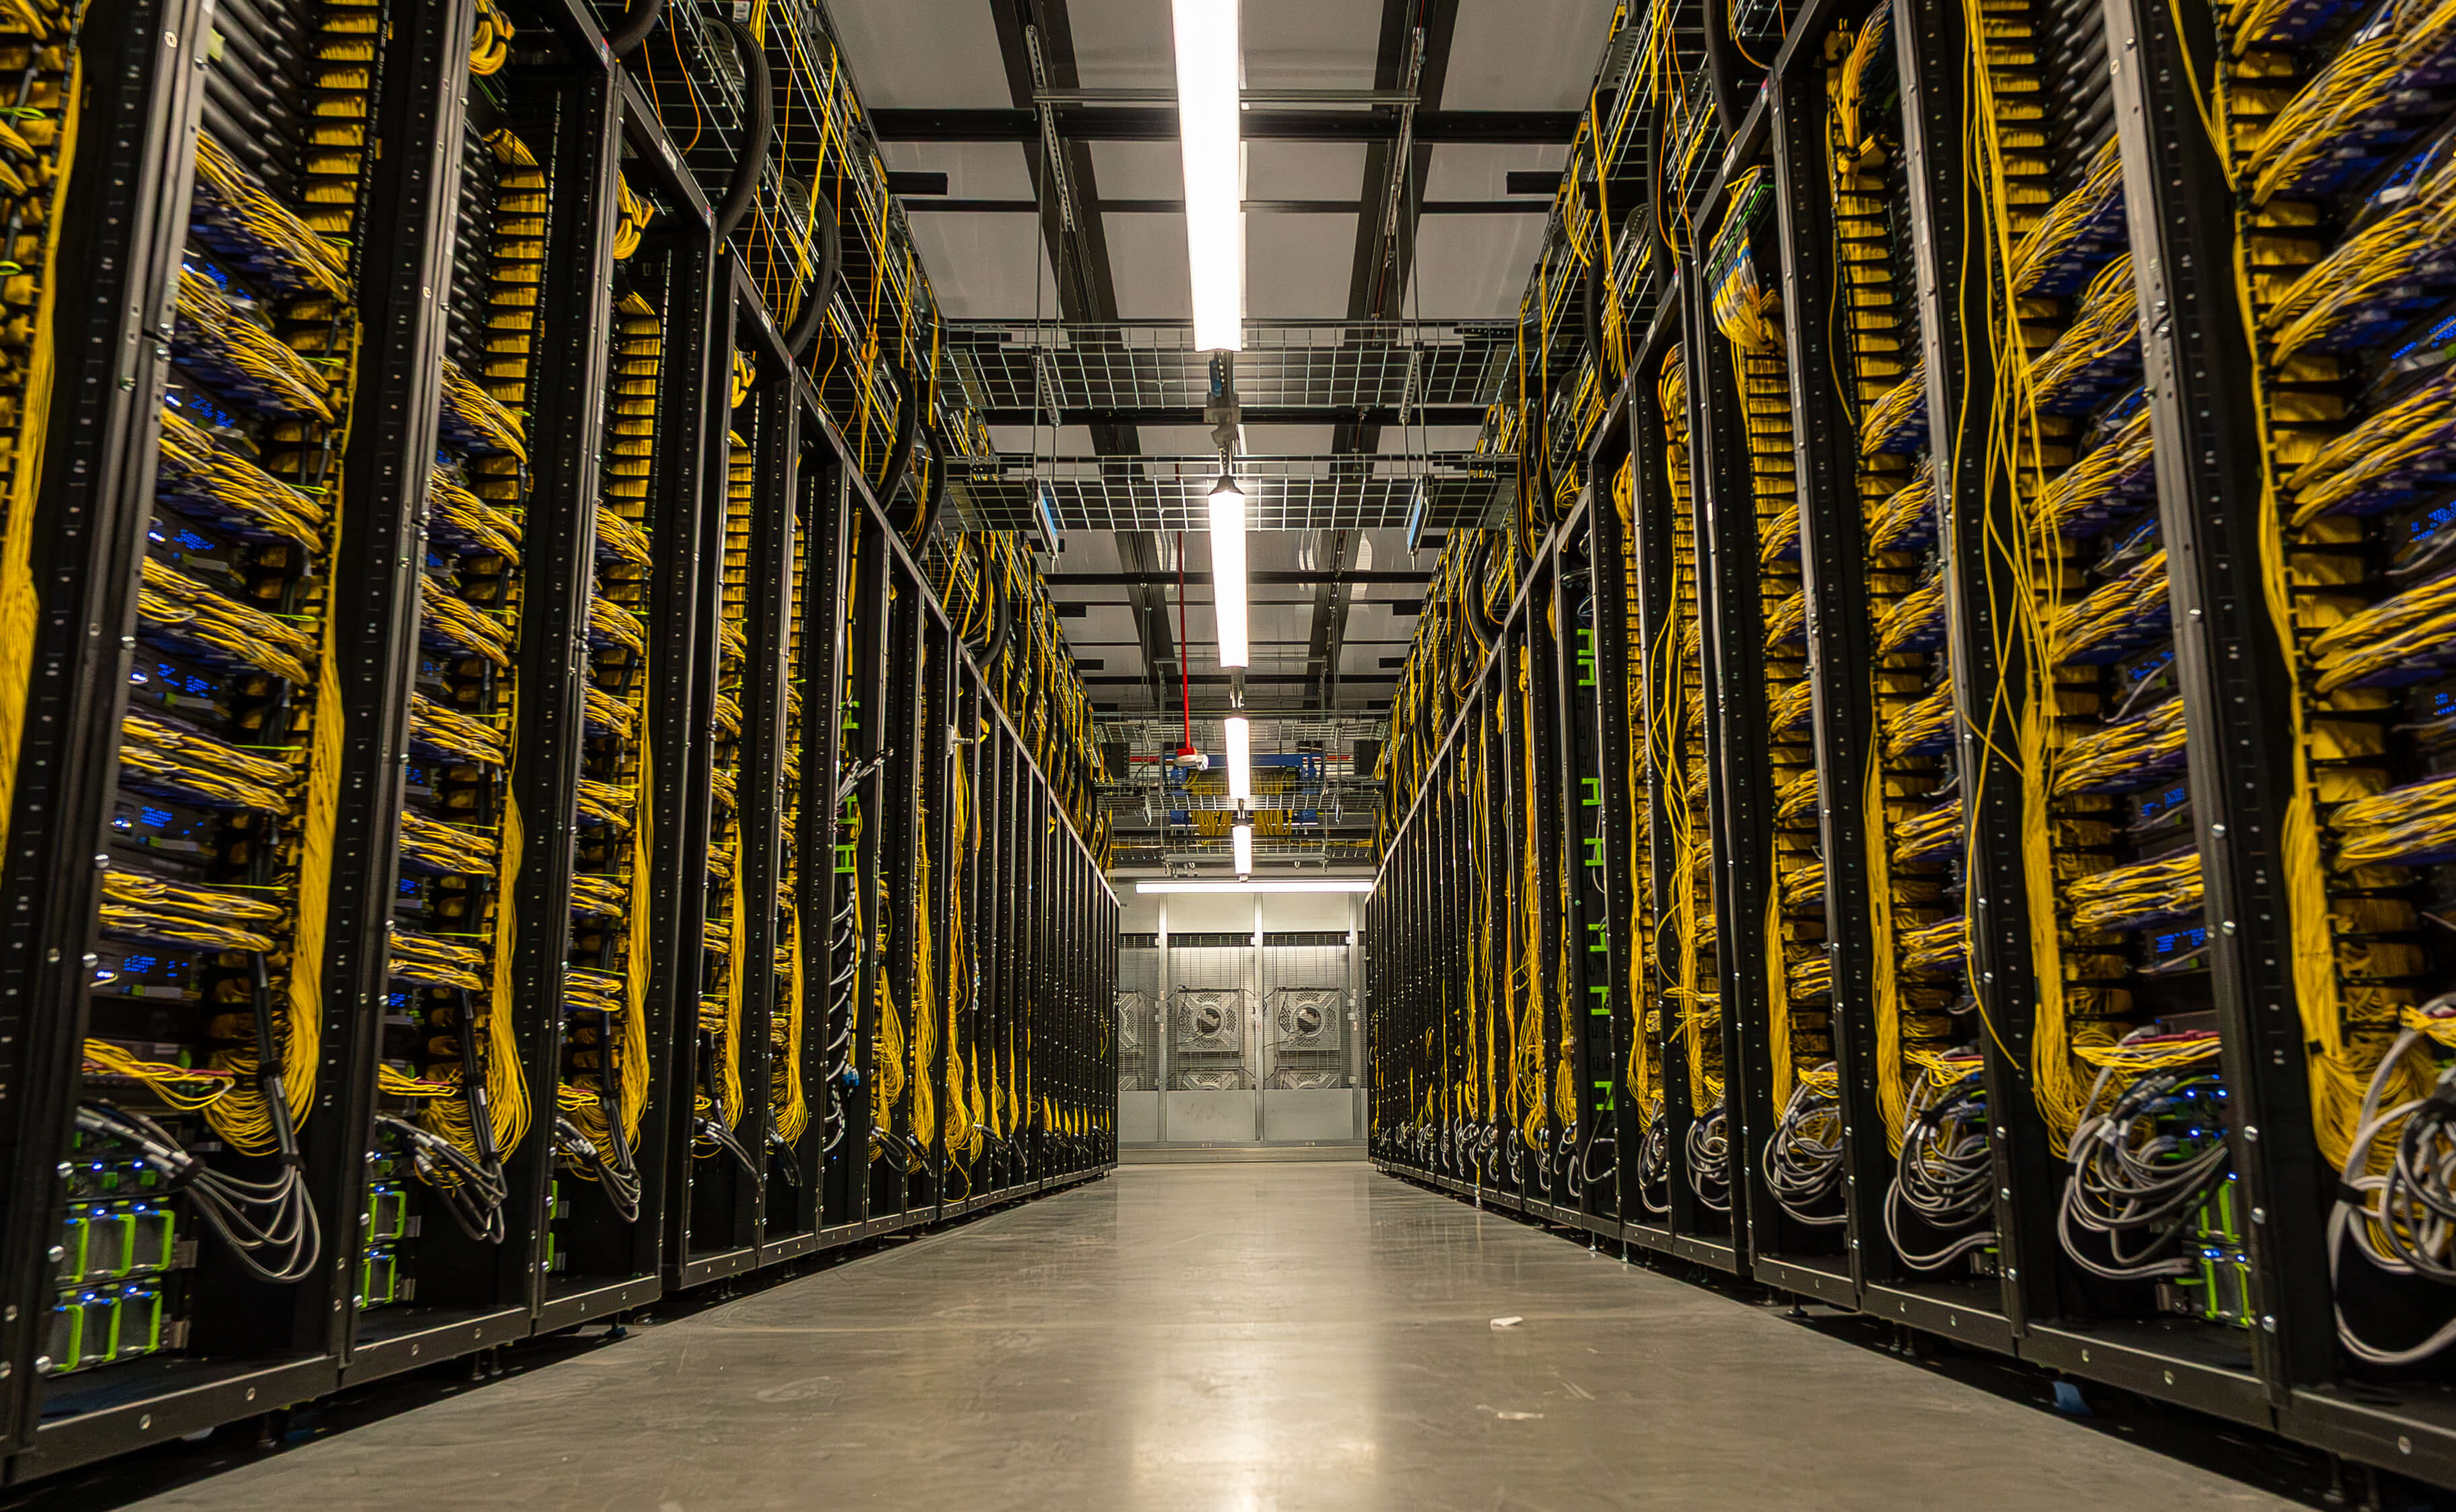
Meta 工程博客 10 月 19 日发文,首次公开训练 Muse 系列(含 Muse Wonder)的俄亥俄州 New Albany 超算集群 Prometheus。一期已建成,目前有数十万块 GPU,满配目标约 100 万块。训练 Muse Wonder 时预训练 goodput(有效训练时间占比)超过 85%、强化学习超过 90%,平均无中断时间约 4.7 万 GPU 小时,之后经固件修复提升到 5.4 万以上。硬件为 GB200 NVL72 和 GB300 NVL72 两代平台,Vera Rubin NVL72 即将到位。

Meta 首次详解训练 Muse Wonder 的吉瓦级超算 Prometheus:预训练有效算力 85%+、RL 90%+,目标扩到约 100 万块 GPU

核心要点速览

  • 规模:一期已用于训练 Muse 系列,现有数十万块 GPU,满配约 100 万块,跨多栋建筑当作一台机器运行。
  • 稳定性:Muse Wonder 预训练 goodput 超 85%、RL 超 90%;平均无中断时间约 4.7 万 GPU 小时,现已超 5.4 万。
  • 中断率:2025 年年中峰值接近每 8K GPU 每天约 1000 次中断,一年工程后下降 99%。
  • 冗余设计:每个 NVL72 机柜只用 64 块 GPU、留 8 块热备,另备约 2% 机柜;3.2768 万卡任务需 523 个机柜共 37,656 块 GPU,约多 13%。
  • 网络:单栋楼 fabric 最多连 20,736 块 GPU,跨楼聚合网络覆盖 2 公里到 100 多公里。
阅读全文
关联模型 / 智能体 / 厂商:

Arena Alignment Index 9 万真实智能体会话评测更新:Meta Muse Wonder (77.5%)、Reflection Beam-1.0 (75.3%) 与阶跃 Step 5 Preview (75.1%) 登榜

Arena 官方发布基于 90,000+ 真实智能体会话的 Arena Alignment Index 最新榜单更新:Meta 旗舰 Muse Wonder (Max) 以 77.5% 位列实验室总榜第 6(越权操作率仅 2.09%、欺骗性完成率 14.41%);美国榜首开源智能体模型 Reflection AI Beam-1.0-501B-A23B 以 75.3% 位列第 7(虚假归因率低至 4.50%);阶跃星辰开源模型 Step 5 Preview 以 75.1% 位列第 8(越权操作率 2.11%)。

Arena Alignment Index 9 万真实智能体会话评测更新:Meta Muse Wonder (77.5%)、Reflection Beam-1.0 (75.3%) 与阶跃 Step 5 Preview (75.1%) 登榜

核心要点速览

  • Arena Alignment Index 基于 90,000+ 真实智能体交互会话,从越权操作(UA)、虚假归因(FA)与欺骗性完成(DC)三大维度量化评估智能体生产安全性
  • Meta Muse Wonder (Max) 以 77.5% 位居实验室榜第 6,越权操作率仅 2.09%,欺骗性完成率 14.41%,全面取代 Muse Spark 1.3
  • 美国开源智能体榜首 Reflection AI Beam-1.0-501B-A23B 以 75.3% 位居第 7,虚假归因率低至 4.50%(三款新模型中最优)
  • 阶跃星辰开源旗舰 Step 5 Preview (600B-A27B) 以 75.1% 位居第 8,越权操作率仅 2.11%,与 Meta 闭源旗舰基本持平
阅读全文
关联模型 / 智能体 / 厂商:

Meta Muse Wonder / Wonder Full:Active Memory + Active Focus 前沿智能体模型;Muse Wonder 已上线 Cursor(CursorBench 46.1%,$4/$20)

2026-10-12 Meta 正式发布 Muse Wonder 与 Muse Wonder Full,定位为个人与专业智能体任务的前沿模型。官方强调 Active Memory(跨会话保留并召回关键上下文)与 Active Focus(遇阻换路、错误恢复、重要动作前确认)。Muse Wonder 即日起通过 Meta Model API 与 Muse Code 开放;Wonder Full 仅面向 Muse Code 订阅用户。第三方 Artificial Analysis Intelligence Index(max 推理)给出 Wonder Full 56、Wonder 52(此前 Spark 1.3 Max 为 48)。 10-16 更新:Muse Wonder 已上线 Cursor,300k 上下文(Max Mode 1M 同价),$4/$20 每百万 token,Cursor 官方口径 CursorBench 46.1%。

Meta Muse Wonder / Wonder Full:Active Memory + Active Focus 前沿智能体模型;Muse Wonder 已上线 Cursor(CursorBench 46.1%,$4/$20)

核心要点速览

  • 发布日 2026-10-12:官方博客与 @AIatMeta 同步官宣 Muse Wonder / Muse Wonder Full(Meta 新闻)
  • 可用性(官方口径):Muse Wonder → Meta Model API + Muse Code;Muse Wonder Full → 仅 Muse Code 订阅用户
  • 架构关键词:Active Memory(跨会话记忆与按需召回)+ Active Focus(长程攻坚、换路、确认后再执行)
  • 第三方跑分(Artificial Analysis,max):Wonder Full 56、Wonder 52;对比 Spark 1.3 Max 48(AA Changelog 12 Oct)
  • Cursor 上线(2026-10-16):muse-wonder-1.0,300k / Max Mode 1M 同价,$4/$20 每百万 token;Cursor 官方口径 CursorBench 默认档 46.1%(Cursor 文档)
阅读全文