AI 编程实时动态与要闻

Zyphra 开源语音合成模型 ZONOS3-Mini:800M 总参、100M 激活的 MoE,Apache 2.0 协议,手机浏览器内实时运行,可逐词控制语气与声线克隆

Zyphra 11 月 9 日发布开源语音合成(TTS)模型 ZONOS3-Mini,权重以 Apache 2.0 协议上架 Hugging Face。它是稀疏 MoE 模型,总参数 8 亿、每 token 激活约 1 亿,用 112 张 H100 训练 2.5 天。官方口径:在 Pixel 9 浏览器里首段音频延迟低于 570 毫秒,M3 MacBook Air 上低于 150 毫秒;在自建的 ZTTS2-Eval(35 种语言朗读 + 20 种语言真实录音)能力指数上排名开源模型第一,领先 Fish S2 Pro 和 MOSS TTS v1.5。支持声线克隆、年龄/口音/性别调节和逐词语气控制,提供 WebGPU、SGLang、vLLM、GGML、MLX 等运行时。

Zyphra 开源语音合成模型 ZONOS3-Mini:800M 总参、100M 激活的 MoE,Apache 2.0 协议,手机浏览器内实时运行,可逐词控制语气与声线克隆

核心要点速览

  • 规模:800M 总参、约 100M 激活(64 专家、top-2 路由),上一代 ZONOS2 为 8B,Apache 2.0 开放权重
  • 速度(官方口径):Pixel 9 浏览器首段音频 <570 ms,M3 MacBook Air <150 ms;单张 H100 在 8 并发下中位首音 80 ms,峰值每秒生成 457 秒音频
  • 自研 ZAC-1 编解码器帧率 15 Hz(原 DAC 为 86 Hz),同等数据下词错率降低约 10 倍;单次最多生成 10 分钟 44.1 kHz 音频
  • 评测:ZTTS2-Eval 覆盖 35 种语言朗读 + 20 种语言真实录音,420 项能力指数中开源模型排名第一,其次为 Fish S2 Pro 与 MOSS TTS v1.5(自建基准,暂无第三方复现)
  • 上手:浏览器 WebGPU 免安装试用,或 sgl-omni serve --model-path Zyphra/ZONOS3-Mini 起 OpenAI 兼容 /v1/audio/speech 接口
阅读全文
关联模型 / 智能体 / 厂商:
⚡ ZONOS3-Mini🌐 Zyphra

NVIDIA 为韩国四大开源模型发布 Dynamo 部署配方:A.X K2、K-EXAONE 2.0、Solar Open 2、Motif-3 一键上 B200,官方称推理性能最高 2 倍

NVIDIA 在首尔 AI Day 上为韩国四个主力开源大模型发布 Dynamo 优化部署配方:SK Telecom 的 A.X K2、LG AI Research 的 K-EXAONE 2.0(750B-A37B)、Upstage 的 Solar Open 2(250B)和 Motif Technologies 的 Motif-3。配方针对 B200,统一使用 NVFP4 权重 + FP8 KV 缓存与 vLLM 后端,提供聚合与预填/解码分离(disaggregated)两套 Kubernetes 清单和基准脚本,官方称开箱最高 2 倍推理性能(未说明对比基线)。按 Dynamo 文档实测:Motif-3 两张 B200 单 GPU 输出约 294 tok/s,K-EXAONE 2.0 四卡首 token 仅 291 毫秒。这也是 NVIDIA 与韩国科技部「AI for All」合作的一部分。

NVIDIA 为韩国四大开源模型发布 Dynamo 部署配方:A.X K2、K-EXAONE 2.0、Solar Open 2、Motif-3 一键上 B200,官方称推理性能最高 2 倍

核心要点速览

  • 覆盖 4 个韩国开源模型:SK Telecom A.X K2、LG K-EXAONE 2.0(750B-A37B)、Upstage Solar Open 2(250B)、Motif-3;配方已在 GitHub ai-dynamo/dynamo 的 recipes/ 目录
  • 官方口径:B200 上开箱最高 2 倍推理性能,但 NVIDIA 未说明与哪种基线比较
  • Dynamo 文档实测(聊天 trace,SLA 为每用户 ≥50 tok/s 且 TTFT p50 <5 秒):Motif-3 2×B200 单 GPU 293.96 tok/s、TTFT 388 ms;Solar Open 2 两副本 216.88 tok/s/GPU、TTFT 308 ms
  • K-EXAONE 2.0 4×B200 聚合:87 tok/s/GPU、每用户 51.4 tok/s、TTFT 291 ms;A.X K2 8×B200 + EAGLE3:76.49 tok/s/GPU、TTFT 0.525 秒,另有 32×H200 方案
  • 注意:Motif-3、A.X K2 跑分用的是合成的投机解码接受长度(约 2.1),不代表真实接受率与输出质量;Solar Open 2 默认高推理强度,GPQA 中位输出约 6,400 tokens,max_tokens 要给足
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

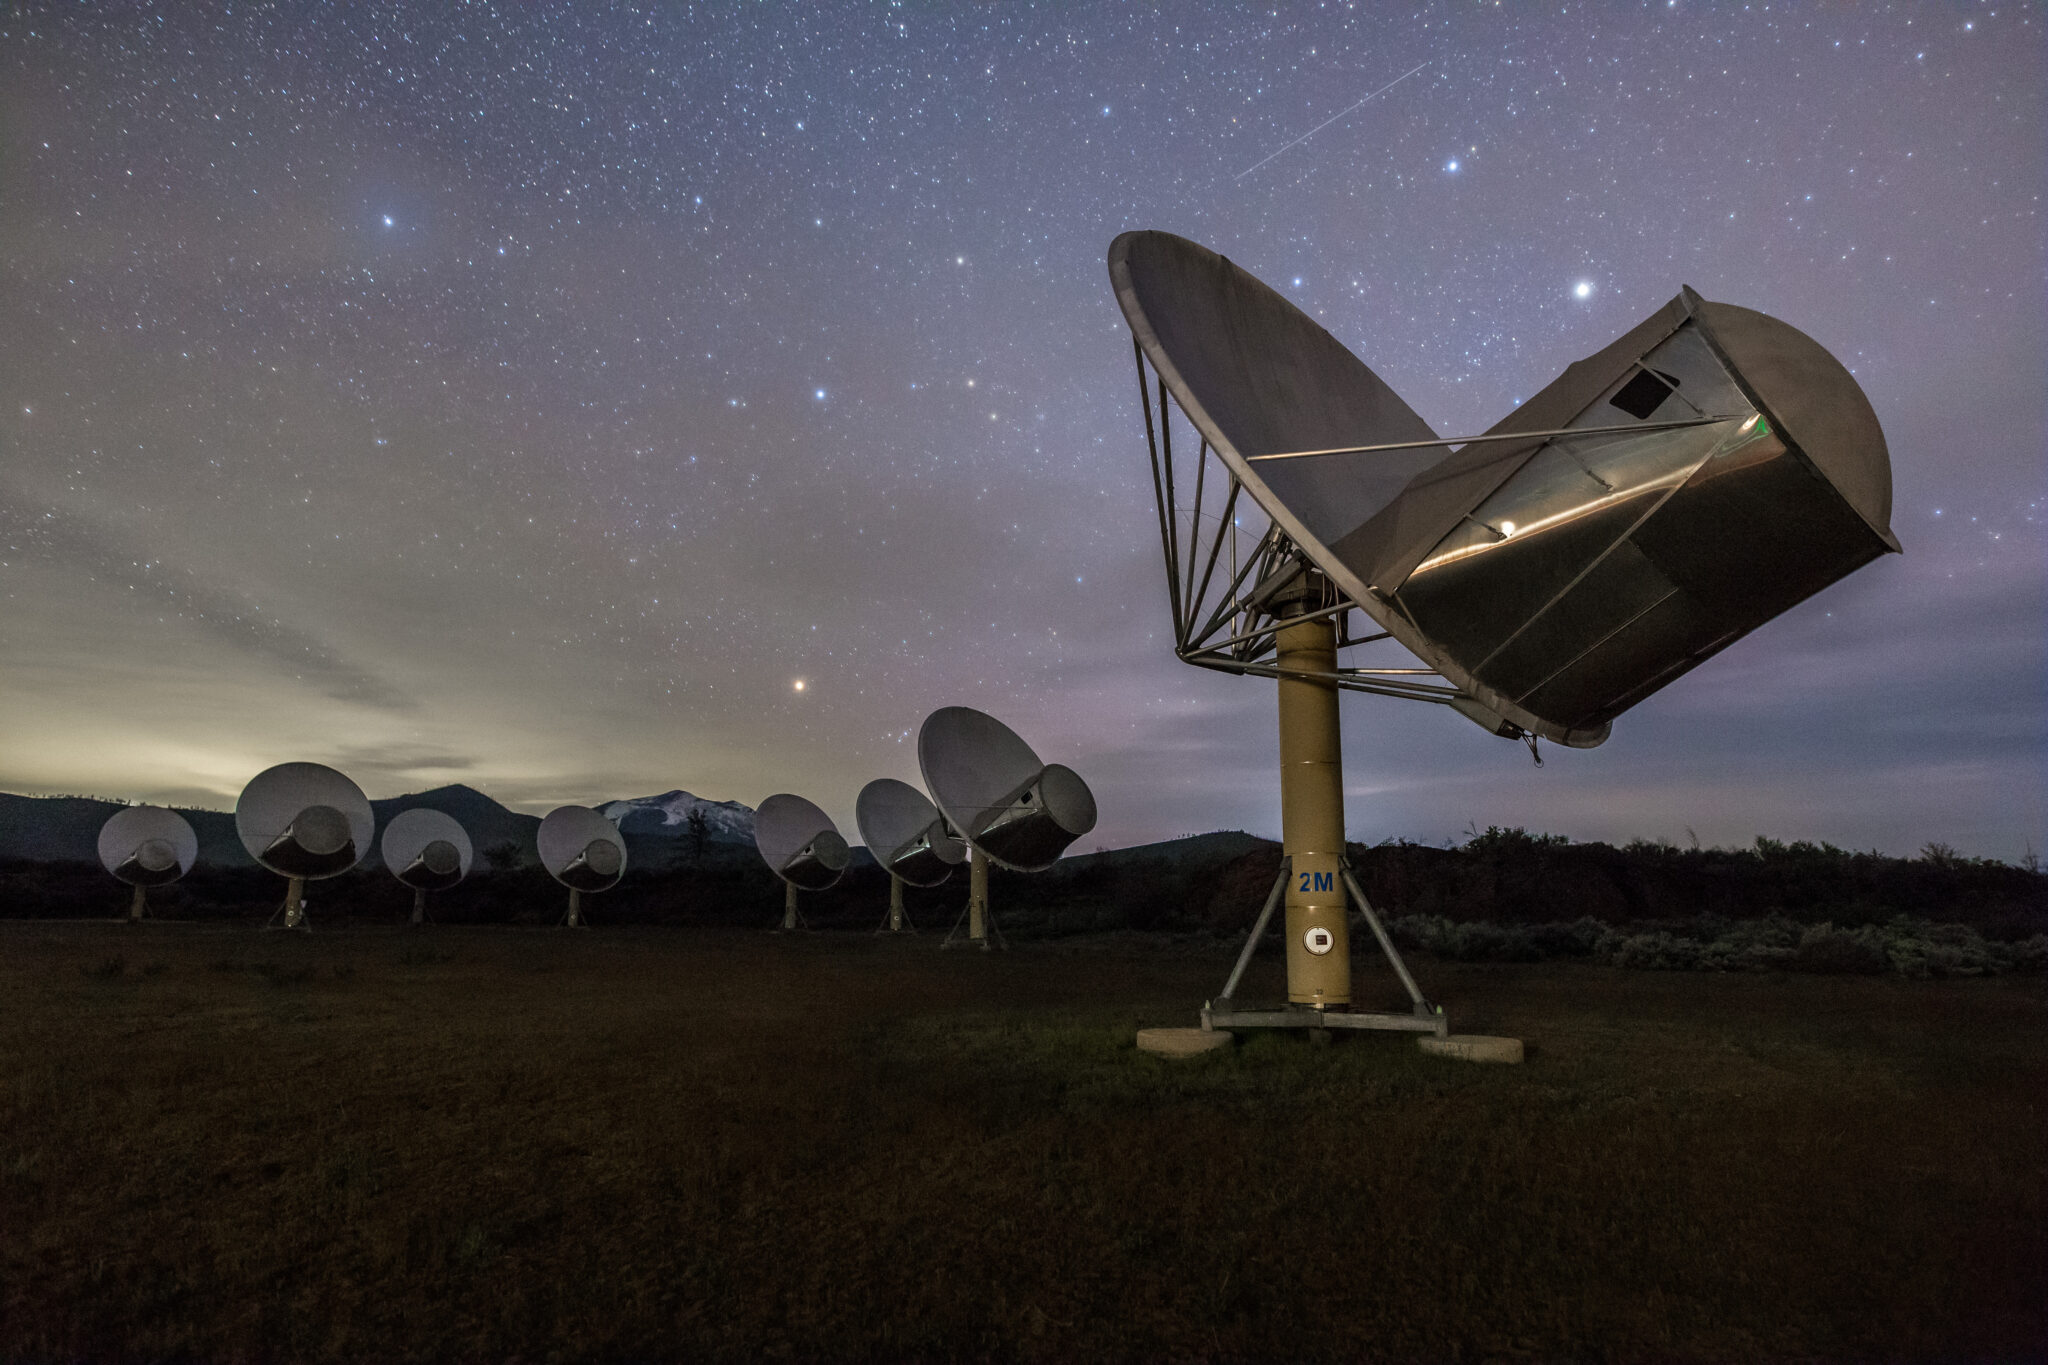
NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

Mistral 10 月 29 日发布改进版 Mistral Large 4(Le Chonk)并开放权重,已上架 Hugging Face(另有 NVFP4 量化版),API 名为 mistral-large-4。相比 10 月初的公开预览,多做了约三周强化学习:官方口径 FrontierCode 2.0 得分 19.7%、Terminal-Bench 4.0 从 28% 升到 41%,并新增 low/medium/high 三档推理。许可证为改版 MIT,商用可用,但做模型即服务需另签商业许可。

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

核心要点速览

  • 规格:约 1T 总参数、每 token 激活 49B(含嵌入和输出层约 52B),128 个路由专家每次激活 4 个外加 1 个共享专家,1M 上下文,文本+图像输入
  • Mistral 口径:Cognition FrontierCode 2.0 得分 19.7%,高于 DeepSeek V4.1 Flash 的 19.3% 和 GLM-5.3 的 17.8%,开源模型第一
  • Artificial Analysis 编码智能体指数 48%,与 GLM-5.3 基本持平,但平均每任务少用 47% 的 token;Terminal-Bench 4.0 由预览版 28% 提升到 41%
  • Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒绝率 96.6%,官方称为开源模型中最高
  • 在 Mistral 自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练;Surge Code 盲评中仅次于 Claude Opus 5.5
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

2026-10-23(UTC 15:41,SGT 23:41),NVIDIA AI 官方账号 @NVIDIAAI 宣布 Nemotron 3.5 Bolt E4B 4GB 上线,定位是能对话、能调用工具的本地小模型,用于本地助手、互动角色和机器人。Hugging Face 官方模型卡显示:它由 Gemma-4-E4B-it 后训练而来,总参数 8B(有效 4B),Q4_K_M 量化,输入输出各支持最多 64K token,可开关思考模式,并提供 DFlash 推测解码草稿模型和 BF16 版本;权重、数据和训练配方开放,许可证为 OpenMDW-1.1,可商用。模型卡跑分中,4GB 量化版 MultiChallenge 55.60(Gemma4 E4B-it 同量化 39.36、Qwen3.5 4B 52.23),但 Tau2-Bench 52.32、BFCL-v3 67.31 低于 Qwen3.5 4B。

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

核心要点速览

  • NVIDIA 官方发布 Nemotron 3.5 Bolt E4B 4GB,面向本地助手、互动角色和机器人
  • 基于 Gemma-4-E4B-it 后训练,总参数 8B(有效 4B),Q4_K_M 量化,64K 上下文,可开关思考模式
  • 权重、数据、训练配方开放,OpenMDW-1.1 许可可商用,附 DFlash 推测解码草稿模型
  • 模型卡跑分:MultiChallenge 55.60 领先同级,但 Tau2-Bench 和 BFCL-v3 不及 Qwen3.5 4B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Bolt E4B⚡ Gemma 4 E4B🌐 NVIDIA🌐 Google

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

在 GTC Berlin 开幕主题演讲中,NVIDIA 官方集中发布了横跨多个专业垂直领域的全新开源模型矩阵。核心亮点包括:支持长文本视觉推理的 Nemotron 3.5 Super VL 与即开即用的 Bolt 系列语言模型;专为高精度 RAG 打造的 Nemotron Retriever 嵌入、重排与文档解析全套套件;面向实体工业的 Cosmos 物理世界模型;面向自动驾驶的 Alpamayo 2 Edge;以及与华盛顿大学 Baker 实验室联合开发的蛋白质生成大模型 BioNeMo RFD4-Proteina。官方实测显示,RFD4-Proteina 在 10 项以上蛋白质设计基准中斩获全球第一,在 200 个氨基酸的靶点设计上比 RFdiffusion3 提速惊人的 13 倍。

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

核心要点速览

  • NVIDIA 在 GTC Berlin 集中开源全栈垂直基础模型:包含 Nemotron 3.5 Super VL、Bolt 4GB 端侧版与 Cosmos 物理世界模型
  • 发布 Nemotron Retriever 全套套件,将企业级 RAG 检索、跨模态重排与复杂 PDF 版面解析的准确率推至行业前列
  • 与顶尖 Baker 实验室联合开源 BioNeMo RFD4-Proteina,在 10 余项蛋白质靶向结合任务中登顶全球性能榜首
  • RFD4-Proteina 生成 200 氨基酸蛋白质结构的设计速度比前代标杆 RFdiffusion3 提速整整 13 倍,大幅缩短原研药发现周期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Super VL⚡ Nemotron 3.5 Bolt⚡ BioNeMo RFD4-Proteina⚡ Cosmos🌐 NVIDIA🌐 Baker Lab

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

亚马逊 AWS 与伊利诺伊大学厄巴纳-香槟分校(UIUC)研究团队在 arXiv:2610.22448 中正式开源 Lean4AgenticRL 框架。针对传统 Agent 强化学习过度依赖稀疏二值结果奖励(Outcome Rewards)、忽视底层工具调用与中间工作流状态的痛点,该研究首次将多级过程奖励锚定在 Lean4 交互式定理证明器的形式化模式中,提出工作流阶段归一化 GRPO 算法。训练得到的 LAR-27B 在 TerminalBench-2.1 上斩获 77.3% 高分,较基座模型提升 9.89%。

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

核心要点速览

  • AWS 与 UIUC 联合推出 Lean4AgenticRL(arXiv:2610.22448),首创将多级过程奖励形式化锚定在 Lean4 交互式定理证明器中
  • 针对稀疏结果奖励痛点,提出工作流阶段归一化 GRPO 算法,有效隔离长轨迹多步探索的高方差与奖励黑客
  • 训练得到的 LAR-27B 在 TerminalBench-2.1 上取得 77.3% 佳绩,较基座模型大幅提升 9.89%,超越同尺寸最优模型 5.07%
  • 消融实验证实形式化阶段校验使收敛速度提升超 42%,为工业级自主编程与终端 Agent 提供可验证强化学习新范式
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

Arena 官方正式发布 Code Arena: WebDev 最新榜单:深度求索最新推出的 DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分登顶开源模型第一,全面超越 Kimi K3 (Max) 且推理成本降低近 10 倍。该模型位列全榜总榜第 12,超越 Claude Opus 5 (High) 并与顶尖闭源旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分以内,以百万 Token 输入 $0.3 / 输出 $1.2 的极低资费大幅改写 Pareto 前沿。

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

核心要点速览

  • DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分斩获 Arena Code Arena: WebDev 开源模型第一名,超越 Kimi K3 (Max)
  • 位居全榜第 12 名,越级战胜顶尖商业模型 Claude Opus 5 (High),与商业旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分
  • 以百万 Token 输入 $0.3 / 输出 $1.2 的极致费率颠覆性重构 Web 代码生成的 Pareto 效率前沿,成本仅为同等闭源模型的 1/10
  • 相较一个月前的 20260910 版本单月实现 +52 分的性能狂飙
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

阿里巴巴淘天集团发表生产级多智能体商业视觉生成系统 CommerceGen-Studio(arXiv:2610.20603,HF 52 赞),通过 PERL-Agent 闭环自进化与 6B 参数 SKU-DiT(RDR 三阶段强化蒸馏),支撑日均数百万张秒级生成,并在真实流量基准 CommerceGen-Bench 上以 9.43/9.45 分击败 20B Qwen-Image-Edit 及闭源 Nano Banana Pro;同期微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),在测试时外置统计采样彻底解决大模型生成同质化(Mode Collapse)。

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

核心要点速览

  • 阿里淘天 CommerceGen-Studio(arXiv:2610.20603)在生产环境支撑日均数百万张商品视觉生成、单图延迟仅数秒
  • 通过 Reinforce-Distill-Reinforce(RDR)训练的 6B 参数 SKU-DiT 在 CommerceGen-Bench 单图/多图任务上斩获 9.43 / 9.45 分,越级击败 20B Qwen-Image-Edit(8.67 / 7.48)与闭源 Nano Banana Pro(9.39 / 9.33)
  • 配合 PERL-Agent(Prompt-Eval-Refine-Loop)自进化闭环与 Layout Thinker Optimization 后,综合得分进一步提升至 9.62 / 9.48
  • 微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),通过从真实语料挖掘分类属性并在测试时显式采样,无需训练即可消除网页 UI 设计、智能体 3D 资产合成等五大场景的模式坍塌
阅读全文
关联模型 / 智能体 / 厂商:

规则世界建模三大突破:OmniVerifier-C1 解耦分级验证器赋能迷宫/数独生成,美团 WorldCast 揭露开源仅 20.1 分代差,国大 RPO 扩散 RL 提速 4 倍

针对多模态生成模型向“严守物理与逻辑规则的世界模型”演进中的验证、评测与强化学习对齐难题,今日三项重磅研究给出系统答案:OmniVerifier-C1(arXiv:2610.22355,HF 32 赞)通过解耦强化学习(DAPO)将提示词拆解为子问题二元判断与全局连续打分,在 ViVerBench 上提至 0.684 并将 FLUX.1-dev 的 GenEval 推至 0.79;美团开源 320 例多步世界状态预测基准 WorldCast(arXiv:2610.20731,HF 30 赞),揭示 GPT-Image-2.5 System 达 72.8 分而最强开源模型仅 20.1 分;新加坡国立大学提出路由策略优化 RPO(arXiv:2610.22282),将注意力块路由作为随机探索动作,以仅 24.1 GPU 小时(较 Flow-GRPO 与 DanceGRPO 分别快 3.1 倍和 4.2 倍)大幅提升视频生成语义对齐。

规则世界建模三大突破:OmniVerifier-C1 解耦分级验证器赋能迷宫/数独生成,美团 WorldCast 揭露开源仅 20.1 分代差,国大 RPO 扩散 RL 提速 4 倍

核心要点速览

  • OmniVerifier-C1 采用解耦强化学习(DAPO)联合优化子问题二元判断与全局连续打分,在 ViVerBench 达 0.684 并将 FLUX.1-dev 的 GenEval 总分从 0.68 拉升至 0.79
  • 美团开源 320 例多步世界状态预测基准 WorldCast:评测 12 款模型发现 GPT-Image-2.5 System 斩获 72.8 分,Nano Banana Pro 为 42.8 分,而最强开源模型仅得 20.1 分
  • 新加坡国大提出路由策略优化(RPO):在注意力块路由内部进行双轨迹随机探索且推理期零改动恢复稠密注意力,在 Wan2.2-TI2V-5B 上仅需 24.1 GPU 小时(较 Flow-GRPO 与 DanceGRPO 分别快 3.1 倍和 4.2 倍)
阅读全文
关联模型 / 智能体 / 厂商:

Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

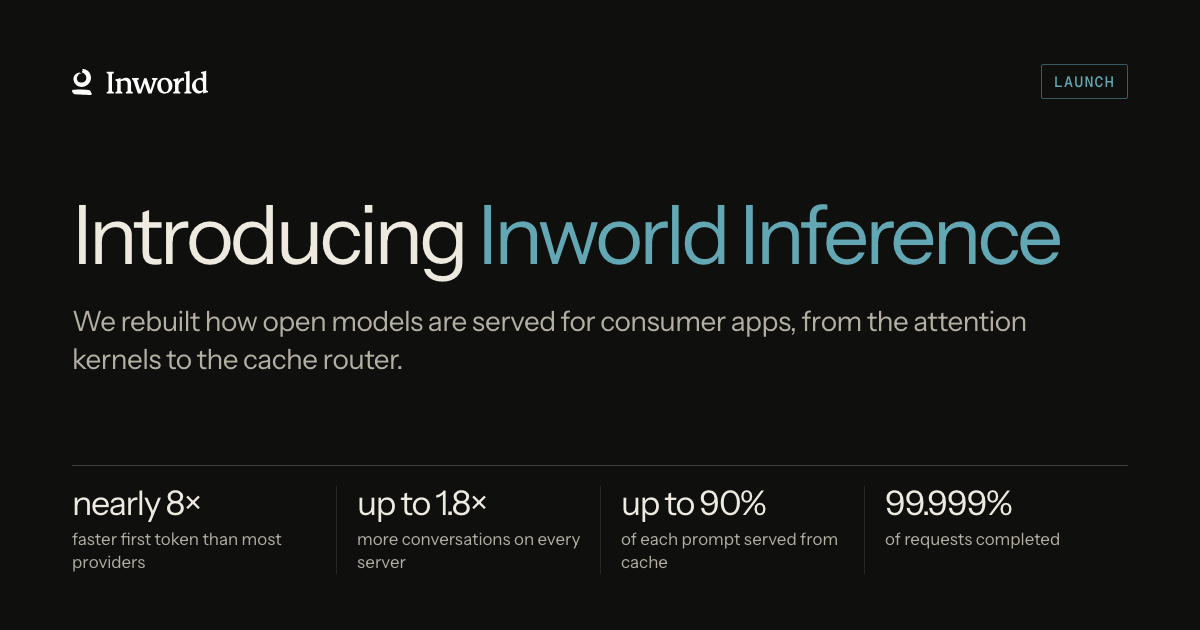
Inworld AI 于 2026-10-14 向所有开发者开放 Inworld Inference,定位为面向消费级应用(陪伴、家教、语音、互动小说)的推理服务。它不铺海量模型,而是为 Gemma 4、GLM 5.3 Flash、DeepSeek、MiMo 等开源模型逐个定制推理构建:草稿-验证(投机)解码、改写的 split-KV 验证注意力、KV 感知路由和按评测把关的低精度权重。官方口径:Gemma 4 26B p95 首 token 0.31 秒,比 OpenRouter 中位供应商快 7.8 倍;最高 90% 提示命中缓存;GLM 5.3 Flash 30 天 2000 万+请求成功率 99.999%。API 兼容 OpenAI SDK,按请求选 Flex/Default/Priority/Fast 四档。

Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

核心要点速览

  • Gemma 4 26B 首 token:p50 0.17 秒 / p95 0.31 秒,较 OpenRouter 中位供应商快 3.6 倍 / 7.8 倍(官方博客,厂商口径,非同负载对比)
  • 价格:Gemma 4 26B 输入 $0.07、缓存 $0.035、输出 $0.34 每百万 token,比不训练用户数据的供应商中位价低近 40%
  • 改写验证注意力 kernel 后单层快 3.4–7.5 倍,注意力占解码步比例 27.5%→16.5%,p50 TTFT 154→117 ms,评测分数不变
  • KV 感知路由:GLM 5.3 Flash 缓存命中 25%→47%,DeepSeek V4.1 Flash 11%→33%;MiMo 2.6 Pro 缓存输入便宜 99%
  • 可靠性:GLM 5.3 Flash 30 天 2000 万+请求仅 98 次失败(约 4.8/百万);service_tier 支持 Flex/Default/Priority/Fast 四档
阅读全文
关联模型 / 智能体 / 厂商:

全模态检索降维打击!MBZUAI 开源 Omni-Embed-Mini:0.9B 参数打通六大多模态,纯冻结文本权重零遗忘

将文本表征模型扩展至语音、音频、图像、视频及图文混排文档等多模态领域时,传统方案往往导致严重的文本检索灾难性遗忘,而现有全模态向量模型通常需要数十亿甚至上百亿参数来勉强维持平衡。穆罕默德·本·扎耶德人工智能大学(MBZUAI)等团队推出了轻量化全模态嵌入模型 Omni-Embed-Mini。该模型仅拥有 0.9B 极小参数量,通过密集的级联描述蒸馏(Dense Cascaded Caption Distillation),将文本、语音、音频、图像、视频与文档六大模态映射进统一的余弦空间。核心突破在于文本侧权重保持 100% 静态冻结(Byte-Identical),从理论与工程上彻底杜绝了文本检索退化(MTEB-v2 BEIR-8 达 49.57 nDCG@10);而其 2.3B 升级变体在全模态平均检索得分上更是逆袭超越了闭源商业标杆 Gemini-Embedding-2。

全模态检索降维打击!MBZUAI 开源 Omni-Embed-Mini:0.9B 参数打通六大多模态,纯冻结文本权重零遗忘

核心要点速览

  • 仅凭 0.9B 极小体积打通文本、语音、音频、图像、视频与图文文档 6 大模态的统一向量对齐
  • 文本侧参数比特级完全冻结,从数学根源杜绝文本灾难性遗忘(MTEB-v2 BEIR-8 达 49.57 nDCG@10)
  • 2.3B 升级版本在多模态综合检索平均表现上全面逆袭超越 Google 闭源商业模型 Gemini-Embedding-2
阅读全文
关联模型 / 智能体 / 厂商:
A
AgentField / Santosh Radha@Agent-Field·
👀89
🔥95

AgentField 开源 CodeAF v0.6:单 Go 二进制「软件工厂」专打开源模型;厂商 DeepSWE 同模对比 54.9% 居首

Agent-Field/CodeAF 以 Apache-2.0 单二进制把开源权重(DeepSeek/Qwen/GLM/Kimi 等)编成「工厂」:一窗派活、子 harness 分工、Pareto Crewing 按任务选模型。v0.6.0 发布于 2026-10-01T18:59:00Z;本跑 ★259。厂商文档:同模 DeepSeek V4 Flash 上 /senior-dev 在 DeepSWE 113 题解出 62(54.9%),单位成本标为对照 1x(有单种子与采样契约差异等限制)。

AgentField 开源 CodeAF v0.6:单 Go 二进制「软件工厂」专打开源模型;厂商 DeepSWE 同模对比 54.9% 居首

核心要点速览

  • 仓库 Agent-Field/CodeAF Apache-2.0;本跑 ★259 / forks 34;安装 curl -fsSL https://agentfield.ai/get/codeaf | bash
  • 正式标签 v0.6.0 发布于 2026-10-01T18:59:00Z;README 仍标 early preview
  • 厂商 DeepSWE 对照(同模 deepseek-v4-flash-0731,113 题):senior-dev 62/113=54.9%、每题约 22¢;mini-swe-agent 49.6%、codex 45.1%、pi 37.2%、claude-code 14.2%(见仓库 docs/benchmarks/deepswe)
  • 后续同套题:DeepSeek V4.1 Flash 上报 88/113=77.9%;Kimi K3 78/113=69.0%(仅 senior-dev,非跨 harness 对比)
  • 内置 OpenRouter/DeepSeek/GLM/Kimi/MiniMax/Qwen/Codex/Ollama;crew 默认 worker/planner/checker 三角色自动选模
阅读全文