AI 编程实时动态与要闻

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

a16z 10 月 30 日发布的 Charts of the Week(作者 Moses Sternstein)讨论了「Rack Spread」:GPU 租金在涨,token 价格在跌。a16z 官方 X 账号 10 月 31 日总结:5 月以来 token 均价下降 67%,token 花费增长超过 120%;按文章的粗算,用 Ramp 数据得出约 122%,用 Ornn 混合单价乘 OpenRouter 用量得出约 160%。另一条帖子给出 7 月中以来 B300 租金涨 106%、B200 涨 66%、H100 涨 17%。a16z 同时强调这些指数样本小且有偏差,不能代表真实总需求。

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

核心要点速览

  • 价格与花费:5 月以来 token 均价降 67%,token 花费涨超 120%(a16z 官方 X 帖,a16z 口径)
  • 两种粗算:Ramp 的 token 花费数据约 +122%;Ornn 混合单价 × OpenRouter 用量约 +160%(Charts of the Week,作者自称是粗算而非严谨方法)
  • GPU 租金:7 月中以来 B300 +106%、B200 +66%、H100 +17%,同期 token 均价 -58%(a16z 帖子)
  • 人均 AI 支出:亚特兰大联储调查的均值超过每员工 1,000 美元,Ramp 的中位数是每月 15.70 美元(每年 188 美元)
  • 热度:两条帖子约 371 和 492 赞、3.8 万和 9.6 万浏览(截至 18:15 SGT)
阅读全文

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

Inception 10 月 19 日发布 Mercury 3,称其为迄今最强的扩散式大语言模型(dLLM)。官方口径:参数规模是 Mercury 1 的 40 倍以上,输出速度 1068 token/秒,上下文从 Mercury 2.5 的 26 万扩到 100 万 token,在 GPQA Diamond、IFBench、SWE-Bench Atlas 等基准上超过 GPT-6 Luna 与 Claude Haiku 5.5(均为 medium 档)。标价每百万输入 0.20 美元、输出 0.70 美元,首发五折。已上线 Inception API、OpenRouter、Baseten 和 Vercel AI Gateway,兼容 OpenAI API。跑分均为厂商自测,暂无独立复现。

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

核心要点速览

  • 速度:输出 1068 token/秒,官方对比表中 GPT-6 Luna 约 130、Haiku 5.5 约 240(厂商口径)。
  • 跑分:GPQA Diamond 89.23、IFBench 76.84、SWE-Bench Atlas 51.08,均高于 Luna 与 Haiku 5.5;但 DeepSWE v1 46.31 低于 Haiku 5.5 的 51.62,MRCR v2 也落后 Haiku。
  • 规模与上下文:参数是 Mercury 1 的 40 倍以上,上下文 100 万 token(Mercury 2.5 为 26 万)。
  • 价格:标价输入 $0.20/M、输出 $0.70/M,首发五折为 $0.10/$0.35,缓存输入再打 1 折;新 API key 赠 1 亿 token。
  • 渠道:Inception API、OpenRouter、Baseten、Vercel AI Gateway,OpenAI API 兼容,可直接替换。
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

MiniMax 官方确认,此前在 OpenRouter 等榜单上用量领先的匿名模型 Space Bunny 就是 M3.1 Flash 的早期版本,并于 10 月 19 日正式上线 API。按量计费为输入 $0.15、输出 $0.60、缓存读 $0.015(每百万 token),1M 上下文,支持文本、图片和视频输入,可用 effort 调节思考深度。官方口径:成本是 M3 的 1/3、速度 3 倍,DeepSWE 73.7%、Automation-Bench 62.2%;10 月 23 日权重已按期在 Hugging Face 开放(MiniMax Community 许可,MXFP8),Together、Inferact(vLLM)、LightSeek TokenSpeed 首日支持。

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

核心要点速览

  • 官方定价(按量):输入 $0.15 / 输出 $0.60 / 缓存读 $0.015 每百万 token;按单价是 M3($0.30/$1.20)的一半,官方「1/3 成本」未说明计算口径。
  • 官方跑分:DeepSWE v1.1 73.7%(Opus 5 为 74.0%)、Automation-Bench 62.2%、BabyVision(带工具)91.0%、Terminal Bench 4.0 38.1%(Opus 5 为 51.8%)。
  • 1M 上下文,文本/图片/视频输入,effort 五档 low 到 max,默认 max,思考不能关闭。
  • 10 月 23 日权重已开放:Hugging Face MiniMaxAI/MiniMax-M3.1-Flash,非 gated,MiniMax Community 许可(非 MIT/Apache),MXFP8 量化,原生多模态 MoE,总参约 428B、每 token 激活 23B,自带 DSpark 投机解码草稿头。
  • 迁移提醒:M2.5/M2.7 自 10 月 19 日起不再对新用户开放,11 月 18 日下线;M Plan 与 Token Plan 的请求已自动路由到 M3.1 Flash。
  • 首日部署:Together AI 托管上线,MiniMax 与 Inferact 合作把生产推理改进回馈 vLLM,LightSeek 的 TokenSpeed 也提供首日支持。
阅读全文
AD赞助内容

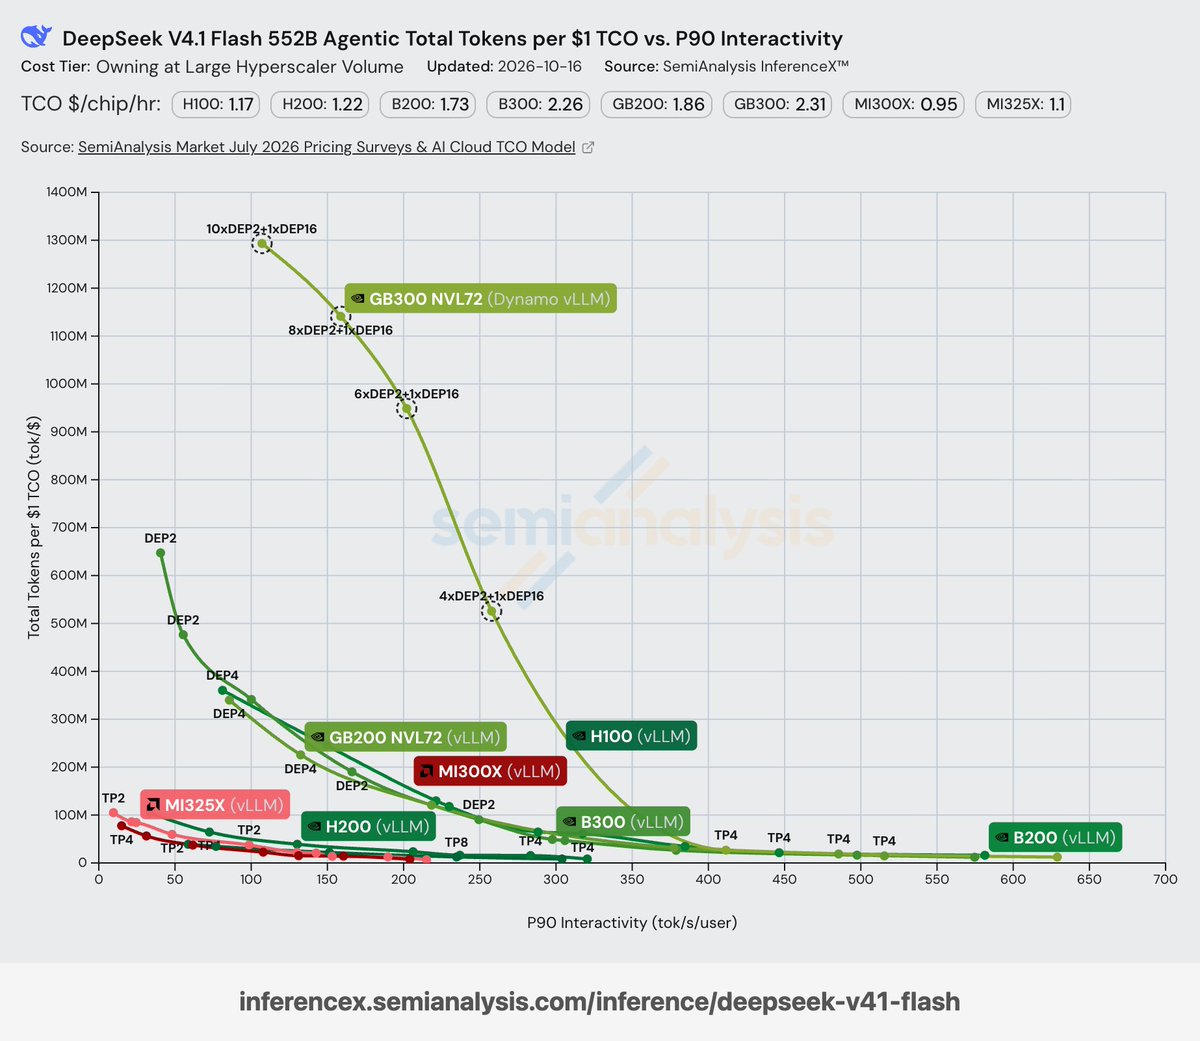
vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

核心要点速览

  • vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
  • 模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
  • OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

Perplexity 开发者团队(@perplexitydevs)联合 OpenRouter 与 Vercel AI Gateway 正式上线新一代开源权重多模态决策模型 pplx-decider-v1.2(27B)与轻量级 pplx-decider-flash-v1.2(4B)。该系列模型支持同时输入文本与图像,直接返回带校准概率分布的类型化决策结果(Typed Answers with Probabilities),其中 27B 版本输入定价低至 $0.02/百万 Token,4B Flash 版速度更快且成本再砍半,成为智能体路由与工具选择的极速基础设施。

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

核心要点速览

  • 双尺寸多模态决策模型上线:发布 27B 旗舰版 pplx-decider-v1.2 与 4B 极速版 pplx-decider-flash-v1.2,支持图文输入直出类型化概率决策
  • 输入定价低至 $0.02/百万 Token:27B 版本仅售 $0.02/1M 输入 Token,4B Flash 版本速度更快且成本再减半
  • OpenRouter 与 Vercel 同步首发:支持 pplx-decider-latest 动态别名,专为智能体工具路由、护栏审查与多模态状态分类打造
阅读全文
关联模型 / 智能体 / 厂商:

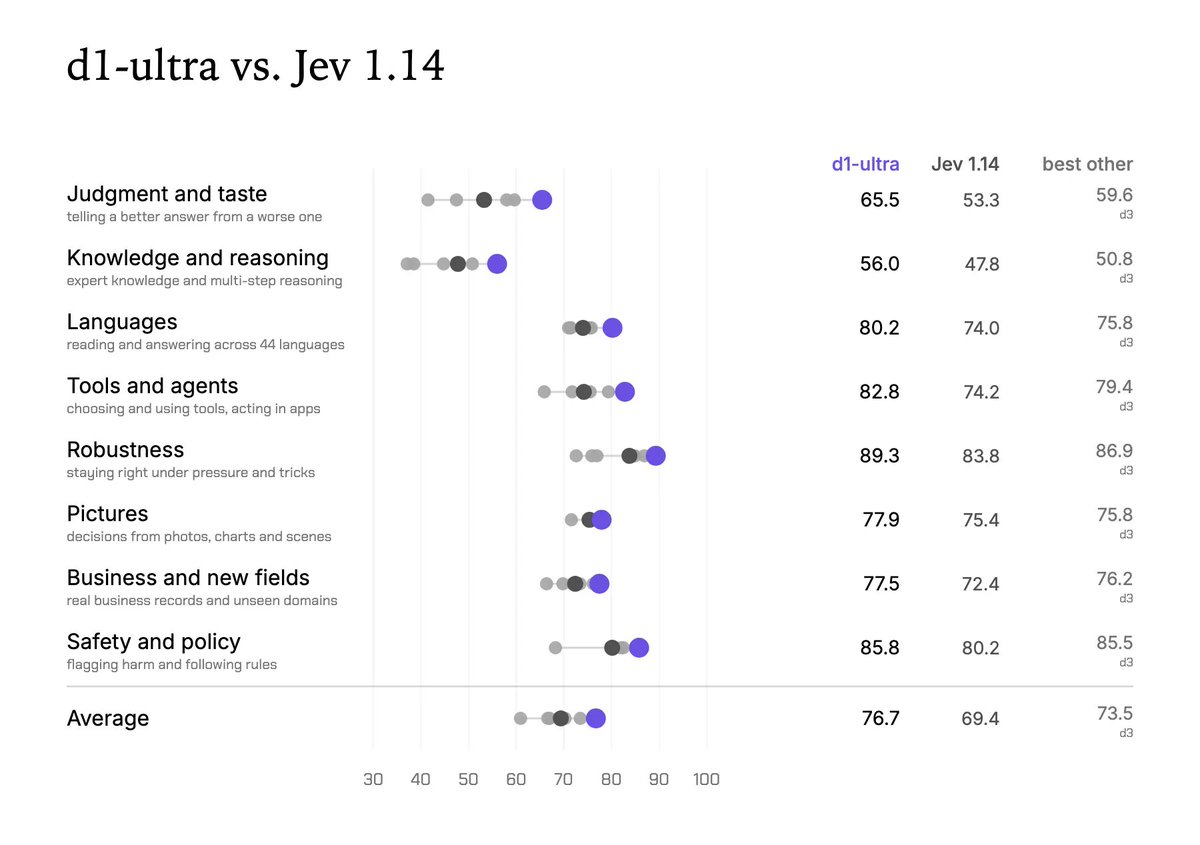
Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

Liquid AI 于 10 月 15 日发布多模态决策模型 d1-ultra,输入文本和图像,一次前向传播直接返回是非、单选、打分三类问题的概率,不生成任何 token,只按输入计费。Artificial Analysis 独立评测中它以 65 分登顶 Decision Index v1.0,领先至少 8 分,非幻觉率 85%;已上线 Liquid API、Vercel AI Gateway 与 OpenRouter。

Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

核心要点速览

  • Artificial Analysis Decision Index v1.0 得分 65,第一名,领先其他决策模型至少 8 分(独立评测)
  • AA-Omniscience-Decision 非幻觉率 85%,第二名 Microsoft-Decision-1 为 40%;但因更多弃答,准确率 32% 低于 d1 的 41%
  • 定价 $0.042 / 百万输入 token,输出免费;1024×1024 图像计 1,536 token(官方博客)
  • 上下文 32,768 token,支持 44 种语言,Liquid 自有 112 项评测中八大类全部领先(厂商口径)
  • 调用方式:Liquid /decisions/v1/systemone 端点 model: d1-ultra,或 Vercel/OpenRouter 的 liquid/d1-ultra(文档)
阅读全文
关联模型 / 智能体 / 厂商:

Meta 开源 Muse Spark Open:816B 总参 / 42B 激活 MoE,1M 上下文,官方称迄今最强美系开源权重模型

Meta 于 2026-10-15 发布 Muse Spark Open 权重:原生多模态 MoE(约 816B 总参、每 token 激活约 42B、1M 上下文),面向长程编程与智能体;权重可经 Hugging Face 等下载,并已上线 Together、Fireworks、Groq、OpenRouter 等托管推理。官方与第三方给出 DeepSWE 60%、MCP-Atlas 89.2%、JobBench 61.8% 等结果(口径见评测方法论文档)。

Meta 开源 Muse Spark Open:816B 总参 / 42B 激活 MoE,1M 上下文,官方称迄今最强美系开源权重模型

核心要点速览

  • 规模:约 816B 总参 / 每 token 激活约 42B;MoE 每层 256 专家、top-8 路由;62 层、隐藏维 8192;上下文至 1,048,576(HF 技术帖)
  • 编码/智能体(Meta 记分卡 / AA,xhigh):DeepSWE 60.0%;SWE-Atlas Codebase QnA 58.0%;MCP-Atlas 89.2%;JobBench 61.8%;Toolathlon-Verified 72.8%(评测方法)
  • 吞吐(NVIDIA 技术博客,GB300 NVL72 上 agentic 负载):宣称最高约 50K tok/s/GPU、约 600 tok/s/用户;提供 NVFP4 检查点(NVIDIA 博客)
  • 落地:权重 Muse Model License(有限商业条款);引擎含 SGLang / vLLM / TensorRT-LLM / MLX / llama.cpp;双台 Apple M5 Ultra Mac Studio 可桌面本地跑(官方演示)
  • 第三方综指:Artificial Analysis Intelligence Index 约 38.9–39(xhigh,2026-10-07 口径),低于闭源前沿,但是开源权重档位中的重点对照(AA)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark Open⚡ Muse Spark Open 816B-A42B🤖 Muse Code🌐 Meta🌐 NVIDIA🌐 Hugging Face🌐 Apple

Meta 开源 Muse Spark Open:816B/42B 原生多模态美系开源旗舰,双 M5 Ultra Mac Studio 可本地跑智能体

Meta 于 2026-10-15 放出 Muse Spark Open 开源权重:816B 总参、每 token 激活 42B 的 MoE + Perception Encoder,原生支持文本/图像/视频/音频输入与 1M 上下文,定位编码与长程智能体。权重上 Hugging Face(BF16/NVFP4)、SageMaker、Model Garden 与 Foundry;API 已通 OpenRouter、Together、Fireworks、Groq 等。官方称其为迄今最强美系开源权重,并与 Apple 合作使双台 M5 Ultra Mac Studio 经 MLX 本地跑通。

Meta 开源 Muse Spark Open:816B/42B 原生多模态美系开源旗舰,双 M5 Ultra Mac Studio 可本地跑智能体

核心要点速览

  • 规格:MoE 816B 总参 / 42B 激活(256 experts,top-8),62 层,1M 上下文;输入文本+图像+视频+音频,输出文本(模型卡)
  • 本地门槛:NVFP4 约需 ≥700GB 显存,BF16 约 2TB;亦可双台 Apple M5 Ultra Mac Studio + MLX 统一内存部署(Meta 博客)
  • 智能体基准(xhigh,官方表):MCP-Atlas 89.2、JobBench 61.8、OSWorld Verified 80.4、Terminal-Bench 2.1 76.4、DeepSWE 1.1 60、AA Intelligence Index 39
  • 推理栈:SGLang / vLLM / TensorRT-LLM / Transformers / llama.cpp / Unsloth / MLX;附 Helion 内核(NVIDIA/AMD 内核级 1.03–3.95×)
  • 许可:Muse Model License(须标注 Built with Muse Spark Open;年收入超 $20M 的 MaaS 需另签);OpenRouter 约 $1.25/M 入、$4.25/M 出
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

NVIDIA 于 2026-10-15 发布开源多模态智能体模型 Nemotron 3.5 Super VL:120B 总参、每 token 激活 12B,Mamba-2/Transformer 混合 MoE + C-RADIO 视觉编码器,支持文本、图像、文档与视频输入,最长 1M 上下文,自带 MTP 与 LiLiCorr 投机解码。权重、数据集与训练配方以 OpenMDW-1.1 开放,已上 Hugging Face、OpenRouter、ModelScope 与 NIM。同日放出面向 RTX/DGX Spark 的 Bolt 74B-A9B 24GB(原生 2-bit 量化感知训练),4GB 的 Bolt E4B 将于 10 月 23 日跟进。

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

核心要点速览

  • 规模:Super VL 120B 总参 / 12B 激活,最长 1M 上下文;BF16 参考部署需 4×H100 或 2×GB200,另有 NVFP4 版(模型卡)
  • 编码与终端(官方口径):SWE-bench Verified 71.10、Terminal-Bench 2.1 66.70、LiveCodeBench v6 88.22;同表 Qwen3.5-122B-A10B 分别为 71.9 / 48.70 / 76.7,GLM-5.3-Flash 为 79.10 / 82.70 / 80.6
  • 智能体评测:Hermes Bench 63.44%(Nemotron 3 Ultra 56.33%),LangChain Evals 87.05%(Ultra 84.3%);NVIDIA 称单卡吞吐最高达同级开源模型 5 倍、Baseten 端点 600+ TPS(技术博客)
  • 本地版 Bolt 74B-A9B 24GB:原生 2-bit(IQ2+QAT)、256K 上下文,Terminal-Bench 2.1 50.98、BrowseComp 66.75,对照 Qwen3.6-35B-A3B 为 44.38 / 48.74;PinchBench 87.82 略低于 Qwen3.6 的 88.07(Bolt 模型卡)
  • 推理工程:LiLiCorr 投机解码在 DGX Spark 上最高提速 2.3 倍;Dynamo 方案在 16×B200、50 tok/s/用户下服务人数提升 8 倍、首 token 延迟降 85%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ nemotron-3.5-super-vl⚡ nemotron-3.5-bolt-74b-a9b⚡ nemotron-3.5-bolt-e4b⚡ Nemotron 3 Ultra🤖 hermes-agent🤖 opencode🤖 OpenHands (All-Hands AI)🤖 Cline (VS Code Agent)🌐 Nvidia (NIM)
AD赞助内容

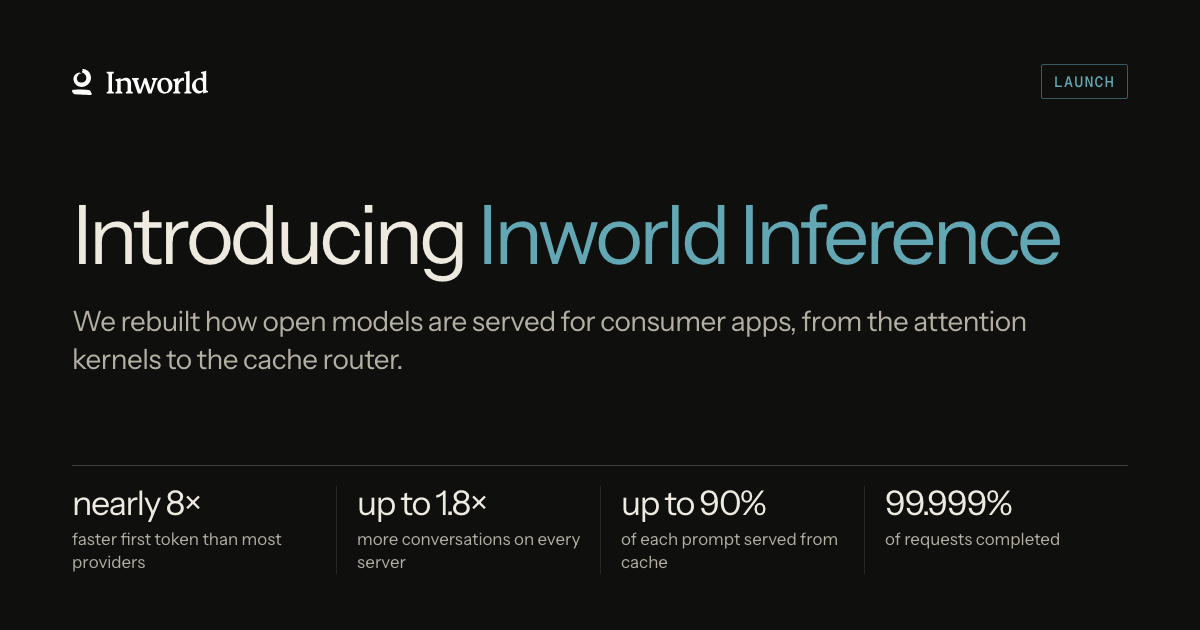
Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

Inworld AI 于 2026-10-14 向所有开发者开放 Inworld Inference,定位为面向消费级应用(陪伴、家教、语音、互动小说)的推理服务。它不铺海量模型,而是为 Gemma 4、GLM 5.3 Flash、DeepSeek、MiMo 等开源模型逐个定制推理构建:草稿-验证(投机)解码、改写的 split-KV 验证注意力、KV 感知路由和按评测把关的低精度权重。官方口径:Gemma 4 26B p95 首 token 0.31 秒,比 OpenRouter 中位供应商快 7.8 倍;最高 90% 提示命中缓存;GLM 5.3 Flash 30 天 2000 万+请求成功率 99.999%。API 兼容 OpenAI SDK,按请求选 Flex/Default/Priority/Fast 四档。

Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

核心要点速览

  • Gemma 4 26B 首 token:p50 0.17 秒 / p95 0.31 秒,较 OpenRouter 中位供应商快 3.6 倍 / 7.8 倍(官方博客,厂商口径,非同负载对比)
  • 价格:Gemma 4 26B 输入 $0.07、缓存 $0.035、输出 $0.34 每百万 token,比不训练用户数据的供应商中位价低近 40%
  • 改写验证注意力 kernel 后单层快 3.4–7.5 倍,注意力占解码步比例 27.5%→16.5%,p50 TTFT 154→117 ms,评测分数不变
  • KV 感知路由:GLM 5.3 Flash 缓存命中 25%→47%,DeepSeek V4.1 Flash 11%→33%;MiMo 2.6 Pro 缓存输入便宜 99%
  • 可靠性:GLM 5.3 Flash 30 天 2000 万+请求仅 98 次失败(约 4.8/百万);service_tier 支持 Flex/Default/Priority/Fast 四档
阅读全文
关联模型 / 智能体 / 厂商:

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

Liquid AI 10 月 13 日发布 LFM2.5 家族最大也是最后一款模型 LFM2.5-24B-A2B:总参 24B、每 token 激活约 2.45B,131K 上下文,强制先思考再回答。厂商口径下在 8 项工具/Agent 基准中 5 项领先或持平 Qwen3.6-35B-A3B(AutomationBench 27.69 vs 8.72),但 SWE-Bench Verified、GPQA 等知识与编码项落后。权重已上 Hugging Face,并有 GGUF/MLX/FP8/ONNX 版本;API 定价 $0.10/$1.00 每百万 token,OpenRouter 同步上架。

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

核心要点速览

  • 规格(模型卡):总参 24.0B、激活 2.45B;40 层(30 个门控短卷积块 + 10 个 GQA);每个 MoE 块 64 专家 top-4 路由;上下文 131,072、词表 128K
  • Agent 基准(厂商口径,对比 Qwen3.6-35B-A3B):AutomationBench 27.69 vs 8.72、LiveClaw 48.09 vs 38.19、ToolSandbox 80.71 vs 75.02、BFCLv4 65.01 vs 65.00
  • 短板同样公开:SWE-Bench Verified(OpenCode)51.00 vs 66.20、GPQA Diamond 74.42 vs 83.69、WebArena Verified 26.75 vs 37.62,官方建议知识类任务搭配检索
  • 速度(官方博客):Apple M5 Max 解码 184 tok/s、AMD Ryzen AI Max+ 395 为 114 tok/s;单张 B300 + SGLang 高并发超 21K 输出 tok/s
  • 训练:预训练由 17T 扩到 33T token,中训 2T@32K + 300B@131K;后训练含在 OpenClaw、Hermes Agent、Pi、OpenCode 中的 Agentic RL;API $0.10 输入 / $1.00 输出每百万 token
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LFM2.5-24B-A2B⚡ LFM2.5-24B-A2B-Base⚡ LFM2-24B-A2B⚡ Qwen3.6-35B-A3B⚡ Gemma-4-26B-A4B-it🤖 Hermes Agent🤖 OpenClaw🤖 OpenCode🤖 Pi🌐 Liquid AI🌐 Hugging Face🌐 OpenRouter

ScaleDown 推出约束解码模型 CDM:1M 上下文专做摘要/压缩/抽取/分类,LangChain 同日接入 Deep Agents 中间件

ScaleDown 10 月 13 日推出约束解码模型(CDM):每个模型只为一个任务训练,只输出该任务允许的答案(标签或原文片段),不逐 token 自由生成。LangChain 同日发布 langchain-scaledown 集成与 LangSmith LLM Gateway 支持,提供历史摘要、工具结果压缩、结构化抽取三类中间件。厂商口径:在这些窄任务上比前沿模型快 200 倍、便宜 467 倍;Extract 与 Summarize 已上 OpenRouter,输入 $0.04/百万 token。

ScaleDown 推出约束解码模型 CDM:1M 上下文专做摘要/压缩/抽取/分类,LangChain 同日接入 Deep Agents 中间件

核心要点速览

  • 四款单任务模型 Summarize / Compress / Extract / Classify,输入上限均为 100 万 token,Extract、Summarize、Classify 可直接吃图片与扫描 PDF(LangChain 博客)
  • 厂商口径:对比 GPT-5.5 / GPT-5.4 Mini / GPT-5.4 Nano 均值,Summarize 便宜 41 倍、快 2.7 倍,Compress 便宜 138 倍、快 1.8 倍,且准确率更高(ScaleDown 基准)
  • Classify 对标 Jev 决策模型:Jev 仅文本、每题 32K token 状态;Classify 支持 1M token 与图片,并给每个决策附一句理由
  • LangChain 官方示例中工具压缩中间件把一页文档从 18,402 字符压到 3,110 字符;ScaleDown 调用失败时中间件保留原历史、Agent 继续运行
  • OpenRouter 上 Extract / Summarize 输入 $0.04/百万 token、1M 上下文,Summarize 最多输出 4,000 token,二者均不支持 tools 与 response_format(OpenRouter)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ ScaleDown Classify-1⚡ ScaleDown Extract⚡ ScaleDown Summarize⚡ ScaleDown Compress🤖 LangChain Deep Agents🌐 ScaleDown🌐 LangChain🌐 OpenRouter

微软发布 Microsoft-Decision-1 决策模型:基于 Qwen3.5-9B 后训练,输入 $0.042/百万 Token、输出免费,已上 Foundry 与 OpenRouter

微软 10 月 9 日发布首个自研决策模型 Microsoft-Decision-1:不生成文本,而是对给定选项输出校准概率,面向路由、分类、校验、Agent 护栏与 AI 评审。官方称其在 36 项盲测基准上准确率最高、P50 延迟约为 GPT-6 Sol 的 1/35,扰动下决策翻转率 1.3%;已在 Microsoft Foundry、OpenRouter 可用,32K 上下文。

微软发布 Microsoft-Decision-1 决策模型:基于 Qwen3.5-9B 后训练,输入 $0.042/百万 Token、输出免费,已上 Foundry 与 OpenRouter

核心要点速览

  • 价格:输入 $0.042/百万 Token、输出 $0,32,768 Token 上下文(OpenRouter 模型页)
  • 官方口径:36 项训练盲测基准、近 15 万题准确率第一;比第二名 H2O-Lightning-4B v1.1 快 2.5 倍,比 GPT-6 Sol 快 35 倍(微软博客)
  • 鲁棒性:同一请求做 8 类扰动,平均决策翻转率 1.3%,选项改写/倒序/打乱时为 0 次翻转
  • 底座:由 Qwen3.5-9B 后训练为单次前向打分,微软称后续将换到 MAI 与 OpenAI 底座
  • 内部实测:Xbox Research 标注 1 万+ 条反馈,质量接近 GPT-6 Sol,速度快 14 倍以上、成本低约 200 倍(厂商口径)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Microsoft-Decision-1⚡ Qwen3.5-9B⚡ GPT-6 Sol🌐 Microsoft🌐 OpenRouter

OpenRouter 上线 Model Router Benchmarks:7 个路由对照 6 项基准的质量、速度与成本

OpenRouter 于 2026-10-02 上线 Model Router Benchmarks:7 个模型路由(Auto、Jev、NVIDIA Switchyard、Unbiased Pareto、Sakana Fugu 等)在 GPQA Diamond、Tau3 Banking、MMMU Pro Vision、SWE Atlas QA、Deep SWE、Terminal Bench 2.1 上对照质量、速度和成本。Router Index 默认质量 60% / 时间 20% / 成本 20%。openrouter/pareto-code 与 Fusion 不在这张榜上。

OpenRouter 上线 Model Router Benchmarks:7 个路由对照 6 项基准的质量、速度与成本

核心要点速览

  • 官宣:@OpenRouter 2026-10-02 22:08 UTC;博文 Model Router Benchmarks(Brian Thomas,10/2/2026);页面 openrouter.ai/benchmarks/routers
  • 七个路由 slug:openrouter/auto、typesafe/jev-router、nvidia/switchyard、unbiased/pareto、sakana/fugu-max、sakana/fugu-ultra、sakana/fugu-ultra-v2。openrouter/pareto-code 与 Fusion 未入榜
  • Router Index 默认质量 60% / 时间 20% / 成本 20%(0–10,可调权重),不等于原始正确率
  • 公开 stats(2026-10-04 SGT):Deep SWE 113 题,Switchyard Flash+Opus 5.5 与只走 Opus 5.5 均为 83/113(约 $279 / $285);Flash+GPT-6 Sol 74/113、约 $55
  • Terminal Bench 2.1(89 题):GPT-6 Astra 直连 77/89($66.50),Opus 5.5 74/89($24.00);Pareto 同题量一档 71/89($27.20)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ openrouter/auto⚡ typesafe/jev-router⚡ nvidia/switchyard⚡ unbiased/pareto⚡ sakana/fugu-ultra-v2⚡ openrouter/pareto-code🌐 OpenRouter🌐 NVIDIA🌐 Sakana🌐 TypeSafe🌐 Unbiased