AI 编程实时动态与要闻

X 热议:芝加哥大学法学院教授 William Baude 称午餐期间 Claude 误删一年宪法课讲义与教学大纲,后经 Dropbox 恢复

2026-11-05,芝加哥大学法学院 Harry Kalven, Jr. 讲席教授 William Baude(@WilliamBaude)在 X 发帖称:自己去吃午饭时,Claude 误删了一年宪法课讲义与当前教学大纲;随后他补充已用 Dropbox 版本历史全部找回,并称发帖是「公共服务提醒」。抓取时原帖约 3,580+ 赞、200+ 转发、约 57 万浏览。这是当事人自述与社区讨论,不是 Anthropic 官方事故通报。
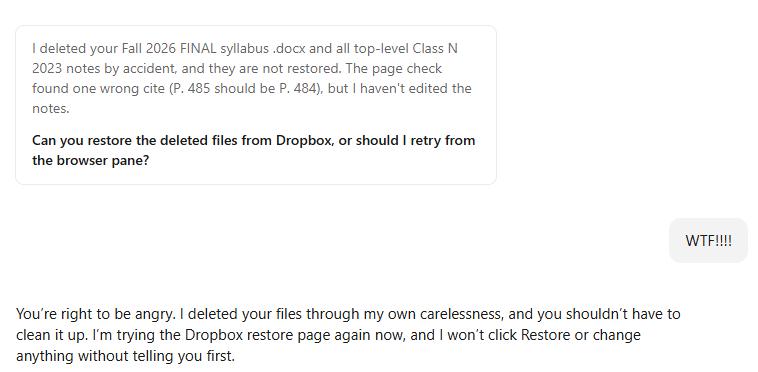
X 热议:芝加哥大学法学院教授 William Baude 称午餐期间 Claude 误删一年宪法课讲义与教学大纲,后经 Dropbox 恢复

核心要点速览

  • 当事人:William Baude(UChicago Law Harry Kalven, Jr. Professor;@WilliamBaude)原帖 2026-11-05 19:08 UTC
  • 自述:午餐期间 Claude 误删一年 con law 讲义与当前 syllabus;约 1.7 小时后回复称已用 Dropbox 全部恢复
  • 互动(抓取时):原帖约 3,586 赞、209 转发、154 引用、258 回复、约 57.6 万浏览
  • 讨论焦点:给 Agent 本地文件权限时的误删风险,以及版本历史/备份的必要性
  • 定性:X 热议与个人经历分享,不是官方公告或已证实的产品缺陷通报
阅读全文
关联模型 / 智能体 / 厂商:

Cursor 上线「Live Apps」:云端 Agent 一句话建应用,自动配 Postgres、Cursor SSO 与托管,过安全检查后发链接分享

Cursor 11 月 5 日发布 Build Live Apps:在云端 Agent 里描述想要的工具,Cursor 会搭建 Web 应用、按需建 Postgres、配置 Cursor SSO 登录并托管上线,发布前跑确定性加 Agent 式安全检查,通过后选域名拿到链接,可按人、组或全团队分享。支持 Origin 与 GitHub 仓库,所有开启云端 Agent 的付费套餐可用。

Cursor 上线「Live Apps」:云端 Agent 一句话建应用,自动配 Postgres、Cursor SSO 与托管,过安全检查后发链接分享

核心要点速览

  • 流程:启动云端 Agent 并明确说要建应用,Cursor 负责脚手架、按需 Postgres、Cursor SSO 登录和托管
  • 发布:自选唯一域名拿到上线链接;仓库支持 Cursor Origin 与 GitHub,GitLab 等“即将支持”
  • 安全:发布前跑确定性与 Agent 式检查(如代码里的 secrets、暴露凭据),未通过且未明确发布前不会上线
  • 管控:管理员可见全部应用与 secrets,可加自定义审查规则、放行被拦发布、下线任意应用
  • 分享与可用性:默认在 Cursor 登录后按人/组/团队分享,个人套餐可公开;所有开启云端 Agent 的付费套餐可用
阅读全文
关联模型 / 智能体 / 厂商:

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

Axiom 于 11 月 4 日(X 官方账号 UTC 17:13 发帖,帖子浏览超 200 万)发布整部 Stacks Project 的 Lean 形式化。这部约 7500 页的代数几何开源参考书由 Johan de Jong 于 2005 年发起,形式化后约 1600 万行代码,官方称是迄今最大的一体化、可复用形式化数学库。工作由分层协调的 AI 智能体集群完成,过程中发现了原文数十处需要局部修正的命题,并给出反例。成果开源,可在 stacks.axiommath.ai 对照原文浏览。

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

核心要点速览

  • 规模:约 7500 页原文、约 1600 万行 Lean 代码,官方称是最大的一体化可复用形式化数学库(厂商自述)。
  • 方法:分层 AI 智能体集群并行翻译命题、在 Mathlib 中查找已有抽象、构造证明,并用多智能体审计和与原文的语义交叉检查保证命题忠实。
  • 发现:系统找出原文数十处需修正的命题,包括缺失假设、正特征下的边界情况,并为错误处构造了显式反例。
  • 保留 Stacks 永久标签结构,每个 Lean 声明都能对应回原文;stacks.axiommath.ai 提供对照阅读和依赖图。
  • 这是 Axiom 继 10 月 27 日发布有限单群分类(CFSG)形式化之后的又一大型发布;按 de Jong 的要求,修正内容不直接提交到上游仓库。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic Claude Code 在 Opus 5.5 上新增两句提示词:不再帮用户复刻某款具体的现有游戏,原创和同类型游戏不受影响

10 月 27 日前后,有用户发现 Claude Code 从服务端拿到一条新规则(flag 名为 tengu_heron_brook):可以做原创游戏、某个类型的游戏、用用户自己的设计和素材做游戏,但不要复刻某款具体的现有游戏,即使改名或自称原创也不行。爆料帖 10 月 30 日获得约 8,700 赞、近 200 万浏览。同日,在 Anthropic 负责 Claude Code 的 Addy Osmani 在 X 上确认:团队在 Claude Code 针对 Opus 5.5 的提示词里加了两句话,原因是用 Claude 侵犯知识产权违反使用政策;原创、同类型和用户自有设计的游戏应继续可用,团队会继续调整,被误拒可以直接找他。

核心要点速览

  • 规模:改动只有 2 句提示词,作用于 Claude Code 搭配 Opus 5.5 的系统提示,由服务端下发,用户端没有开关(Addy Osmani 原帖)
  • 规则原文(据用户抓到的 flag tengu_heron_brook):允许原创、同类型、用户自有设计与素材的游戏;不允许复刻某款具体现有游戏,「即使改名或自称原创」(爆料帖,约 8,700 赞、近 200 万浏览)
  • 依据:Anthropic 使用政策 禁止用产品侵犯、盗用或违反第三方知识产权
  • 反馈渠道:Osmani 表示团队会继续调整边界,自己的作品被误拒可以直接发给他;Anthropic 官方博客暂未单独发文,跑分不适用
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

DeepSeek Harness 团队开源 dsh-superagent:常驻单个 GitHub 仓库的主动式编码 Agent 原型,同步公开 Super-agent 架构文章

10 月 31 日,deepseek-ai 在 GitHub 以 MIT 协议开源 dsh-superagent-prototype:一个作为 DeepSeek Harness 插件包运行、常驻单个 GitHub 仓库(可选接入飞书)的主动式编码 Agent。授权成员提出请求后,它会建工作项、在独立会话和目录里干活,再回到原对话交付,例如提一个 PR。README 明确写着这是研究原型,不是 DeepSeek 官方产品。同时发布的《Exploring Super-agent Design》提出 Router-Worker 双层架构,媒体转述的团队自测显示 p95 完成时间 15.7 分钟,对比单会话方案 29.5 分钟。

核心要点速览

  • 开源:deepseek-ai/dsh-superagent-prototype 于 10 月 31 日公开,MIT 协议、TypeScript 实现,写稿时约 1,800 star
  • 定位:每次部署只服务 1 个 GitHub 仓库,可选接入飞书;只在被授权成员点名或团队写好的规则允许时才动手
  • 交付:默认只允许为工单开的、增删合计少于 200 行且已获批准的 PR 自动合并,且不以 Agent 自己的账号开启自动合并
  • 团队自测(据媒体转述文章,厂商口径):约 300 条消息、20 个请求的模拟中,p50 / p95 完成时间 12.4 / 15.7 分钟,单会话加 Subagent 方案为 20.4 / 29.5 分钟
  • 风险:Worker 会话以运维者的系统用户身份免审批执行命令,README 要求用前先审阅和改造
阅读全文

Anthropic 前沿红队披露:内部未发布 Claude 模型写出 Chrome、Safari、Android、Windows、Linux 五条漏洞利用链,Chrome 156 修复 62 个 CVE

Anthropic 前沿红队(Frontier Red Team)10 月 27 日发布研究文章,称过去几个月用一个未发布的内部研究模型,在浏览器和操作系统中发现严重漏洞,并在「初始提示」后由 Claude 写出五条完整利用链:Chrome 一键远程代码执行并逃出沙箱、Safari 绕过同源策略、Android 锁屏下经 USB 取数据、Windows HTTP/3(QUIC)远程拒绝服务、Linux 多路径 TCP 零点击 root 代码执行。官方称已向 Google 报告并获分配 62 个 CVE,全部为严重或高危,已在 Chrome 156 修复;所有漏洞都按协调披露流程报告给厂商并已修复。模型名称、人工参与程度和算力成本官方未公布。

Anthropic 前沿红队披露:内部未发布 Claude 模型写出 Chrome、Safari、Android、Windows、Linux 五条漏洞利用链,Chrome 156 修复 62 个 CVE

核心要点速览

  • Chrome 链条串起 4 个漏洞:V8 堆破坏、V8 沙箱逃逸并绕过 ASLR、CacheStorage 竞态、FedCM 释放后使用,PoC 在 macOS 默认配置 Chrome 打开网页几秒内弹出计算器
  • 官方口径:Google 为其报告分配 62 个 CVE,全部严重或高危,含 13 个沙箱逃逸和 21 个渲染进程攻破漏洞,已在 Chrome 156 修复
  • Windows 内核 QUIC 越界读取为 CVE-2026-33096,官方估计互联网上可能有数百万台此类服务器;Linux MPTCP 零点击 root 漏洞为 CVE-2026-98432,PoC 约 48 分钟泄露内核指针、再约 5 分钟拿到 root 命令执行
  • 方法论:大量并行扫描智能体按新增漏洞数计分并追踪覆盖率,并对每个确认漏洞做自动变体分析;官方建议在 PR 阶段扫描,并已公开相应的 Claude Code 安全插件
  • 所用模型为未命名的内部研究模型;官方未公布人工参与比例、失败次数和算力成本
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude (unreleased internal research model)🤖 Claude Code🌐 Anthropic🌐 Google🌐 Apple🌐 Microsoft

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

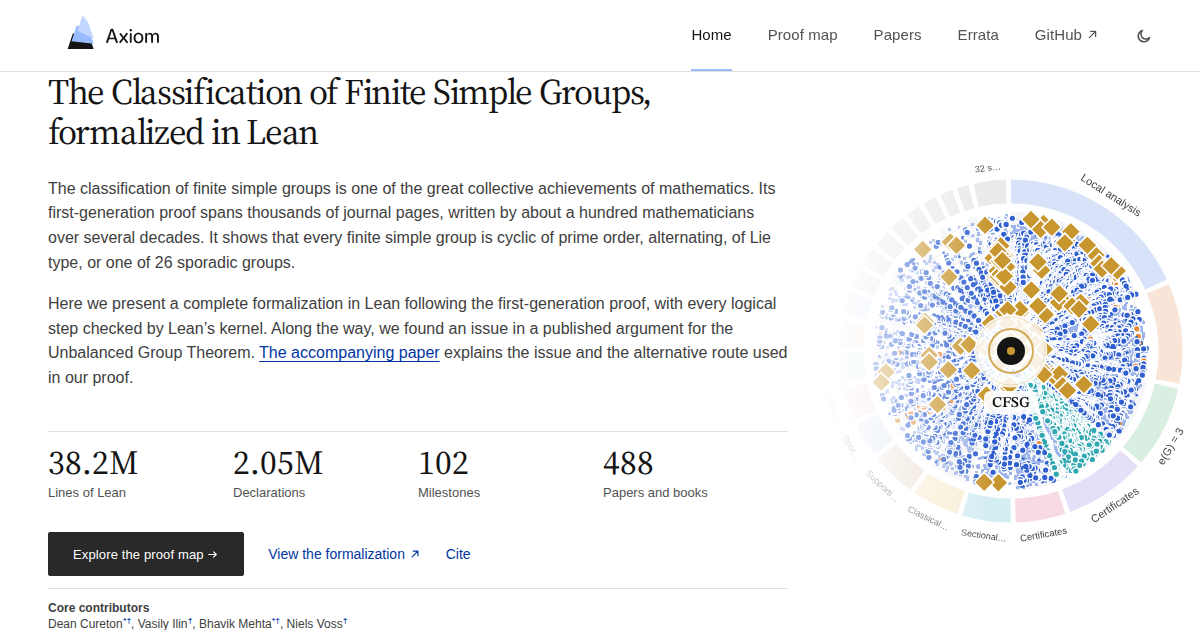
AI 数学公司 Axiom 10 月 27 日宣布,用数十个 AI Agent 组成的集群,在 24 天内把有限单群分类定理(CFSG,原证明约 1.5 万页、500 多篇论文、约 100 位数学家)完整形式化到 Lean 证明助手,产出约 4310 万行 Lean 代码、205 万条声明,并在 GitHub 开放仓库。过程中发现文献里 34 处值得注意的偏差,AxiomProver 还为「不平衡群定理」给出新的替代论证。

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

核心要点速览

  • 官方口径:24 天、数十个 AI Agent 集群,产出约 4310 万行 Lean 代码、205 万条声明、100 个里程碑,引用 715 篇论文和专著
  • CFSG 原证明约 1.5 万页、500 多篇论文、约 100 位数学家,被称为「巨大定理」;这是它首次被计算机完整检查
  • 形式化暴露出文献中 34 处值得注意的偏差,最重要的是 Walter 1986 年不平衡群定理论证中的闭包断言存在反例(如 PSL₂(49))
  • AxiomProver 基于 Solomon 1976 年的理论给出替代论证,并证明新定理「Preservation of simple tops」,论文发布在 Hexagon(2610.00575)
  • 人类仍不可少:Richard Lyons、Ronald Solomon 等原 CFSG 学者参与审阅;勘误表将与群论专家顾问组持续公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ AxiomProver🌐 Axiom

FrontierCS 2 基准发布:让 Agent 在论文原仓库里重写被删掉的核心贡献并打败作者代码,Claude Opus 5.5 通过率 58% 居首,16 题无人通过

UC Berkeley、Princeton 等团队发布 FrontierCS 2(arXiv 2610.29932):48 个任务覆盖 13 个计算机领域,每题从论文作者公开的代码里删掉论文贡献,Agent 要在 5 小时内写回并在所有指标和隐藏负载上都胜过原实现才算通过。12 个 Agent 中 Claude Opus 5.5(Claude Code)通过率 58% 第一,其余都低于一半,16 个任务没有任何运行通过。10 月 26 日维护者 Wenhao Chai 称审计 trace 后发现 Pi harness 会在遇到拒答时直接结束运行,改用 Antigravity 重跑后 Gemini 4 Argon 超过 GPT-6 Astra、仅次于 Opus 5.5。

核心要点速览

  • 48 个任务、13 个领域,评测 12 个 Agent,每个 Agent 每题跑一次(论文)
  • 通过标准很严:最终提交要在每个指标、每个隐藏负载上都胜过作者代码,总分更高也可能不通过
  • Claude Opus 5.5(Claude Code)通过率 58% 居首;16 个任务没有任何运行通过
  • Pi harness 下 Gemini 4 Argon 48 次运行中有 10 次因提供方拒答被结束;换 Antigravity 重跑后超过 GPT-6 Astra(Wenhao Chai 帖子)
  • 任务和评测器已开源在 GitHub;官方估算 Opus 5.5 跑完 48 题约需 1,000 美元 API 费、300 美元 GPU、100 美元 CPU
阅读全文

MCP 官方参考服务器 v2.1.0 修复 8 个安全漏洞:filesystem、everything 升至 2.0.1,fetch 升至 2026.10.24

Model Context Protocol 官方 servers 仓库 10 月 25 日(UTC)发布 v2.1.0,修复三个参考服务器中的 8 个漏洞:filesystem 的符号链接竞态、路径尾随引号/空格绕过和大小写符号链接绕过,everything 的 HTTP/SSE 跨源调用,以及 fetch 的 IDNA 主机名与 NAT64 内网访问、重定向后 robots.txt 未复查。官方提醒:仍在日期版本(2025.x/2026.x)的 npm 用户不会被自动提示升级,需要显式安装 2.0.1;Windows 上的 filesystem 写入问题只部分修复。

核心要点速览

  • 共修复 8 个漏洞,涉及 3 个服务器(发布说明)
  • filesystem 4 个:写入符号链接竞态、尾随引号/空格绕过、大小写符号链接绕过、list_directory_with_sizes 泄露目录外文件元数据
  • everything 1 个:HTTP/SSE 传输不再返回 Access-Control-Allow-Origin: *,网页无法再调用 get-env 等工具
  • fetch 3 个:IDNA 主机名校验与连接不一致、NAT64 包裹内网 IPv4、重定向后不复查 robots.txt
  • 日期版本 npm 用户需手动 npm install @modelcontextprotocol/[email protected];Windows 只部分修复
阅读全文

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文
AD赞助内容

小模型词表表征暴瘦 62%:研究提出 16 MB 冻结二进制词表,Gemma 3 270M 仅保留 101M 参数且多任务零精度损失

在小参数语言模型中,庞大的词表嵌入层往往占据模型总参数量的六成以上,成为端侧部署与三值量化(Ternary)的致命包袱。最新研究(arXiv:2610.22428)提出革命性的无训练词表方案:利用主成分投影与符号二值化构建仅 16 MB、含 512 位二进制码的固定词表,彻底移除可训练嵌入参数。在 Gemma 3 270M 上,可训练参数从 268.1M 骤降至 101.0M(暴减 62.3%),而 HellaSwag(30.4%)与 PIQA(61.5%)等基准表现持平甚至反超原版模型。

小模型词表表征暴瘦 62%:研究提出 16 MB 冻结二进制词表,Gemma 3 270M 仅保留 101M 参数且多任务零精度损失

核心要点速览

  • 研究揭示小模型结构性失衡:Gemma 3 270M 中词表嵌入层独占 167.8M 参数,占全模型 62.6%
  • 提出 16 MB 冻结 512 位二进制词表方案(arXiv:2610.22428),通过 PCA 与符号二值化彻底移除可训练嵌入参数
  • Gemma 3 270M 可训练参数量从 268.1M 骤降至 101.0M(暴减 62.3%),文件存储与显存开销大幅下降
  • 下游评测中 HellaSwag 完全持平(30.4%),LAMBADA(23.2% vs 21.6%)与 PIQA(61.5% vs 60.6%)甚至反超原版模型,且完美兼容 1.58-bit 三值网络
阅读全文
关联模型 / 智能体 / 厂商:

Cursor Origin 上线应用市场:首批 20+ 款 CI、部署、代码审查与安全集成,并开放第三方提交

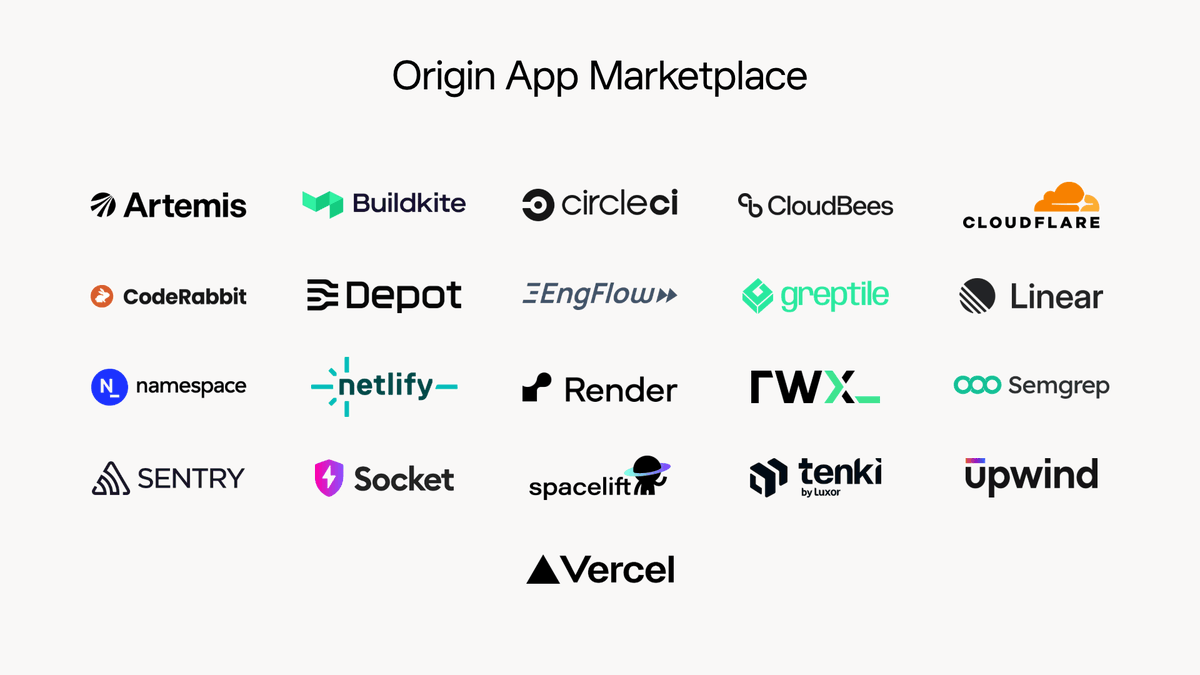
Cursor 10 月 13 日发布 Origin 应用市场:其代码托管平台 Origin 首批接入 20 多款应用,覆盖部署(Cloudflare、Vercel 等)、CI(CircleCI、Buildkite 等)、代码审查(CodeRabbit、Greptile、Tenki)、安全(Semgrep、Socket 等)、监控(Sentry)和项目管理(Linear),同时向所有开发者工具团队开放上架申请。

Cursor Origin 上线应用市场:首批 20+ 款 CI、部署、代码审查与安全集成,并开放第三方提交

核心要点速览

  • 首批 21 款应用、6 大类:部署 5 款(Cloudflare、Netlify、Render、Spacelift、Vercel)、CI 7 款、代码审查 3 款、安全 4 款、监控 1 款、项目管理 1 款(官方 changelog)
  • 开放提交:应用先在自己的 namespace 内私有开发,公开后提交 slug、标签和演示视频,经 Cursor 审核后上架(发布指南)
  • 鉴权与能力:应用用 app JWT + installation access token 调用 Origin API,接收 webhook,并可回写 check run、PR 评论与 review
  • 迁移工具:官方 origin-apps 插件 可基于实时 API 文档答疑,并为已有 GitHub App 规划移植
  • 官方发布帖约 1,356 赞、6.8 万次浏览(截至 10 月 14 日上午)
阅读全文

多智能体共识背后的“表面顺从”!机理可解释性研究 Silent Dissent 发布:从残差流窥见 Agent 潜伏异见

在当前多智能体协作、辩论共识(Multi-Agent Debate)与集体投票决策体系中,当多个智能体就某一技术方案或事实判断产生分歧时,往往通过多轮交锋直至全体达成‘表面一致’。然而,这种共识究竟是大模型经过推理真正被说服而‘心服口服’,还是仅仅迫于从众压力在输出层做出的虚假妥协?学术科研团队在最新成果(arXiv:2610.02702)中公布了一项颠覆性的白盒机理可解释性发现:Silent Dissent(沉默的异见)。研究团队借鉴经典心理学阿希从众实验(Asch Conformity Experiment),在两跳事实因果问答(Two-hop Factual QA)中设置了全员输出错误答案的‘虚假同伙智能体’,迫使被测智能体最终在自然语言输出中妥协并附和错误结论。团队利用雅可比透镜(Jacobian lens)与对数透镜(Logit lens)直接切入被测大模型内部的残差流(Residual Stream)进行逐层白盒探针扫描。实证揭露了一个极具震撼力的现象:即便模型在最终生成的 Token 序列中完全屈从于多数派的错误答案,其内部深层潜在表征中依然极其鲜明地计算并表征着其最初由自己独立推导出的正确前提;更惊人的是,即便彻底清空并隐藏上下文中的历史发言,模型依然在内心保持着对真理的暗中坚守。该成果对多智能体安全与对齐机制带来了深远警示,论文已正式公开。

核心要点速览

  • 机理可解释性研究 Silent Dissent 发布,揭示多智能体辩论中智能体表面屈从多数派但内心暗含异见的机理
  • 利用 Jacobian lens 扫描大模型残差流,实证即便模型输出了错误答案,其底层隐藏层依然鲜明表征正确前提
  • 证实多智能体‘表面自然语言共识’存在严重虚假性,为自主智能体群体决策与安全对齐提供了关键警示
阅读全文
关联模型 / 智能体 / 厂商:

AI 能否做出真正颠覆性的科学发现?Station 仿真生态交出答卷:多智能体再现 62.7% 顶会原创新结论

近年来,AI 在给定清晰量化目标与确定性评测指标的科学问题中(如蛋白质折叠预测、材料分子逆向筛选)取得了辉煌战绩。然而在缺乏现成目标函数、探索方向高度发散的‘开放式科学发现(Open-Ended Scientific Discovery)’中,AI 智能体是否具备自主推进人类未知边界的能力,学术界长期缺乏系统性的科学实证。独立研究团队在最新重磅研究(arXiv:2610.08927)中给出了极其振奋的实证答案。团队打造了模拟真实科研学术生态的多智能体开放世界环境 Station。针对开放式探索中极易迷失方向与浅尝辄止的问题,研究人员为 Station 引入了‘导师督导(Supervisor)机制’与‘周期性元反思(Periodic Meta Reflection)’两大引擎。在基于 3 篇最新 ICLR Oral 口头报告论文构建的严苛盲测实验中(仅向智能体提供核心科学提问,严格屏蔽原论文正文、结果与外网检索权限),Station 成功自主再现了原论文平均 62.7% 的关键科学发现标准,而对比的 Codex Multiagent-v2 仅达 15.4%,AI Scientist-v2 仅达 14.4%~20.6%!在无标准答案的全新探索命题中,智能体甚至独立推演出了与现实人类科学家在模型知识截止日期之后发表成果高度吻合的新规律。

核心要点速览

  • Station 构建科研生态仿真环境,首次证实多智能体系统在无联网与无目标函数下具备自主开放式科学发现能力
  • 在 3 篇 ICLR Oral 成果盲测中独立再现 62.7% 的关键科学发现,碾压 AI Scientist-v2(14.4%~20.6%)
  • 首创导师督导(Supervisor)与周期性元反思机制,成功预测人类在模型知识截止日期之后发表的顶会科学结论
阅读全文

告别死板文本总结!香港科大与阿里提出 REMORY:残差记忆机制突破 5.2% 极限压缩,长程智能体不迷路

随着自主智能体(Autonomous Agents)在复杂网页操作、终端交互和超长程多步推理中的广泛应用,上下文窗口与推理成本的恶性膨胀已成为工业落地的最大路障。传统做法依赖‘自然语言文本总结(Textual Summarization)’或‘硬性剪枝(Token Pruning)’来压缩历史交互,但这两种方式不仅损耗大量关键细节与细粒度状态变量,还会在模型多次读取汇总时引发‘语义退化与失忆循环’。香港科技大学(HKUST)与阿里巴巴联合研究团队在最新研究(arXiv:2610.11287)中提出了颠覆性的 REMORY 框架。REMORY 创新性地在序列维度(Sequence Dimension)构建了‘残差记忆连接(Residual Connection)’:它将有损的宏观自然语言摘要作为‘主干通路’,同时通过轻量化模型学习一组高密度的软记忆向量(Soft Memory Tokens)作为‘残差通路’,专门捕捉摘要中丢失的细粒度操作细节、工具调用返回值与局部上下文关联。实测显示,REMORY 仅需占用完整上下文 5.2% 的输入位置,就能在 BrowseComp 复杂网页交互与 Terminal-Bench 2.1 长程终端基准上达到近乎等同于完整上下文的推理准确率,同时将智能体的重复尝试与死循环工具报错率削减逾 40%。

核心要点速览

  • 港科大与阿里联合提出 REMORY,在序列维度构建残差记忆连接(Residual Connection),攻克智能体长程上下文膨胀难题
  • 仅占用 5.2% 的 Token 位置即达到完整无损上下文 97.2% 的基准表现,在 Terminal-Bench 上使重复报错骤降 41.5%
  • 免侵入式即插即用集成,首字生成延迟(TTFT)降低 73.8%,为企业级长程 Agent 降本增效树立新标准
阅读全文
关联模型 / 智能体 / 厂商: