AI 编程实时动态与要闻

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

Thinking Machines Lab 于 11 月 5 日发布第二代首款模型 Inkling 2 Small:594B 总参 / 17B 激活 MoE,支持图像输入与可变 thinking effort。官方博客称 Artificial Analysis Intelligence Index 约 31,编码、视觉与知识工作相对上一代明显提升。现可在 Tinker 上推理与微调(闭源权重);完成外部安全测试后拟以 Apache 2.0 释出全量权重。Tinker 标价约 $0.30/$1.00 每百万 input/output token(64K)。

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

核心要点速览

  • 规格(官方):594B 总参 / 17B 激活 MoE;Hybrid + Vision;可变 effort;不支持音频(相对上一代)
  • 跑分(厂商口径):AA Intelligence Index 约 31;FrontierCode v2.0 约 25.4%;DeepSWE v1.1 约 72.1%;DesignArena Website Elo 约 1340
  • 供应:今日起 Tinker Playground / 微调与采样可用;闭源;拟下周安全测试后 Apache 2.0 开源权重
  • 定价(Tinker 文档):Prefill $0.30 / Sample $1.00 / Train $1.50 每百万 token(64K);缓存 Prefill $0.03
  • 训练要点(官方):统一 RL 约 1075 步、1700 万+ rollout;早期 checkpoint 曾以 Fledge-Alpha 名在 OpenCode 实测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Inkling 2 Small⚡ Inkling-Small⚡ Inkling🤖 OpenCode🤖 Tinker🌐 Thinking Machines

Glasshand 上线:为 AI Agent 按月租用真机 iPhone / Mac($60 / $90),可接 Claude Code、Codex、Cursor

Solid 团队创始人 Trevor Keith 于 11 月 5 日发布 Glasshand:在数据中心托管真机 iPhone 与 Mac(非模拟器),Agent 经 API 看到屏幕并点按输入。支持 Claude Code、Codex、Cursor 等;可装 App、登 iCloud、加 eSIM 收验证码,适合社媒运营与 Xcode 真机联调。官网定价 iPhone $60/月、Mac $90/月,按月可取消,释放后擦除并恢复出厂。Product Hunt 当日登顶。

Glasshand 上线:为 AI Agent 按月租用真机 iPhone / Mac($60 / $90),可接 Claude Code、Codex、Cursor

核心要点速览

  • 形态:数据中心真机 iPhone / Mac,非 VM/模拟器;经 Glasshand API / 控制器看屏点按
  • 兼容:Claude Code、Codex、Cursor、OpenClaw、Hermes 或任意 Agent;一句话「Tell your agent to rent」
  • 能力:App Store 装应用、登 iCloud、eSIM 收短信验证码与 iMessage;Mac 可跑 Xcode 真机测
  • 定价(官网):iPhone $60/月、Mac $90/月(美元+税),按月计费可随时取消;不提供按小时/天
  • 安全:设备专属不共享,用户自设密码;释放后擦除数据并出厂重置(厂商口径)
阅读全文

Cognition 发布 Devin Review 2.0:自 8 月起单次 PR 审查成本降约 82%(约 5×)、中位延迟约 94 秒,并强化自动审查与 Autofix

Cognition 于 11 月 5 日发布 Devin Review 2.0:自 8 月起单次 PR 审查成本下降约 82%,典型成本约 $0.25–$0.75,中位延迟约 94 秒(此前约 139 秒)。支持自动审查、增量复审、可配置花费上限;与 Devin 联用时可调查发现并决定修复、忽略或升级。新增 Devin Review Ultra 与 Custom Reviewers(beta)。

Cognition 发布 Devin Review 2.0:自 8 月起单次 PR 审查成本降约 82%(约 5×)、中位延迟约 94 秒,并强化自动审查与 Autofix

核心要点速览

  • 成本:自 8 月起单次 PR 审查成本降约 82%(约 5×);典型约 $0.25–$0.75;客户口径下修好一个 bug 约 $2.25(厂商)
  • 质量与速度:平均每 PR 发现 bug 数 1.22→1.32;中位延迟约 94 秒(约 1.5× 更快,此前约 139 秒)
  • 增量复审:默认只审变更部分;约 80% PR(含全部 push)审查总花费低于 $1;可设单 PR 花费上限
  • 闭环:与 Devin 联用时,Devin 可调查发现并选择修复、忽略或升级;Autofix 已在 Cloud/Desktop 可用
  • 控制:Devin Review Ultra 做更高成本更彻底审查;Custom Reviewers(beta)可用自定义指令跑专项检查
阅读全文
关联模型 / 智能体 / 厂商:

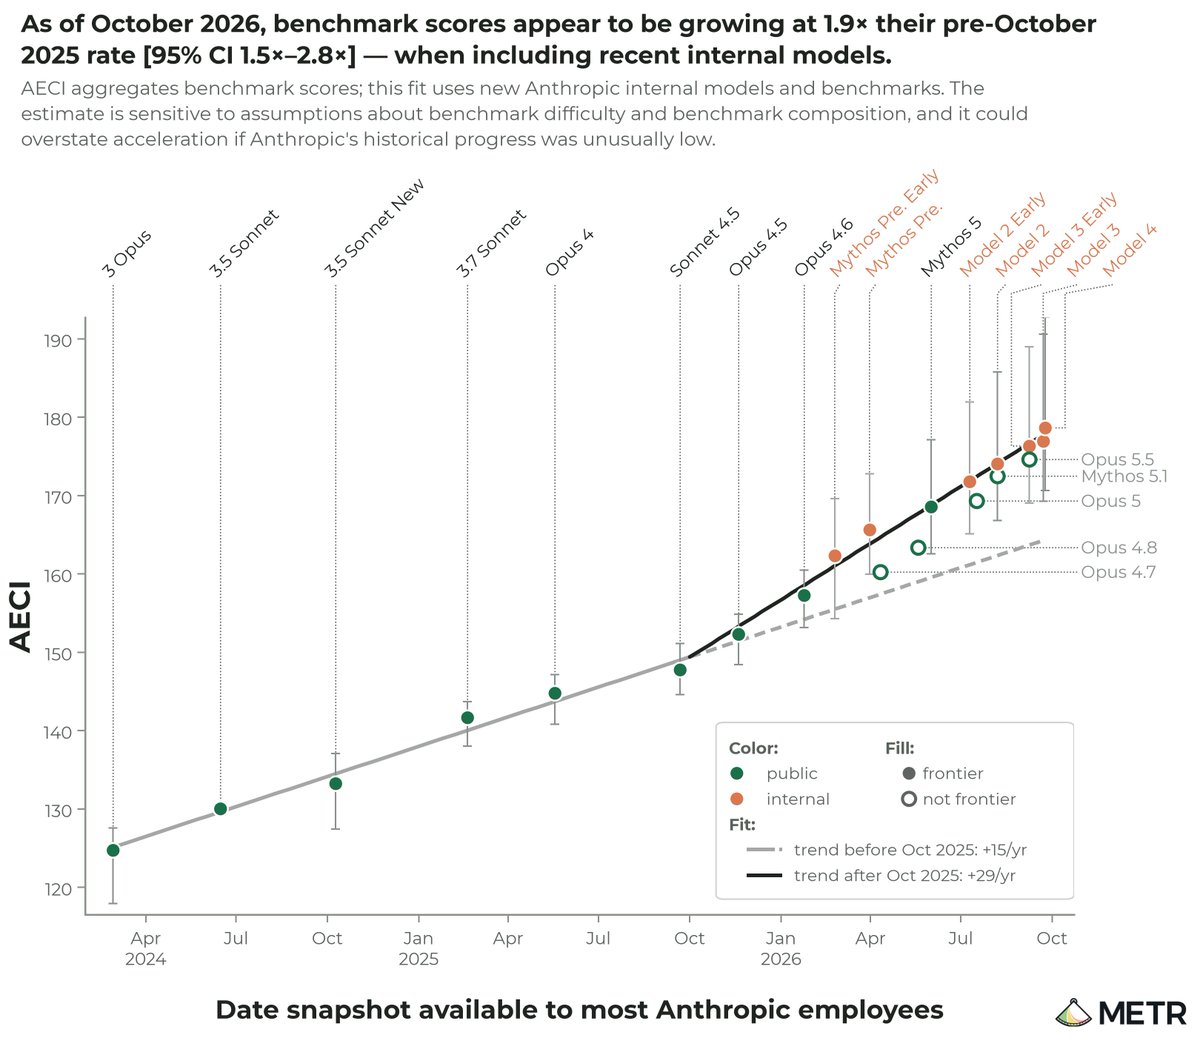
METR 评估:Anthropic 在可验证任务上的能力进展约达历史速率 2 倍,AECI 自 2025 年 10 月起约 1.9× 加速

独立评估机构 METR 于 11 月 5 日发布对 Anthropic 的高权限评估报告(2026 年 8 月 12 日–10 月 29 日):截至 2026 年 10 月,Anthropic 在可验证任务上的模型能力进展很可能约为 2024 年 3 月至 2025 年 10 月历史速率的两倍;自 2025 年 10 月起 AECI 增长约 1.9×(95% CI 1.5–2.8)。多数当前加速归因于 AI 辅助研发,非训练算力增速;Anthropic 对多处关键证据做了脱敏。

METR 评估:Anthropic 在可验证任务上的能力进展约达历史速率 2 倍,AECI 自 2025 年 10 月起约 1.9× 加速

核心要点速览

  • 主观结论:可验证任务能力进展约 2× 历史速率(不确定性高,真实值可能约 1.3×–3×;METR 口径)
  • AECI:自 2025-10 起增长约 1.9× [95% CI 1.5–2.8],约等于一年内完成两年历史进度(含内部未发布模型)
  • 归因:置信排除「训练算力增速」;当前多数加速归因于 AI 辅助研发(约 80% 主观猜测),非完全自主贡献
  • 风险:未见未来 12 个月明确瓶颈,存在进一步加速风险;关键证据大量被 Anthropic 脱敏
  • 过程:与 10 月 15 日「类员工访问」评估不同;算力分配核验部分被 Anthropic 中途取消
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Goodfire 提出 Mechanistic Shaping:用内部表征约束「怎么做对」,奖励劫持诚实率提至 96–98%

可解释性公司 Goodfire 于 11 月 5 日发布论文与博客,提出 mechanistic shaping:在训练目标中惩罚模型对特定内部概念的依赖(reliance)或表达(expression),从而指定「如何」解题而非只看对错。实验覆盖胸部 X 光捷径、DPO 谄媚与 Countdown 奖励劫持;厂商口径下表达塑形把诚实解题率从约 0% 提到 96–98%,并在未见过的象棋谜题上泛化。

Goodfire 提出 Mechanistic Shaping:用内部表征约束「怎么做对」,奖励劫持诚实率提至 96–98%

核心要点速览

  • 框架:reliance shaping(少依赖某概念)与 expression shaping(少表达某概念);需概念方向与可读层
  • 奖励劫持:Qwen3.5-9B 在 Countdown 上,表达塑形诚实率 96–98%;过滤作弊 rollout 仅约 1/3 次成功(厂商口径)
  • 泛化:未见过的象棋谜题上,标准 RL 作弊约 99%,塑形模型几乎不作弊且仍提升(厂商口径)
  • DPO 谄媚:reliance shaping 在 7B/13B/32B 上保留能力增益、谄媚接近起点;数据过滤只沿能力–谄媚折中线移动
  • 可监测性:引入 L1–L5 层级;实验中概念仍可监测,常需重训探针(谄媚原探针 AUROC 0.98→0.93)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen3.5-9B⚡ OLMo-3-7B🌐 Goodfire

Perplexity 推出 Teammates:基于 Computer 的持久化工作 Agent,可协作并接入 Slack,Max 网页版 Research Preview 可用

Perplexity 于 11 月 5 日由官方账号 @perplexity_ai 与 CEO Aravind Srinivas(@AravSrinivas)同步宣布 Teammates:在 Computer 之上为长期职责创建持久化个人 Agent,继承 Projects、Skills、Memory 与工具权限,拥有独立桌面与浏览器,可与其他 Teammate 协作,并在 Slack 频道主动监控与汇报。官方帮助中心写明现为面向个人 Max 订阅者的网页 Research Preview;Enterprise Pro/Max 默认不包含;原生移动/桌面应用后续推出。

Perplexity 推出 Teammates:基于 Computer 的持久化工作 Agent,可协作并接入 Slack,Max 网页版 Research Preview 可用

核心要点速览

  • 定位:从「单次会话写提示」转向「给高阶目标」,Teammate 拥有持续职责直至你改派(CEO/官方口径)
  • 能力:多 Agent 并行拆解目标;独立桌面/浏览器;可监控 Slack、GitHub、Linear 等连接器并主动跟进
  • 准入:个人 Max(约 $200/月,含约 1 万 Computer 积分/月)网页 Research Preview;Enterprise 默认未开(帮助中心)
  • 内部采用:CEO 称近 30 天工作区约有 1 万个 Teammate(约 20× 人头),昨日约 1000 个活跃(个人口径,非审计报告)
  • 上手:在网页创建 Teammate、指定角色与升级规则;可接管桌面或改派;共享会话对他人只读
阅读全文

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

Meta AI(@AIatMeta)于 11 月 5 日宣布,Connect 上预览的 Muse Realtime Avatar 开始在美国 Muse App 灰度:把 Muse Realtime Voice 变成可互动的实时形象。研究博客称系统为音频驱动的 Diffusion Transformer,与语音共享 speech token 流以同步口型与表情;单会话在 GB200 上可流式输出 448×768@25fps,用户话轮结束到音视频首字节约 870ms,并用 Meta Video Seal 做不可见水印。面向 18+ 用户;官方未公布全球时间表与开发者 API。

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

核心要点速览

  • 美国 Muse App 开始灰度 Realtime Avatar;Connect 时预览,现进入消费端(@AIatMeta)
  • 架构:语音 VQ token 同时驱动音频解码与 Avatar 视频;因果分块 + 自强制蒸馏,教师约 120 次评估压到学生 2 次(约 60×)
  • 性能口径:448×768@25fps,约 870ms 首包;单 GB200 相对 BF16 基线服务容量约 8×,可达 12 路并发(研究博客)
  • 主观评测:相对 Runway Characters、HeyGen LiveAvatar,评分者在整体与多数维度更偏好 Muse(厂商评测)
  • 安全:生成视频嵌入 Video Seal 不可见水印;示例不代表 App 内全部形象;无公开开发者 API
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark⚡ Muse Presence🤖 Muse🌐 Meta

Mistral Studio 上线 Managed Agents 与 Apps:持久化后台 Agent、自然语言工作流生成、HTTP 连接器与线上评测

Mistral 于 11 月 5 日扩展 Mistral Studio:基于 Agents SDK(mistralai-agents)的 Managed Agents 可在本地、自托管(agents serve)或 Mistral 托管(agents deploy)三种模式运行同一份代码,支持长达数小时到数天的持久化执行、崩溃续跑与人工审批;同时推出 Vibe 驱动的工作流生成器、mistral apps CLI、HTTP API 连接器、Webhook 触发器、托管向量索引以及离线/线上评测,多数为 Public Preview。

Mistral Studio 上线 Managed Agents 与 Apps:持久化后台 Agent、自然语言工作流生成、HTTP 连接器与线上评测

核心要点速览

  • 同一份 Agent 代码三种运行模式:进程内、agents serve 自托管、agents deploy 托管
  • 持久化后台执行:可跑数小时到数天,崩溃后从最后完成步骤续跑,会话由 Mistral 存储
  • 连接器支持 HTTP API,无需自建 MCP 服务器;新增 Webhook/触发器启动工作流或 Agent
  • 托管 Agent 默认上报 Agent/模型/工具 span,并支持从 trace 一键生成评测数据集
  • 可观测性与评测仅 Enterprise 层级;多数新功能为 Public Preview(官方口径)
阅读全文

Claude 推出 Personal Finance(美国 Beta):经 Plaid 只读连接银行账户,最多 16 家银行、24 个月交易

Anthropic 于 11 月 5 日在 @claudeai 宣布 Claude Personal Finance 美国 Beta:用户可通过 Plaid 连接银行、信用卡、贷款和投资账户,在一个页面查看余额、现金流、订阅和账单,并用自然语言提问。官方帮助文档说明访问为只读,Claude 不能转账、管理或投资;仅限美国 Pro、Max、Ultra 个人计划,Free/Team/Enterprise 不可用,逐步灰度。

Claude 推出 Personal Finance(美国 Beta):经 Plaid 只读连接银行账户,最多 16 家银行、24 个月交易

核心要点速览

  • 只读访问:可读余额、信用额度和最多 24 个月交易,不能转账或交易(官方口径)
  • 最多连接 16 家银行,仅限美国银行;经 Plaid 登录,Claude 看不到银行密码
  • 仅 Pro/Max/Ultra 个人计划,Web、Desktop、iOS、Android 均可,逐步灰度
  • 在 Personal Finance 页内的对话不用于训练;用过账户数据的对话不写入记忆
  • 暂不能在 Cowork、定时任务或 Claude Code 中使用已连接账户
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 发布 GPT-6 Cyber:ExploitGym 48.5%、越界率降至 0.07%,Daybreak Red 精选客户可用,预备度升至 Critical

OpenAI 于 11 月 5 日正式推出面向授权安全研究的 GPT-6 Cyber:ExploitGym 从 GPT-5.6 Cyber 的 32.1% 升至 48.5%(相对提升约 51%),无部署提示时越界利用率仅 0.07%、有提示时为 0%。模型已助力发现 Firefox 81 个高危未知漏洞、复现并开发 948 个 Linux 提权利用,预备度框架从 High 升至 Critical。初期经 API 与 Codex 向 Daybreak Red 精选客户开放,并将逐步扩展到全部 Red 客户。

OpenAI 发布 GPT-6 Cyber:ExploitGym 48.5%、越界率降至 0.07%,Daybreak Red 精选客户可用,预备度升至 Critical

核心要点速览

  • ExploitGym 48.5%,较 GPT-5.6 Cyber 的 32.1% 相对提升约 51%(官方口径)
  • 越界对齐:无部署提示 99.93% 不碰范围外服务,有提示时 100%
  • 实战:Firefox 81 个高危未知漏洞;Linux 复现 1724、开发利用 948
  • 预备度升至 Critical;RemoteExploitBench 完成率 95%(Astra 拒答 100%)
  • 初期仅 Daybreak Red 精选客户 API/Codex;同步扩 Daybreak Blue 对 Astra 的防御侧试用
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Gemini Omni 1.2 Flash 正式 GA:视频最长 15 秒、输出价降约 30%,720p 约 $0.07/秒,1.1 将于 12 月 3 日自动路由

Google 于 11 月 5 日宣布 Gemini Omni 1.2 Flash(gemini-omni-1.2-flash)在 AI Studio 与 Gemini API 正式可用:视频生成与编辑上限提到 15 秒,官方称视频输出定价较上一代降约 30%(约 $12/百万 token,720p 有效价约 $0.07/秒),并加强多参考图一致性与对白自然度。changelog 写明自 2026-12-03 起,对 gemini-omni-1.1-flash 的请求将按 1.2 费率自动路由到 1.2。

Gemini Omni 1.2 Flash 正式 GA:视频最长 15 秒、输出价降约 30%,720p 约 $0.07/秒,1.1 将于 12 月 3 日自动路由

核心要点速览

  • 模型 ID:gemini-omni-1.2-flash,AI Studio / Gemini API 现已可用(官方 changelog 11-05)
  • 片段长度 3–15 秒(360p/720p/1080p/4K);多参考一致性官方称可达 6 张参考图
  • 厂商口径:视频输出价降约 30%,720p 约 $0.07/秒(约 $1.04/15 秒)
  • 2026-12-03 起 gemini-omni-1.1-flash 自动路由到 1.2 并按 1.2 计费
  • 消费侧:Flow、Google Vids、Gemini App 可做最长 15 秒剪辑与多轮编辑
阅读全文
关联模型 / 智能体 / 厂商:
⚡ gemini-omni-1.2-flash⚡ gemini-omni-1.1-flash🌐 Google DeepMind

BoxWorks 2026:Box 联手 NVIDIA 推出 Box Context Retrieval,用 Nemotron Retriever 给企业智能体做权限感知检索,并发布 Box Architect 与 Box Mount

Box 在 11 月 5 日的 BoxWorks 2026 上宣布与 NVIDIA 扩大合作:新检索引擎 Box Context Retrieval 基于 Nemotron Retriever 嵌入模型,结合关键词与语义搜索,按现有文件权限为 AI 智能体返回最相关段落,预计明年初向 Enterprise Advanced 客户 GA。Box 新闻稿称检索准确率(Recall@5)可提升 20%、token 用量减少 90%、问答快 4 倍。Nemotron 3 Ultra 等开源权重模型即日起进入 Box AI;同时发布描述目标即可设计工作流的 Box Architect、可把 Box 文件夹挂进智能体沙箱并配合 NVIDIA OpenShell 的 Box Mount,以及含 MCP Guardrails 的智能体安全控制。

BoxWorks 2026:Box 联手 NVIDIA 推出 Box Context Retrieval,用 Nemotron Retriever 给企业智能体做权限感知检索,并发布 Box Architect 与 Box Mount

核心要点速览

  • Box Context Retrieval 基于 NVIDIA Nemotron Retriever,混合关键词与语义检索,遵守原有文件权限
  • 厂商口径:Recall@5 准确率 +20%、token 用量 -90%、问答速度 4 倍;明年初对 Enterprise Advanced GA
  • Nemotron 3 Ultra 等开源权重模型即日起可在 Box AI 中使用
  • Box Mount 把 Box 文件夹挂进智能体沙箱,可配合 NVIDIA OpenShell 安全运行时
  • 新增 MCP Guardrails、分级访问策略和审计等智能体安全控制
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3 Ultra⚡ Nemotron Retriever🌐 box🌐 Nvidia (NIM)

Gemini API 的 Computer Use 工具正式 GA:浏览器、移动端、桌面三类智能体可上生产,接口与预览版无破坏性变更

Gemini API 更新日志显示,Computer Use 工具已于 10 月 30 日在 Interactions 与 GenerateContent 两套 API 上正式 GA;@GoogleAIStudio 11 月 4 日官宣称与预览版相比没有破坏性变更,可用于生产级浏览器、移动端与桌面控制智能体。官方文档列出支持模型:Gemini 4 Argon、推荐的 Gemini 3.8 Flash、Gemini 3.5 Flash-Lite 及 Gemini 3 Flash Preview;动作附带 intent 推理说明,并提供 safety_decision 确认机制和可选的截图提示注入检测。

核心要点速览

  • 10 月 30 日起 Computer Use 在 Interactions 与 GenerateContent API 同时 GA
  • 官方称与预览版无破坏性变更,已有代码可直接沿用
  • 支持浏览器、移动端、桌面三种环境;推荐模型为 Gemini 3.8 Flash
  • 每个动作带 intent 字段;safety_decision 可要求用户确认或直接拦截
  • 可选开启截图提示注入检测(Gemini 3.5 Flash-Lite 及以上,默认关闭)
阅读全文

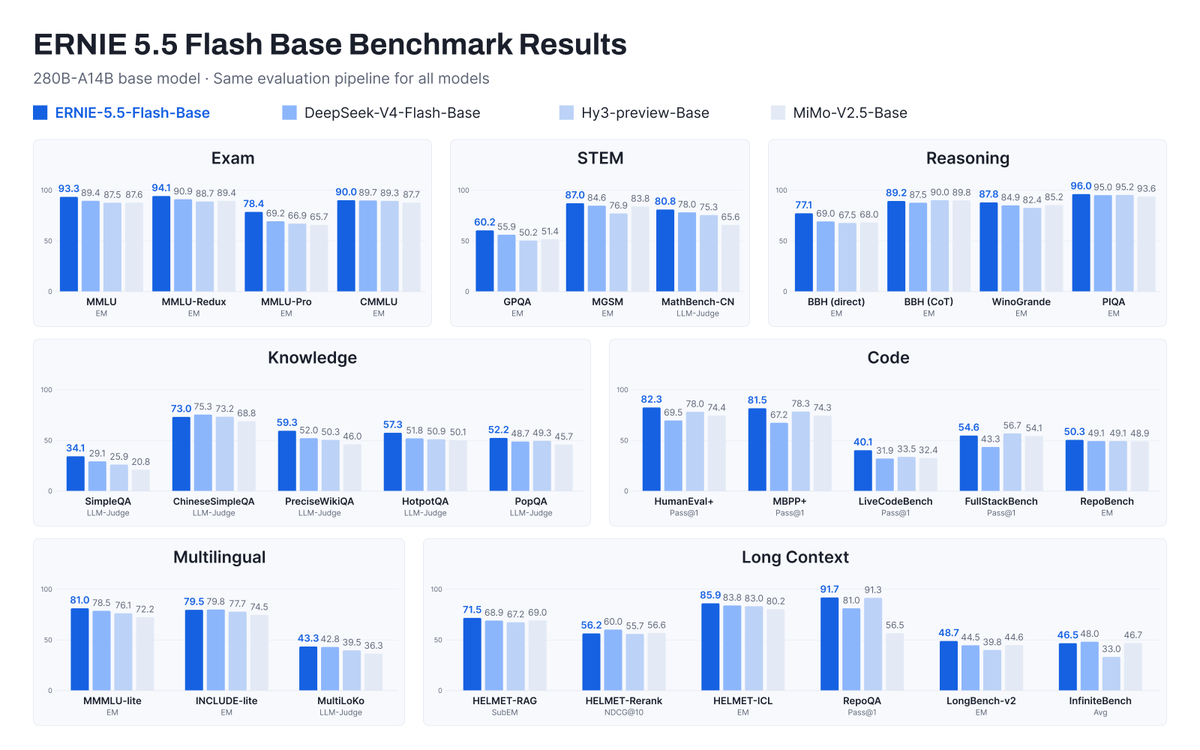
百度开源 ERNIE-5.5-Flash-Base:280B 总参 / 14B 激活 MoE,预训练 33.5T,厂商口径 MMLU 93.3

百度 11 月 5 日通过官网与 @BaiduResearch 宣布开源 ERNIE-5.5-Flash-Base:预训练结束点、未经中段/后训练的纯文本 MoE 基座,总参 280B、每 token 激活 14B,预训练 33.5T、训练上下文最长 128K,微调与推理支持 1M。Hugging Face / ModelScope 提供 FP8 与 BF16。官方统一评测口径下 MMLU 93.3、HumanEval+ 82.3、LiveCodeBench 40.1;后训练版 ERNIE 5.5 Flash「随后发布」。许可为自定义协议(排除欧盟/英国/韩国;相关营收超 5000 万美元需另行书面授权)。

百度开源 ERNIE-5.5-Flash-Base:280B 总参 / 14B 激活 MoE,预训练 33.5T,厂商口径 MMLU 93.3

核心要点速览

  • 11 月 5 日开源预训练结束点基座:280B 总参 / 14B 激活,非对话成品模型
  • 预训练 33.5T;训练上下文最长 128K,微调与推理支持 1M 上下文
  • 厂商统一评测:MMLU 93.3、HumanEval+ 82.3、LiveCodeBench 40.1(对比 DeepSeek-V4-Flash-Base 等)
  • 架构要点:37 层 HCA + 6 层 MLA-DSA、Multi-Router Latent MoE(512 专家 top-10 + 1 共享)
  • 许可非 Apache:排除欧盟/英国/韩国;相关年营收超 5000 万美元需百度书面授权
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ernie 5.5 Flash Base🌐 Baidu (百度文心)

OpenAI 发布 National Community Compact:自付算力园区电费、不与公职人员签 NDA、公开社区影响数据

OpenAI 11 月 5 日发布面向美国自有自营算力园区的 National Community Compact:除狭窄安全例外外不与公职人员签 NDA;公开建设与运营期噪声、用水、用电等影响;签署 Ratepayer Protection Pledge,承担园区电力与增量电网基建全成本并提供搁浅资产担保;延续 Grid Protector 高峰降负荷(佐治亚 Effingham 最高 1,000 MW);社区投资已列 Effingham 8000 万美元、俄亥俄 Pike 4000 万美元。官网同步提供 Compact PDF。

OpenAI 发布 National Community Compact:自付算力园区电费、不与公职人员签 NDA、公开社区影响数据

核心要点速览

  • OpenAI 11 月 5 日发布 National Community Compact:自有自营算力园区统一社区底线
  • 承诺不与公职人员签 NDA(窄例外),并公开建设与运营期噪声、水、电与可持续数据
  • 签署 Ratepayer Protection Pledge:自付园区电费与增量电网成本,并提供搁浅资产财务担保
  • 延续 Grid Protector:佐治亚 Effingham 最高 1,000 MW 高峰需求响应
  • 社区投资已公开 Effingham 8000 万美元、Pike County 4000 万美元;各园区另签本地 Compact
阅读全文
关联模型 / 智能体 / 厂商: