AI 编程实时动态与要闻

Together AI 发布 Together Compiler:智能体持续优化线上推理,最高提速 2.6 倍

Together AI 11 月 4 日发布 Together Compiler(TKCC),用一群 AI 智能体配合常驻推理引擎,按真实流量、模型和硬件持续重写推理内核,并提出「多态推理」(Polymorphic Inference)思路。官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等模型上最高提升 2.6 倍 TPS,客户负载最高快 50%,目前已在生产中服务每天数万亿 token。

核心要点速览

  • Together Compiler 把推理优化从传统编译问题改成「智能体搜索」问题:智能体提出内核改动,常驻引擎验证速度和正确性,只有通过的改动才上线
  • 官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 上最高 2.6 倍 TPS,客户负载最高快 50%
  • InferenceX 低延迟 batch size 1 设置下:MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS(公司自报),SemiAnalysis 称已复核其中一项结果
  • 常驻引擎热加载候选前向计算,上线时间 9 秒(对比重启引擎 467 秒),实验吞吐比基线智能体优化系统高 252 倍
  • 已在 Together 生产环境服务每天数万亿 token,Together 已有 40 多个模型由智能体优化
阅读全文

Artificial Analysis 改用「单任务耗时」作为头号性能指标:GPT-6 Astra 满档约 17 分钟完成一题,快于 Opus 5.5 与 Gemini 4 Carbon

独立评测机构 Artificial Analysis 于 11 月 4 日(UTC 17:34)在 X 上宣布新版 API 性能基准:头号指标从输出速度改为 Time per Task,即完成一道 Intelligence Index 任务所需时间(每题输出 tokens ÷ 端到端输出速度)。新版覆盖约 1,000 个 serverless 端点,速度改为从发出请求算到最后一个 token,并加入多轮 Agent 编码与知识工作负载。官方数据:GPT-6 Astra 满档 51 tokens/s 但约 17 分钟完成一题,Claude Opus 5.5(max)约 26 分钟,Gemini 4 Carbon(high)约 29 分钟。

核心要点速览

  • Time per Task = 每道 Intelligence Index 任务的输出 tokens ÷ 端到端输出速度;逐 token 很快但话多的模型,可能比慢但省 token 的模型更晚完成任务。
  • 端到端输出速度从发出请求算到收到最后一个 token,包含首 token 前的等待(prefill 与隐藏推理);输出 token 改用各家 API 自报数量,不再用 o200k_base 分词器估算。
  • GPT-6 Astra(max)51 tokens/s,每题约 5 万输出 tokens、约 17 分钟;Claude Opus 5.5(max,111 tokens/s)约 26 分钟,Gemini 4 Carbon(high,71 tokens/s)约 29 分钟,后两者每题约 12–17 万 tokens。
  • 按各家 API 默认档(三者均为 medium),GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 的单任务耗时降约 3–5 倍、成本降约 2–4 倍,Intelligence Index 低约 5–11 分;Opus 5.5 从约 26 分钟/10.04 美元降到约 6.8 分钟/2.45 美元。
  • 官方方法论页显示这是 3.0.0 版(10 月 30 日),测试频率改为每 6 小时一次,并新增端点错误率指标。
阅读全文

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

Ricursive Intelligence 于 11 月 4 日(UTC 18:24)发布首个模型 Ripple-65B Preview,并在 Hugging Face 以 Apache 2.0 开源指令版(BF16、NVFP4)和基座版。官方模型卡显示:65B 稠密 Transformer、12T token 预训练、最长 1M 上下文,自报 TerminalBench 2.1 80.5、SWE-bench Pro v2.0 Hard 79.1、DeepSWE 1.1 44.3,在编码 Agent 任务上超过参数大得多的美国开源模型;可在 DGX Spark 等本地硬件运行。CEO Anna Goldie 称成本约为此前同类 SOTA 的十分之一。

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

核心要点速览

  • Ripple-65B Preview 为 65B 稠密模型,80 层、d_model 5120 的“窄而深”结构,从 Olmo 3 基线改为类 Gemma 3N 架构。
  • 预训练 12T token(8K 序列),后训练含中训练、长上下文、SFT 与混合领域 RL,支持最长 1M 上下文。
  • 自报 TerminalBench 2.1 80.5,高于 Reflection Beam 501B(80.1)、Muse Spark Open 816B(76.4);但 SWE-bench Verified 76.5、DeepSWE 1.1 44.3 并非全面领先。
  • 官方称核心团队从 1 人扩到 5 人,代码计算效率相对 Olmo 3 提升 16 倍;2×B200 上约 250 tok/s。
  • Hugging Face 提供 BF16、NVFP4、基座版和 DFlash2 投机解码模型,许可均为 Apache 2.0。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ripple-65B Preview⚡ Reflection Beam 501B⚡ Muse Spark Open⚡ Nemotron 3 Ultra🌐 Ricursive Intelligence🌐 NVIDIA

商汤发布日日新 SenseNova 6.8 Flash 正式版:主打长期记忆与主动交互的办公智能体,可生成动态 PPT、动态海报和可编辑 Blender 3D 工程

商汤 11 月 2 日晚发布多模态智能体模型日日新 SenseNova 6.8 Flash 正式版,重点升级两块:一是长期记忆和主动交互,能跨任务、跨会话记住用户目标与约束,在信息变化时主动提醒;二是设计生成,覆盖 Web、SVG、Three.js、Blender、动态 PPT 和动态海报,并可接入 Figma。模型已上线 SenseNova Studio、商汤小浣熊和 SenseNova Token Plan;官方 X 账号称 Token Plan 可免费试用,每 5 小时 1500 次 API 请求。官方称其在智能体协作、数据分析和演示生成上超过部分国际前沿模型,但未在公告中列出具体分数。

商汤发布日日新 SenseNova 6.8 Flash 正式版:主打长期记忆与主动交互的办公智能体,可生成动态 PPT、动态海报和可编辑 Blender 3D 工程

核心要点速览

  • 正式版于 11 月 2 日晚发布,定位为多模态智能体模型,主攻办公协作和设计交付
  • 长期记忆加主动交互:跨会话记住目标、约束和偏好,相关信息变化时主动提出调整建议(官方演示基于小浣熊内部研发版)
  • 设计能力覆盖 Web、SVG、Three.js、Blender、动态 PPT、动态海报,输出可继续编辑的 PPTX 和 Blender 工程,并可接入 Figma
  • 渠道:SenseNova Studio、商汤小浣熊、SenseNova Token Plan;官方 X 称 Token Plan 每 5 小时 1500 次免费 API 请求
  • 官方只称在智能体协作、数据分析、演示生成上超过部分国际前沿模型,公告未给具体分数,暂无独立评测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova 6.8 Flash⚡ SenseNova Loop-9B-Preview🤖 Raccoon🌐 SenseTime
AD赞助内容

Grok Bot 官方推出新购物体验:找最优价、比较商品卡片,下单经你批准后自动追踪物流

11 月 3 日,Grok Bot 官方账号 @bot 发视频推广新购物体验:让 Bot 找最优价、比较商品,并追踪你的所有订单。对应功能来自 10 月 27 日的 0.78.1 版(含 0.78.0)官方更新日志:商品以卡片呈现(图片、评分、价格、商店,最多两个徽章),3–4 个结果横向轮播;商品页优先显示有货选项,「Buy now」发起一笔需你批准的订单;下单后 Bot 跟踪发货与送达,发货卡片显示承运商和阶段;Shop Pay 可在 Vault 的 Payments 标签里绑定并设为首选付款方式。

Grok Bot 官方推出新购物体验:找最优价、比较商品卡片,下单经你批准后自动追踪物流

核心要点速览

  • 官方帖 11 月 3 日 21:50 UTC 发布,附 17 秒演示视频;截至抓取约 1687 赞、122 转发、292 回复、11.2 万次浏览
  • 功能来源:官方更新日志 0.78.1(10 月 27 日,含 0.78.0),标题为「Shopping cards and subscription templates」
  • 商品卡片:图片、评分、价格、商店,最多 2 个徽章(如 Top rated),3–4 个结果轮播;商品页有货选项优先、无货选项置灰
  • 下单与追踪:「Buy now」发起的订单须你批准;下单后 Bot 通知发货与送达,发货卡片显示承运商和物流阶段
  • 支付:0.77.0(10 月 26 日)起 Vault 有 Payments 标签;0.78.1 可绑定 Shop Pay 并设为 Bot 首选付款方式
阅读全文
关联模型 / 智能体 / 厂商:

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

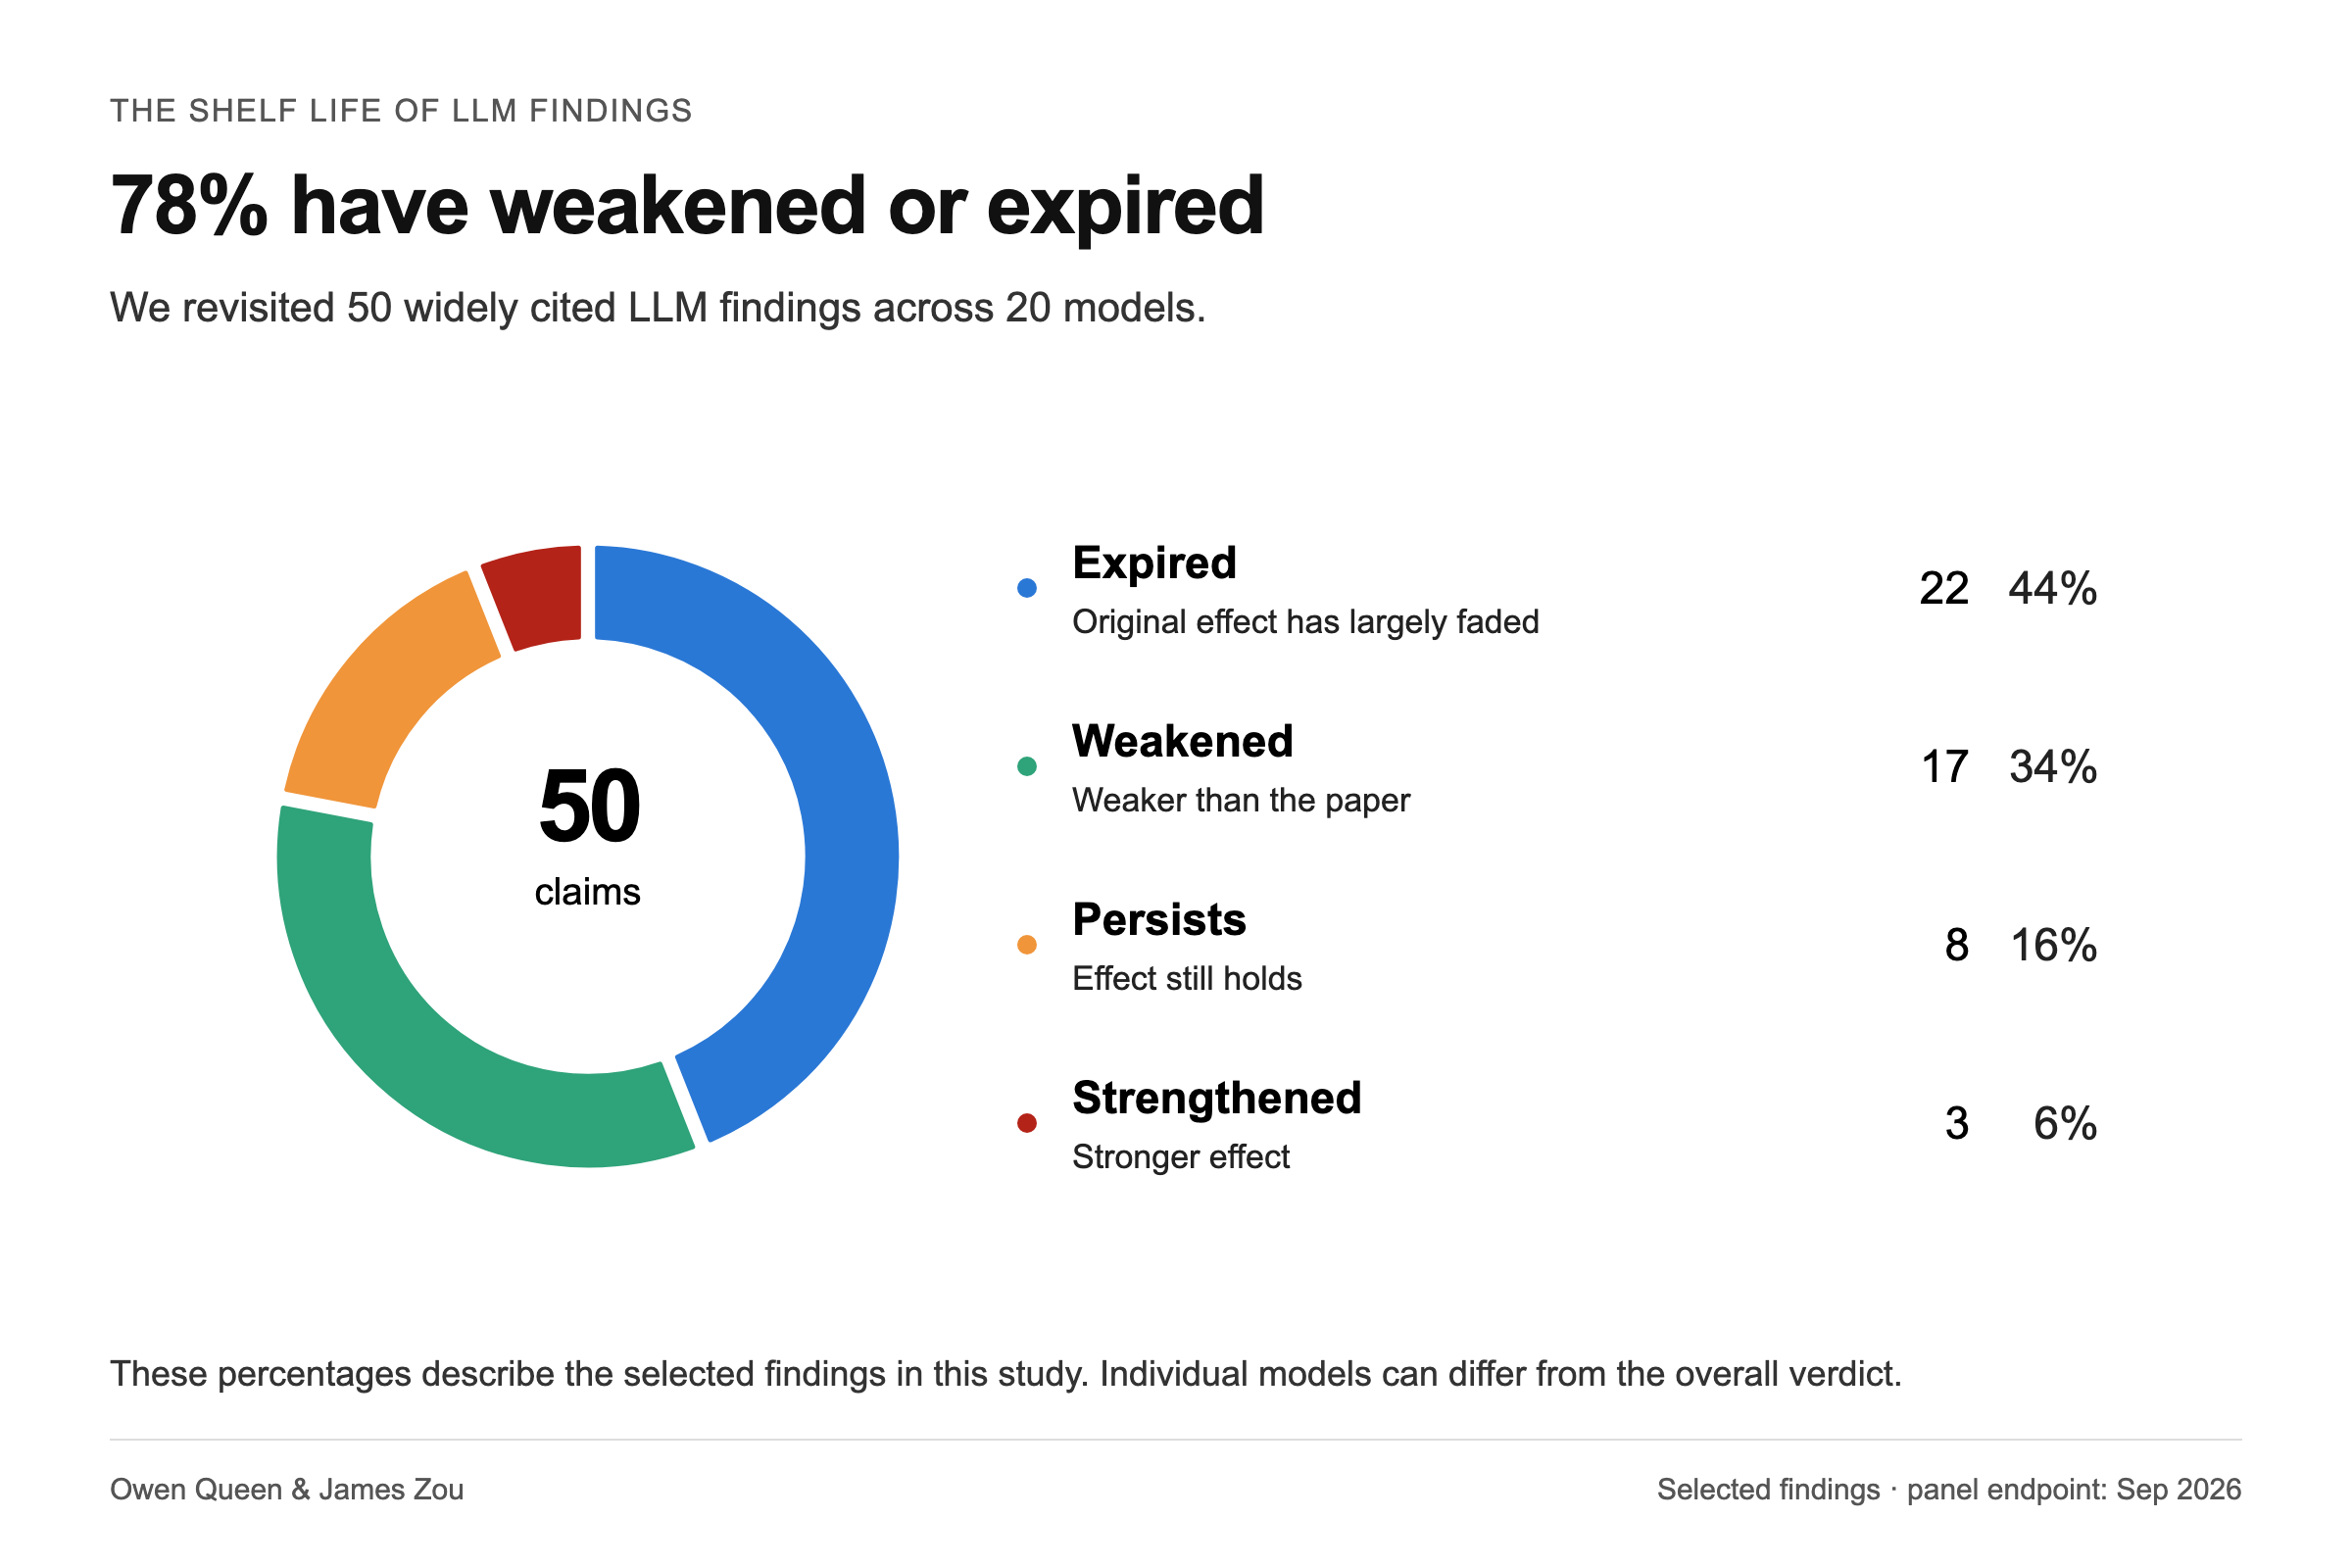
斯坦福 James Zou 团队(Owen Queen、James Zou)11 月 2 日发布交互式研究报告《The shelf life of LLM findings》,用 2024 年 7 月到 2026 年 9 月发布的 20 个模型(来自 8 家开发商)重测 50 条被广泛引用的 LLM 行为结论。结果:22 条(44%)已失效,17 条(34%)明显减弱,8 条(16%)仍成立,3 条(6%)反而增强;已失效结论从发表到失效的中位时间为 14.7 个月。数字母、长上下文「中间丢失」、编造引用等能力缺陷大多消失,而迎合用户、裁判模型偏爱自己答案等偏好类问题依然存在。

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

核心要点速览

  • 50 条结论、20 个模型、8 家开发商;判定截至 2026 年 9 月 30 日的拟合效应。
  • 44% 已失效、34% 减弱、16% 仍成立、6% 增强;已失效结论的中位寿命 14.7 个月(均值 15.7 个月)。
  • 按 Kaplan–Meier 估计,结论发表 6 个月、1 年、2 年后的失效比例分别约 4%、16%、39%。
  • 编造引用整体已失效,但 Qwen3.7-Flash 在同一测试里仍编造了 69% 的参考文献(Sonnet 5.5 约 1%、GPT-6.1 Sol 为 0%)。
  • 重测管线由 Claude Code 和 Codex 实现;48 条可复现检查中 43 条在容差内复现原论文结果。
阅读全文

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

Anthropic Frontier Red Team 11 月 2 日发布研究文章并开源 FlashProve(Apache 2.0):模型提供方先对权重做隐藏承诺,之后为每次回答生成零知识证明,用户不需要权重、在普通 CPU 上就能验证回答确实来自该模型,可用来识别中转站偷换模型或 token 流被篡改。官方口径:Llama 4 Maverick(400B MoE,4-bit)上单张 H100 约 110 token/秒,每个 1,024 token 请求的证明约 19 MB,GPU 时间约为 vLLM 推理的 70–95 倍。这是不再维护的研究原型,上下文只支持 1,024 token、只覆盖整数化模型的贪心解码。Anthropic 工程师 Steve Weis 在 X 上转发了这次发布。

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

核心要点速览

  • 官方口径:Llama 4 Maverick(400B MoE,4-bit)单张 H100 证明速度约 110 token/秒(24 请求一批的 prefill),每个 1,024 token 请求证明约 19 MB。
  • 代价不小:GPU 时间约为 vLLM 推理的 70–95 倍;仓库性能页显示服务端需约 270 GB 内存,一次权重承诺约 39 分钟。
  • 验证不需要 GPU:C++ 验证器单线程约 21 秒验完一个证明;另有可证明正确的 Lean 验证器,安全性定理在 Lean 4 中给出证明。
  • 对比此前开源方案:VerInf 在同一模型上约 0.02 token/秒;商业方案 Attestable 在 Gemma 4 31B 上 53–77 token/秒,但未开源。
  • 限制:v0.16.0 为不再维护的研究原型,上下文 1,024 token,只覆盖整数化模型的贪心解码,不隐藏模型架构。
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

Randall Balestriero 与 Yann LeCun 10 月 29 日在 arXiv 发布论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》(2610.39302),署名单位为 Brown University、NYU 和 AMI Labs。论文证明:只要正样本对是同一场景的两次观测(「好视角」),分别在不同模态上训练的 JEPA 会学到只差一个旋转的相同表征;而 next-token prediction 相当于「坏视角」的 JEPA,所以语言模型只能靠堆规模才与视觉对齐。作者称,好视角达到同等对齐只需 next-token 的 1/42 训练样本,109M 文本 JEPA 在 DINOv2 对齐上得 0.184,高于 Qwen2.5-72B 的 0.154(论文作者口径)。代码与在线 Demo 已开放;Balestriero 的发布帖约 1,054 赞、7.2 万浏览。

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

核心要点速览

  • 论文:arXiv 2610.39302,2026-10-29 提交,作者 Randall Balestriero、Yann LeCun(Brown University / NYU / AMI Labs)
  • 在 PRH 原有基准上,109M 文本 JEPA 与 DINOv2 的对齐分为 0.184,Qwen2.5-72B 为 0.154、Llama-3-70B 为 0.151;与 CLIP 图像编码器对齐为 0.23,此前最好为 0.21(作者口径)
  • 好视角只需 next-token prediction 1/42 的训练样本即可达到相同对齐;作者预先登记对齐缩放律的预测,再训练 85 个新 run,预测误差与换随机种子相当
  • 只用一个旋转把独立训练的编码器拼成图像描述器,COCO 上 CIDEr 0.838;在无配对基准上 ImageNet-100 top-5 为 64%,此前 8B 以内语言模型最高 56%
  • 代码 galilai-group/prh-proof 与 在线 Demo 已开放;Balestriero 发布帖 约 1,054 赞、180 转发
阅读全文
关联模型 / 智能体 / 厂商:
x
xAIdocs.x.ai·
👀66
🔥82

xAI 宣布 11 月 7 日起 Grok API 文本默认加隐形水印:覆盖 grok-4.7 等 7 个模型,团队管理员可按模型退出

xAI(文档署名 SpaceXSI)10 月 31 日在 API 文档新增《Output Watermarking》页面:从 2026 年 11 月 7 日起,grok-4.7、grok-4.6、grok-4.5、grok-4.3 以及 grok-4.20 的推理、非推理和多 Agent 三个版本,生成的文本默认带隐形水印,理由是遵守欧盟 AI 法案。水印覆盖 Responses 和 Chat Completions 两套接口的普通文本、结构化输出和工具调用参数,在生成时轻微影响选词,不添加任何字符。开发者可读响应头 x-watermark 判断;团队管理员可在控制台按模型退出,但须确认适用法律豁免,部分模型可能被锁定无法关闭。

核心要点速览

  • 生效时间:2026 年 11 月 7 日起默认开启,无需改代码、没有请求参数(xAI 文档)
  • 范围:7 个模型 ID(grok-4.7、4.6、4.5、4.3 及 grok-4.20 的 reasoning、non-reasoning、multi-agent),全球与区域端点、Responses 与 Chat Completions 都覆盖
  • 覆盖内容:普通文本、结构化输出和工具调用参数;响应头 x-watermark: true 表示本次输出带水印
  • 退出:团队管理员按模型关闭,5 分钟内对新请求生效、写入审计日志;须确认适用法律豁免,部分模型被锁定不可关
  • 官方口径:水印不影响质量和速度;检测为统计方法,结果分为有水印、无水印、不确定三档,检测 API 需申请
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Exin Therapeutics:Claude Sonnet 5 智能体自选基因疗法并操控机械臂完成小鼠脑注射,Opus 5.5 拒绝执行

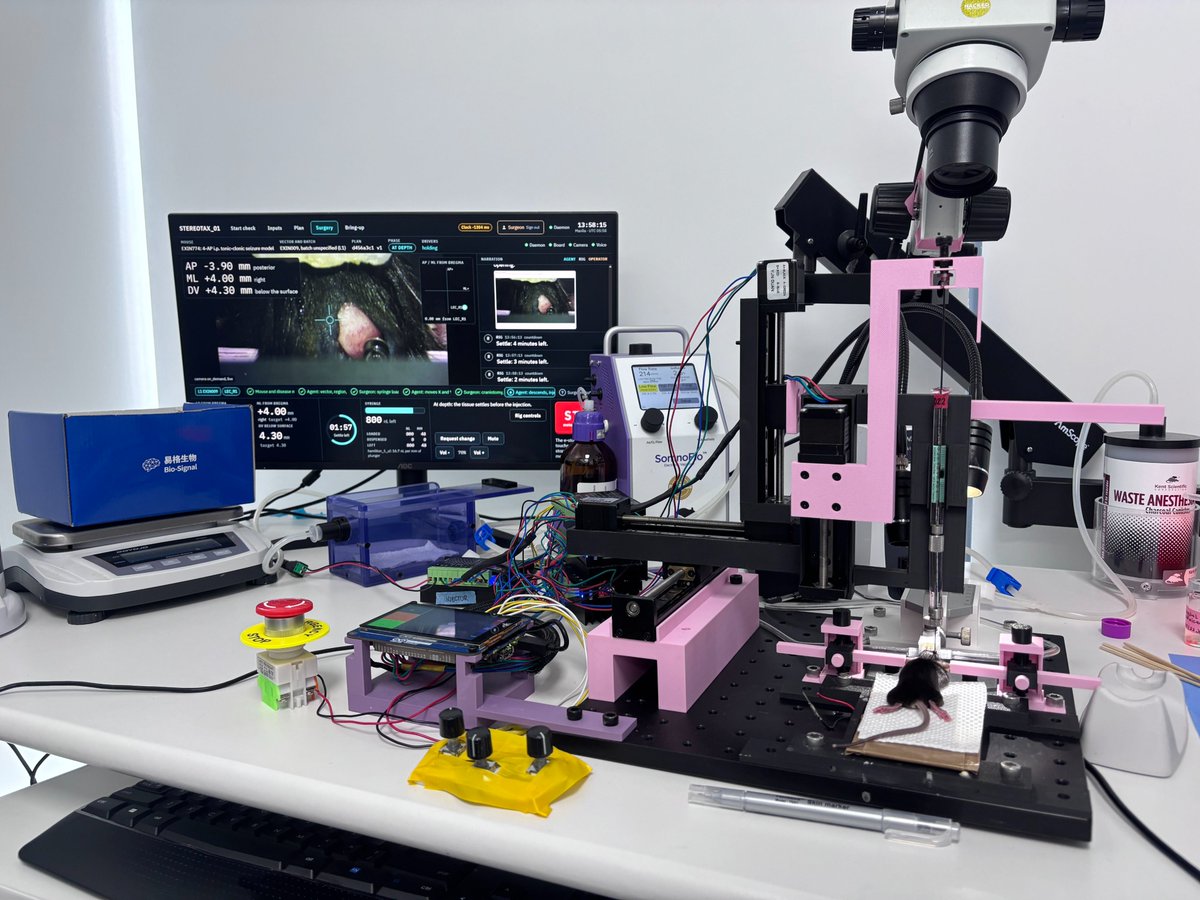
生物科技初创公司 Exin Therapeutics 联合创始人兼 CEO Gabriel Ocana-Santero 10 月 28 日在 X 上披露:一个 AI 智能体从 19 种基因治疗载体中选药、选脑区、从 3 篇论文推导坐标,并驱动立体定位机械臂向癫痫模型小鼠脑内注射 250 纳升。WIRED 报道称团队先试 Claude Opus 5.5 被拒,改用 Sonnet 5 完成;兽医把关每个不可逆步骤,结果尚未经同行评审。

Exin Therapeutics:Claude Sonnet 5 智能体自选基因疗法并操控机械臂完成小鼠脑注射,Opus 5.5 拒绝执行

核心要点速览

  • 智能体从 19 种基因治疗载体中自选药物、脑区,并从 3 篇论文推导注射坐标(CEO 自述)
  • 实际注射量 250 纳升,术中通过摄像头监看出血;据 The Decoder 转述共做了 32 次观察
  • 据 WIRED:Claude Opus 5.5 拒绝下针,改用 Sonnet 5 完成;手术略超 1 小时(常规约 45 分钟)
  • 设备坐标出错后智能体拒绝绕过安全限制,团队需另行改代码;开颅仍由兽医完成
  • 原帖 9,426 赞、160 万+次浏览;疗效(癫痫发作是否减少)尚待观察,未经同行评审
阅读全文
T
Tsinghua University & Z.AI (HarnessPro, arXiv 2610.26770)arxiv.org·
👀21
🔥80

清华与智谱 Z.AI 开源 HarnessPro:Agent 自己改写 harness,Terminal-Bench 2 通过率 80.8%、单任务成本降 34%

清华大学与 Z.AI(智谱)等机构的论文 HarnessPro(arXiv 2610.26770,10 月 19 日提交、10 月 20 日更新 v2)提出一种无需标准答案的 harness 自我改进方法:让专门的 agent 诊断执行轨迹、改写指令与运行时策略,再用 LLM 生成的测试评估,并按性能与成本给出 Lite、Medium、Heavy 三档 harness。论文口径:GPT-5.5 搭配 Codex 时,Heavy 档在 Terminal-Bench 2 达到 80.8%,比此前方法 RHO 高 4.5 个百分点,单任务成本从 1.09 美元降到 0.72 美元。代码以 MIT 协议开源,本周被 Pandaily 等媒体集中报道。

清华与智谱 Z.AI 开源 HarnessPro:Agent 自己改写 harness,Terminal-Bench 2 通过率 80.8%、单任务成本降 34%

核心要点速览

  • Terminal-Bench 2(GPT-5.5 × Codex,三次平均):Heavy 档 80.8%、单任务 0.72 美元;RHO 为 76.3%、1.09 美元,成本降 33.9%(论文口径,见 arXiv)
  • 三个基准平均:相对 RHO 通过率 +2.0 个百分点、单任务成本 -26.1%;基准为 Terminal-Bench 2、SWE-Bench Pro、ProgramBench
  • 换模型也成立:GLM-5.2 × Claude Code 在 Terminal-Bench 2 上,Heavy 档 81.4%、0.62 美元,对比原版 74.6%、0.92 美元和 RHO 78.0%、1.00 美元
  • 省钱档:Medium 档在 Terminal-Bench 2 上 76.3%(与 RHO 持平)但只要 0.56 美元;Lite 档 72.9%、0.43 美元
  • 训练代价小:每个基准只用 10 个训练任务、跑 3–4 轮进化,测试集为 59/100/100 个留出任务;GitHub 以 MIT 协议开源三档 harness
阅读全文

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

10 月 31 日,Vercel Labs 的 Chris Tate(agent-browser 作者)在 X 上发布 agent-desktop,称其为「整台电脑版的 agent-browser」。它是一个 Rust 编写、Apache-2.0 开源的 CLI 和 C 库:读取桌面应用的系统无障碍树,以 JSON 返回每个可操作元素的 ref,Agent 按 ref 点击、输入后再快照核对,不做像素匹配,默认在后台无头运行。1.0.0 已于 10 月 27 日发布并首次加入 Linux 支持,目前 npm 最新版为 1.0.2。

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

核心要点速览

  • 安装:npm install -g agent-desktop,一个包自带 x64/ARM64 原生二进制;1.0.0(10-27)加入 Linux(glibc 2.35+,经 AT-SPI),npm 最新 1.0.2(10-30)
  • 工作方式:snapshot 输出带 ref 的 JSON 树,click @<snapshot_id>:eN 操作,再 snapshot 核对;UI 变化时返回 STALE_REF,错误里带 retry 是否安全的标记
  • 规模:README 称共 60 个命令名、56 个可用命令,覆盖窗口、键鼠、通知、剪贴板、等待与会话追踪
  • 默认无头:按 ref 的操作走无障碍 API,不移动鼠标、不抢焦点,需要真实输入时加 --headed;Chris Tate 称多个 Agent 可各带一个光标并行使用电脑
  • 跑分:官方未公布任何成功率或速度基准;它只是工具,不内置模型,网页自动化仍交给 agent-browser
阅读全文

X 热议:Anthropic 平台工程负责人称团队起步时没有 Rust 工程师,由 Claude 写代码把 Messages API 整体移植到 Rust,CPU 约省 40–50%

Anthropic 平台工程负责人 Katelyn Lesse 在 Latent Space 播客(10 月 27 日上线)中说,上周已全量上线用 Rust 写的 Messages API:原系统是吃 CPU 的 Python 单体,团队起步时「一个 Rust 开发都没有」,人负责系统设计和验证,Claude 写实现,再用影子流量比对新旧两套输出。她给出的粗略数字是 CPU 少约 40–50%,首 token 延迟改善约 10–20%。这段片段被 Somi(@somi_ai)剪出后在 X 上获得 1,000+ 点赞、约 14 万次浏览,swyx 等人转引,讨论焦点是「别搞大重写」这条老经验是否已经过时。以下观点属于 X 讨论,数字为 Lesse 口头估算,Anthropic 尚未发布书面工程报告。

X 热议:Anthropic 平台工程负责人称团队起步时没有 Rust 工程师,由 Claude 写代码把 Messages API 整体移植到 Rust,CPU 约省 40–50%

核心要点速览

  • 一手来源是 Latent Space 播客节目《How Anthropic ships Claude with Claude》中 Katelyn Lesse 的口述,「56:05 Rebuilding the Messages API in Rust」一段
  • Lesse 说迁移起因是用量暴涨后 CPU 成了瓶颈,CPU 需要提前做容量规划,Anthropic 内部研究沙箱、产品沙箱、CI 等都在争同一池 CPU
  • 做法是一次性 fork 整个 API 的 Rust 版本,跑影子流量对比 Python 与 Rust 的输出一致后逐步切换,刻意不在移植中加新功能
  • 她估算 CPU 节省约 40–50%,首 token 延迟改善约 10–20%,长时任务改善更大;这些是播客中的口头粗略数字,非正式基准
  • X 上 Somi 称「别搞大重写」的建议已死,swyx 说 Anthropic「把整个后端 vibecode 成了 Rust」;后者是夸张说法,Lesse 只谈到 Messages API
阅读全文
关联模型 / 智能体 / 厂商:

Krea 推出 Ad Studio:首个 Krea 3 Expert 模型,粘贴网址即可生成品牌一致的广告

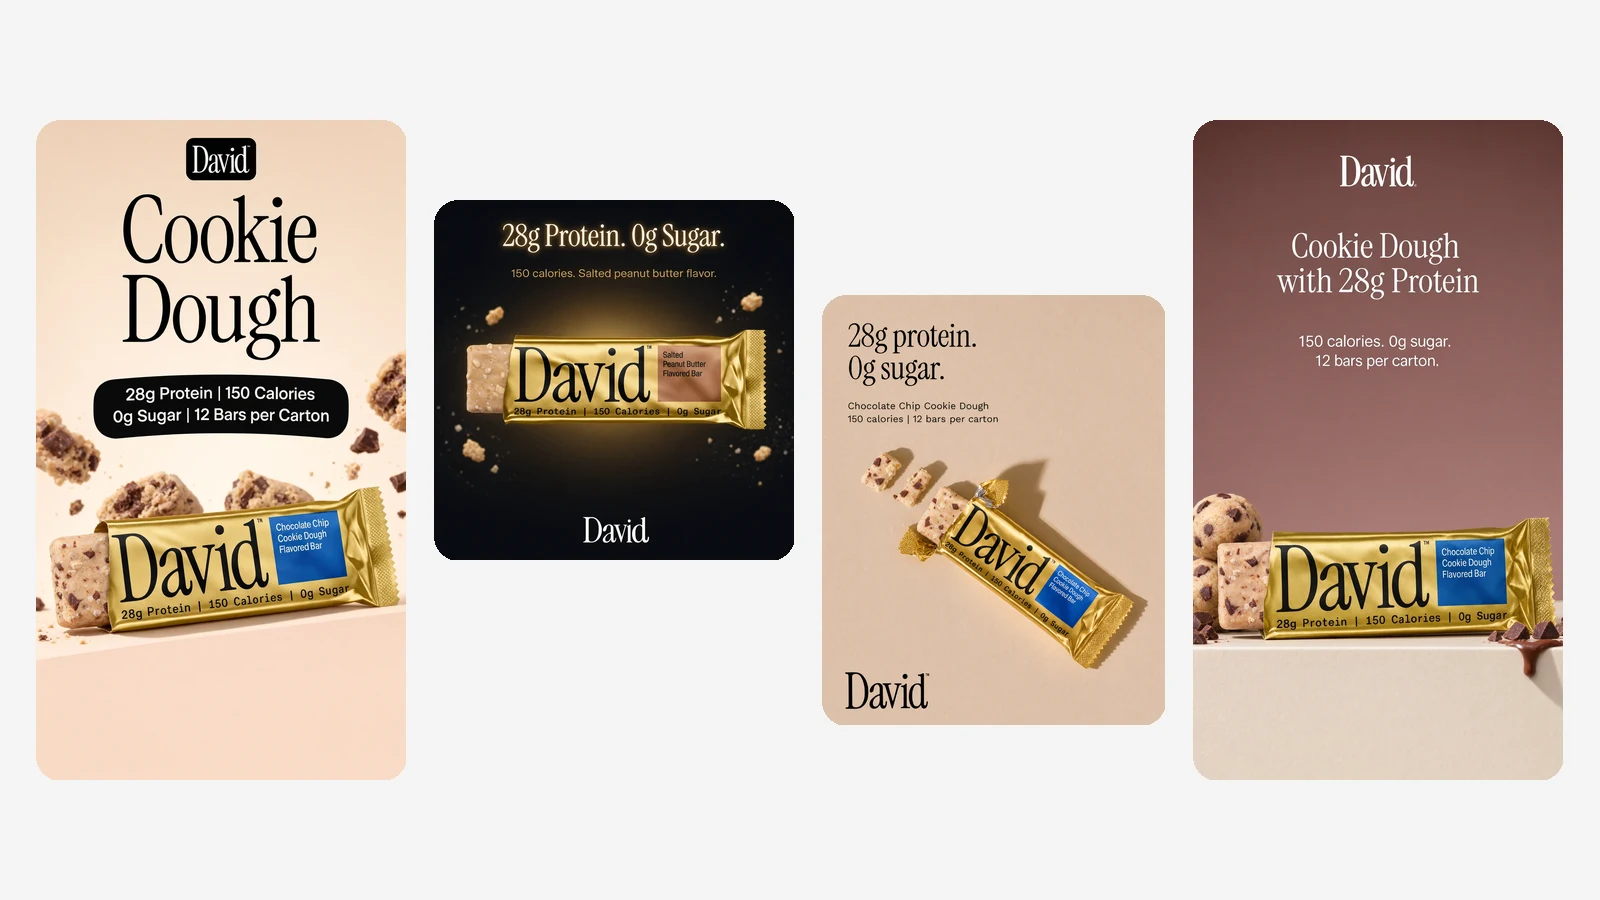
Krea 于 10 月 29 日发布 Ad Studio,这是首个 Krea 3 Expert(专精单一任务的 Krea 3 版本)。粘贴品牌网址后,它会自动生成可编辑的品牌套件和产品目录,再按投放位一次批量生成最多 12 条广告,并可通过 Krea MCP 服务器在 Claude 中调用。

Krea 推出 Ad Studio:首个 Krea 3 Expert 模型,粘贴网址即可生成品牌一致的广告

核心要点速览

  • Ad Studio 是首个 Krea 3 Expert,官方表示更多 Expert 正在路上
  • 输入网址后自动提取 logo、配色、字体、语气、卖点与产品(Shopify 可读取商品目录),品牌套件最多 20 个产品
  • 支持 4:5、1:1、9:16、16:9 投放尺寸,每批最多 12 条,可让 Krea Agent 对话式修改
  • 官方实测:品牌套件 49 秒完成,6 条 Story 广告 2 分 28 秒;付费套餐 Basic 起可用,未公布跑分
阅读全文
关联模型 / 智能体 / 厂商: