AI 编程实时动态与要闻

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

SemiAnalysis 发布 2027 数据中心重磅研报:年增 50GW 算力狂飙与 1.3 万亿美元租赁合同,芯片紧缺风暴或将重现

半导体权威分析机构 SemiAnalysis 发布重磅行业前瞻报告《Datacenters 2027: The Year of Acceleration》。报告披露全行业年内新增算力电力需求高达 50GW、在建容量达 60GW,年初至今签署的数据中心租赁合同总额已突破 1.3 万亿美元。研报指出随着电力和机房土地建设在 2027 年集中释放,全球 AI 算力的最大短缺瓶颈将从电力基础设施重新倒灌转移至先进制程 AI 加速芯片。

SemiAnalysis 发布 2027 数据中心重磅研报:年增 50GW 算力狂飙与 1.3 万亿美元租赁合同,芯片紧缺风暴或将重现

核心要点速览

  • SemiAnalysis 发布重磅行业研报《Datacenters 2027: The Year of Acceleration》
  • 披露全球数据中心在建算力达 60GW,预计 2027 单一自然年内将新增投产 50GW 史诗级电力容量
  • 年初至今科技巨头已签署超 1.3 万亿美元的数据中心长期租赁合同,创历史新高
  • 前瞻指标指出 2027 年电力机房集中交付后,全行业最大短缺瓶颈将从电力重新倒灌回先进制程 AI 加速芯片
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Ollama Cloud 上线美欧本土零数据留存集群并一键接入 Claude Code,SemiAnalysis 揭秘 GLM-5.3 纯靠后训练实现网安能力质变

Ollama 官方宣布在美国与欧盟本土服务器正式上线严格“零数据留存、零训练”的 Ollama Cloud 托管服务,同步接入 DeepSeek-V4.1-Flash-1017 并支持通过 ollama launch 一键拉起 Claude Code 与 OpenCode;同日,SemiAnalysis 披露重磅内幕:智谱旗舰模型 GLM-5.3 未重新预训练,而是 100% 基于前代模型通过高 GPU 效率的后训练(Post-Training)打造,在网络安全与攻防推理上较 GLM-5.2 实现跨代质变。

Ollama Cloud 上线美欧本土零数据留存集群并一键接入 Claude Code,SemiAnalysis 揭秘 GLM-5.3 纯靠后训练实现网安能力质变

核心要点速览

  • Ollama Cloud 正式上线美国与欧盟本土零数据留存(Zero Data Retention)托管集群,支持通过 ollama launch 一键驱动 Claude Code 与 OpenCode 运行 DeepSeek-V4.1-Flash-1017
  • Ollama v0.40.6 同步发布,新增 GGUF q2_0 量化张量类型支持,并彻底修复 Windows 平台孤儿 Runner 进程残留问题
  • SemiAnalysis 披露 GLM-5.3 完全基于前代模型通过高 GPU 效率的后训练(Post-Training)构建而成,在网络安全能力上较 GLM-5.2 实现“昼夜之别”的跨代跃升
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

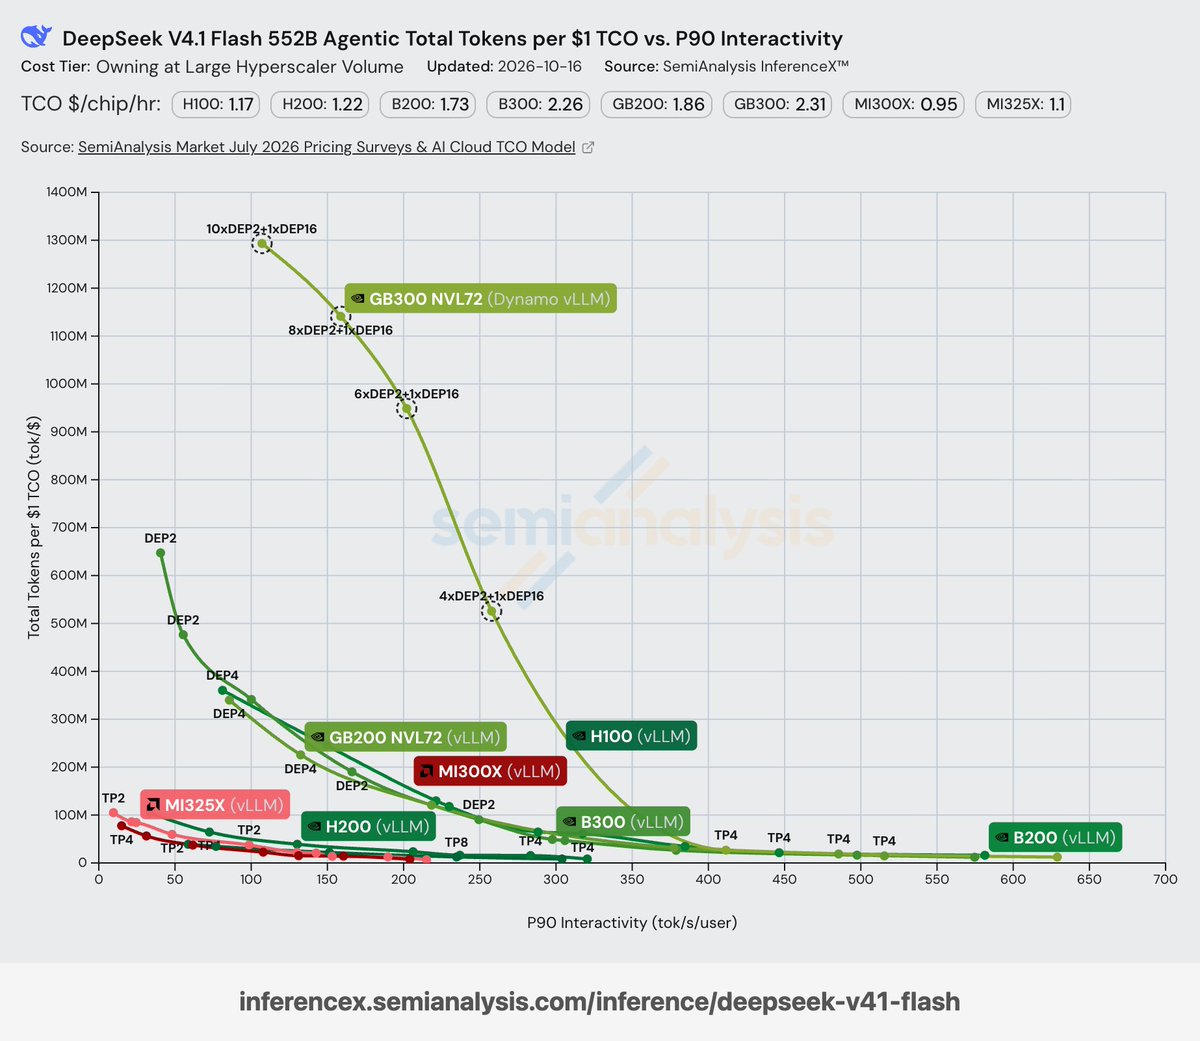
权威半导体与 AI 算力研究机构 SemiAnalysis 披露了 AgentX 基准实现每美元 TCO 产出 13 亿 Token 的底层架构细节:vLLM 联合 Inferact 采用预填充/解码分离式推理(Disaggregated Serving),在超大规模云商批量计价下单位成本性能达到 NVIDIA B300 聚合式(Aggregated)部署的 4 倍;与此同时,开源编程智能体 Cline 公布实测,指出 DeepSeek-V4.1-Flash-1017 仅靠在多套异构 Coding Agent Harness 上扩展强化学习,便以低 17 倍的成本在 Terminal-Bench 上击败 GPT-5.6-Sol、较前代提分 35%。

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

核心要点速览

  • SemiAnalysis 实测确认:vLLM 联合 Inferact 采用预填充/解码分离式架构,在 AgentX 上实现每美元 TCO 产出 13 亿 Token,性价比达 NVIDIA B300 聚合式配置的 4 倍
  • Cline 官方实测指出 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 上较前代跃升 35%,以低约 17 倍的成本击败 GPT-5.6-Sol
  • 这一 35% 的性能跃升在“零算法创新”下完成,核心归功于在多套真实 Coding Agent Harness 上直接进行强化学习后训练
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

核心要点速览

  • vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
  • 模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
  • OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文

SemiAnalysis AgentX:AMD MI355x 在较低交互档位上 tokens/$ TCO 超越 B300

SemiAnalysis 在 AgentX(面向多轮长上下文智能体负载的基准)上指出,新的 AMD MI355x 提交在较低交互性区间的总拥有成本(tokens per $ TCO)上击败 B300,并点名 vLLM、AMD 与 LMCache 工程团队。对选型推理硬件与 agentic serving 栈有参考价值。

核心要点速览

  • 基准:AgentX 衡量多轮、长上下文智能体真实流量。
  • 结果:AMD MI355x 在较低交互档位 tokens/$ TCO 优于 B300。
  • 栈:点名 vLLM、AMD、LMCache 协作推进 agentic 优化。
阅读全文
关联模型 / 智能体 / 厂商: