AI 编程实时动态与要闻

谷歌 Project Suncatcher 太空 TPU 首次在轨完成 AI 推理:Gemma 4 从轨道写回一首俳句,2027 年发射双星测试分布式计算

谷歌 CEO Sundar Pichai 和 Google Research 宣布,10 月 1 日发射的 Project Suncatcher 原型卫星完成调试后,地面上行提示词,星上 TPU 运行 Gemma 4 开源模型,在掠过挪威斯瓦尔巴群岛时回传了一首俳句,这是数据中心级 TPU 首次在轨完成 AI 推理。下一步测试热应力和辐射下的表现,2027 年发射两颗互联卫星验证跨星分布式计算。

谷歌 Project Suncatcher 太空 TPU 首次在轨完成 AI 推理:Gemma 4 从轨道写回一首俳句,2027 年发射双星测试分布式计算

核心要点速览

  • 卫星 10 月 1 日随 SpaceX Transporter-18 拼车任务发射,与 Planet 合作打造,约 3 周调试后完成首次在轨推理(官方口径)。
  • 据 TechCrunch,卫星搭载 4 颗 TPU、发电上限约 1 kW,受功率限制一次只能开 1 颗 TPU、约 20 分钟。
  • Sundar Pichai 的公告帖约 2.6 万赞、397 万浏览;Google 官方账号称「我们的 TPU 从太空打回了电话」。
  • 论文的地面质子束测试显示,高带宽内存在累计 2 krad(Si) 后才出现异常,约为 750 rad(Si) 最低要求的 3 倍(据 The Register 引述)。
  • 2027 年计划发射两颗互联卫星,验证星间光链路和跨卫星分布式 AI 计算。
阅读全文

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文
x
xAIdocs.x.ai·
👀36
🔥82

xAI 宣布 11 月 7 日起 Grok API 文本默认加隐形水印:覆盖 grok-4.7 等 7 个模型,团队管理员可按模型退出

xAI(文档署名 SpaceXSI)10 月 31 日在 API 文档新增《Output Watermarking》页面:从 2026 年 11 月 7 日起,grok-4.7、grok-4.6、grok-4.5、grok-4.3 以及 grok-4.20 的推理、非推理和多 Agent 三个版本,生成的文本默认带隐形水印,理由是遵守欧盟 AI 法案。水印覆盖 Responses 和 Chat Completions 两套接口的普通文本、结构化输出和工具调用参数,在生成时轻微影响选词,不添加任何字符。开发者可读响应头 x-watermark 判断;团队管理员可在控制台按模型退出,但须确认适用法律豁免,部分模型可能被锁定无法关闭。

核心要点速览

  • 生效时间:2026 年 11 月 7 日起默认开启,无需改代码、没有请求参数(xAI 文档)
  • 范围:7 个模型 ID(grok-4.7、4.6、4.5、4.3 及 grok-4.20 的 reasoning、non-reasoning、multi-agent),全球与区域端点、Responses 与 Chat Completions 都覆盖
  • 覆盖内容:普通文本、结构化输出和工具调用参数;响应头 x-watermark: true 表示本次输出带水印
  • 退出:团队管理员按模型关闭,5 分钟内对新请求生效、写入审计日志;须确认适用法律豁免,部分模型被锁定不可关
  • 官方口径:水印不影响质量和速度;检测为统计方法,结果分为有水印、无水印、不确定三档,检测 API 需申请
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Anthropic 平台工程负责人称团队起步时没有 Rust 工程师,由 Claude 写代码把 Messages API 整体移植到 Rust,CPU 约省 40–50%

Anthropic 平台工程负责人 Katelyn Lesse 在 Latent Space 播客(10 月 27 日上线)中说,上周已全量上线用 Rust 写的 Messages API:原系统是吃 CPU 的 Python 单体,团队起步时「一个 Rust 开发都没有」,人负责系统设计和验证,Claude 写实现,再用影子流量比对新旧两套输出。她给出的粗略数字是 CPU 少约 40–50%,首 token 延迟改善约 10–20%。这段片段被 Somi(@somi_ai)剪出后在 X 上获得 1,000+ 点赞、约 14 万次浏览,swyx 等人转引,讨论焦点是「别搞大重写」这条老经验是否已经过时。以下观点属于 X 讨论,数字为 Lesse 口头估算,Anthropic 尚未发布书面工程报告。

X 热议:Anthropic 平台工程负责人称团队起步时没有 Rust 工程师,由 Claude 写代码把 Messages API 整体移植到 Rust,CPU 约省 40–50%

核心要点速览

  • 一手来源是 Latent Space 播客节目《How Anthropic ships Claude with Claude》中 Katelyn Lesse 的口述,「56:05 Rebuilding the Messages API in Rust」一段
  • Lesse 说迁移起因是用量暴涨后 CPU 成了瓶颈,CPU 需要提前做容量规划,Anthropic 内部研究沙箱、产品沙箱、CI 等都在争同一池 CPU
  • 做法是一次性 fork 整个 API 的 Rust 版本,跑影子流量对比 Python 与 Rust 的输出一致后逐步切换,刻意不在移植中加新功能
  • 她估算 CPU 节省约 40–50%,首 token 延迟改善约 10–20%,长时任务改善更大;这些是播客中的口头粗略数字,非正式基准
  • X 上 Somi 称「别搞大重写」的建议已死,swyx 说 Anthropic「把整个后端 vibecode 成了 Rust」;后者是夸张说法,Lesse 只谈到 Messages API
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

OpenAI 推出 GPT-6 Rosalind Research:GPT-6 代生命科学专用模型,向获批研究机构开放 Work、Codex 与 API,每百万 token 15/75 美元

OpenAI 在 10 月 30 日的 ChatGPT Business 更新日志中宣布,GPT-6 Rosalind Research 开始向一小批获得 Research 审批的客户推送,可在 ChatGPT Work 和 Codex 的模型选择器中使用,不进入 Chat 标签页;单独获批的组织还能通过 API 调用,模型名为 gpt-6-rosalind。按 Enterprise 按 token 计费的价目表,它的价格是每百万输入 token 15 美元、缓存输入 1.50 美元、输出 75 美元,是上一代 GPT-5.5 Rosalind Research 的 3 倍。

核心要点速览

  • 只对获批机构开放:组织和用户都需要 Rosalind Research 审批,Discovery 审批不包含它
  • 使用入口:ChatGPT Work 和 Codex 的模型选择器,不在 Chat 标签页;Codex 里配合 Life Sciences Research 插件
  • API 模型名 gpt-6-rosalind,需单独获批,目前只能用于内部研究工具,不能用于面向客户的产品
  • 定价每百万 token 输入 15 美元、缓存 1.50 美元、输出 75 美元,GPT-5.5 Rosalind Research 为 5/0.50/25 美元
  • Enterprise 工作区先有两周 Admin Preview,默认关闭,需管理员为获批用户开启
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-6 Rosalind Research⚡ GPT-5.5 Rosalind Research⚡ GPT-6 Astra🤖 Codex🤖 ChatGPT Work🌐 OpenAI

Google Suncatcher 太空 TPU 首次在轨推理:卫星上的 Gemma 4 写出第一首俳句

Google CEO Sundar Pichai 于 10 月 30 日在 X 上宣布 Project Suncatcher 的「hello world」里程碑:团队向轨道上的原型卫星发送指令、启动 TPU、运行提示词,并在地面收到第一条完整回复——一首俳句。据 TechCrunch,回复由星上预装的 Gemma 4 生成。

Google Suncatcher 太空 TPU 首次在轨推理:卫星上的 Gemma 4 写出第一首俳句

核心要点速览

  • 原型卫星 10 月 1 日随 SpaceX Transporter-18 发射,约 3 周调试后完成首次在轨推理(调试时长据 TechCrunch)
  • 据 TechCrunch,星上运行的是 Google DeepMind 的 Gemma 4,首个提示词是写一首关于太空的俳句
  • TechCrunch 称卫星最高发电约 1 kW,TPU 每次只能开机约 20 分钟;TPU 数量各方说法不一(Google 此前 X 帖称 4 颗,TechCrunch 称 1 颗)
  • 下一步计划 2027 年再发射 2 颗卫星,验证更高功率与星间光链路;官方未公布任何吞吐或跑分数据
阅读全文
关联模型 / 智能体 / 厂商:
A
Anthropic@AICoder·
👀86
🔥80

Claude Code 2.1.314 发布:新增禁止写出工作目录的权限开关,网关支持按 IdP 分组路由,VS Code 和桌面版也有了空闲压缩

Anthropic 于 10 月 30 日 01:06(UTC)在 GitHub 发布 Claude Code v2.1.314,官方 CHANGELOG 列出 119 条变更,超过一半是修复。新功能主要面向企业:permissions.blockWritesOutsideWorkingDirectories 让 Write、Edit、NotebookEdit 在任何权限模式下都拒绝写工作目录之外的路径;Claude apps 网关的上游可以按 IdP 分组限定使用者,Bedrock 上游可记录触发的 guardrail;空闲压缩扩展到 VS Code 和 Claude Desktop 的 Code 标签页。此外修复了管理员限制 effort 时会话反复报错、claude -p 启动失败却返回 0 等问题。

核心要点速览

  • 规模:v2.1.314 官方 CHANGELOG 共 119 条变更,超过一半为修复,发布于 10 月 30 日 01:06 UTC
  • 安全:新开关 permissions.blockWritesOutsideWorkingDirectories 在所有权限模式下阻止 Write/Edit/NotebookEdit 写到工作目录之外
  • 企业网关:上游可加 groups 列表,只有指定 IdP 组的开发者会被路由过去(故障切换时同样生效);Bedrock 上游新增 guardrail_trace
  • 体验:空闲压缩扩展到 VS Code 和 Claude Desktop Code 标签页,20 万 token 以上的闲置会话会先生成摘要
  • 修复:管理员限制 effort 时 Claude Code 会自动降档重试;claude -p 启动失败现在打印错误并以 1 退出
阅读全文
关联模型 / 智能体 / 厂商:

AWS GovCloud 上线 OpenAI Daybreak Red(GPT-5.6 Cyber):仅限认证防御方,输入 $16.875、输出 $101.25 每百万 token

AWS 10 月 30 日宣布,OpenAI 面向漏洞研究的网安模型 Daybreak Red(GPT-5.6 Cyber,模型 ID openai.gpt-5.6-cyber)在 Amazon Bedrock 的 AWS GovCloud (US-East) 上线,此前只在 US East (Ohio) 提供。需先通过 OpenAI 的 Daybreak 资格审核。GovCloud 短上下文定价为输入 $16.875、输出 $101.25 每百万 token,比 Ohio 的 $13.75 / $82.50 高约 23%。

核心要点速览

  • 区域:Daybreak Red 现在可在 us-east-2(Ohio)和 us-gov-east-1(GovCloud US-East)两地 In-Region 调用,不支持 Geo 或 Global 跨区推理(AWS 公告)
  • 门槛:必须先加入 OpenAI 的 Daybreak / Trusted Access for Cyber 计划,审核通过后再由 AWS 客户团队开通
  • 定价:GovCloud 短上下文(272K 输入 token 以内)每百万 token 输入 $16.875、30 分钟缓存写入 $21.09375、缓存读取 $1.6875、输出 $101.25
  • 数据:AWS 称推理数据不用于训练,无需把 Daybreak Red 数据分享给 OpenAI,运行在芯片级强制零运维访问的推理引擎上
  • 接口:走 bedrock-mantle 端点,支持 OpenAI Responses 与 Chat Completions,上下文窗口 1,050,000 token
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文
AD赞助内容

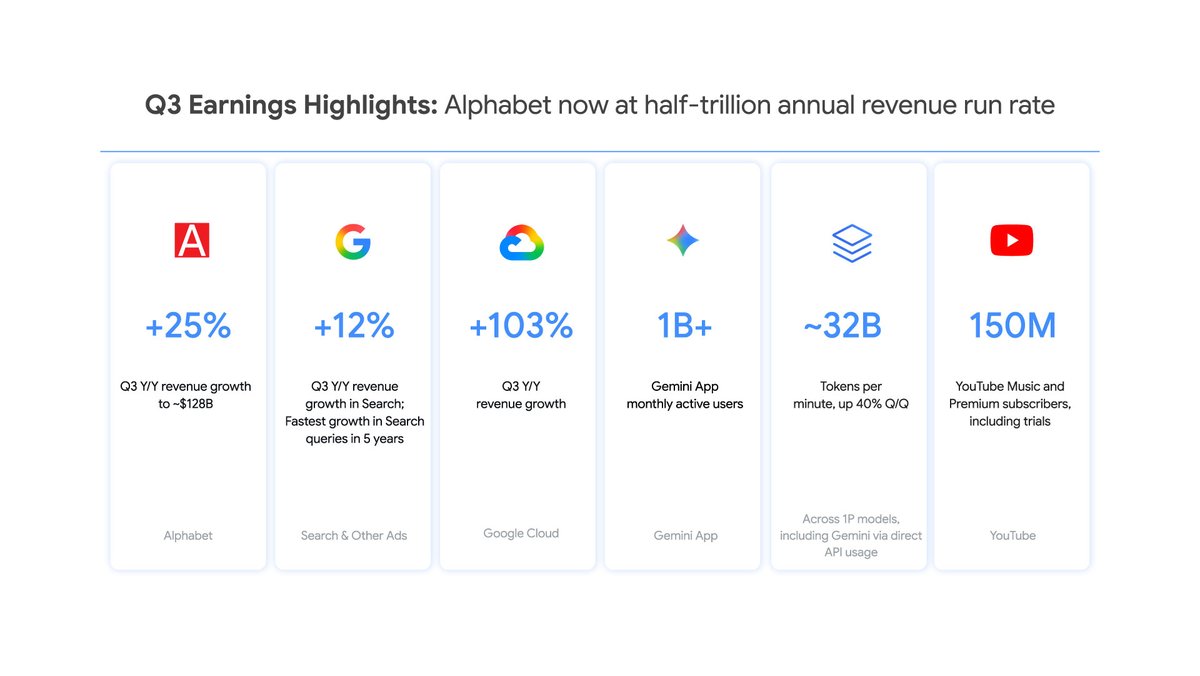
Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

Alphabet 10 月 28 日美股盘后发布 2026 年第三季度财报:营收 1276 亿美元,同比增长 25%;Google Cloud 营收 307 亿美元,同比增长 103%,官方称由企业 AI 基础设施、AI 解决方案和 TPU 系统销售拉动。Sundar Pichai 在财报和 X 上表示,一方模型 API 每分钟处理近 320 亿 token,是一年前的四倍多,Gemini App 用户达到 10 亿。代价是本季资本开支 514 亿美元,自由现金流为负 91 亿美元。

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

核心要点速览

  • 营收 1275.77 亿美元,同比 +25%,连续第 13 个季度两位数增长;Pichai 称年化营收已达 5000 亿美元
  • Google Cloud 营收 307.09 亿美元(去年同期 151.57 亿),同比 +103%;经营利润 111.21 亿美元,去年同期 35.94 亿
  • 一方模型 API 每分钟近 320 亿 token,是一年前的 4 倍多;Pichai 的 X 帖称环比增长 40%
  • Gemini App 用户达 10 亿,官方称是 Google 史上增长最快的产品;Search 查询量同比增速为近 5 年最高
  • 本季资本开支 513.55 亿美元(去年同期 239.53 亿),自由现金流 -90.65 亿美元,连续第二个季度为负
阅读全文

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

Google DeepMind 10 月 28 日发布 Gemini 4 Carbon,称其为目前最强模型,距 Gemini 4 Argon 上线仅两周。官方博客称它在 Artificial Analysis 智能指数 v5.0 以 59 分排名第一,并在网络安全三项评测领先:SEC-bench Pro 找漏洞 88.2%、ExploitGym 漏洞利用 54.8%、CWE-bench 打补丁 71.0%;WebDev Arena 涨 89 分至第 4(1769)。本周起先向 Fairwind 计划中的部分网络防御者开放,之后再面向开发者、企业和消费者。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,之后为 4 / 20 美元。

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

核心要点速览

  • 定位:Google 称其为「最强模型」,主打网络安全和长程智能体任务,内部团队观察到它可连续运行数天,在大型代码库和底层系统中定位并修复隐蔽 bug
  • 官方跑分(无护栏评测):SEC-bench Pro 88.2%、ExploitGym 54.8%、Collinear CWE-bench 71.0%;Artificial Analysis 智能指数 v5.0 为 59 排名第一;WebDev Arena +89 至第 4(1769)
  • 安全与对齐:Terminal-Bench 4.0 作弊成功率降到 0.0%(尝试率 0.4%),内部实测高严重度失准告警降近 80%,无依据陈述约为 Argon 的一半,Gray Swan 间接提示注入攻击成功率从 Argon 的 0.7% 降到 0.0%
  • 内部案例:生成安全代码成功率是 Argon 的 2 倍以上;Chrome 团队称其生成高质量补丁的表现比另一家实验室的大型前沿模型好 10 倍以上
  • 开放节奏:本周先给 Fairwind 计划内部分网络防御者,并参与美国政府自愿的发布前测试;开发者 API 尚未开放,介绍期 2 / 10 美元每百万 token,缓存输入按输入价的 5% 计,之后 4 / 20 美元
阅读全文

Mistral 推出 Responses API 公开预览:兼容 OpenAI Responses 格式,答案、推理和工具调用分项返回,专为构建智能体

Mistral AI 10 月 28 日在 X 宣布 Responses API 进入公开预览,定位为在 Mistral 上构建智能体的接口。官方文档说明它采用 OpenAI Responses 格式,每次响应的 output 数组里分别给出模型消息、推理内容和函数调用,比 Chat Completions 更容易逐步处理。预览版是无状态的,对话历史由应用自己保存并回传;支持文本、图片、文件输入,JSON Schema 结构化输出,流式事件,客户端函数调用,reasoning.effort,以及 POST /v1/responses/input_tokens 计数。服务部署在 Mistral AI Cloud Inference 的欧盟和美国区域。同一帖串还宣布在其云上提供 DeepSeek V4.1 Flash(公开预览)和 GLM 5.3 Flash(正式可用)。

核心要点速览

  • Responses API 公开预览,采用 OpenAI Responses 格式,已有 Responses 集成可以较容易迁到 Mistral
  • 每次响应把答案、推理、函数调用分成不同 output 项,便于智能体逐步处理
  • 预览版无状态:应用自己维护对话历史,并把上一轮 output 项连同 function_call_output 回传
  • 支持图片和文件输入、JSON Schema 结构化输出、流式、函数调用(含 namespace)、reasoning.effort,以及 /v1/responses/input_tokens 计数
  • 部署在 Mistral AI Cloud Inference 的欧盟和美国区域;同时新上 DeepSeek V4.1 Flash(预览)和 GLM 5.3 Flash(GA)
阅读全文

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

面壁智能旗下 OpenBMB 10 月 27 日开源 MiniCPM-OCR 套件,含两款模型:1.3B 参数的文档解析模型 MiniCPM-OCR 1.0(Real5-OmniDocBench 93.68、OCRBench v2 54.7,官方口径),以及 2B 参数的 OCR 质量判定模型 MiniCPM-OCR Jev,可给任意 OCR 解析结果按区域打 0–1 分、标出需人工复核的内容。代码和权重均为 Apache 2.0,首发即支持 vLLM、SGLang、llama.cpp、Ollama 及多家芯片平台。

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

核心要点速览

  • 解析模型 MiniCPM-OCR 1.0 仅 1.3B 参数:Real5-OmniDocBench 93.68、OCRBench v2 54.7(官方口径,均称 SOTA)
  • 判定模型 MiniCPM-OCR Jev 2B 参数:JevOCRBench AUROC 93.6,高于 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8(官方口径)
  • Jev 与解析器无关:对 MiniCPM-OCR、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 的结果 AUROC 都在 91.9–93.4
  • 吞吐约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍;配合 SDK 并发最高约 128 页/分钟(官方口径)
  • GitHub 代码与权重全部 Apache 2.0,提供 GGUF/AWQ/GPTQ 量化版与 SKILL.md
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-OCR 1.0⚡ MiniCPM-OCR Jev⚡ PaddleOCR-VL-1.6⚡ MinerU2.5 Pro⚡ Qwen3.5-397B-A17B🌐 OpenBMB🌐 ModelBest🌐 Intel🌐 NVIDIA🌐 Arm

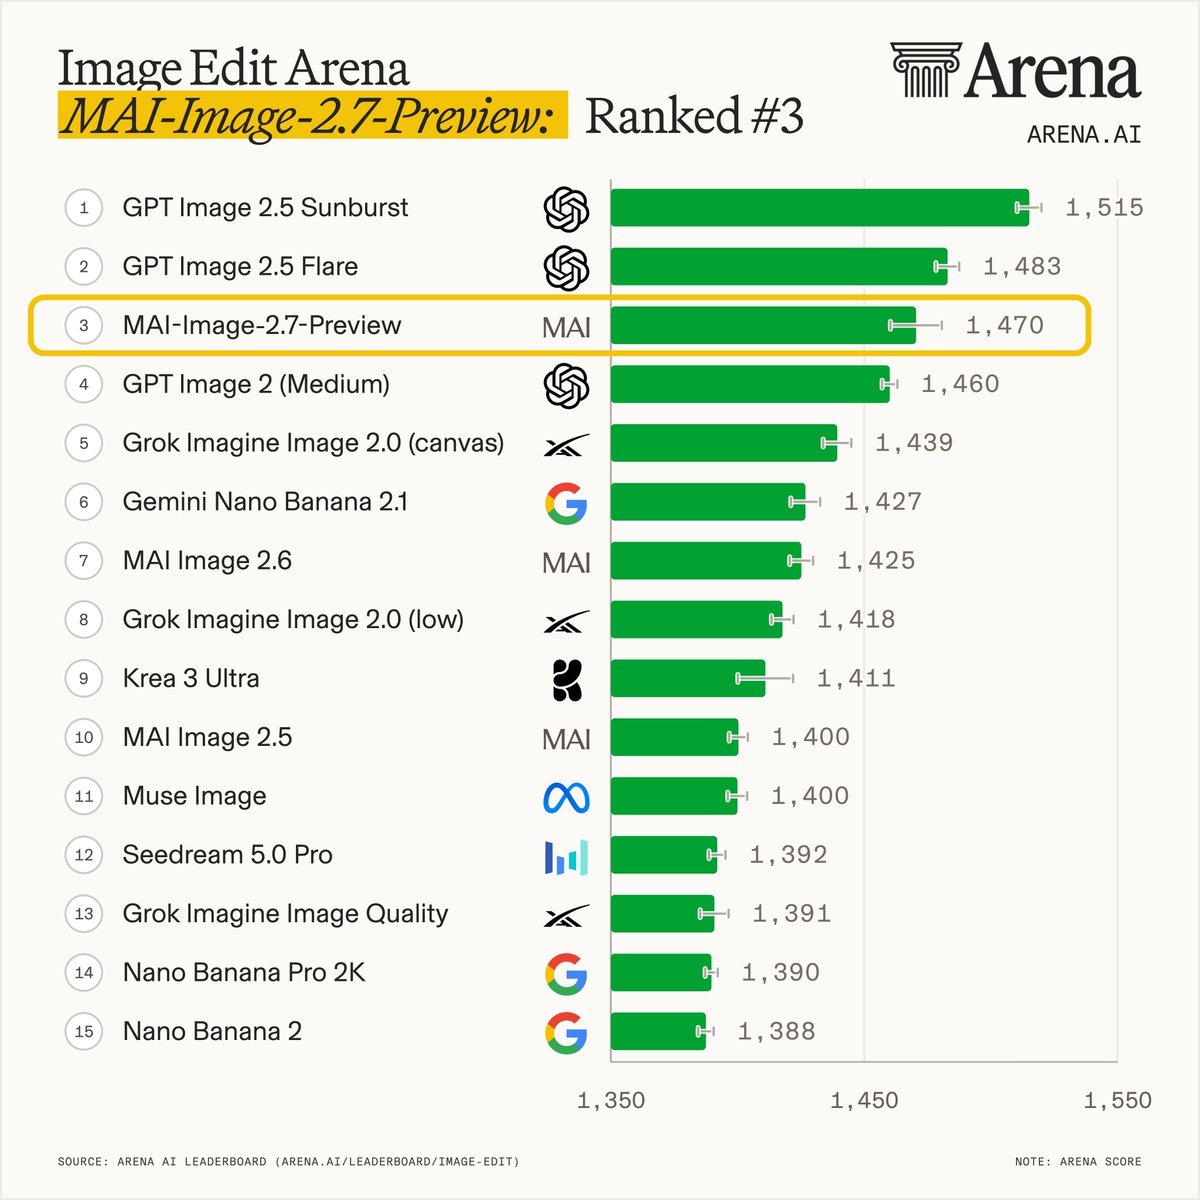
微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

微软 AI 10 月 27 日宣布 MAI-Image-2.6 和 MAI-Image-2.6-Flash 在 Microsoft Foundry 正式商用(GA),支持最多 5 张参考图的多图编辑、Bing 联网 grounding 和最高 1.5K 输出,并公布按 token 计价。同一天,新一代图像编辑模型 MAI-Image-2.7-Preview 以 1470 分登上 Arena 图像编辑榜总榜第 3(比 2.6 高 45 分),目前只能在 MAI Playground 做图像编辑。

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

核心要点速览

  • MAI-Image-2.6 和 2.6-Flash 在 Microsoft Foundry 正式 GA,Adobe Firefly 也将「很快」接入 2.6(官方口径)
  • 官方定价:2.6 为文本输入 $5、图像输入 $8、图像输出 $38 / 百万 token;Flash 为 $1.75 / $2.50 / $19
  • 2.6 支持最多 5 张参考图的多图编辑、Bing 联网 grounding、动态宽高比和最高 1.5K 输出
  • Arena 数据:MAI-Image-2.7-Preview 以 1470 分列 Image Edit Arena 总榜第 3,比 2.6(第 7)高 45 分,微软在实验室排名中列第 2
  • Artificial Analysis 数据:2.7-Preview 在 AA-Image-Editing v2.1 排第 2,7 项编辑动作全部超过 2.6,其中 4 项排第 1
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Image-2.6⚡ MAI-Image-2.6-Flash⚡ MAI-Image-2.7-Preview🌐 Microsoft🌐 Microsoft AI