AI 编程实时动态与要闻

X 热议:前 Claude Code 成员 Thariq 称 200 美元档订阅已够用,「这是智能史上最贵的时候」

个人简介写着「formerly Claude Code @anthropicai」的 Thariq(@trq212)11 月 2 日在 X 发帖:「用了一周,我的结论是做出好东西并不需要无限 token,200 美元的套餐非常好用,而且这是智能史上最贵的时候。」帖子约 7 小时内获得 5,500 多赞、24 万次浏览、350 多条回复。支持者认为订阅制已足够大多数开发者,反对者质疑「不需要无限 token」却推荐最贵一档,也有人担心补贴结束后价格会回升。这是个人观点,不是 Anthropic 官方声明。

核心要点速览

  • Thariq 的原话是:不需要无限 token 也能做出好东西,200 美元档套餐「非常好用」,并断言「这是智能史上最贵的时候」。
  • 他在回复中补充,自己周末也一直在用这些套餐,「从没碰到过真正的限额」。
  • Claude 官方定价页显示:Max 每月 100 美元(Pro 的 5 倍用量),Ultra 每月 200 美元(Pro 的 10 倍用量、无 5 小时限制、每月 200 美元 API 额度)。
  • 反对声音集中在两点:一是「不要无限 token」和推荐最贵档位自相矛盾,二是现价是否依赖补贴、之后会不会涨价。
  • 这是一位前 Anthropic 成员的个人观点,不代表 Anthropic 官方立场,也没有给出用量数据。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Jason Calacanis 称每年不到 4 万美元的 AI 订阅换来 200 万美元以上价值、已自动化至少 7 个全职岗位

天使投资人、This Week in Startups 主持人 Jason Calacanis 11 月 2 日在 X 上发帖:他每年在 Anthropic、Lovable、Grok Bot、ElevenLabs 等 AI 产品的 token 和订阅上花不到 4 万美元,却在 LAUNCH 和 This Week in Startups 获得 200 万美元以上的价值,已自动化至少 7 个全职岗位,平均任务速度快了 100%。他说过去 90 天的变化超过此前两年。帖子约 9 小时内获得约 2200 赞、23 万浏览,讨论集中在 AI 投资回报和岗位替代。以上数字都是他本人的说法,未经独立核实。

核心要点速览

  • 这是 Calacanis 的个人帖子,不是任何 AI 公司的官方数据或公告;4 万美元、200 万美元、7 个岗位、快 100% 都是他自报,没有公开明细。
  • 原帖(2026-11-02 05:27 UTC)约 2201 赞、106 转发、244 回复、42 引用、23 万浏览、715 次收藏(抓取时数据)。
  • 他提到的工具包括 Anthropic、Lovable、Grok Bot、ElevenLabs,以及一长串其他产品;他还说,过去 90 天的产品每周没用满 30 小时,就体会不到这类软件有多大变化。
  • 支持方:创业者 Steven Cohn(@spcohn)引用称他们也看到了同等的回报;拥有约 40 万粉丝的 Farzad(@farzyness)引用称「AI 的回报率高得惊人」,约 157 赞。
  • 质疑方:有用户调侃,把「自动化了 7 个全职岗位」配上 🚨 当成产品发布来宣传,而且每周用 30 小时本身就像一份新的全职工作。
阅读全文
关联模型 / 智能体 / 厂商:

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

商汤 10 月 30 日在官方 X 账号和 Hugging Face 发布 SenseNova-Loop-9B-Preview(Apache 2.0)。它把 32 层解码器里的第 4–27 层用同一套权重连跑两遍,每次前向执行 56 层计算,存储约 9B 参数、推理参数约 14.6B,并用两路 mHC(流形约束超连接)管理残差流。模型支持文本加图片输入,训练序列最长 262,144 token。官方图表显示它在 BIRD-Dev、WorkBuddy Bench 等多项 Agent 与数据任务上超过 Qwen3.5/3.6 同级模型,但 Terminal Bench 2.1 仍落后;技术报告尚未发布。官方 X 首帖约 910 赞。

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

核心要点速览

  • 结构:32 个不同解码层、第 4–27 层共享权重循环 2 遍,每次前向共 56 层计算;约 9B 存储参数、约 14.6B 推理参数(模型卡)
  • 官方口径跑分:BIRD-Dev 71.38(Qwen3.5-27B 69.84)、WorkBuddy Bench 66.89(Qwen3.6-35B-A3B 61.98)、AutomationBench 13.72(Qwen3.5-27B 10.17)
  • 短板同样来自官方图表:Terminal Bench 2.1 为 40.45,低于 Qwen3.6-27B 的 47.19;τ³-Banking 18.56,略低于 Qwen3.5-27B 的 19.59
  • 训练上下文最长 262,144 token;混合注意力为每 4 层 3 层线性注意力加 1 层全注意力;已支持 MTP 加速,DSpark/DFlash2 仍在训练
  • Apache 2.0 许可,需 trust_remote_code=True;官方给出 Transformers 5.18.0、LightLLM 4 卡和 SGLang PR 部署示例,技术报告待发布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova-Loop-9B-Preview⚡ Qwen3.5-27B⚡ Qwen3.6-35B-A3B🌐 SenseTime
AD赞助内容
O
OpenAIhelp.openai.com·
👀48
🔥83

OpenAI 宣布 12 月起 ChatGPT 与 Codex 共用一份按 token 计的额度:覆盖 Plus、Pro 和 Business,Instant 聊天不计入

OpenAI 帮助中心 10 月 31 日新增《Understanding ChatGPT and Codex usage limits》页面:从 12 月起,Plus、Pro 和 Business 套餐的使用额度将在 ChatGPT 与 Codex 之间共享,原因是要把 Work 的 Agent 能力并入 ChatGPT 主界面。用量改按 token 计,模型越强、任务越复杂消耗越快;Instant 聊天不消耗额度。用户可在「设置 → 用量」查看合并后的剩余额度和重置时间,用完后可等重置、升级套餐或购买额度。OpenAI 官方称预计大多数用户等待重置的频率不会比现在更高,但尚未公布具体上线日期和各套餐额度。该消息在 X 上引发大量 Plus 用户担忧。

核心要点速览

  • 时间:12 月起生效,具体日期官方未公布;覆盖 Plus、Pro、Business 三类套餐(OpenAI 帮助中心)
  • 计量:统一按 token 计,Instant 聊天不计入;Business 定价页也已加注「12 月起套餐用量在 ChatGPT 与 Codex 之间共享上限」(Business 定价)
  • 现状参考:目前只有 Work 与 Codex 共用额度,Plus 每 5 小时本地消息估算为 GPT-6 Astra 5–45 条、GPT-6.1 Sol 15–160 条、GPT-6 Luna 350–3,000 条(官方估算,帮助文档)
  • Pro 100/200/500 目前在 Work 与 Codex 中没有 5 小时上限,合并后各套餐额度官方未公布
  • 官方口径:预计大多数用户等待重置的频率不会比现在更高;用完可等重置、升级或买额度
阅读全文
A
Anthropic (Claude Help Center)support.claude.com·
👀12
🔥82

Anthropic 把文本水印扩展到旧款 Claude:Mythos 5、Opus 4.7/4.6、Sonnet 4.6 输出将带隐形水印,媒体称 11 月 3 日生效

Anthropic 官方帮助中心「How Claude marks AI-generated content」(10 月 28 日更新)的支持表已把 Claude Mythos 5、Opus 4.7、Opus 4.6、Opus 4.5、Sonnet 4.6、Sonnet 4.5 等 8 月 2 日前发布的旧模型列入「第一方产品文本水印」,并写明正在为这些模型补加水印,以履行欧盟 AI 法案第 50 条透明度义务。据 MACCUS 等媒体披露的 Anthropic 客户邮件截图,旧模型水印 11 月 3 日起生效,Amazon Bedrock 可能晚几天;具体日期官方公开页面未写明。水印基于 Google DeepMind 的 SynthID-Text 方法,不加隐藏字符、不多耗 token,检测 API 目前只对监管、媒体、研究者等合规机构私测开放,X 上不少用户对「无法自查」表达不满。

Anthropic 把文本水印扩展到旧款 Claude:Mythos 5、Opus 4.7/4.6、Sonnet 4.6 输出将带隐形水印,媒体称 11 月 3 日生效

核心要点速览

  • 覆盖范围:官方支持表中,Mythos 5、Opus 4.7/4.6/4.5、Sonnet 4.6/4.5 等旧模型目前只勾选了「第一方产品文本水印」一列;云厂商输出水印和 C2PA 文件凭证仍只在 8 月 2 日后的新模型上(见 帮助中心)
  • 时间:媒体披露的客户邮件称 11 月 3 日起生效、Bedrock 可能晚几天(MACCUS 报道,官方公开页面未写日期)
  • 成本与质量:官方称水印不加任何字符、不多耗 token、不涨价,方法是 SynthID-Text 的一个变体(见 Anthropic 说明)
  • 检测:检测 API 为私测,仅对监管、执法、媒体、事实核查、研究者及有合规义务的企业开放,普通用户暂无法自查
  • 覆盖面:水印在 Claude、Claude Platform API、Claude Code、Cowork、Tag 等所有支持的产品上全球统一生效,因为官方「暂无按地区区分的可靠办法」
阅读全文

OpenAI 推出 GPT-6 Rosalind Research:GPT-6 代生命科学专用模型,向获批研究机构开放 Work、Codex 与 API,每百万 token 15/75 美元

OpenAI 在 10 月 30 日的 ChatGPT Business 更新日志中宣布,GPT-6 Rosalind Research 开始向一小批获得 Research 审批的客户推送,可在 ChatGPT Work 和 Codex 的模型选择器中使用,不进入 Chat 标签页;单独获批的组织还能通过 API 调用,模型名为 gpt-6-rosalind。按 Enterprise 按 token 计费的价目表,它的价格是每百万输入 token 15 美元、缓存输入 1.50 美元、输出 75 美元,是上一代 GPT-5.5 Rosalind Research 的 3 倍。

核心要点速览

  • 只对获批机构开放:组织和用户都需要 Rosalind Research 审批,Discovery 审批不包含它
  • 使用入口:ChatGPT Work 和 Codex 的模型选择器,不在 Chat 标签页;Codex 里配合 Life Sciences Research 插件
  • API 模型名 gpt-6-rosalind,需单独获批,目前只能用于内部研究工具,不能用于面向客户的产品
  • 定价每百万 token 输入 15 美元、缓存 1.50 美元、输出 75 美元,GPT-5.5 Rosalind Research 为 5/0.50/25 美元
  • Enterprise 工作区先有两周 Admin Preview,默认关闭,需管理员为获批用户开启
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-6 Rosalind Research⚡ GPT-5.5 Rosalind Research⚡ GPT-6 Astra🤖 Codex🤖 ChatGPT Work🌐 OpenAI

CrowdStrike:中国关联组织 VAPOR PANDA 用 ARTEX 多智能体框架(主用 DeepSeek)11 天内攻击 200 多家机构

CrowdStrike 于 10 月 29 日发布报告:中国关联的间谍组织 VAPOR PANDA 自 10 月 17 日起,用开源 agent 入侵框架 ARTEX 搭配 DeepSeek 和另一款未能确认的商业大模型,在 11 天内从同一个控制端对至少 14 个国家的 200 多家机构发起攻击,确认 9 家被攻入并植入 BLOODALCHEMY 后门。单次入侵中规划 agent 就消耗约 14 亿输入 token;恢复的对话记录显示有人类操作员用中文在关键节点下指令。

核心要点速览

  • 10 月 17 日起 11 天,同一个 ARTEX 控制端攻击至少 14 个国家、200 多家机构,涉及多国外交部、美国 19 家制药/半导体/国防/核能/金融机构,以及美国、比利时、菲律宾的电信商(CrowdStrike 报告)
  • 确认 9 家机构被攻入并部署 BLOODALCHEMY 后门,另有至少 12 家遭密码喷洒和凭据扫描
  • 主用 DeepSeek,外加一款 CrowdStrike 未能确认的订阅制商业大模型;单次入侵中规划 agent 约消耗 14 亿输入 token
  • 恢复的记录里人类操作员用「【人类指令】」标签下中文指令,还要求 agent 找出「没有装猎鹰(Falcon)」的 Windows 主机
  • CrowdStrike 称这与微软此前报道的 Storm-0940 使用 ARTEX 是两起不同活动,并判断未来 12 个月中国关联组织「极可能」继续采用此类 agent 框架
阅读全文
关联模型 / 智能体 / 厂商:

AWS GovCloud 上线 OpenAI Daybreak Red(GPT-5.6 Cyber):仅限认证防御方,输入 $16.875、输出 $101.25 每百万 token

AWS 10 月 30 日宣布,OpenAI 面向漏洞研究的网安模型 Daybreak Red(GPT-5.6 Cyber,模型 ID openai.gpt-5.6-cyber)在 Amazon Bedrock 的 AWS GovCloud (US-East) 上线,此前只在 US East (Ohio) 提供。需先通过 OpenAI 的 Daybreak 资格审核。GovCloud 短上下文定价为输入 $16.875、输出 $101.25 每百万 token,比 Ohio 的 $13.75 / $82.50 高约 23%。

核心要点速览

  • 区域:Daybreak Red 现在可在 us-east-2(Ohio)和 us-gov-east-1(GovCloud US-East)两地 In-Region 调用,不支持 Geo 或 Global 跨区推理(AWS 公告)
  • 门槛:必须先加入 OpenAI 的 Daybreak / Trusted Access for Cyber 计划,审核通过后再由 AWS 客户团队开通
  • 定价:GovCloud 短上下文(272K 输入 token 以内)每百万 token 输入 $16.875、30 分钟缓存写入 $21.09375、缓存读取 $1.6875、输出 $101.25
  • 数据:AWS 称推理数据不用于训练,无需把 Daybreak Red 数据分享给 OpenAI,运行在芯片级强制零运维访问的推理引擎上
  • 接口:走 bedrock-mantle 端点,支持 OpenAI Responses 与 Chat Completions,上下文窗口 1,050,000 token
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Claude Code 负责人 Boris Cherny 回应「额度消耗过快」:逐个排查用户会话,未发现回归,几处小问题的修复正在推送

10 月 21 日起不少开发者在 X 上抱怨 Claude Code 额度消耗明显变快。Anthropic 的 Claude Code 负责人 Boris Cherny 于 10 月 28 日(UTC)在 X 上回复:团队看完了用户提交的全部会话 ID,没有找到单一根因,也没有发现 Claude Code 的回归;找到几处让部分会话多耗 token 的小问题,修复正在推送。多数「掉得快」的情况可追溯到一两个重度会话,如 xhigh effort、/goal、Workflows、Agent Teams 和长时间 SDK 任务。

核心要点速览

  • 引发讨论的原帖称额度「掉得快 5 倍」,获约 1,660 个赞、240 多条回复(用户说法,非官方数据)
  • Boris Cherny:逐一检查了用户提交的会话 ID,未发现单一根因或 Claude Code 回归,几处小问题的修复正在推送
  • 重度用法是主因:xhigh effort、/goal、Workflows、Agent Teams、长时间 SDK 任务
  • 子智能体默认继承会话的 effort 等级,容易叠加;/usage 可查看 token 去向
  • 官方文档称 Agent Teams 在 plan 模式下约比普通会话多用 7 倍 token
阅读全文
关联模型 / 智能体 / 厂商:

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

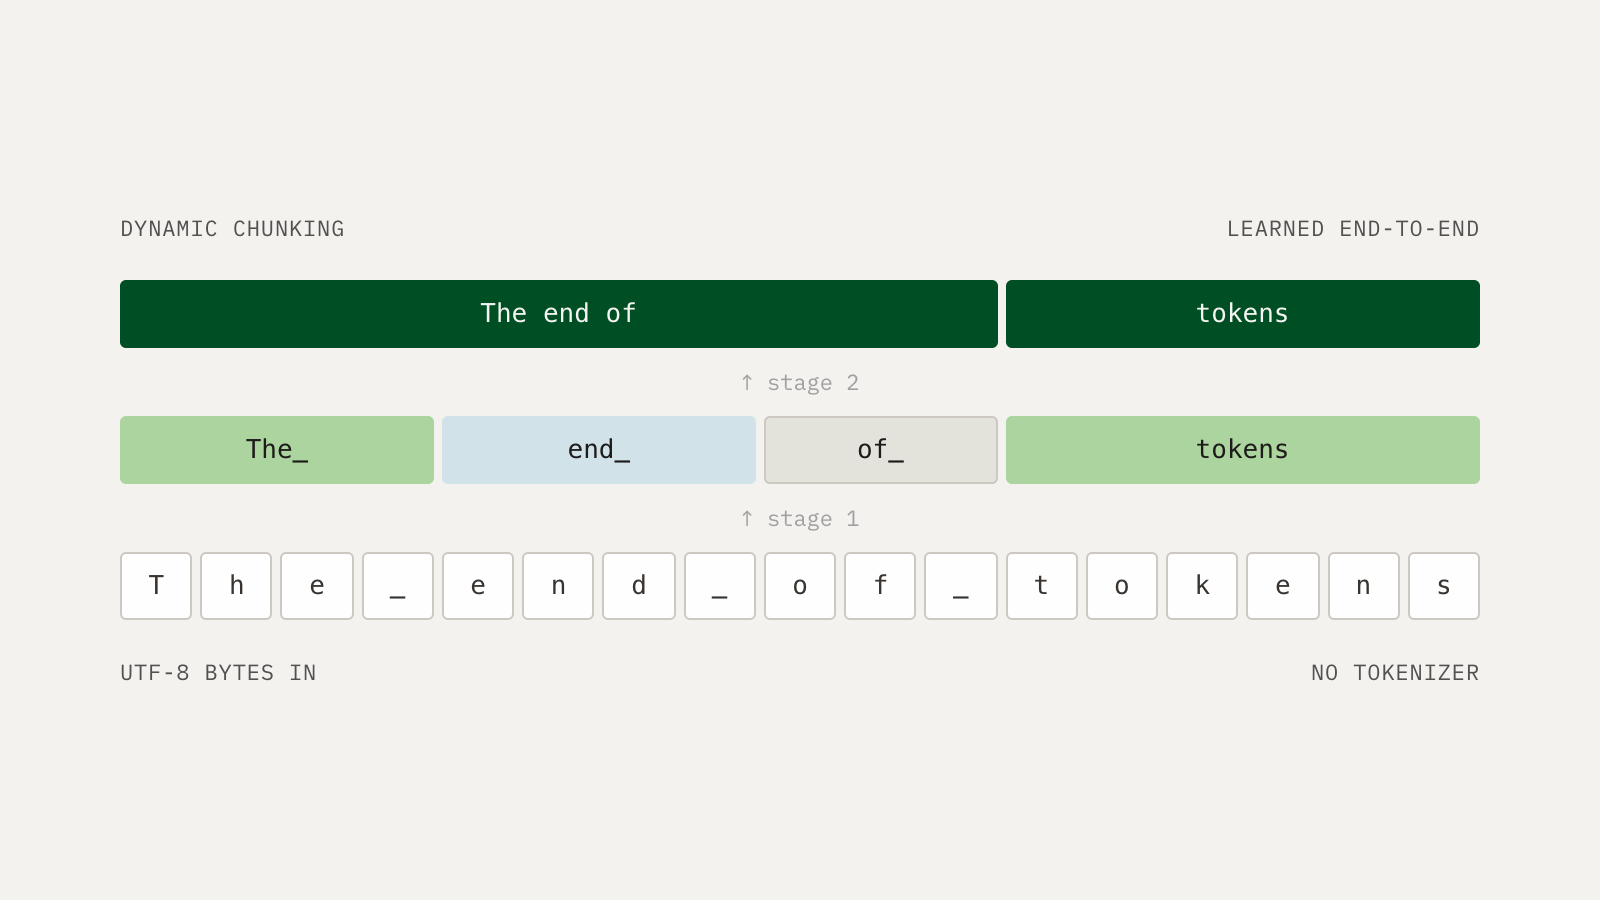
Mamba 作者、Cartesia 首席科学家 Albert Gu 团队 10 月 28 日发布两篇研究博客,公布新一代分层网络 H-Net 的扩展结果:在严格对照的 scaling ladder 中,只把 BPE 分词换成学习式动态分块,就获得最高 3–5 倍计算效率提升;更大的两阶段字节级 H-Net(3.67B 参数)在与 SmolLM3-3B 每字节算力对齐的条件下,约 1T token 即达到 SmolLM3 训练 11T token 后的平均下游分数(厂商口径)。新架构尚未开源,官方称计划逐步发布。

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

核心要点速览

  • 对照实验(官方口径):1 阶段 H-Net 直接替换 BPE,验证损失约 1.3 倍、代码约 2 倍计算效率,整体最高 3–5 倍
  • 大模型对比:两阶段字节级 H-Net 3.67B 参数 vs SmolLM3 3.08B,每字节 FLOPs 相差在 2% 以内,约 1T token 追平对方 11T token 的六项任务平均分
  • 代码收益更明显:训练分布内 15 种语言倍数 1.49x–2.40x(中位 2.04x),分布外 10 种语言中位 3.10x,Prolog 最高 5.37x
  • 训练数据配比为英文 70%、代码 20%、数学 5%、多语言 5%;主网络约每 7.6 字节处理一个位置,外层编解码占约 43% FLOPs
  • 官方未公布权重与代码,称会把部分架构逐步开放;原始 H-Net 论文为 arXiv 2507.07955
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-Net⚡ SmolLM3-3B⚡ Mamba-2🌐 Cartesia🌐 Hugging Face

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文

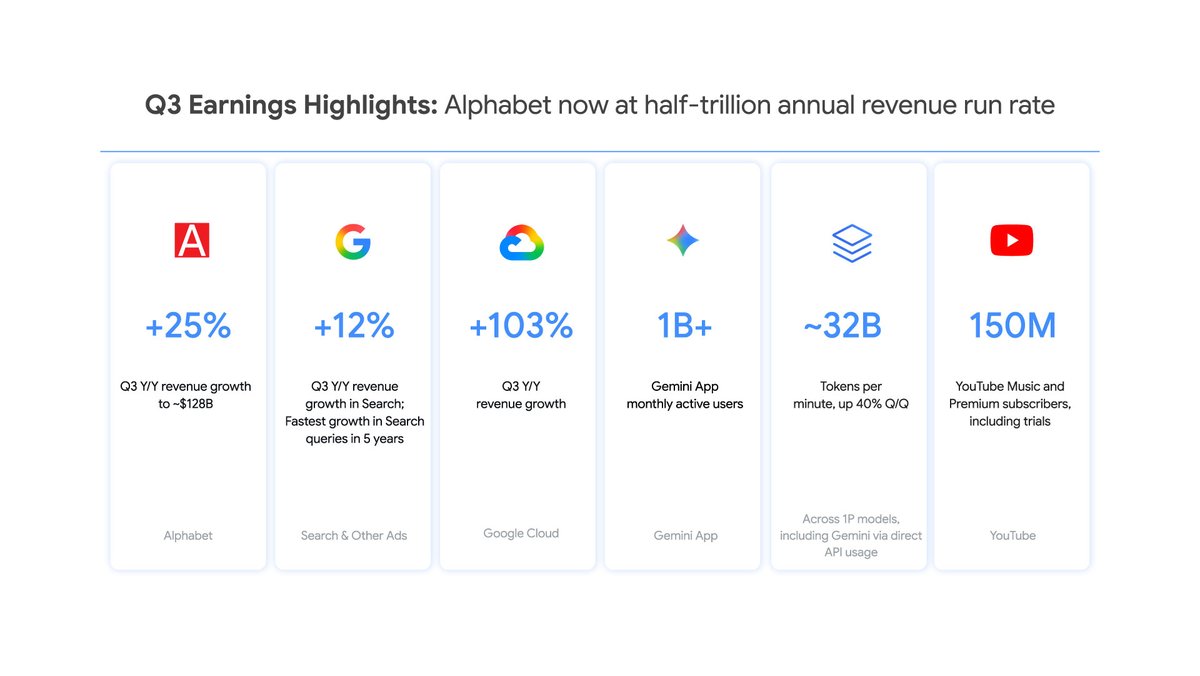
Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

Alphabet 10 月 28 日美股盘后发布 2026 年第三季度财报:营收 1276 亿美元,同比增长 25%;Google Cloud 营收 307 亿美元,同比增长 103%,官方称由企业 AI 基础设施、AI 解决方案和 TPU 系统销售拉动。Sundar Pichai 在财报和 X 上表示,一方模型 API 每分钟处理近 320 亿 token,是一年前的四倍多,Gemini App 用户达到 10 亿。代价是本季资本开支 514 亿美元,自由现金流为负 91 亿美元。

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

核心要点速览

  • 营收 1275.77 亿美元,同比 +25%,连续第 13 个季度两位数增长;Pichai 称年化营收已达 5000 亿美元
  • Google Cloud 营收 307.09 亿美元(去年同期 151.57 亿),同比 +103%;经营利润 111.21 亿美元,去年同期 35.94 亿
  • 一方模型 API 每分钟近 320 亿 token,是一年前的 4 倍多;Pichai 的 X 帖称环比增长 40%
  • Gemini App 用户达 10 亿,官方称是 Google 史上增长最快的产品;Search 查询量同比增速为近 5 年最高
  • 本季资本开支 513.55 亿美元(去年同期 239.53 亿),自由现金流 -90.65 亿美元,连续第二个季度为负
阅读全文

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文