AI 编程实时动态与要闻

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

独立评测机构 Artificial Analysis 11 月 4 日在 X 上宣布,把金融会计、战略运营、法律、医疗、工程、经济六个 Capability Indexes 升级到 v2.0,与 Intelligence Index v5.0 的评测对齐,并更重视 Non-Hallucination(不编造)和 Agentic Tool Use。各指数统一把 HLE 换成 HLE-Diamond、AA-Omniscience 升到 v1.1,并移除 GDPval-AA;工程指数新增 Science 能力项。官方结果:Claude Opus 5.5 (max) 六项全部领先,GPT-6 Astra (max) 在金融会计、法律、工程排第二;开放权重阵营中 Kimi K3.1 Pro(权重尚未发布)六项都领先,排在第 5 到第 8 名。

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

核心要点速览

  • 六个指数把 O*NET 职业任务映射到对应 benchmark,按能力在该职业中出现的频率加权(方法论页)
  • 通用改动:HLE 升为 HLE-Diamond,AA-Omniscience 升为 v1.1,各指数的 Agentic Knowledge Work 都去掉 GDPval-AA(改由 AA-Briefcase v1.1 承担)
  • 金融会计与法律指数中 Non-Hallucination 权重升到 15%;战略运营指数 Agentic Tool Use(AutomationBench-AA)升到 35%,为单项最高
  • 工程指数新增 Science(20%,CritPt v2 Hard Subset + Terminal-Bench-Science 0.1),Agentic Coding 加入 FrontierCode 2.0;经济指数用 GDP.pdf 取代 AA-LCR
  • 官方结果:Claude Opus 5.5 (max) 六项第一;开放权重中 Kimi K3.1 Pro 六项领先,MiniMax-M3.1-Flash 在战略运营(#10)、DeepSeek V4.1 Flash 1017 (max) 在医疗(#12)领先
阅读全文

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

2026-10-23(UTC 15:41,SGT 23:41),NVIDIA AI 官方账号 @NVIDIAAI 宣布 Nemotron 3.5 Bolt E4B 4GB 上线,定位是能对话、能调用工具的本地小模型,用于本地助手、互动角色和机器人。Hugging Face 官方模型卡显示:它由 Gemma-4-E4B-it 后训练而来,总参数 8B(有效 4B),Q4_K_M 量化,输入输出各支持最多 64K token,可开关思考模式,并提供 DFlash 推测解码草稿模型和 BF16 版本;权重、数据和训练配方开放,许可证为 OpenMDW-1.1,可商用。模型卡跑分中,4GB 量化版 MultiChallenge 55.60(Gemma4 E4B-it 同量化 39.36、Qwen3.5 4B 52.23),但 Tau2-Bench 52.32、BFCL-v3 67.31 低于 Qwen3.5 4B。

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

核心要点速览

  • NVIDIA 官方发布 Nemotron 3.5 Bolt E4B 4GB,面向本地助手、互动角色和机器人
  • 基于 Gemma-4-E4B-it 后训练,总参数 8B(有效 4B),Q4_K_M 量化,64K 上下文,可开关思考模式
  • 权重、数据、训练配方开放,OpenMDW-1.1 许可可商用,附 DFlash 推测解码草稿模型
  • 模型卡跑分:MultiChallenge 55.60 领先同级,但 Tau2-Bench 和 BFCL-v3 不及 Qwen3.5 4B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Bolt E4B⚡ Gemma 4 E4B🌐 NVIDIA🌐 Google

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

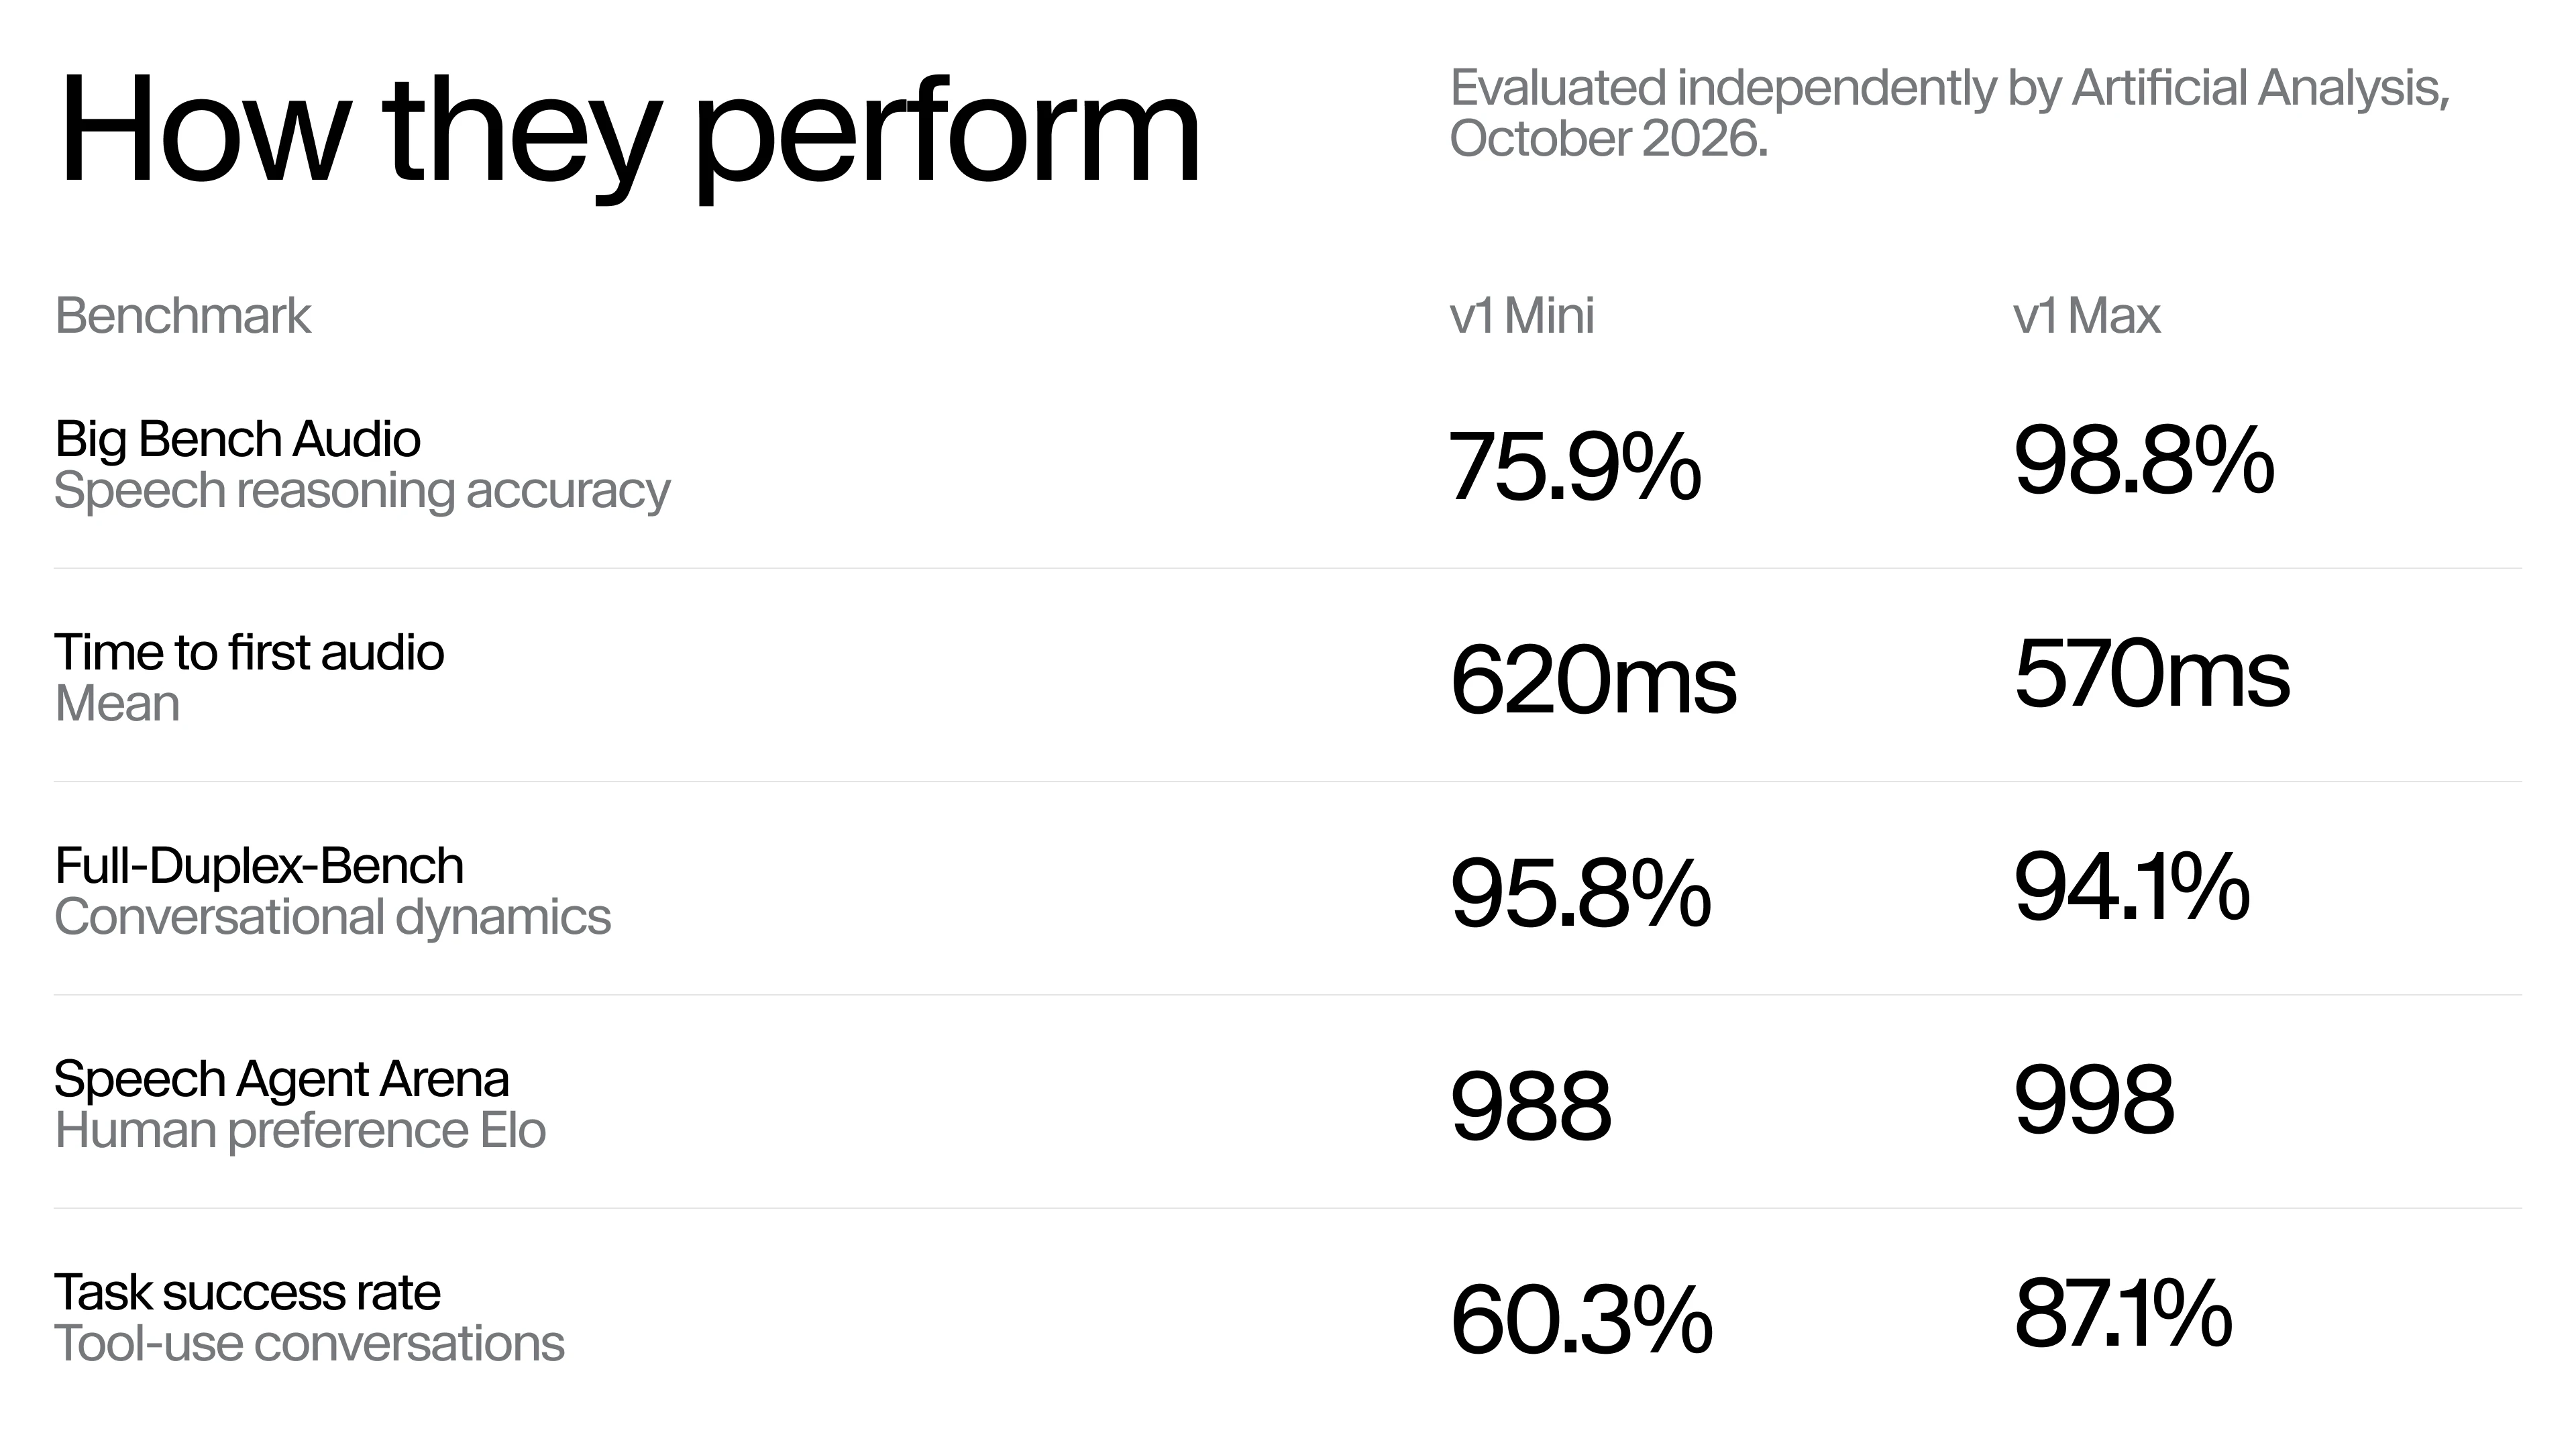
10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

Liquid AI 10 月 13 日发布 LFM2.5 家族最大也是最后一款模型 LFM2.5-24B-A2B:总参 24B、每 token 激活约 2.45B,131K 上下文,强制先思考再回答。厂商口径下在 8 项工具/Agent 基准中 5 项领先或持平 Qwen3.6-35B-A3B(AutomationBench 27.69 vs 8.72),但 SWE-Bench Verified、GPQA 等知识与编码项落后。权重已上 Hugging Face,并有 GGUF/MLX/FP8/ONNX 版本;API 定价 $0.10/$1.00 每百万 token,OpenRouter 同步上架。

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

核心要点速览

  • 规格(模型卡):总参 24.0B、激活 2.45B;40 层(30 个门控短卷积块 + 10 个 GQA);每个 MoE 块 64 专家 top-4 路由;上下文 131,072、词表 128K
  • Agent 基准(厂商口径,对比 Qwen3.6-35B-A3B):AutomationBench 27.69 vs 8.72、LiveClaw 48.09 vs 38.19、ToolSandbox 80.71 vs 75.02、BFCLv4 65.01 vs 65.00
  • 短板同样公开:SWE-Bench Verified(OpenCode)51.00 vs 66.20、GPQA Diamond 74.42 vs 83.69、WebArena Verified 26.75 vs 37.62,官方建议知识类任务搭配检索
  • 速度(官方博客):Apple M5 Max 解码 184 tok/s、AMD Ryzen AI Max+ 395 为 114 tok/s;单张 B300 + SGLang 高并发超 21K 输出 tok/s
  • 训练:预训练由 17T 扩到 33T token,中训 2T@32K + 300B@131K;后训练含在 OpenClaw、Hermes Agent、Pi、OpenCode 中的 Agentic RL;API $0.10 输入 / $1.00 输出每百万 token
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LFM2.5-24B-A2B⚡ LFM2.5-24B-A2B-Base⚡ LFM2-24B-A2B⚡ Qwen3.6-35B-A3B⚡ Gemma-4-26B-A4B-it🤖 Hermes Agent🤖 OpenClaw🤖 OpenCode🤖 Pi🌐 Liquid AI🌐 Hugging Face🌐 OpenRouter
AD赞助内容

IQuest-Q1 开源 320B MoE 编程 Agent 模型:15B 激活 / 524K 上下文,DeepSWE 64.6、Terminal-Bench 2.1 达 83.2

IQuest Research 的 IQuest-Q1(约 320B 总参 / 15B 激活、524K 上下文)面向仓库级编码、终端与长程工具调用;权重与部署镜像已在 Hugging Face / GitHub。官方同管线自评:DeepSWE v1.1 64.6、NL2Repo 63.0、CyberGym 84.5、Terminal-Bench 2.1 83.2;支持 SGLang/vLLM 与 Claude Code / Codex 接入。

IQuest-Q1 开源 320B MoE 编程 Agent 模型:15B 激活 / 524K 上下文,DeepSWE 64.6、Terminal-Bench 2.1 达 83.2

核心要点速览

  • 规格:~320B MoE / ~15B 激活、88 层、256 专家激活 8、524,288 上下文;混合注意力 3×SWA+1×FA(HF 模型卡)
  • Agent 编码自评:DeepSWE v1.1 64.6(DeepSeek-V4.1-Flash 74.2 / Opus 5 73.7);NL2Repo 63.0(Opus 5 75.3)
  • 终端与安全:Terminal-Bench 2.1 83.2;CyberGym 84.5(与 GLM-5.3 并列,Flash 88.1)
  • 后训练:SFT+RL,并强调 Multi-Teacher On-Policy Distillation(MOPD);官方声明仍属早期、文本-only
  • 落地:hf download IQuestLab/IQuest-Q1 + Docker 镜像 sglang-iquest-q1 / vllm-iquest-q1(tp=8);可接 Claude Code 2.1.140 / Codex 0.142
阅读全文

填补网安落地空白!MBZUAI 等开源 KaliBench:8,504 对严苛终端命令基准,8B 模型比肩 685B 巨兽

随着大模型加速渗透进网络安全工作流,安全专家期望智能体能够将自然语言攻防意图直接转化为精确的底层终端命令。然而现有评估往往局限于高阶选择题或模糊的端到端 Agent 任务,无法精确度量模型为真实网安工具生成可执行命令行(CLI)的能力。网络安全操作对语法极其严苛,微小的参数误绑定、参数顺序颠倒或漏配标志位即可导致渗透执行失败。来自 MBZUAI 等机构的研究学者推出了面向 Kali Linux 的细粒度自然语言到命令行转换基准 KaliBench,涵盖 23 个安全能力维度、5 大攻防阶段共 1,642 款真实安全工具的 8,504 组查询-命令对。评测发现开源模型在无提示约束下准确率普遍不足 42%;而结合 KaliBench 提供的无运行时可验证奖励进行强化微调后,8B 模型综合表现直接追平 685B 超大参数 MoE 旗舰。

填补网安落地空白!MBZUAI 等开源 KaliBench:8,504 对严苛终端命令基准,8B 模型比肩 685B 巨兽

核心要点速览

  • 全球首个涵盖 1,642 款 Kali Linux 网安工具的确定性命令行基准与 8,504 对实战命令集
  • 揭露开源模型在无工具提示盲测下命令准确率普遍不足 42% 的严峻语法幻觉短板
  • 提出无运行时依赖的可验证奖励机制,训练驱动 8B 小模型综合表现直接追平 685B MoE 巨型模型
阅读全文
关联模型 / 智能体 / 厂商:

KRAFTON 发布 PUBG Ally:首个大规模实战交互式具身游戏智能体,真机实测横跨 141 国

《绝地求生》(PUBG: BATTLEGROUNDS)开发商 KRAFTON 联合 AI 研究团队在 Hugging Face 与 ArXiv 正式公开了《PUBG Ally: A Conversational Embodied Agent as an AI Teammate》(arXiv: 2609.29837)。面对在复杂动态、毫秒级延迟与生死对抗的 AAA 级游戏中构建自主协同队友的极端挑战,团队打造了首个能边听边说、边打边战的全双工具身智能体 PUBG Ally。智能体采用“高层大模型策略决策 + 低层高频实时电机控制”的双层异构架构,并在全球 141 个国家进行了近 3.9 万场真实玩家在线匹配实战演练,净推荐值(NPS)正向超负向达 25.1 个百分点。

KRAFTON 发布 PUBG Ally:首个大规模实战交互式具身游戏智能体,真机实测横跨 141 国

核心要点速览

  • 首次将全双工语音大模型与毫秒级高频游戏控制层解耦融合,实现能听、能说、能报点、能战术突击的自主队友。
  • 首创“分层具身决策体系”:大模型处理全局战场态势与语音交流,底层极速控制器负责精细走位、瞄准压枪与扶人。
  • 采集近 3.9 万场真实人类组队对战数据(包含语音录音、环境反馈、微观按键与赛后评分),闭环自进化训练。
  • 在 141 个国家的实装公测中,确认与 Ally 并肩作战的人类玩家推荐好评度相比负面评价高出 25.1 个百分点。
  • 论文预印本、模型端侧量化方案与实时护栏安全规范已在 ArXiv 与 Hugging Face 全面公开。
阅读全文

阿里通义千问发布 Qwen3.8-Omni-Flash:百万上下文全模态,音视频推理成本降 60%

阿里云正式发布 Qwen3.8-Omni-Flash 全模态大模型。该模型原生支持 100 万 token 上下文窗口,专为实时端到端音视频理解、极速语音交互及复杂智能体工具调用优化,音视频推理资费相比上一代直降 60% 以上;同时宣布通义车载 AI 架构正式入驻比亚迪新一代智能座舱。

核心要点速览

  • 原生支持 100 万 token 超长上下文,实现极低延迟的全双工音视频端到端交互
  • 音频与多模态视频推理成本大幅降低超 60%,极速降低多模态智能体部署门槛
  • 深度入驻比亚迪新一代智能座舱,全面赋能意图识别、复杂任务规划与车控自动化
阅读全文
关联模型 / 智能体 / 厂商:

通义发布 Qwen3.8-Omni-Flash:首款面向智能体的原生全模态模型,视频输入成本约降 89%

阿里通义官方宣布 Qwen3.8-Omni-Flash:原生音视频理解、推理与工具调用合一,可自动剪辑 vlog、翻译短视频、把电影压成摘要。音视频能力逼近 Gemini 3.8 Flash;WildClawBench-MM 与 UniClawBench 智能体表现平均 +19.5 分;1M 上下文并开源 Qwen-MM-Plugins,Qwen-Live Harness 即将推出。相对 Qwen3.5-Omni-Plus,视频输入成本约降 89%。

核心要点速览

  • 官方 @Alibaba_Qwen 发布 Qwen3.8-Omni-Flash:原生全模态 + 工具编排,面向长程音视频智能体工作流。
  • 音视频逼近 Gemini 3.8 Flash;WildClawBench-MM / UniClawBench 智能体均分约 +19.5;1M 上下文,OmniVideoBench 上代币用量约少 51.8%。
  • 相对 Qwen3.5-Omni-Plus 视频输入成本约降 89%;开源 Qwen-MM-Plugins,Qwen-Live Harness 即将上线;API/Studio/Blog 已开放。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen Qwen3 8 Omni Flash🌐 Qwen (通义千问)

Ternary Bonsai 2 27B 开源发布:5.9GB 保留 98.2% 性能,强化编码与长程代理

PrismML 发布 Ternary Bonsai 2 27B,基于 Qwen3.8 27B 的三值权重模型,体积约 5.9GB,相比全精度版本缩小 9 倍,同时保留 98.2% 的综合基准性能。官方称新版本在智能体编码、多模态推理和长程工具使用上显著提升,并以 Apache 2.0 开源。

核心要点速览

  • 基于 Qwen3.8 27B 的三值权重模型约 5.9GB,比全精度版本小 9 倍。
  • 官方称其保留 98.2% 的综合基准性能,并重点提升智能体编码、多模态推理与长程工具使用。
  • 模型已按 Apache 2.0 开源,并提供 Hugging Face 权重、白皮书、WebGPU Demo 与配套 llama.cpp 分支。
阅读全文
AD赞助内容

Salesforce 发布 Koa:基于 NVIDIA Nemotron 的首个 CRM 推理模型,现已进入 Agentforce 试点

Salesforce 与 NVIDIA 在 Dreamforce 宣布 Koa——面向 Agentforce 的首个 CRM 推理模型,基于 NVIDIA Nemotron 3 Super 后训练,并用近 30 年 CRM 部署知识合成的专有数据塑造。官方称在 CRM 基准上匹配或超过领先模型表现,CRM 动作错误约少 3 倍;擅长多步工作流与工具调用;训练未使用客户数据。双方还将把 Nemotron 系模型与加速计算带入 Missionforce,面向政府与受监管环境的私有云/气隙部署。Koa 现已试点。

核心要点速览

  • Koa:基于 Nemotron 3 Super 后训练的首个 CRM 推理模型,服务 Agentforce 多步工作流
  • Salesforce CRM 基准称匹配/超过领先模型,CRM 动作错误约少 3 倍;未用客户数据训练
  • 同步把 Nemotron 与加速计算带入 Missionforce;Koa 现已试点
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis:GPT-Live-1(Astra)登顶 Speech to Speech Index,得分 81.5

Artificial Analysis(@ArtificialAnlys)公布 Speech to Speech Index:OpenAI GPT-Live-1 在委托后端为 Astra(medium)时以 81.5 分登顶,Sol(low)为 80.1 排第 3,夹在中间的是 Grok Voice Think Fast 2.0 High(81.3)。GPT-Live-1 为全双工语音模型,可在对话中把推理与工具调用委托给后端文本模型;同批评测还覆盖 Speech Agent Arena、Tau Voice、Big Bench Audio 与成本/首音延迟。

核心要点速览

  • GPT-Live-1(Astra medium)Speech to Speech Index 81.5 登顶;Sol low 80.1 排第 3。
  • Tau Voice 智能体榜:Astra medium 67.9%、Sol low 59.3%,分列前两名。
  • 成本约 $5.83/$4.47 每小时输入音频(含后端);首音延迟约 1.34s/1.24s,慢于 Grok Voice 0.70s。
阅读全文
关联模型 / 智能体 / 厂商:

上海 AI Lab 开源 Atria Dawn Preview:基于 744B MoE GLM-5.2 的长程智能体模型,MIT 许可

上海人工智能实验室发布 Atria Dawn Preview:面向长程研究/工程任务的智能体基础模型,基于 744B 参数 MoE GLM-5.2,支持工具使用、代码与实验闭环。权重已上 Hugging Face(internlm)与 ModelScope,另有 FP8 版与 256K 上下文,并提供 GitHub、网站与 API 试用入口。

核心要点速览

  • Atria Dawn Preview 基于 744B MoE GLM-5.2,面向长程研究与工程智能体任务。
  • 开源权重已上 Hugging Face/ModelScope,含 FP8 与 256K 上下文,MIT 许可。
  • 覆盖 Discovery/Creation/Delivery/Cybersecurity 四类端到端生产力场景,并提供 API 试用。
阅读全文
关联模型 / 智能体 / 厂商:

上海 AI Lab Intern-S2-397B 上线 BF16/FP8:SWE-bench Multilingual 84.0,Apache-2.0

ModelScope 宣布上海人工智能实验室 Intern-S2-397B 以 BF16 与 FP8 权重开放(Apache-2.0)。官宣分数含 FrontierScience-Olympiad 87.0、SWE-bench Multilingual 84.0,并强调长时程 agent RL、工具使用与 thinking/non-thinking 模式;训练直接吃原始科学页面(文/图/符号),覆盖 20+ 科学域。合集见 modelscope.ai。

核心要点速览

  • BF16/FP8 权重开放,协议 Apache-2.0,可在 ModelScope 获取。
  • SWE-bench Multilingual 84.0、FrontierScience-Olympiad 87.0,官宣为对比榜领先。
  • 长时程 agent RL 强化工具调用与持续执行,并提供 thinking / non-thinking 模式。
阅读全文
关联模型 / 智能体 / 厂商:

AWS 开源 Pizza Bot:面向后台 AI Agent 的邮件式收件箱,Apache-2.0 可自托管

AWS 将内部曾服务超 2000 人的 Pizza Bot 以 Apache-2.0 开源:自托管应用用邮件式界面汇总后台 agent 的完成结果与待审批决策,支持 Bedrock/Anthropic/Gemini/OpenAI/OpenRouter/Ollama,并含 MCP、SKILL.md workers 与 interrupt/approval 策略,提供桌面与浏览器/终端入口。

核心要点速览

  • 源自亚马逊内部工具,现以 Apache-2.0 开源并可自托管。
  • 邮件式收件箱汇总后台 agent 结果与待审批决策。
  • 支持多模型供应商、MCP、SKILL.md workers 与 interrupt/approval 策略。
阅读全文
关联模型 / 智能体 / 厂商: