AI 编程实时动态与要闻

Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2:降价至每百万 token 输入 8 美元、输出 40 美元,FrontierCode 2.0 拿下 49.1% 刷新已发布模型最高分,1000 个 Agent 30 小时完成费马大定理形式化

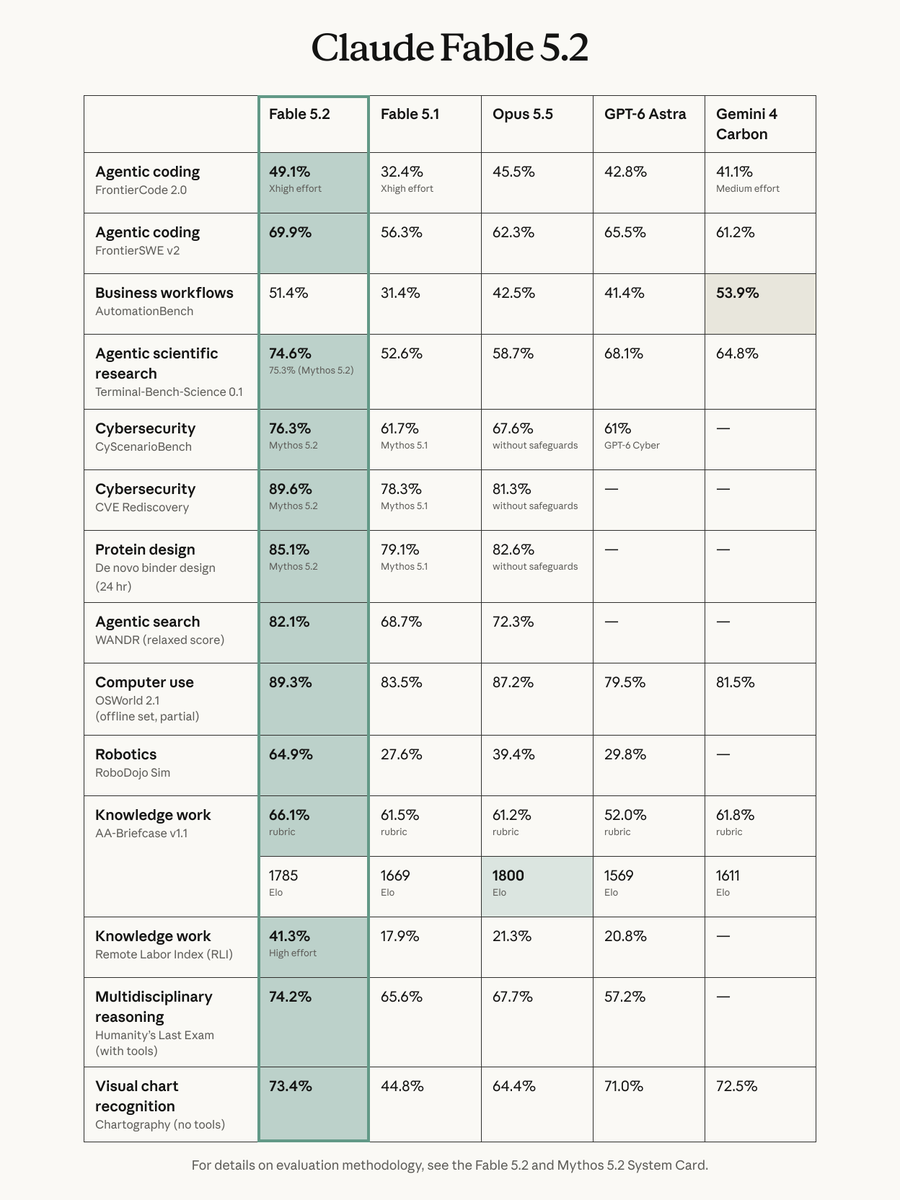
北京时间 11 月 10 日凌晨 2:58,Claude 官方账号发布 Claude Fable 5.2 和 Claude Mythos 5.2。两者是同一个底层模型:Fable 带有网络安全和生物安全防护,面向所有付费用户、Claude Platform 和各大云平台开放;Mythos 去掉部分防护,只通过网络安全与生命科学验证计划提供给审核过的机构。价格从 Fable 5.1 的每百万 token 10/50 美元降到 8/40 美元,输出速度最多快 30%,另有最多提速 2.5 倍的 fast mode(16/80 美元)。官方口径下,Fable 5.2 在 FrontierCode 2.0 上以 Xhigh 档拿到 49.1%,高于 Opus 5.5 的 45.5% 和 GPT-6 Astra 的 42.8%;High 档与 Opus 5.5 最高分持平,单任务成本约为一半。API 模型名为 claude-fable-5-2。
Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2:降价至每百万 token 输入 8 美元、输出 40 美元,FrontierCode 2.0 拿下 49.1% 刷新已发布模型最高分,1000 个 Agent 30 小时完成费马大定理形式化

核心要点速览

  • 定价:$8 / $40 每百万 token(输入/输出),比 Fable 5.1 的 $10 / $50 便宜 20%;fast mode 最多提速 2.5 倍,价格 $16 / $80
  • 编码(官方口径):FrontierCode 2.0 Xhigh 档 49.1%(Opus 5.5 为 45.5%,GPT-6 Astra 为 42.8%);High 档 45.3% 追平 Opus 5.5 最高分,单任务成本约 一半;FrontierSWE v2 69.9%
  • 长程 Agent:1000 个 Fable 5.2 Agent 用 30 小时 完成费马大定理的 Lean 形式化,同样配置下 Opus 5.5 18 小时只完成 26%;一名工程师让它协调 1000 多个子 Agent 连续 8 天写出可在笔记本上启动的原型操作系统
  • 其他跑分(官方口径):RoboDojo Sim 64.9%(Fable 5.1 为 27.6%)、HLE(带工具)74.2%、OSWorld 2.1 89.3%、Remote Labor Index 41.3%;Mythos 5.2 CVE Rediscovery 89.6%
  • 防护:Fable 与 Mythos 是 同一模型;Fable 5.2 的安全分类器误拦截比 5.1 少约 55%;preserved thinking 防蒸馏功能扩展到 所有账号
阅读全文

Stripe 开放「用 Agent 分析数据」:全量用户可经 MCP / Queries / Reports API 自然语言查 MRR、欺诈与对账,Queries 免费至 2027-01-31

Stripe 于 11 月 5 日宣布,所有用户都可通过 Stripe MCP 或直接调用 Queries / Reports API,用 Claude、Cursor 等兼容 Agent 以自然语言分析自家 Stripe 数据,包括 MRR、流失、欺诈与对账。Reports API 内置 300+ 表建模与用法指引;Queries API 免费至 2027 年 1 月 31 日,之后按用量计费,Reports API 保持免费。每次分析可核对底层 SQL。

Stripe 开放「用 Agent 分析数据」:全量用户可经 MCP / Queries / Reports API 自然语言查 MRR、欺诈与对账,Queries 免费至 2027-01-31

核心要点速览

  • 覆盖:全量 Stripe 用户可用;经 MCP 或 Queries / Reports API 直连 Claude、Cursor 等兼容 Agent
  • 能力:自然语言查 MRR、扩张/收缩/流失、欺诈、对账与付款表现;可拼 PostHog 等外部工具上下文
  • 数据:Reports API 带 300+ 表建模与用法指引;每次分析可检查并编辑底层 SQL
  • 定价(官方):Queries API 免费至 2027-01-31,之后按 credit 计费、无月费;Reports API 持续免费
  • 权限:只读 Data Metrics / Queries / Reports;勿把 secret key 贴进聊天,用 agent API key 或 OAuth
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Vercel CEO Guillermo Rauch 称「AI 会把人类写的软件全部重写很多遍」,引发关于形式化验证与重写风险的争论

11 月 5 日 Rauch 在 X 发帖称,大多数人写的软件又慢、漏洞多、规格不清,AI 会把它们重写很多遍,并做形式化验证、压测和加固,「这才是软件工程真正的诞生」。帖子约 3,000+ 赞、270+ 转发、近 10 万浏览;赞同者举出用 AI 从零重写的案例,反对者提醒规格缺失和人工复核的问题。这是个人观点,不是 Vercel 官方公告。

核心要点速览

  • Rauch 原帖(11-05 02:22 UTC)约 3,060 赞、272 转发、681 收藏、约 9.9 万浏览(抓取时数据)
  • 核心观点:AI 会重写人类软件「很多遍」,并做形式化验证、压测、加固,把内存不安全的底层换成更稳的实现
  • 前一小时他还转发 Vercel Security Review 数据:24 小时发现 6,817 个漏洞、580 个严重/高危、Agent 已修 1,411 个(厂商口径)
  • 反方声音:重写缺规格的代码只会更快复制错误行为,形式化验证也不会让 bug 消失,只是上移到更高抽象层
  • 这是观点讨论,不是事实或官方路线图
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Grok Bot 工程师 poteto 称让 Agent 做对抗式代码审查「大多是浪费 token」,主张把 token 花在实证加形式化验证上

11 月 3 日,自我介绍为 SpaceXSI 旗下 Grok Bot 工程师、React Compiler 核心团队成员(曾在 Cursor、Meta、Netflix)的 @poteto(lauren)发帖,自称「也许是暴论」:她现在认为对抗式审查大多是在浪费 token,不如把这些 token 用在实证验证结合形式化验证上;她已调整自己的 Agent 技能包 pstack,减少调用 interrogate(多模型对抗审查)技能,以后可能直接移除。她还说抽象层面的代码审查价值很小,Agent 往往陷在吹毛求疵和 YAGNI 式意见里。帖子约 90.6 万浏览、9227 赞、5538 收藏,属个人观点,引发对 AI 代码审查价值的讨论。

核心要点速览

  • 观点(个人看法,非官方结论):对抗式审查「大多是浪费 token」,更值得投入的是实证验证 + 形式化验证
  • 行动:作者称已让 pstack 少用 interrogate 技能,未来可能移除;抓取时 GitHub 上 cursor/plugins 的 pstack 公开目录自 10 月 27 日后尚无新提交,具体改动未见公开
  • interrogate 是什么:按公开 SKILL.md,它为每个配置模型各开一个只读审查者(默认 Claude Opus 5.5 xhigh 与 Grok 4.7 xhigh fast)对 diff 做对抗审查,再分为 Act on / Consider / Noted / Dismissed 四档,不自动改代码
  • 作者身份(据其 X 与 GitHub 简介):Grok Bot @ SpaceXSI 工程师、React Compiler 核心团队,曾在 Cursor、Meta、Netflix
  • 热度:约 90.6 万浏览、9227 赞、5538 收藏、668 回复、356 转发、210 引用
阅读全文
AD赞助内容

X 热议:Claude Code 团队的 Addy Osmani 长文谈「认知投降」,提醒开发者在 Agent 干活时别交出批判性思考

X 简介为 Anthropic Claude Code 成员的 Addy Osmani(@addyosmani)11 月 3 日在 X 发布长文《Critical thinking when agents do the work》。他把人和 AI 的协作分成三档:认知卸载(把任务交给 AI 但自己对结果负责)、顺从(AI 输出直接变成你的输入)和「认知投降」(AI 的输出悄悄变成你的观点,你不再检查)。「认知投降」一词出自沃顿商学院的 Steven Shaw 和 Gideon Nave。他给出几条自检问题和验证习惯。发布约 3 小时内收获约 1400 赞、2400 次收藏、7 万多次浏览,并登上 X 热门。以下是作者观点,不是 Anthropic 官方公告。

核心要点速览

  • 三档光谱:认知卸载(委托但仍对结果负责,作者说他整天都这么做)、顺从(输出不再被当作假设)、认知投降(不再检查,直接当成自己的结论)。原文见 X 长文。
  • 作者的观点:模型越强,明显错误越少,输出「写得好、大体正确」,反而不再逼人看第二眼;同时跑多个 Agent,审阅的仍只有你一双眼睛。
  • 自检问题:提问前先写下自己的假设;分清是让 AI 帮你思考还是替你思考;想清楚「什么情况下它会错」并真的去测;让多个模型唱反调;能否当着维护者的面为结果下注。
  • 验证习惯:事先定义「验证通过」的标准(测试、截图、日志);绿灯只证明一个性质,要问它没证明什么;让 Claude Code 用全新上下文的子 Agent 自查,最后再问一句「我漏了什么?」。
  • 低风险的事可以完全交给 AI,代价落在别人身上的决定(要做什么、是否可以上线)要自己保留推理过程。
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

OpenAI 10 月 26 日发布博文,称其内部模型在数学、计算机科学和物理上各得到一项新结果:证明 Sogge 局部光滑化猜想在所有维度成立(进而推出 Kakeya 与 Stein 限制猜想);证明指数时间假设(ETH)为假,并已用 Lean 验证;给出四维 QCD 及含 Yang–Mills 在内的量子场论的严格存在性证明。数学和 CS 结果的论文与 Lean 证明已放到 GitHub 的 openai/math 仓库,物理结果由 David Gross 牵头的外部小组先行整理、暂不公开。这些都是官方口径,尚待学界独立验证。

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

核心要点速览

  • 计算机科学(官方口径):论文给出一个确定性算法,在亚指数时间、多项式空间内精确计数定宽 CNF 公式的满足赋值,3-SAT 情形即证伪 ETH;AI 于 10 月 16 日得出证明,10 月 17 日完成 Lean 形式化
  • ETH 由 Impagliazzo、Paturi 和 Zane 提出,已被数百篇论文用作条件下界;验证小组由 Impagliazzo、Paturi(UC San Diego)和 Ryan Williams(MIT)牵头,OpenAI 承诺资助一场专题会议
  • 数学:证明局部光滑化猜想在所有空间维度 n≥2 成立,推出 Kakeya、Nikodym 极大猜想与 Stein 限制估计;此前仅有 2019 年的二维证明和 2025 年的三维 Kakeya 证明
  • 物理:Yang–Mills 存在性的自然语言证明 9 月 9 日完成、QCD 9 月 18 日完成,Yang–Mills 部分的 Lean 形式化 10 月 16 日完成;材料由 David Gross 等 5 人小组整理,暂不公开
  • OpenAI 称不寻求学术署名,外部参与者自愿、无报酬、不签保密协议;openai/math 仓库 10 月 7 日曾因符号错误撤回 3 篇稿件,结论仍需独立核查
  • 物理结果后续(10 月 28 日):KITP 公布 Yang-Mills 工作组声明,委员会为 Michael Douglas、David Gross(主席)、Arthur Jaffe、Igor Klebanov、Nikita Nekrasov;Gross 10 月 16 日受 OpenAI 委托保管证明,委员会称对 OpenAI 不负任何责任,将先核对 Lean 形式化的定义与标准是否一致再公开 Lean 证明,确认正确后连同评估发布全部 1147 页证明;禁闭与质量间隙仍是未解难题
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Matt Pocock 发帖描绘理想的「agent 编程语言」——像 Rust 一样快、像 Go 一样少设计空间、类型校验最严格,点名 Bend,Chris Lattner 回帖推荐 Mojo

TypeScript 教育者 Matt Pocock(@mattpocockuk,Total TypeScript、AI Hero 作者)在 UTC 2026-10-25 17:23 发帖(原帖)称,下一个伟大的「agent 编程语言」应当像 Rust 一样快、像 Go 一样设计空间小、拥有有史以来最严格的类型/校验系统,并说 Bend 是「有意思的首次尝试」。抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览,进入 X 热门话题。Mojo 作者 Chris Lattner 回帖(回帖)推荐 Mojo,并建议把「能面向所有硬件」加进清单。这是观点讨论,不是已证实的结论。

核心要点速览

  • 主帖:原帖,UTC 10-25 17:23 发布,抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览
  • 三条标准:速度对标 Rust、设计空间小到像 Go(同一件事写法少)、类型/校验系统要「有史以来最严格」,思路是让编译器替人拦住 agent 写错的代码
  • Chris Lattner 回帖推荐 Mojo,称其具备线性类型、符号约束等高级类型特性,并提议加上「能面向所有硬件」(回帖,抓取时约 40 赞)
  • Bend 作者 Victor Taelin(@VictorTaelin)也在回复串中参与讨论,称 Bend 拦下了 agent 对应用的破坏性修改是「按设计工作」
  • 讨论没有给出任何跑分或对比实验,Bend、Mojo 是否适合 agent 编程目前只是个人观点
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:工程师 Arpit Bhayani 称「没有人类能比 LLM 写出更好的代码」,7 千多赞、240 多条回复引发 AI 编程能力之争

工程师 Arpit Bhayani(@arpit_bhayani)在 UTC 2026-10-25 13:37 发帖称「No human will ever write code better than LLMs. Accept this fact, stop pretending, and move on.」(原帖)。抓取时约 7,193 赞、496 转发、104 引用、241 回复、529 收藏、17.4 万浏览,并进入 X 热门话题。回复两极:有人认同 LLM 写代码又快又好,也有人反驳说 LLM 常写出超出需要的冗长代码,生产环境的边界情况、架构和最终验证仍要靠人。这是一条 X 热议,观点按观点呈现,不是已证实的结论。

核心要点速览

  • 主帖:Arpit Bhayani 原帖,UTC 10-25 13:37 发布,抓取时约 7,193 赞、496 转发、104 引用、241 回复、529 收藏、17.4 万浏览
  • 原话是「没有人类能比 LLM 写出更好的代码,接受这个事实,别再假装了,往前走」,是个人观点,没有附数据或实验
  • 支持方:有回复者称自己写了多年代码,LLM 写得比自己更好更快
  • 反对方:有回复者指出 LLM 往往生成比需求多得多的代码,浏览器兼容、无障碍和生产环境边界情况仍要人来判断
  • 共识方向:多条回复认为人的价值在设计、监督和验证;网上流传的裁员和招聘比例数字本文未核实,不采用
阅读全文
关联模型 / 智能体 / 厂商:

GitHub Next 发布 PDD Kit:面向 Coding Agent 的形式化规约证明套件,从数学上杜绝代码边角缺陷

微软 GitHub 旗下创新实验室 GitHub Next 正式发布 PDD Kit(Property-Driven Development Kit)。针对当前自主编程智能体(Coding Agents)虽然能写出通过基础单元测试的代码、但在边界复杂条件下依然频频崩溃的行业顽疾,PDD Kit 引入了基于形式化数学证明的属性驱动开发规范。系统不再依赖概率性或有限用例的样本测试,而是自动从数学上证明 AI Agent 生成的代码在所有可能输入(For Every Input)下均严格满足预设规约,从根本上杜绝潜在的运行时 panic、越界与逻辑回退,推动 Coding Agent 从“概率代码生成”跨越至“形式化保真交付”。

GitHub Next 发布 PDD Kit:面向 Coding Agent 的形式化规约证明套件,从数学上杜绝代码边角缺陷

核心要点速览

  • GitHub Next 发布 PDD Kit 形式化规约套件,利用形式化数学证明彻底终结 Coding Agent 代码边角隐患
  • 提出“全输入空间数学证明”(Proofs for every input)新范式,替代脆弱的有限单元测试用例抽样
  • 在复杂算法与系统内核重构中,完全消除传统 Agent 常见的死锁、越界与状态不一致崩溃
  • 为自主软件工程智能体从实验原型迈向银行、航空与系统级核心软件开发提供了坚实的工程验证底座
阅读全文

OpenAI 披露利用 GPT-5.6 Sol 挖掘影响全球 70% 网站的 PHP 关键漏洞,开源检测工具并设 10 亿美元基金

OpenAI 官方宣布,网络安全研究机构 Calif 借助 GPT-5.6 Sol 成功发现了存在于 PHP 核心解释器中的关键高危漏洞,云安全巨头 Wiz 亦独立完成双重漏洞上报。鉴于全球约 70% 的互联网网站均运行在 PHP 之上,该漏洞具有重大潜在威胁。OpenAI 遵循负责任漏洞披露规范协助完成安全补丁升级,宣布设立 10 亿美元规模的 Daybreak 补贴基金以强化关键开源安全,并联合开源了基于 Codex 技能的自动化检测工具 openai/php2shell-checker,供全球站长一键自查。

OpenAI 披露利用 GPT-5.6 Sol 挖掘影响全球 70% 网站的 PHP 关键漏洞,开源检测工具并设 10 亿美元基金

核心要点速览

  • Calif 借助 OpenAI 前沿大模型 GPT-5.6 Sol 成功挖掘出 PHP 核心引擎的关键远程代码执行(RCE)高危漏洞
  • PHP 驱动着全球超过 70% 的 Web 站点,官方已与安全厂商协同完成热修复并向社区披露
  • OpenAI 宣布提供 10 亿美元规模的 Daybreak 补贴算力支持,专门用于全球关键开源基建的安全审计与防御
  • 在 GitHub 正式开源自动化检测工具 openai/php2shell-checker,支持开发者利用 Codex 技能快速排查系统风险
阅读全文
AD赞助内容

告别裁判模型幻觉与偏见:Scale AI 开源 Sauron 证据优先智能体验证架构,成本降低 85%

Scale AI 团队在 arXiv:2610.17724 中开源革命性智能体评测与验证架构 Sauron。针对大模型在长程智能体评估中作为裁判(LLM-as-a-Judge)时普遍存在的臆测裁判、幻觉解释与无法追溯问题,Sauron 提出“证据优先(Evidence-First)”范式。通过对执行轨迹进行自适应有界质询、提取确定性检查回执并隔离共享证据,在 PA100 基准上全面刷新 F1 分数,以比 Archipelago 低 85% 的推理成本实现 0.94 精确率与 0.97 召回率,评估速度飙升 4.2 倍。

告别裁判模型幻觉与偏见:Scale AI 开源 Sauron 证据优先智能体验证架构,成本降低 85%

核心要点速览

  • Scale AI 开源证据优先智能体评估引擎 Sauron(arXiv:2610.17724),彻底根治长程任务中 LLM 裁判的臆测与幻觉
  • 提出有界自适应质询与机器确定性检查回执,按需提取最小事实证据,Token 消耗削减一半以上
  • 在 PA100 基准 8 大基座上 F1 全面夺冠,以比全量快照比对低 85% 的推理成本斩获 0.94 精确率与 0.97 召回率
  • 10 个长任务评测耗时从 71 分钟骤减至 17 分钟(提速 4.2 倍),代码全面开源并已托管至 GitHub
阅读全文
关联模型 / 智能体 / 厂商:

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

亚马逊 AWS 与伊利诺伊大学厄巴纳-香槟分校(UIUC)研究团队在 arXiv:2610.22448 中正式开源 Lean4AgenticRL 框架。针对传统 Agent 强化学习过度依赖稀疏二值结果奖励(Outcome Rewards)、忽视底层工具调用与中间工作流状态的痛点,该研究首次将多级过程奖励锚定在 Lean4 交互式定理证明器的形式化模式中,提出工作流阶段归一化 GRPO 算法。训练得到的 LAR-27B 在 TerminalBench-2.1 上斩获 77.3% 高分,较基座模型提升 9.89%。

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

核心要点速览

  • AWS 与 UIUC 联合推出 Lean4AgenticRL(arXiv:2610.22448),首创将多级过程奖励形式化锚定在 Lean4 交互式定理证明器中
  • 针对稀疏结果奖励痛点,提出工作流阶段归一化 GRPO 算法,有效隔离长轨迹多步探索的高方差与奖励黑客
  • 训练得到的 LAR-27B 在 TerminalBench-2.1 上取得 77.3% 佳绩,较基座模型大幅提升 9.89%,超越同尺寸最优模型 5.07%
  • 消融实验证实形式化阶段校验使收敛速度提升超 42%,为工业级自主编程与终端 Agent 提供可验证强化学习新范式
阅读全文
关联模型 / 智能体 / 厂商:

规则世界建模三大突破:OmniVerifier-C1 解耦分级验证器赋能迷宫/数独生成,美团 WorldCast 揭露开源仅 20.1 分代差,国大 RPO 扩散 RL 提速 4 倍

针对多模态生成模型向“严守物理与逻辑规则的世界模型”演进中的验证、评测与强化学习对齐难题,今日三项重磅研究给出系统答案:OmniVerifier-C1(arXiv:2610.22355,HF 32 赞)通过解耦强化学习(DAPO)将提示词拆解为子问题二元判断与全局连续打分,在 ViVerBench 上提至 0.684 并将 FLUX.1-dev 的 GenEval 推至 0.79;美团开源 320 例多步世界状态预测基准 WorldCast(arXiv:2610.20731,HF 30 赞),揭示 GPT-Image-2.5 System 达 72.8 分而最强开源模型仅 20.1 分;新加坡国立大学提出路由策略优化 RPO(arXiv:2610.22282),将注意力块路由作为随机探索动作,以仅 24.1 GPU 小时(较 Flow-GRPO 与 DanceGRPO 分别快 3.1 倍和 4.2 倍)大幅提升视频生成语义对齐。

规则世界建模三大突破:OmniVerifier-C1 解耦分级验证器赋能迷宫/数独生成,美团 WorldCast 揭露开源仅 20.1 分代差,国大 RPO 扩散 RL 提速 4 倍

核心要点速览

  • OmniVerifier-C1 采用解耦强化学习(DAPO)联合优化子问题二元判断与全局连续打分,在 ViVerBench 达 0.684 并将 FLUX.1-dev 的 GenEval 总分从 0.68 拉升至 0.79
  • 美团开源 320 例多步世界状态预测基准 WorldCast:评测 12 款模型发现 GPT-Image-2.5 System 斩获 72.8 分,Nano Banana Pro 为 42.8 分,而最强开源模型仅得 20.1 分
  • 新加坡国大提出路由策略优化(RPO):在注意力块路由内部进行双轨迹随机探索且推理期零改动恢复稠密注意力,在 Wan2.2-TI2V-5B 上仅需 24.1 GPU 小时(较 Flow-GRPO 与 DanceGRPO 分别快 3.1 倍和 4.2 倍)
阅读全文
关联模型 / 智能体 / 厂商:

零外部裁判登顶 WebArena Infinity 74.6%!Salesforce 开源 CLIFT 保形自验证,SCOPED-8B 跨能力蒸馏反超 32B 模型

针对网页与多模态智能体在强化学习中奖励稀疏、外部大模型裁判昂贵以及多能力梯度冲突的痛点,今日三项重磅研究实现突破:Salesforce AI Research 推出 CLIFT(arXiv:2610.06829),将保形认证的 URL 状态自验证问题库同时用于训练稠密奖励与测试期零裁判轨迹优选(CTS),使 Gemma-4 31B 在 WebArena Infinity 9 大应用上斩获 74.6% 登顶(超越 Gemini 3 Flash 的 70.1%),迁移至 GPT-5.5 刷新 VisualWebArena 53.7% SOTA;MMSearch-OPD(arXiv:2610.22240)将 9B 多模态深度搜索准确率提至 60.2%(+15.3 分);东北大学 SCOPED-8B(arXiv:2610.22217)通过技能解耦在线专家蒸馏斩获 73.13% 均分,越级击败 4 倍体积的 Qwen3-VL-32B(72.01%)与 Claude Opus 4.6(72.86%)。

零外部裁判登顶 WebArena Infinity 74.6%!Salesforce 开源 CLIFT 保形自验证,SCOPED-8B 跨能力蒸馏反超 32B 模型

核心要点速览

  • Salesforce 提出 CLIFT 保形自验证框架:使开源 Gemma-4 31B 在 WebArena Infinity 9 大应用上斩获 74.6% 最高成功率(较基座 +12.8 分,击败 Gemini 3 Flash 的 70.1%),且测试期轨迹优选(CTS)无需调用任何外部裁判
  • 将开源模型学到的 CLIFT 验证问题库零训练迁移至闭源 GPT-5.5,在 VisualWebArena 上以 53.7% 刷新最高纪录;MMSearch-OPD 则将 9B 多模态深度搜索 7 项基准均分拉升 15.3 分至 60.2%
  • 东北大学开源 SCOPED 技能解耦在线专家蒸馏框架:SCOPED-8B 在 8 大多模态基准上斩获 73.13% 均分,越级击败 4 倍体积的 Qwen3-VL-32B(72.01%)与 Claude-Opus-4.6(72.86%)
阅读全文
关联模型 / 智能体 / 厂商:

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商: