

北京时间 11 月 10 日凌晨 2:58,Claude 官方账号发布 Claude Fable 5.2 和 Claude Mythos 5.2。两者是同一个底层模型:Fable 带有网络安全和生物安全防护,面向所有付费用户、Claude Platform 和各大云平台开放;Mythos 去掉部分防护,只通过网络安全与生命科学验证计划提供给审核过的机构。价格从 Fable 5.1 的每百万 token 10/50 美元降到 8/40 美元,输出速度最多快 30%,另有最多提速 2.5 倍的 fast mode(16/80 美元)。官方口径下,Fable 5.2 在 FrontierCode 2.0 上以 Xhigh 档拿到 49.1%,高于 Opus 5.5 的 45.5% 和 GPT-6 Astra 的 42.8%;High 档与 Opus 5.5 最高分持平,单任务成本约为一半。API 模型名为 claude-fable-5-2。
核心要点速览
- ✓定价:$8 / $40 每百万 token(输入/输出),比 Fable 5.1 的 $10 / $50 便宜 20%;fast mode 最多提速 2.5 倍,价格 $16 / $80
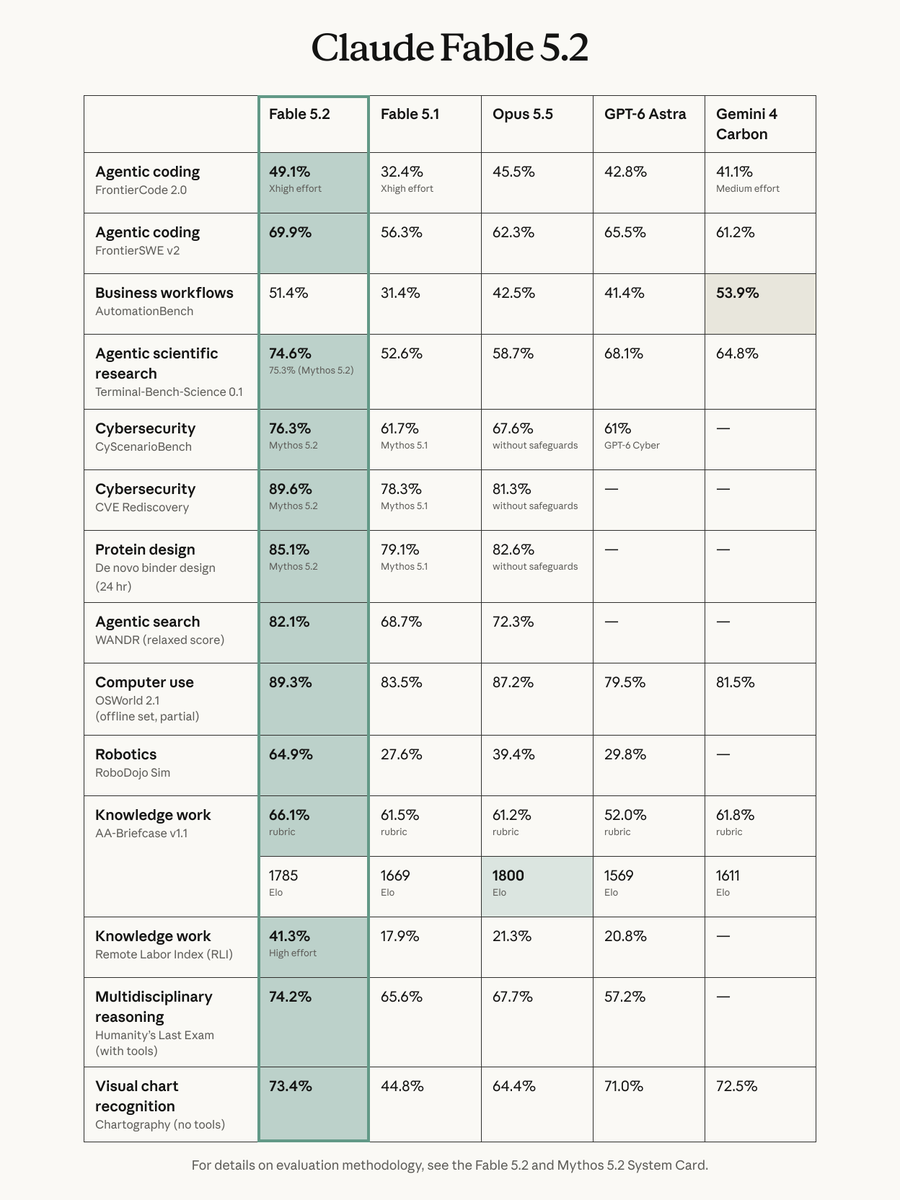
- ✓编码(官方口径):FrontierCode 2.0 Xhigh 档 49.1%(Opus 5.5 为 45.5%,GPT-6 Astra 为 42.8%);High 档 45.3% 追平 Opus 5.5 最高分,单任务成本约 一半;FrontierSWE v2 69.9%
- ✓长程 Agent:1000 个 Fable 5.2 Agent 用 30 小时 完成费马大定理的 Lean 形式化,同样配置下 Opus 5.5 18 小时只完成 26%;一名工程师让它协调 1000 多个子 Agent 连续 8 天写出可在笔记本上启动的原型操作系统
- ✓其他跑分(官方口径):RoboDojo Sim 64.9%(Fable 5.1 为 27.6%)、HLE(带工具)74.2%、OSWorld 2.1 89.3%、Remote Labor Index 41.3%;Mythos 5.2 CVE Rediscovery 89.6%
- ✓防护:Fable 与 Mythos 是 同一模型;Fable 5.2 的安全分类器误拦截比 5.1 少约 55%;preserved thinking 防蒸馏功能扩展到 所有账号
开发者 3 秒速决决策指标
Claude Code 高频使用:比较订阅额度与 API 账单
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Anthropic 的产品线现在分两层:Opus 5.5 是官方推荐的「日常主力」,Fable 和 Mythos 则用于最难、最开放的技术任务。Fable 5.1 的问题是贵(每百万 token 10/50 美元)、安全分类器误拦截多,开发者常常被挡在网络安全和生物相关任务之外。北京时间 11 月 10 日凌晨,Anthropic 发布 Fable 5.2 和 Mythos 5.2,同时降价、提速,并减少误拦截。两者是同一个底层模型:Fable 带防护、面向所有付费用户;Mythos 去掉部分防护,只开放给通过网络安全和生命科学验证计划审核的机构。
架构亮点与底层机制
Anthropic 没有公布参数量和架构细节。官方说明的变化有:输出速度比 5.1 最多快 30%,新增 fast mode,生成速度最多再提 2.5 倍;在默认的 Medium 档,完成同样任务用的 token 比 Fable 5.1 少。Fable 5.2 可以当 Advisor(让 Haiku、Sonnet、Opus 遇到难题时向它求助),也可以当 Orchestrator(把简单任务分给小模型)。训练时 Anthropic 有意限制了它在加速器内核优化、改进大模型架构等方面的能力,这些方面只与 Opus 5.5 相当。防蒸馏方面,preserved thinking 扩展到所有账号,防止别人篡改上下文来套取推理过程。
权威 Benchmark 与实测跑分对比
以下均为 Anthropic 官方口径。FrontierCode 2.0(衡量代码改动能否被开源项目维护者合并):Fable 5.2 Xhigh 档 49.1%,Opus 5.5 为 45.5%,GPT-6 Astra 为 42.8%,Gemini 4 Carbon 为 41.1%;High 档 45.3%,与 Opus 5.5 最高分持平,单任务成本约一半。FrontierSWE v2 为 69.9%(Opus 5.5 为 62.3%)。AutomationBench 51.4%,仍低于 Gemini 4 Carbon 的 53.9%。RoboDojo Sim 64.9%,是 GPT-6 Astra(29.8%)的两倍多。Humanity's Last Exam(带工具)74.2%,OSWorld 2.1 89.3%。Mythos 5.2 的 CVE Rediscovery 为 89.6%。官方最亮眼的案例是 1000 个 Fable 5.2 Agent 用 30 小时完成费马大定理的 Lean 形式化,同样配置下 Opus 5.5 18 小时只完成 26%。第三方独立评测暂未公布。
开发者实战落地与开箱指南
API 模型名为 claude-fable-5-2,已上线 Claude Platform、AWS、Google Cloud 和 Azure,Claude 付费套餐和 Claude Code 也已可用,默认 Medium 档。价格为输入 8 美元、输出 40 美元(每百万 token),fast mode 为 16/80 美元,可在 Claude Code、Claude Platform、Google Cloud 和 Microsoft Foundry 使用。本周付费用户可获得 1 到 3 次 Fable 用量重置,Pro 套餐的 Fable 用量最多可占每周额度的 50%。官方仍建议多数编码任务先用 Opus 5.5,遇到大型迁移、长程多 Agent 等任务再切到 Fable。注意 Fable 会拦截大部分渗透测试、漏洞利用等网络安全任务,被拦截时改由 Opus 4.8 回答。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察