AI 编程实时动态与要闻

X 热议:Sam Altman 称“人类应始终掌控未来”,不应把未来交给超级智能,这一要求最终应约束 AI 进展

OpenAI CEO Sam Altman(@sama)11 月 4 日 09:40(新加坡时间)在 X 发帖称“人类应始终掌控未来”,表示 OpenAI 反对让人类沦为只做“AI 系统认为值得奖励的事”的角色,并称人类不应把未来的控制权交给超级智能,“这一要求最终应当约束 AI 的进展”。帖子约 25 分钟内获得约 1,360 赞、337 条回复和近 10 万次浏览,François Chollet 等人表态支持,也有不少质疑。这是 Altman 本人的观点表态,不是 OpenAI 发布的新政策或产品。

核心要点速览

  • 互动量:发帖约 25 分钟内约 1,360 赞、337 条回复、89 次转发、74 条引用、约 9.9 万次浏览(X API 口径),回复数占比很高,说明争议大
  • 核心表述三句:人类应始终掌控未来;OpenAI 反对人类沦为做“AI 系统认为值得奖励之事”的角色;不应把未来交给超级智能,这一要求“最终应约束 AI 进展”
  • 支持方:François Chollet(@fchollet)转发称“Co-sign”,认为值得建设的未来是 AI 始终是人类手中的工具;Matthew Berman 称 Altman 上周接受他采访时也讲过同样观点
  • 质疑方:有人反问“由哪些人掌控”,有人认为“AI 系统根本不会思考”,也有人把它和 Altman 近期关于 RAM、算力集中在数据中心的言论对照
  • 帖子没有说明引号里那句话出自哪里,也没有给出任何具体政策或时间表;网上把它和 GPT-6.2 Astra 发布时间挂钩的说法均属猜测
阅读全文
关联模型 / 智能体 / 厂商:

Hume 发布 Audio Decision API:直接对原始音频提问,一次调用判断情绪、说话人数和背景声,官方称与人类评审一致率 70.7%

语音 AI 公司 Hume 11 月 2 日发布 Audio Decision API,号称首个「音频原生」的问答式决策模型:开发者上传原始音频,用一句话写问题并给出候选答案,接口返回每个答案的概率,不经过转写。支持是/否、多选、打分和时间片段四类问题,可判断说话人数、是否有人笑、来电者是否不耐烦、背景是否有警笛等。官方口径:训练用了 1000 万以上条人类判断,初步评测与人类评审平均判断的一致率为 70.7%(单个评审基线 56.5%)。目前需申请或加入候补名单获取访问权限。

Hume 发布 Audio Decision API:直接对原始音频提问,一次调用判断情绪、说话人数和背景声,官方称与人类评审一致率 70.7%

核心要点速览

  • 官方口径:初步评测中与人类评审平均判断一致率 70.7%,单个评审基线为 56.5%;评测样本量和语种未公布。
  • 训练数据为 1000 万以上条人类感知判断(Hume X 帖子口径),博客称累计数千万条评审打分。
  • 四类问题:是/否、多选、打分、时间片段,新增一个问题只需一行 JSON,无需标注或重新训练。
  • 开发者接口为 POST /v0/decisions/file,另有输入 token 估算接口,提供 Python 和 TypeScript SDK。
  • 官方称以前要 10 个以上模型组合的工作现在一次调用完成;价格官方未公布。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hume Audio Decision Model🌐 Hume AI

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

开源编码智能体 OpenCode 背后的 Anomaly 发布语音输入工具 Hex 3.0 稳定版:按住快捷键说话、松开即粘贴到光标处,语音识别在本机完成,内存占用从约 900MB 降到约 160MB,并新增词汇表、hex 命令行和可选的 OpenCode 改写。

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

核心要点速览

  • Hex v3.0.0 于 10 月 31 日 00:38 UTC 在 GitHub 发布,MIT 协议、Rust 编写,仓库约 1,557 星(发布说明)
  • 官方口径:本地模型内存占用从约 900MB 降到约 160MB;2.3.0 起边说边转写,2 分钟口述松键后约 0.1 秒出字(RTX 5070 Ti)
  • 支持 macOS 15+(Apple 芯片)、Windows x64/ARM64、Linux x64/ARM64,Linux 新增 .deb/.rpm 包
  • 3.0 不自动从 2.3.1 升级,设置、历史和模型需重新下载;语音动作和口令功能被移除
  • @opencode 的发布帖约 2,400 赞、1,600 收藏、10 万+浏览(原帖)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Parakeet⚡ Whisper🤖 OpenCode🤖 Hex🌐 Anomaly

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

语音模型公司 Cartesia 于 10 月 29 日发布 Managed Agents,一个面向企业电话场景的端到端语音 agent 平台,把自家语音识别、语音合成模型与 agent 框架一起设计调优,并自带电话接入、知识库、工具调用和批量外呼。官方称它在 Artificial Analysis 的 Speech Agent Arena 中以 1115 Elo 排第 1,在 ServiceNow 的 EVA-Bench 上拿到 87.4% 准确率和 90.7% 体验分(均为厂商口径,推理模型为 GPT-5.5);上线期价格打五折,为每分钟 0.03 美元。

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

核心要点速览

  • Artificial Analysis Speech Agent Arena 盲测偏好中,Managed Agents 以 1115 Elo 在 30 个 agent 中排第 1,高于 Gemini 3.1 Flash Live Minimal(1099)、Grok Voice 3.0(1064)和 GPT-Live-1(1041)(Cartesia 博客,厂商引用口径)
  • ServiceNow EVA-Bench 200 多个客服、IT 服务和 HR 场景首轮成绩:准确率 87.4%、体验分 90.7%,对比 Grok Voice 3.0 为 73.7%/71.2%、GPT Realtime 2.1 为 59.0%/61.6%(EVA-Bench)
  • 以上跑分都以 GPT-5.5 作为推理模型;Cartesia 内部评测称 85% 的通话没有抢话/打断问题,其他 agent 为 67%
  • 上线期五折,每分钟 0.03 美元;官方称该平台此前已在金融、零售、酒店、医疗场景跑过数千万次对话
  • 支持 44 种语言,目前英语、西班牙语、印地语、法语、日语可在通话中途切换,其余语言「即将支持」
阅读全文
AD赞助内容

ChatGPT dots 支持短信:美国 Pro 用户可用 iMessage 或 RCS 给自己的 dot 派活,dot 也会主动发短信汇报

OpenAI 10 月 28 日通过 @ChatGPT 宣布,用户现在可以给自己的 dot(ChatGPT 里常驻的智能体)发短信:用文字、照片或语音备忘布置任务或让它盯事,dot 有相关进展会主动发短信回来。功能走 iMessage 或 RCS,不支持普通 SMS;只有本人能给 dot 发,dot 也只发给本人。目前以 beta 形式向美国部分 Pro 用户推出,Business 和 Enterprise 工作区不支持。短信经第三方服务商 Linq 转发,官方说明这段对话不是端到端加密。

ChatGPT dots 支持短信:美国 Pro 用户可用 iMessage 或 RCS 给自己的 dot 派活,dot 也会主动发短信汇报

核心要点速览

  • 范围:美国 Pro 用户 beta 预览,名额有限;Business / Enterprise 工作区不支持(OpenAI 帮助中心)
  • 渠道:只支持 iMessage(iPhone)和 RCS(Android),普通 SMS 会收到自动回复提示改用 iMessage、RCS 或 App
  • 开通 3 步:dot 资料页选 Texting,输入手机号发确认短信,填验证码完成绑定
  • 隐私:经第三方 Linq 转发,非端到端加密;Linq 投递后不保留内容,只留时间戳、投递状态等元数据
  • 上下文:短信与 App 内 dot 共用同一份记忆和插件;回复 STOP 或在资料页 Texting 里关闭即可停用
阅读全文

Apple 推送 27.2 系统更新:Siri AI 新增法语、日语、韩语、葡萄牙语和西班牙语,并能记住过去的对话

Apple 10 月 26 日发布 iOS、iPadOS、macOS、watchOS 和 visionOS 27.2,基于 Apple Intelligence 重做的 Siri AI(Beta)在英语之外新增法语、日语、韩语、葡萄牙语和西班牙语。官方称繁体中文、挪威语、土耳其语和越南语将在年底前上线。按 iOS 27.2 发布说明,Siri AI 现在可以回忆过去的对话,并能从信息里的照片、日历参与者、语音留言等更多来源取材。Siri AI 仍不在欧盟(iOS、iPadOS、watchOS)和中国大陆提供,依赖服务器端模型的功能有每日用量上限,Apple 称未来将推出付费的扩展额度。

Apple 推送 27.2 系统更新:Siri AI 新增法语、日语、韩语、葡萄牙语和西班牙语,并能记住过去的对话

核心要点速览

  • 语言:Siri AI 从仅英语扩展到 6 种语言,新增法语、日语、韩语、葡萄牙语、西班牙语;繁体中文、挪威语、土耳其语、越南语官方称年底前上线
  • 覆盖 5 个平台:iOS、iPadOS、macOS、watchOS、visionOS 27.2 同日推送,Siri AI 仍标注为 Beta
  • 新能力(据 iOS 27.2 发布说明):可回忆过去的对话,新增信息内照片、日历参与者、语音留言等取材来源,并可在一个设置里排除指定 App
  • 限制:iOS/iPadOS/watchOS 在欧盟不可用,中国大陆账号不可用,13 岁以下不可用;服务器端模型功能有每日上限,Apple 称将来提供付费扩展额度
  • 机型:iPhone 15 Pro 及之后机型、M1 及以上 iPad 和 Mac 等 Apple Intelligence 设备,设备语言与 Siri 语言需一致
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Apple Intelligence⚡ AFM 3🤖 Siri AI🌐 Apple

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

腾讯混元(Tencent Hy)10 月 26 日开源实时同声传译模型 Hy-SimulMT,支持中英双向语音到语音翻译,边听边译,同时输出译文文本和语音,并可实时克隆说话人音色。Hugging Face 上一次放出 6 个权重(30B-A3B 的纯译文版与带原文的 Interleave 版,各含 BF16、FP8、GGUF),模型卡标注 Apache-2.0;GitHub 同步提供 SimulInfer 推理服务与 SimulTrain 训练工具。官方口径:RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统最低。

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

核心要点速览

  • 规模与形态:30B-A3B MoE(约 3B 激活),共 6 个权重:纯译文版与 Interleave(原文+译文)版,各有 BF16、FP8、GGUF(Hugging Face 合集)
  • 延迟(官方/厂商口径):RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 质量分超过对比的开源模型和 5 个商业 API 中的 4 个
  • 短音频(官方/厂商口径):FLEURS 90.3、CoVoST2 75.5、ACL6060 81.2、RealSI-Sentence 84.7,后者为表中所有系统最高;同表 Qwen3.8-LiveTranslate 为 88.4/82.1/80.5/84.4
  • 真人对比:18 段约 6 分钟的真实中英音频,对比 6 名 CATTI 一级/二级口译员,官方称质量相当、延迟常更低,并注明仅适用于该小规模测试
  • 部署:SimulInfer 一条 deploy.sh 命令拉起 vLLM(需 >=0.31)与 Web/WebSocket 服务,语音输出和音色克隆需另配 TTS;llama.cpp 支持尚未合入上游(SimulInfer 文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy-SimulMT-30B-A3B⚡ Hy-SimulMT-30B-A3B-Interleave⚡ Qwen3.8-LiveTranslate🌐 Tencent

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

10 月 20 日,UCSD Hao AI Lab 的 FastVideo 团队开源 FastH3 Omni,这是 MiniMax H3 参考生成音视频(Ref2VA)模型的蒸馏版,可同时用文本、最多 9 张图、视频片段和人声参考生成带同步立体声的视频。采样从 50 步降到 8 次 transformer 计算,官方在 8 张 GB200 上测得端到端延迟降低 5.6–11.9 倍,训练代码一并开源,并提供面向 DGX Spark、RTX 5090 的 NVFP4 权重和 ComfyUI 支持。

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

核心要点速览

  • 步数:8 次 transformer 计算,基座 MiniMax H3 为 50 步,采用 PDD + DMD 蒸馏
  • 速度(官方口径):27 组对照负载、8×GB200,端到端延迟降低 5.6–11.9 倍;例如 15 秒单图请求 139.69 秒降到 14.14 秒
  • 输入:最多 9 张图、3 段视频、3 段音频,合计不超过 12 个参考;输出 24 FPS 视频 + 32kHz 立体声
  • 本地运行:DGX Spark(128GB)和 RTX 5090(32GB)用 NVFP4 QAD 权重,默认 480p;RTX 4090 可用 FP8 版
  • 许可:沿用 MiniMax-H3 Community License,不是 Apache/MIT
阅读全文
关联模型 / 智能体 / 厂商:

Gradium 开源端侧 TTS 模型 Phonon:31M 参数、64 MB,笔记本 CPU 上 7 毫秒开口,英文版 Apache 2.0 可商用

10 月 20 日,法国语音 AI 公司 Gradium 开源 Phonon 端侧文本转语音模型家族:英文 Phonon 31m(q8 权重 64 MB,Apache 2.0)和 Phonon 40m(英/法/德/西/葡单语版与五语合一版,CC BY-NC 非商用)。模型基于 Kyutai 的 Pocket TTS 和 Mimi 编解码器,自带推理栈,覆盖 CPU、Metal、CUDA、Vulkan、WebGPU、Core ML 和骁龙,可在手机、浏览器、树莓派上离线运行。官方称 MacBook Air M5 CPU 上首段音频 7 毫秒,Kokoro 为 517 毫秒。

Gradium 开源端侧 TTS 模型 Phonon:31M 参数、64 MB,笔记本 CPU 上 7 毫秒开口,英文版 Apache 2.0 可商用

核心要点速览

  • 许可要看清:只有英文 Phonon 31m 是 Apache 2.0 可商用;Phonon 40m 各语言版和多语版均为 CC BY-NC 4.0,商用需联系 Gradium
  • 体积(官方):31m 的 q8 权重 64 MB,40m 为 74.6 MB;内置 37 个英文音色,多语版 102 个,也可用 Gradium 克隆或设计的音色
  • 速度(官方实测):MacBook Air M5 CPU 4 线程首段音频 6.9 毫秒、29.9 倍实时;Kokoro 517 毫秒(Kokoro 不流式输出);树莓派 5 上 38 毫秒开口、3.7 倍实时;骁龙 8 Elite Gen 5 上 7.5 毫秒
  • 准确率(厂商自建难句集,每种语言 500 句,已在 HF 公开):英文 WER 31m 1.70%、40m 2.22%,Kokoro 3.50%、NeuTTS Nano 8.71%;号码、日期、版本号等结构化文本靠文本规范化读对
  • 上手:uvx ptts 或 pip install ptts 即可本地合成,另有浏览器 npm 包 phonon-tts 和 GitHub 运行时 gradium-ai/xn-ptts
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Phonon 31m⚡ Phonon 40m⚡ Phonon 40m multilingual⚡ Pocket TTS⚡ Kokoro🤖 Pipecat🌐 Gradium🌐 Kyutai🌐 Arm🌐 Qualcomm🌐 Hugging Face
AD赞助内容

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

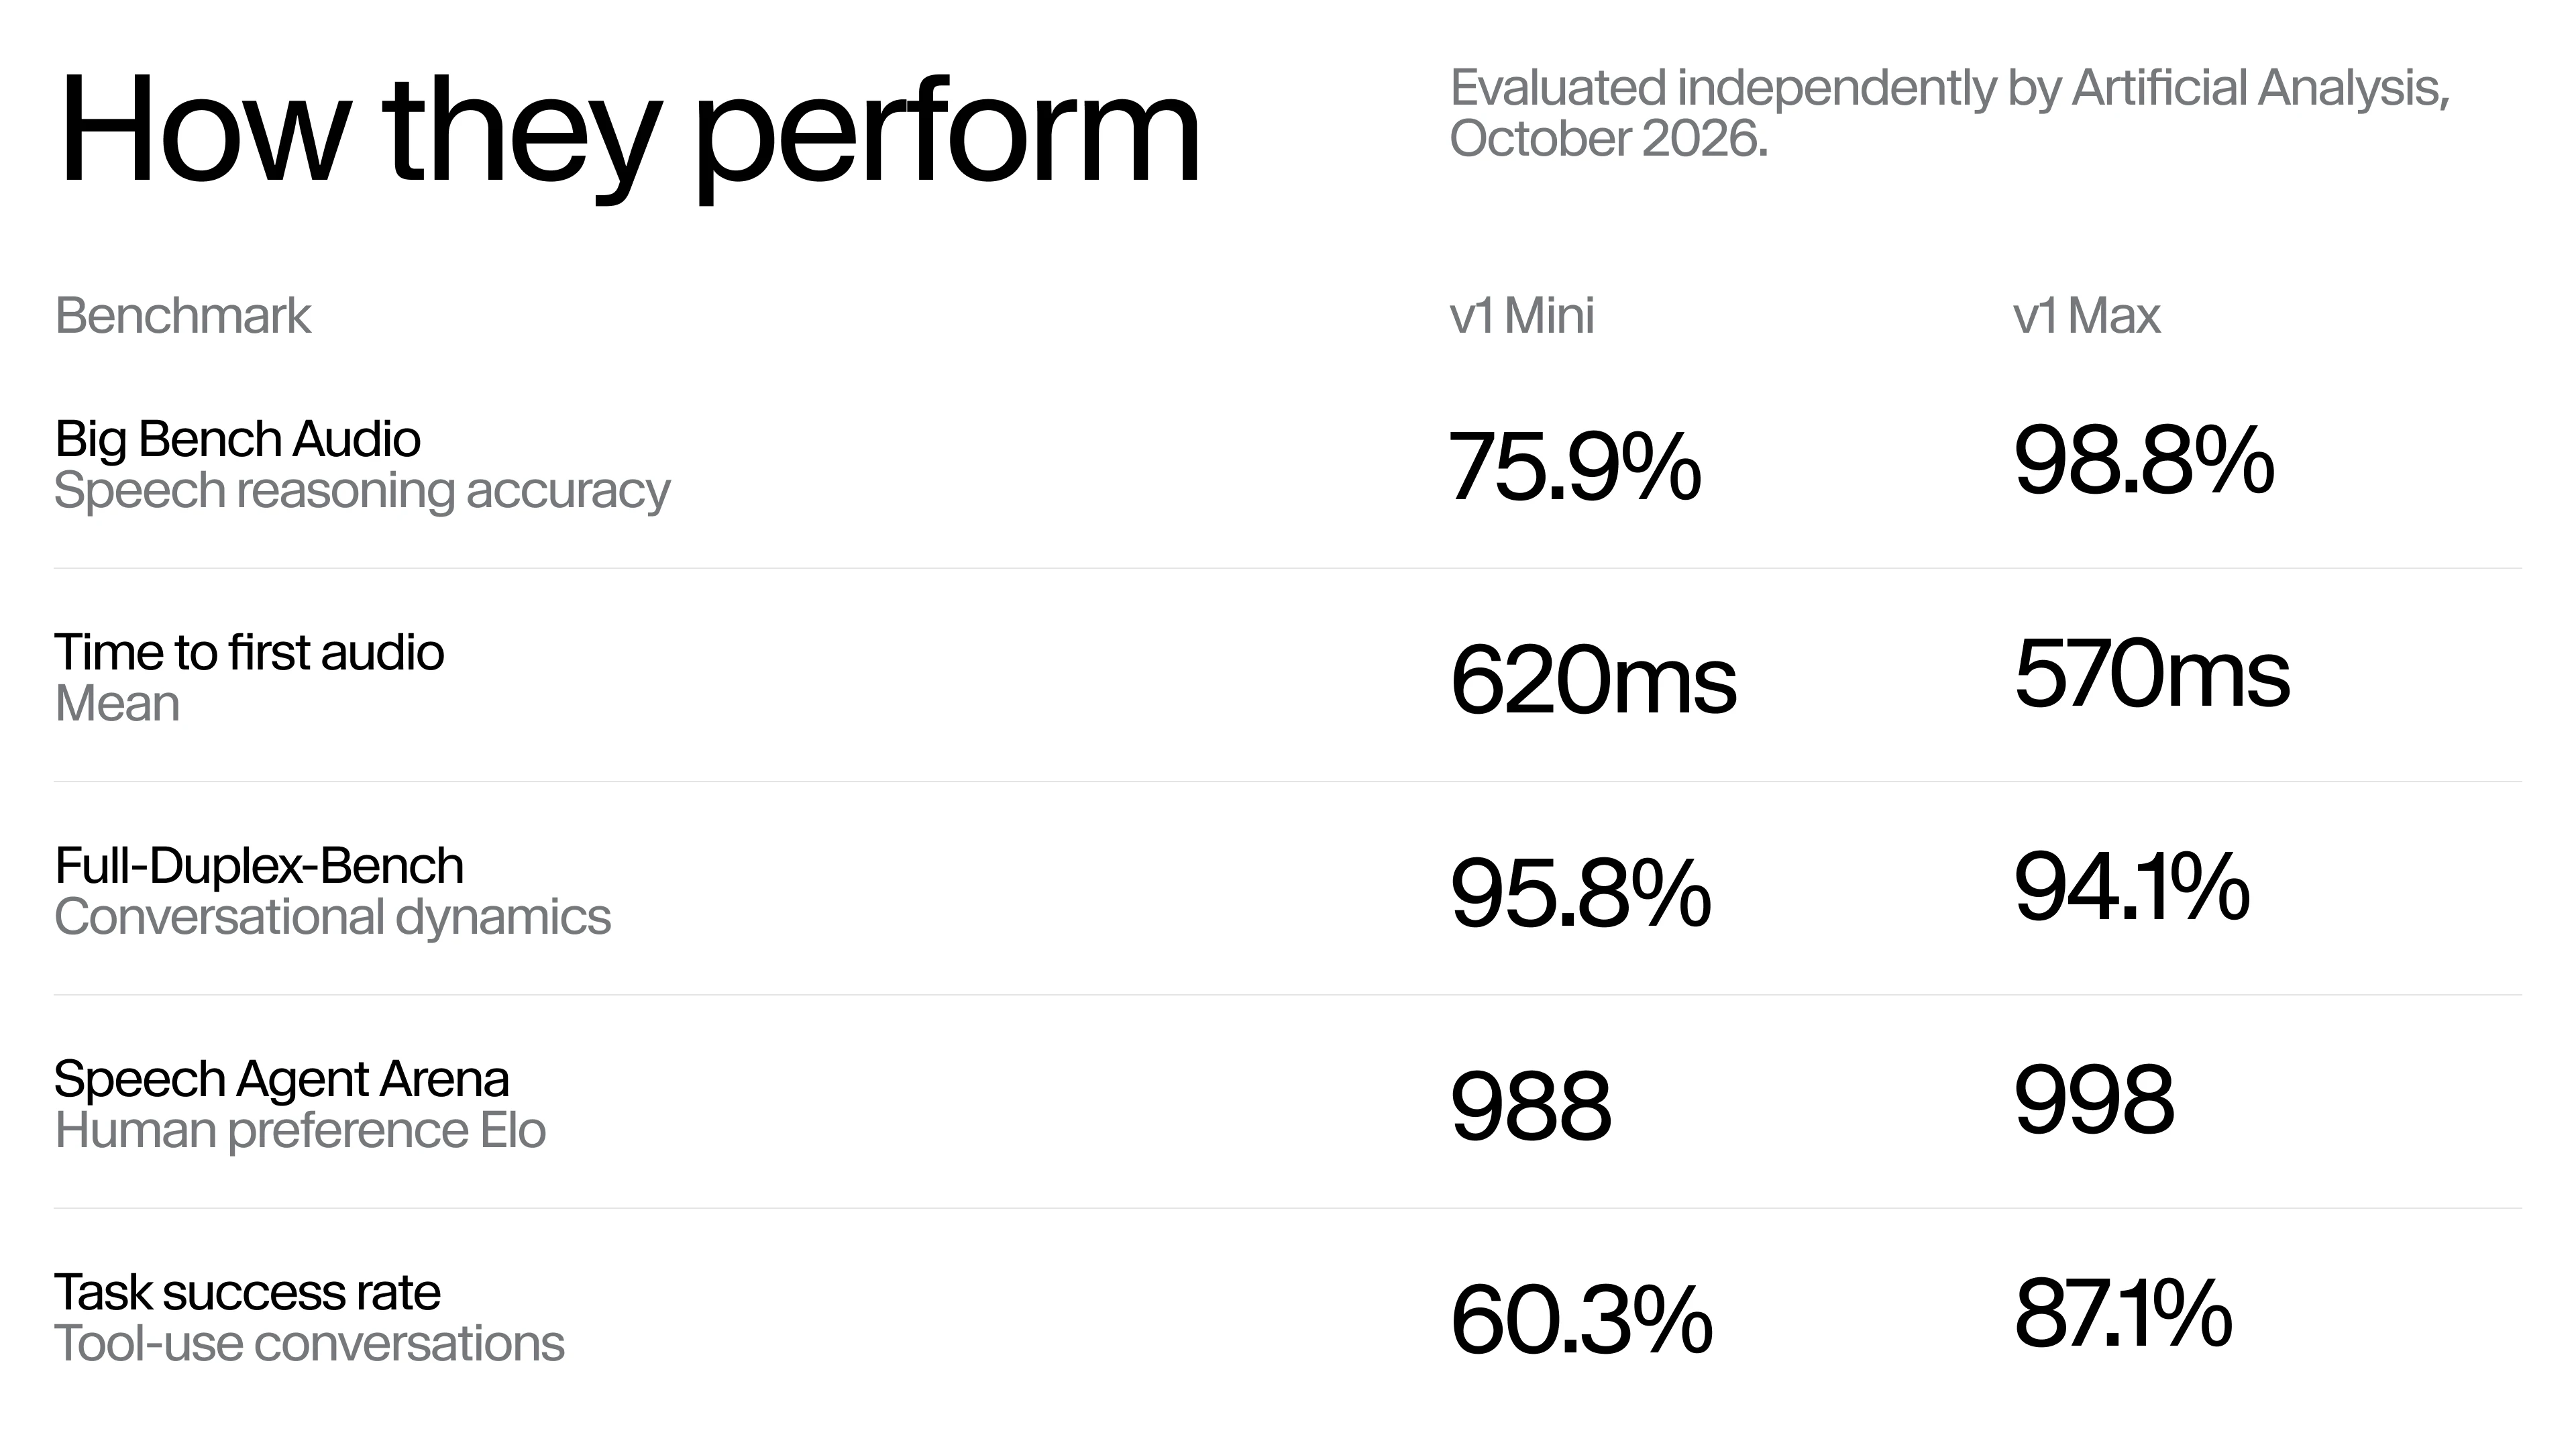
10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

10 月 20 日,Mistral 发布 Voxtral 3:语音转文字模型 Voxtral Small/Mini Transcribe 3、实时转写 Voxtral Mini Transcribe Realtime 3、语音合成 Voxtral Mini TTS 3(Voxtral Speech 3),以及基于 LiveKit 的语音 Agent SDK,把“听—思考调工具—说”串成一条流式管线,官方称每轮响应不到 1 秒。转写覆盖 50+ 语言并支持说话人分离和上下文偏置,TTS 覆盖 35+ 语言、50+ 方言,另有 30 分钟录音即可复刻音色的 Pro Voice。模型已通过 Mistral API(欧盟、美国、全球端点)上线,也可自部署。

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

核心要点速览

  • 多语种转写(官方口径):FLEURS 45 种语言宏平均 WER,Voxtral Small Transcribe 3 为 4.1%(指定语言)/4.0%(自动识别),与 Microsoft AI Transcribe 2 持平,优于 Scribe v2 的 4.9% 和 Whisper large-v3 的 16.0%/14.9%
  • 说话人分离(官方口径):cpWER 方面 Small 为 18.4%、Mini 为 18.6%,上一代 Voxtral Mini Transcribe 2 为 30.9%,Gemini 3.5 Transcribe 为 38.4%
  • 价格:Voxtral Mini Transcribe 3 为 4B 参数,每分钟 0.0035 美元(文档标注 Public Preview、32k 上下文);Voxtral Speech 3 每百万字符 13 美元
  • 实时转写:Voxtral Mini Transcribe Realtime 3 延迟可低于 500 毫秒;官方 FLEURS 35 语言图中 480ms 档 WER 为 6.4%,仍高于 Gemini 3.5 Realtime Transcribe 的 4.2%
  • 语音 Agent SDK 基于 LiveKit,支持 SIP 电话与 WebRTC,每个环节可单独替换 LLM、音色或语言,Pro Voice 用 30 分钟录音即可复刻音色
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Voxtral Small Transcribe 3⚡ Voxtral Mini Transcribe 3⚡ Voxtral Mini Transcribe Realtime 3⚡ Voxtral Mini TTS 3🤖 Voxtral voice agent SDK🌐 Mistral AI🌐 LiveKit

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

在 Artificial Analysis 最新发布的全球文本转语音(TTS)独立基准评测中,蚂蚁集团(Ant Group)开源的 Ming-3.0-tts 斩获 93.2% 的发音准确率,在全部 31 款参评模型中位列第一(超越 ElevenLabs v4 的 91.7%)。该模型提供 0.5B 密集版与 7.9B MoE 架构版本,支持高质量声音克隆与预设音色,在受控声音评测榜以 1,069 Elo 分位居开源第一,且以极度宽松的 MIT 开源协议完全向开发者免费开放。

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

核心要点速览

  • 蚂蚁集团开源新一代语音大模型 Ming-3.0-tts,在 Artificial Analysis 独立测评中斩获 93.2% 发音准确率登顶全球开源第一
  • 发音表现超越 ElevenLabs v4(91.7%),在受控声音竞技场以 1,069 Elo 分位居开源模型榜首
  • 提供面向低延迟端侧的 0.5B 稠密版与极致拟真的 7.9B MoE 旗舰版,支持 3 秒极速零样本声音克隆
  • 采用无限制 MIT 开源协议完全免费商用,权重与代码已全面上线 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

蚂蚁 Ant Ling(inclusionAI)10 月 19 日以 MIT 协议开源 Ming-3.0 的 5 个模型,覆盖语音合成(tts-0.5B、tts-tiny 7.9B/1.3B 激活)、音频理解(audio-flash 126B/6.5B 激活、audio-tiny 9.3B/2.7B 激活)和语音识别(asr-tiny 8.6B/2B 激活)。官方称 tts-0.5B 在 Artificial Analysis Controlled Voice 榜以 1069 Elo 位列开源权重第一,发音稳健性 93.2% 并列全榜第一;asr-tiny 四类 ASR 平均错误率 4.41%。权重已上 Hugging Face 和 ModelScope,SGLang 与 vLLM 首日支持。

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

核心要点速览

  • 阵容:3 个系列 5 个模型,TTS 2 个、音频理解 2 个、ASR 1 个,全部 MIT 协议。
  • TTS 成绩:tts-0.5B 在 AA Controlled Voice 获 1069 Elo,开源权重第一;Provider Voice 1188 Elo 排第 3;发音稳健性 93.2% 并列全榜第一(官方口径)。
  • TTS 能力:支持 7 种语言加四川话、粤语,14 种行内副语言标签(笑声、叹气、咳嗽等),44.1 kHz 输出,基于 Qwen2.5-0.5B。
  • 音频理解:audio-flash 总参 126B、每步激活 6.5B,可做长录音总结、语音问答、音频推理并生成工具调用请求。
  • ASR:asr-tiny 支持热词和对话上下文,在 15 个方言测试集上评测,四类任务平均错误率 4.41%(官方口径)。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ming-3.0-tts-0.5B⚡ Ming-3.0-tts-tiny⚡ Ming-3.0-audio-flash⚡ Ming-3.0-audio-tiny⚡ Ming-3.0-asr-tiny🌐 Ant Group🌐 inclusionAI🌐 SGLang🌐 vLLM

OpenAI 向全部 API 客户开放 prompt-to-voice:一句文字描述生成 GPT-Live 专属音色,创建免费,另增 9 个德法日韩印地语音色

OpenAI 于 10 月 16 日在官方更新日志宣布,prompt-to-voice 向所有 API 客户正式开放:开发者用一段文字描述口音、音高、音色和语速,即可通过 /v1/audio/voices 接口或 voice Playground 生成并保存自定义音色,在 GPT-Live 会话中复用。创建音色免费,语音生成按常规 GPT-Live 会话计费;每个组织最多保存 100 个。同时新增 9 个自然音色,覆盖德语、法语、印地语、日语和韩语。

OpenAI 向全部 API 客户开放 prompt-to-voice:一句文字描述生成 GPT-Live 专属音色,创建免费,另增 9 个德法日韩印地语音色

核心要点速览

  • 10 月 16 日起对所有 API 客户正式开放(GA),无需录音或授权录音即可建音色
  • 创建音色免费;在 GPT-Live 中出声、以及在 Playground 试听均按常规会话计费(官方口径)
  • 每个组织最多 100 个文字生成音色;可选 script_hint 示例台词,最长 2,000 字符
  • 新增 9 个自然音色:德语 3 个、法语 2 个、日语 2 个、印地语与韩语各 1 个
  • 限制:文字生成音色仅支持 GPT-Live,不支持 TTS、Realtime、Chat Completions;建音色接口不兼容零数据保留(ZDR)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-Live-1⚡ GPT-Live-1.1🌐 OpenAI