AI 编程实时动态与要闻

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

Mistral 10 月 29 日发布改进版 Mistral Large 4(Le Chonk)并开放权重,已上架 Hugging Face(另有 NVFP4 量化版),API 名为 mistral-large-4。相比 10 月初的公开预览,多做了约三周强化学习:官方口径 FrontierCode 2.0 得分 19.7%、Terminal-Bench 4.0 从 28% 升到 41%,并新增 low/medium/high 三档推理。许可证为改版 MIT,商用可用,但做模型即服务需另签商业许可。

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

核心要点速览

  • 规格:约 1T 总参数、每 token 激活 49B(含嵌入和输出层约 52B),128 个路由专家每次激活 4 个外加 1 个共享专家,1M 上下文,文本+图像输入
  • Mistral 口径:Cognition FrontierCode 2.0 得分 19.7%,高于 DeepSeek V4.1 Flash 的 19.3% 和 GLM-5.3 的 17.8%,开源模型第一
  • Artificial Analysis 编码智能体指数 48%,与 GLM-5.3 基本持平,但平均每任务少用 47% 的 token;Terminal-Bench 4.0 由预览版 28% 提升到 41%
  • Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒绝率 96.6%,官方称为开源模型中最高
  • 在 Mistral 自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练;Surge Code 盲评中仅次于 Claude Opus 5.5
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

亚马逊 AWS 与伊利诺伊大学厄巴纳-香槟分校(UIUC)研究团队在 arXiv:2610.22448 中正式开源 Lean4AgenticRL 框架。针对传统 Agent 强化学习过度依赖稀疏二值结果奖励(Outcome Rewards)、忽视底层工具调用与中间工作流状态的痛点,该研究首次将多级过程奖励锚定在 Lean4 交互式定理证明器的形式化模式中,提出工作流阶段归一化 GRPO 算法。训练得到的 LAR-27B 在 TerminalBench-2.1 上斩获 77.3% 高分,较基座模型提升 9.89%。

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

核心要点速览

  • AWS 与 UIUC 联合推出 Lean4AgenticRL(arXiv:2610.22448),首创将多级过程奖励形式化锚定在 Lean4 交互式定理证明器中
  • 针对稀疏结果奖励痛点,提出工作流阶段归一化 GRPO 算法,有效隔离长轨迹多步探索的高方差与奖励黑客
  • 训练得到的 LAR-27B 在 TerminalBench-2.1 上取得 77.3% 佳绩,较基座模型大幅提升 9.89%,超越同尺寸最优模型 5.07%
  • 消融实验证实形式化阶段校验使收敛速度提升超 42%,为工业级自主编程与终端 Agent 提供可验证强化学习新范式
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

Arena 官方正式发布 Code Arena: WebDev 最新榜单:深度求索最新推出的 DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分登顶开源模型第一,全面超越 Kimi K3 (Max) 且推理成本降低近 10 倍。该模型位列全榜总榜第 12,超越 Claude Opus 5 (High) 并与顶尖闭源旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分以内,以百万 Token 输入 $0.3 / 输出 $1.2 的极低资费大幅改写 Pareto 前沿。

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

核心要点速览

  • DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分斩获 Arena Code Arena: WebDev 开源模型第一名,超越 Kimi K3 (Max)
  • 位居全榜第 12 名,越级战胜顶尖商业模型 Claude Opus 5 (High),与商业旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分
  • 以百万 Token 输入 $0.3 / 输出 $1.2 的极致费率颠覆性重构 Web 代码生成的 Pareto 效率前沿,成本仅为同等闭源模型的 1/10
  • 相较一个月前的 20260910 版本单月实现 +52 分的性能狂飙
阅读全文
关联模型 / 智能体 / 厂商:

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

阿里巴巴淘天集团发表生产级多智能体商业视觉生成系统 CommerceGen-Studio(arXiv:2610.20603,HF 52 赞),通过 PERL-Agent 闭环自进化与 6B 参数 SKU-DiT(RDR 三阶段强化蒸馏),支撑日均数百万张秒级生成,并在真实流量基准 CommerceGen-Bench 上以 9.43/9.45 分击败 20B Qwen-Image-Edit 及闭源 Nano Banana Pro;同期微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),在测试时外置统计采样彻底解决大模型生成同质化(Mode Collapse)。

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

核心要点速览

  • 阿里淘天 CommerceGen-Studio(arXiv:2610.20603)在生产环境支撑日均数百万张商品视觉生成、单图延迟仅数秒
  • 通过 Reinforce-Distill-Reinforce(RDR)训练的 6B 参数 SKU-DiT 在 CommerceGen-Bench 单图/多图任务上斩获 9.43 / 9.45 分,越级击败 20B Qwen-Image-Edit(8.67 / 7.48)与闭源 Nano Banana Pro(9.39 / 9.33)
  • 配合 PERL-Agent(Prompt-Eval-Refine-Loop)自进化闭环与 Layout Thinker Optimization 后,综合得分进一步提升至 9.62 / 9.48
  • 微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),通过从真实语料挖掘分类属性并在测试时显式采样,无需训练即可消除网页 UI 设计、智能体 3D 资产合成等五大场景的模式坍塌
阅读全文
关联模型 / 智能体 / 厂商:

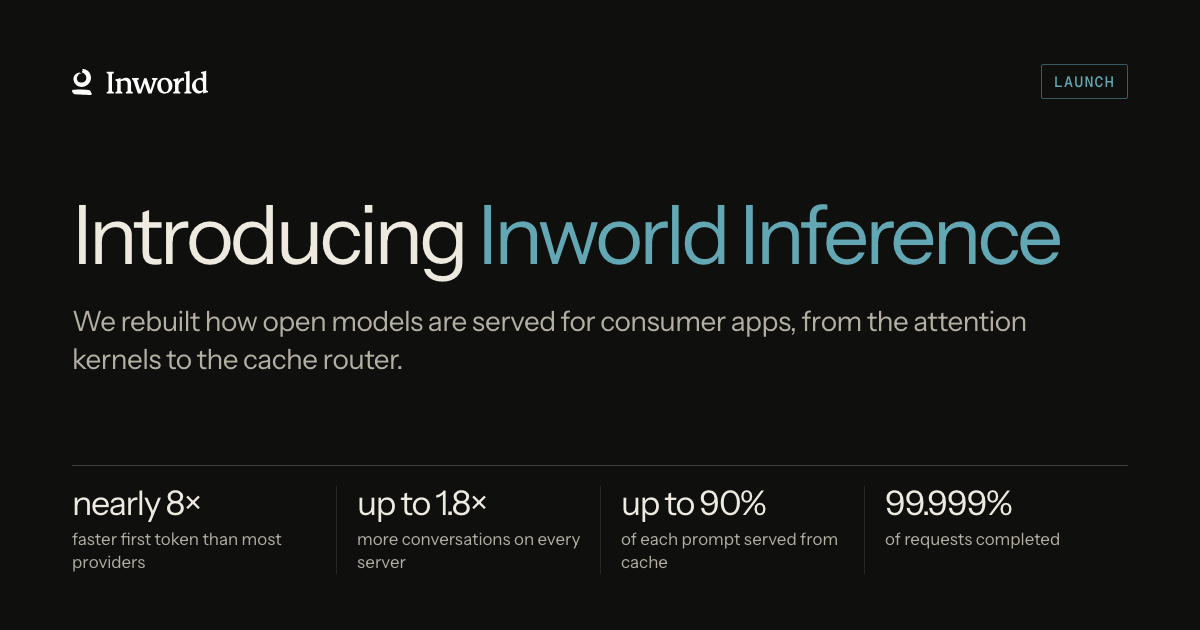
Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

Inworld AI 于 2026-10-14 向所有开发者开放 Inworld Inference,定位为面向消费级应用(陪伴、家教、语音、互动小说)的推理服务。它不铺海量模型,而是为 Gemma 4、GLM 5.3 Flash、DeepSeek、MiMo 等开源模型逐个定制推理构建:草稿-验证(投机)解码、改写的 split-KV 验证注意力、KV 感知路由和按评测把关的低精度权重。官方口径:Gemma 4 26B p95 首 token 0.31 秒,比 OpenRouter 中位供应商快 7.8 倍;最高 90% 提示命中缓存;GLM 5.3 Flash 30 天 2000 万+请求成功率 99.999%。API 兼容 OpenAI SDK,按请求选 Flex/Default/Priority/Fast 四档。

Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

核心要点速览

  • Gemma 4 26B 首 token:p50 0.17 秒 / p95 0.31 秒,较 OpenRouter 中位供应商快 3.6 倍 / 7.8 倍(官方博客,厂商口径,非同负载对比)
  • 价格:Gemma 4 26B 输入 $0.07、缓存 $0.035、输出 $0.34 每百万 token,比不训练用户数据的供应商中位价低近 40%
  • 改写验证注意力 kernel 后单层快 3.4–7.5 倍,注意力占解码步比例 27.5%→16.5%,p50 TTFT 154→117 ms,评测分数不变
  • KV 感知路由:GLM 5.3 Flash 缓存命中 25%→47%,DeepSeek V4.1 Flash 11%→33%;MiMo 2.6 Pro 缓存输入便宜 99%
  • 可靠性:GLM 5.3 Flash 30 天 2000 万+请求仅 98 次失败(约 4.8/百万);service_tier 支持 Flex/Default/Priority/Fast 四档
阅读全文
关联模型 / 智能体 / 厂商:

全模态检索降维打击!MBZUAI 开源 Omni-Embed-Mini:0.9B 参数打通六大多模态,纯冻结文本权重零遗忘

将文本表征模型扩展至语音、音频、图像、视频及图文混排文档等多模态领域时,传统方案往往导致严重的文本检索灾难性遗忘,而现有全模态向量模型通常需要数十亿甚至上百亿参数来勉强维持平衡。穆罕默德·本·扎耶德人工智能大学(MBZUAI)等团队推出了轻量化全模态嵌入模型 Omni-Embed-Mini。该模型仅拥有 0.9B 极小参数量,通过密集的级联描述蒸馏(Dense Cascaded Caption Distillation),将文本、语音、音频、图像、视频与文档六大模态映射进统一的余弦空间。核心突破在于文本侧权重保持 100% 静态冻结(Byte-Identical),从理论与工程上彻底杜绝了文本检索退化(MTEB-v2 BEIR-8 达 49.57 nDCG@10);而其 2.3B 升级变体在全模态平均检索得分上更是逆袭超越了闭源商业标杆 Gemini-Embedding-2。

全模态检索降维打击!MBZUAI 开源 Omni-Embed-Mini:0.9B 参数打通六大多模态,纯冻结文本权重零遗忘

核心要点速览

  • 仅凭 0.9B 极小体积打通文本、语音、音频、图像、视频与图文文档 6 大模态的统一向量对齐
  • 文本侧参数比特级完全冻结,从数学根源杜绝文本灾难性遗忘(MTEB-v2 BEIR-8 达 49.57 nDCG@10)
  • 2.3B 升级版本在多模态综合检索平均表现上全面逆袭超越 Google 闭源商业模型 Gemini-Embedding-2
阅读全文
关联模型 / 智能体 / 厂商:
A
AgentField / Santosh Radha@Agent-Field·
👀81
🔥95

AgentField 开源 CodeAF v0.6:单 Go 二进制「软件工厂」专打开源模型;厂商 DeepSWE 同模对比 54.9% 居首

Agent-Field/CodeAF 以 Apache-2.0 单二进制把开源权重(DeepSeek/Qwen/GLM/Kimi 等)编成「工厂」:一窗派活、子 harness 分工、Pareto Crewing 按任务选模型。v0.6.0 发布于 2026-10-01T18:59:00Z;本跑 ★259。厂商文档:同模 DeepSeek V4 Flash 上 /senior-dev 在 DeepSWE 113 题解出 62(54.9%),单位成本标为对照 1x(有单种子与采样契约差异等限制)。

AgentField 开源 CodeAF v0.6:单 Go 二进制「软件工厂」专打开源模型;厂商 DeepSWE 同模对比 54.9% 居首

核心要点速览

  • 仓库 Agent-Field/CodeAF Apache-2.0;本跑 ★259 / forks 34;安装 curl -fsSL https://agentfield.ai/get/codeaf | bash
  • 正式标签 v0.6.0 发布于 2026-10-01T18:59:00Z;README 仍标 early preview
  • 厂商 DeepSWE 对照(同模 deepseek-v4-flash-0731,113 题):senior-dev 62/113=54.9%、每题约 22¢;mini-swe-agent 49.6%、codex 45.1%、pi 37.2%、claude-code 14.2%(见仓库 docs/benchmarks/deepswe)
  • 后续同套题:DeepSeek V4.1 Flash 上报 88/113=77.9%;Kimi K3 78/113=69.0%(仅 senior-dev,非跨 harness 对比)
  • 内置 OpenRouter/DeepSeek/GLM/Kimi/MiniMax/Qwen/Codex/Ollama;crew 默认 worker/planner/checker 三角色自动选模
阅读全文
AD赞助内容

Command Code 在 Composio Agent 基准中以 18/30 任务领先,平均用时 375 秒

Command Code CEO Ahmad Awais 发布 Composio 基准结果称,Command Code 在开放模型上的 Agent harness 对比中解决 30 项任务中的 18 项,并以 375 秒平均用时领先;该贴引用了 Composio 在 GPT-6 Astra 上对六种编码 Agent harness 的测试。

核心要点速览

  • Command Code 在 30 项任务中解决 18 项,贴文称其准确率领先其他 harness。
  • 平均任务用时 375 秒,贴文称其速度也领先并超过 DeepSeek 自有 harness。
  • 引用的 Composio 测试覆盖 Codex、Claude Code、OpenCode、Hermes Agent、Pi Agent 与 Command Code 六种 harness。
阅读全文
关联模型 / 智能体 / 厂商:

Agent Arena:DeepSeek-V4.1-Flash (Max) 以约 $0.07/任务重塑开源成本帕累托前沿

Arena.ai(@arena)公布 Agent Arena 数据:DeepSeek-V4.1-Flash (Max) 净提升约 +4.87%,中位任务成本约 $0.07,在开源 Top-3 中成本最低;相对 Hy4 preview 保留约 98% 净提升且成本低约 73%,相对 Kimi K3 (Max) 保留约 76% 表现且成本低约 92%。

核心要点速览

  • DeepSeek-V4.1-Flash (Max) 进入 Agent Arena,约 +4.87% 净提升。
  • 中位任务成本约 $0.07,开源 Top-3 中最便宜。
  • 相对 Hy4 / Kimi K3 在成本上大幅占优,重塑帕累托前沿。
阅读全文
关联模型 / 智能体 / 厂商:

TechCrunch:Abliteration.ai 把「去护栏」做成商业服务,托管去掉拒答的 GLM-5.3

TechCrunch 报道初创公司 Abliteration.ai 将长期存在于开源社区的 abliteration(正交化去除拒答倾向)做成可浏览器/API 访问的托管服务,并上线智谱 Z.ai 近期开源权重模型 GLM-5.3 的去护栏版本。公司称面向进攻性网络、红队与智能体测试等「其他模型拒绝做」的工作;TechCrunch 实测可免费注册并用该模型生成窃取 Chrome 密码脚本与危险病原体培养协议等内容。平台提供客户侧可加回的审查层,自身仍有少量限制(如自杀指导),尚无正式 KYC(主要记信用卡)。CivAI 等安全研究者警告大规模可及的去护栏模型可能被滥用于伤害;部分红队从业者则称日常更依赖微调开源模型,且 abliteration 可能损伤能力。

核心要点速览

  • 商业化托管去护栏开源权重模型,含 GLM-5.3 abliterated 版,浏览器/API 可用
  • 自称服务红队/进攻性网络与智能体测试;TechCrunch 实测多项高风险请求被答应
  • 安全争议:降低滥用门槛 vs 让防御方复现威胁;尚无完整 KYC
阅读全文
关联模型 / 智能体 / 厂商:

Together AI 联合 Equinix 与 NVIDIA:Equinix Inference Exchange 开源模型推理上线全球数据中心

Together AI(@togethercompute)宣布与 Equinix、NVIDIA 合作推出 Equinix Inference Exchange:其开源模型平台已在 Equinix 全球数据中心上线,面向企业把「用哪款模型」与「跑在哪里」一并产品化,强调模型选择与性能不必二选一。

核心要点速览

  • Equinix Inference Exchange 上线:Together 开源模型平台部署到 Equinix 全球数据中心。
  • 联合 NVIDIA,面向企业推理场景,把模型选型与部署位置打通。
  • 叙事焦点是开源成为企业默认路径,兼顾选择权与性能。
阅读全文
关联模型 / 智能体 / 厂商:

Ollama 云套餐改按 Token 透明计价:Pro 含 60 美元额度且无隐藏限流

Ollama 宣布 Pro、Max、Team 改为按公开 Token 单价扣费,并内置每月额度池:Pro 20 美元含 60 美元用量、Max 100 美元含 300 美元、Team 500 美元含 1000 美元共享额度且不限席位。新方案对接 Claude Code、Codex 与自建 API,无服务费、无 5 小时或周限额,用完可按同样单价续跑;请求在美欧专属算力上执行(部分 Qwen 走新加坡),零数据留存且不用于训练。旧套餐可继续使用,新注册默认走新价;官方称 GPU 时长计费在 Kimi K3 等超大开源模型上已难以预测。

核心要点速览

  • Pro / Max / Team 分别为 20/100/500 美元,含 60/300/1000 美元每月 Token 额度,Team 不限席位共享额度。
  • 无服务费、无 5 小时或周限额,额度用尽后按同一公开单价继续调用,并兼容 Claude Code 与 Codex。
  • 美欧专属推理、零数据留存且不训练;旧套餐可保留,新用户默认新计价。
阅读全文
关联模型 / 智能体 / 厂商: