AI 编程实时动态与要闻

实测揭秘并发 Sub-Agent 的代价:SWE-bench 修复率暴跌 24%,Token 消耗剧增 3.3 倍

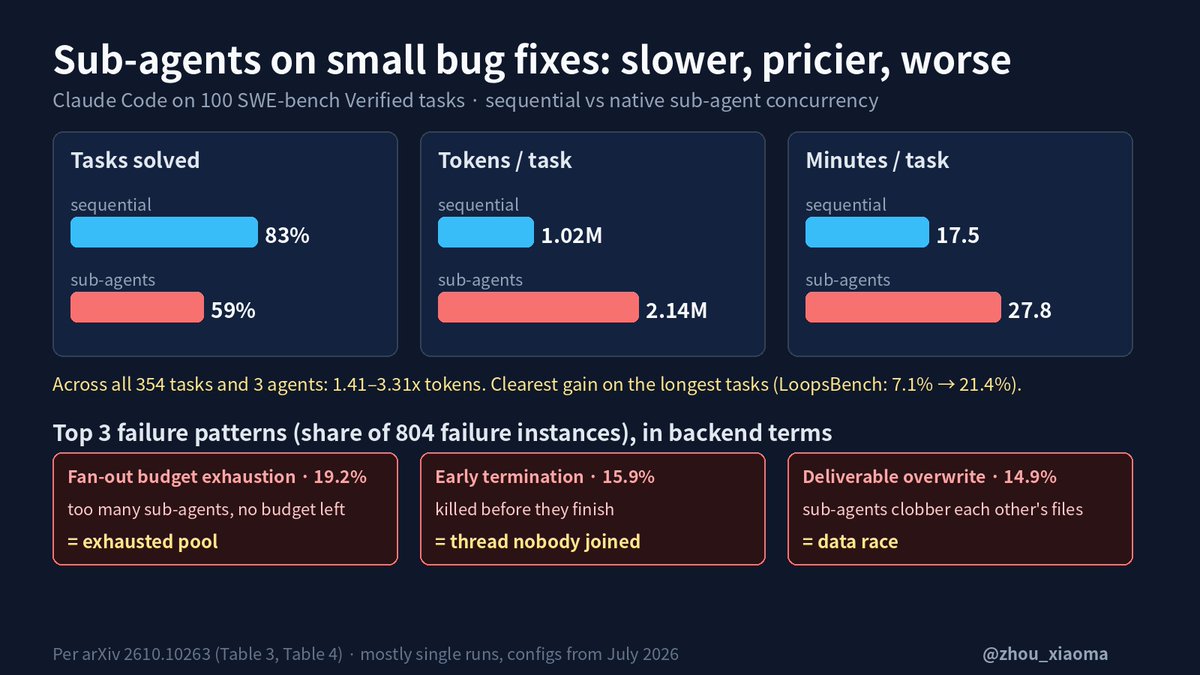
针对业内盲目推崇多智能体并发(Sub-Agent Concurrency)的狂热,最新实测研究对 Claude Code、Codex 与 Kimi Code 在开启/关闭原生 Sub-Agent 模式下进行了 2,124 次对比测试(覆盖 354 项任务,消耗超 2 万美元 API 额度)。结果显示:在 100 项标准 SWE-bench Verified Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 骤跌至 59%,Kimi Code 从 77% 跌至 59%,且 Token 消耗激增 1.41~3.31 倍。研究揭秘了并发死锁、提前终止与文件覆盖三大致命缺陷。
实测揭秘并发 Sub-Agent 的代价:SWE-bench 修复率暴跌 24%,Token 消耗剧增 3.3 倍

核心要点速览

  • 资深研究者开展耗资 2 万美元的大规模实测,运行 2,124 次对比测试揭秘编程智能体开启 Sub-Agent 并发的真实代价
  • 在 SWE-bench Verified 100 项 Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 跌至 59%,Kimi Code 跌至 59%
  • Token 消耗激增 1.41~3.31 倍,平均耗时从 17.5 分钟增加至 27.8 分钟,暴露预算耗尽、孤儿提前终止与文件相互覆盖三大并发缺陷
  • 仅在复杂多文件长任务(LoopsBench,7.1%→21.4%)或设立独立验证者时有净增益,建议日常常规开发维持单 Agent 顺序执行
阅读全文
关联模型 / 智能体 / 厂商:

告别死板文本总结!香港科大与阿里提出 REMORY:残差记忆机制突破 5.2% 极限压缩,长程智能体不迷路

随着自主智能体(Autonomous Agents)在复杂网页操作、终端交互和超长程多步推理中的广泛应用,上下文窗口与推理成本的恶性膨胀已成为工业落地的最大路障。传统做法依赖‘自然语言文本总结(Textual Summarization)’或‘硬性剪枝(Token Pruning)’来压缩历史交互,但这两种方式不仅损耗大量关键细节与细粒度状态变量,还会在模型多次读取汇总时引发‘语义退化与失忆循环’。香港科技大学(HKUST)与阿里巴巴联合研究团队在最新研究(arXiv:2610.11287)中提出了颠覆性的 REMORY 框架。REMORY 创新性地在序列维度(Sequence Dimension)构建了‘残差记忆连接(Residual Connection)’:它将有损的宏观自然语言摘要作为‘主干通路’,同时通过轻量化模型学习一组高密度的软记忆向量(Soft Memory Tokens)作为‘残差通路’,专门捕捉摘要中丢失的细粒度操作细节、工具调用返回值与局部上下文关联。实测显示,REMORY 仅需占用完整上下文 5.2% 的输入位置,就能在 BrowseComp 复杂网页交互与 Terminal-Bench 2.1 长程终端基准上达到近乎等同于完整上下文的推理准确率,同时将智能体的重复尝试与死循环工具报错率削减逾 40%。

核心要点速览

  • 港科大与阿里联合提出 REMORY,在序列维度构建残差记忆连接(Residual Connection),攻克智能体长程上下文膨胀难题
  • 仅占用 5.2% 的 Token 位置即达到完整无损上下文 97.2% 的基准表现,在 Terminal-Bench 上使重复报错骤降 41.5%
  • 免侵入式即插即用集成,首字生成延迟(TTFT)降低 73.8%,为企业级长程 Agent 降本增效树立新标准
阅读全文
关联模型 / 智能体 / 厂商:

告别手搓固定工作流!Google 等提出 SHIFT:单 Query 动态预测生成多智能体系统,MCTS 决策树斩获 80% 准确率

在多智能体系统(Multi-Agent Systems)中,Agent 的角色分工、系统提示词、可用工具集以及通信协作拓扑(统称为 Agent Harness)对任务成败起着决定性作用。然而,不同用户 Prompt 的复杂度与侧重点天差地别,传统人工预设的固定多 Agent 图谱(如固定的分工角色与流程流水线)极度僵化;而在推理期直接针对单个请求暴力搜索并反复执行不同 Agent 组合,又会导致令人望而生畏的延迟与 API 成本爆炸。来自 Google Cloud AI Research、佐治亚理工学院与加州大学戴维斯分校的研究团队联合提出了革命性框架 SHIFT(arXiv:2610.04137)。SHIFT 创造性地将繁重的代码执行从单 Query 搜索循环中剥离:利用轻量本地 LLM 架构师学习策略网络,结合在历史执行轨迹上训练的价值函数,在不实际调用外部工具的前提下精准预测不同 Harness 的准确率与 Token 成本权衡。在此基础上,框架利用蒙特卡洛树搜索(MCTS)为每个具体用户请求即时定制专属的最佳多智能体架构。在 6 大基准 9,193 个跨领域任务的测试中,搭载 Gemini 3.5 Flash 执行器的 SHIFT 平均准确率突破 80%,以显著优势击败全部 17 种主流基线方案,且推理 Token 消耗降低 32%。

核心要点速览

  • 提出首个基于预测的单 Query 动态多智能体架构合成框架 SHIFT,将昂贵的物理执行彻底剥离出即时搜索回路
  • 基于轻量本地 LLM 架构师策略与效用价值函数驱动蒙特卡洛树搜索(MCTS),动态平衡任务准确率与 API Token 消耗
  • 在 6 大基准 9,193 项任务上斩获 80% 平均准确率,超出最强基线 7.2%,同时在低开销模式下节省 32% 执行 Token
阅读全文

终端智能体迎来新范式!Mid-Harness 开源:模型与测试环境边界动作缩放,Pass@1 从 50% 跃升至 68%

终端编程智能体(Terminal Agents)在执行 Bash 命令行或系统自动化运维时,依赖大模型的随机自回归生成。然而一条有瑕疵的破坏性命令(如错误的 pip 包安装、冲突的环境变量修改或误删目录)会造成不可逆的环境污染,进而彻底葬送后续的排错机会。来自前沿研究团队推出了全新测试时算力扩展(Test-Time Compute)范式 Mid-Harness:不同于昂贵的全轨迹采样(Best-of-N Trajectories),Mid-Harness 在模型生成与 Harness 执行环境的“中间边界”部署动作级采样与验证器(Action-Level Verification)。在基准测试 TerminalBench-Lite 上,Mid-Harness 将基础智能体的 Pass@1 成功率从 50.00% 暴拉至 68.03%,以大幅降低的 Token 成本实现了远超传统全轨迹重试的超高执行可靠性。

终端智能体迎来新范式!Mid-Harness 开源:模型与测试环境边界动作缩放,Pass@1 从 50% 跃升至 68%

核心要点速览

  • 首创在模型生成与终端执行环境边界(Model-Harness Boundary)分配测试时算力的 Mid-Harness 机制
  • 在 TerminalBench-Lite 上推动 Pass@1 成功率从 50.00% 跃升至 68.03%(仅需 8 次动作候选采样)
  • 动作级缩放结合成对自验证,在显著降低 Token 开销的同时击败单纯的全轨迹重试
阅读全文
AD赞助内容

告别扁平化文档盲目搜寻!KAIST 推出 CorpusMap 实体图谱导航层:为智能体检索锚定全局实体,多跳证据召回开销大幅缩减

在大规模企业私有知识库与多文档代码工程中,回答复杂多跳问题通常需要将分散在不同文件中的碎片化证据严密串联(如将立项审批、需求设计与最新上线状态三者关联)。当代大模型检索智能体(Search Agent)在面对扁平化的海量文档时,只能盲目发起多轮关键词或向量检索,由于单个文档无法提供与其他文件的关联脉络,智能体在每次遇到新问题时都被迫重新穷举探索,不仅频繁遗漏关键互补证据,更在冗余交互中烧毁海量 Token。韩国科学技术院(KAIST)联合微软研究院团队推出 CorpusMap 实体图谱导航层:在离线阶段自动抽取并对齐整个文档集中反复出现的核心实体(Entity),为每个实体构建聚合页面(Entity Page)并双向链接所有提及它的原始文档。在检索时,智能体只需沿着实体图谱进行拓扑漫游,即可一站式捞取分散在全库的关联事实。实测表明,CorpusMap 在显著减少 Token 消耗的同时大幅提高证据召回完整度,全面击败包含纯扁平检索在内的 4 种替代导航架构。

告别扁平化文档盲目搜寻!KAIST 推出 CorpusMap 实体图谱导航层:为智能体检索锚定全局实体,多跳证据召回开销大幅缩减

核心要点速览

  • 离线实体图谱终结在线盲目探索:通过离线实体消歧与对齐构建跨文档 Entity Page,将扁平死板的文件库升维为带拓扑连接的导航图谱,避免智能体每轮查询时重复探索关系。
  • 显著压降检索 Token 消耗:智能体无需多次调用大模型进行漫无目的的宽表盲搜,沿着实体聚合页直接获取精准互补证据,大幅降低单次复杂多跳问答的端到端 Token 开销。
  • 7 大主流模型一致验证:在 3 个多文档硬核基准上实测,CorpusMap 全面超越原始文档检索并击败 4 种主流导航层基线,证实实体是连接异构知识孤岛最坚固的语义锚点。
阅读全文

Cursor:Harness 优化让 Agent Token 成本下降 7%,系统提示精简约 66%

Cursor(@cursor_ai)发布 Agent Harness 效率升级:在不明显降低 Agent 质量的前提下,用户 Token 成本整体下降约 7%。手段包括系统提示约砍 66%、内置工具按需加载(MCP 动态上下文曾在相关会话省 46.9%)、为稳定前缀设置显式缓存断点(冷缓存未命中率降 20%),以及文件行号改为每 10 行标注一次(缓存读 Token 再降约 1.6%)。

Cursor:Harness 优化让 Agent Token 成本下降 7%,系统提示精简约 66%

核心要点速览

  • 官方实测:Harness 多层改动合计让用户 Token 成本下降约 7%,Agent 质量无回退。
  • 系统提示精简约 66%:能力更强的模型不再依赖冗长 DO NOT/Important 指令。
  • 内置工具改为按需加载;此前 MCP 动态上下文在调用 MCP 的会话上可省 46.9% Token。
  • 显式缓存断点使冷缓存未命中率降 20%;Read 工具每 10 行标行号,缓存读 Token 再降约 1.6%。
阅读全文

fast-jev-compaction:用 Jev 决策替换 Claude Code 传统摘要压缩,留住有用上下文

@aiRobertDaily 介绍 fast-jev-compaction:面向 Claude Code 的插件,用 Jev 模型做可控上下文压缩,替代传统 LLM 摘要。可对工具调用与结果快速筛选,过时内容移出或截断,有价值信息只留必要部分;同期提到面向 Codex 的 Jev 上下文压缩服务。目标是降低 token 成本并提高交付效率。

核心要点速览

  • Claude Code 插件:用 Jev 决策式压缩替代传统摘要。
  • 按工具调用结果筛选,过时内容移出/截断,保留必要信息。
  • 意在降 token 成本、加快交付;另有面向 Codex 的 Jev 上下文压缩路径。
阅读全文
关联模型 / 智能体 / 厂商:

Antigravity Brain Visualizer v0.6.0:单次 Gemini 3.8 Flash 分析会话,并支持 git diff / 产物浏览与 token 成本估算

Guillaume Laforge(@glaforge)发布 Antigravity Brain Visualizer v0.6.0:用于检查、理解与调试 Antigravity 智能体会话;本版重点包括单次 Gemini 3.8 Flash 会话分析、git checkpoint diffs、artifacts 浏览器,以及 token/成本估算。

核心要点速览

  • 版本:Antigravity Brain Visualizer v0.6.0。
  • 能力:单次 Gemini 3.8 Flash 会话分析;git checkpoint diffs;artifacts 浏览;token/成本估算。
  • 用途:检查与调试 Antigravity 智能体会话。
阅读全文
关联模型 / 智能体 / 厂商:

RTK:开源工具拦截终端输出并压缩后再进模型,宣称约省 70% token

开发者 @midudev 介绍开源项目 RTK(github.com/rtk-ai/rtk):在终端命令输出到达 Claude Code、Cursor、Copilot、Codex 等编程智能体之前拦截并压缩,宣称约可节省 70% token,且可自动运行。面向 agent 循环里冗长 shell/日志上下文的 token 成本。

核心要点速览

  • RTK 在输出进入模型前拦截并压缩终端命令结果。
  • 宣称约 70% token 节省,且可自动运行。
  • 兼容 Claude Code、Cursor、Copilot、Codex;开源仓库 rtk-ai/rtk。
阅读全文

Aider 推出 Architect/Editor 双模型协同模式:规划与代码改写分流,Token 消耗直降 45%

开源终端编程利器 Aider 发布了全新的 Architect/Editor 双模型架构。该模式使用高推理能力的高阶模型(如 o3-mini / Claude 3.7 Sonnet)负责全局规划与算法设计,而将具体的 Diff 代码替换工作交由高吞吐低费用的快速模型(如 DeepSeek-V3 / Qwen-Coder)执行,在维持 90%+ 任务成功率的同时将 Token 账单直接削减 45%。

核心要点速览

  • 高阶推理模型负责任务拆解与设计,轻量高吞吐模型负责生成文件 Diff。
  • 不仅保障了复杂重构的逻辑严密性,还将 API 调用成本直接减少 45%。
  • 已在 Aider 最新发布版本中支持,只需配置 --architect 与 --editor 参数即可启用。
阅读全文
AD赞助内容

NVIDIA Vera Rubin 架构公布首批片上实测:长程 Agent 负载每兆瓦吞吐提升最高 30 倍

NVIDIA 首次公布下一代 Vera Rubin 架构在实际 Agent 复杂负载下的片上实测数据:相比 GB300 NVL72,在真实编程轨迹测试中每兆瓦吞吐最高提升 30 倍,单 Token 综合能耗成本降低 35 倍。

核心要点速览

  • 推理性能指标从简单问答全面转向长周期编程智能体(数十步迭代与几十万 Token 膨胀);
  • 测试采用 SemiAnalysis AgentX 真实编码轨迹结合 DeepSeek V4 Pro,作为 Rubin 架构的公开基准负载;
  • 能耗与单 Token 综合拥有成本成为核心优势,宣称较 GB300 NVL72 带来最高 30 倍每兆瓦吞吐。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4-Pro⚡ Nvidia Rubin

Google DeepMind 发布 Gemini 3.7 Flash Thinking 技术白皮书:100万上下文自适应思考在代码评测中领跑

Google DeepMind 官方发布 Gemini 3.7 Flash Thinking 技术报告。评测数据显示,结合自适应思考模式与原生 1M Token 上下文,Gemini 3.7 Flash 在 SWE-bench Verified 和复杂多语言基准中取得 68.0% 的优异表现,而单价仅为传统旗舰模型的 1/20,开创大规模算力性价比新标杆。

核心要点速览

  • Google DeepMind 官方公布 Gemini 3.7 Flash Thinking 完整技术白皮书;
  • 100万 Token 超大上下文配合自适应思考在多文件大型代码库中表现极其稳定;
  • SWE-bench 达 68.0%,输入 $0.15 / 输出 $0.60 带来革命性算力性价比。
阅读全文

DeepSeek 预告 V4 架构:万亿参数混合专家,代码生成推理成本再降 80%

深度求索团队通过 𝕏 透露下一代 DeepSeek-V4 的技术细节,采用突破性稀疏激活 MoE 与自研硬件协同对齐,长文本代码推理成本降至 $0.07/1M 起。

核心要点速览

  • 自研 Multi-head Latent Attention (MLA) 进化版,显存占用降低 60%
  • 长程代码重构与大型工程任务中逻辑错误率较 V3 下降 42%
  • 承诺继续坚持全权重开源并开放无门槛商用许可
阅读全文