
AI 编程实时动态与要闻

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

微软 AI 10 月 27 日宣布 MAI-Image-2.6 和 MAI-Image-2.6-Flash 在 Microsoft Foundry 正式商用(GA),支持最多 5 张参考图的多图编辑、Bing 联网 grounding 和最高 1.5K 输出,并公布按 token 计价。同一天,新一代图像编辑模型 MAI-Image-2.7-Preview 以 1470 分登上 Arena 图像编辑榜总榜第 3(比 2.6 高 45 分),目前只能在 MAI Playground 做图像编辑。
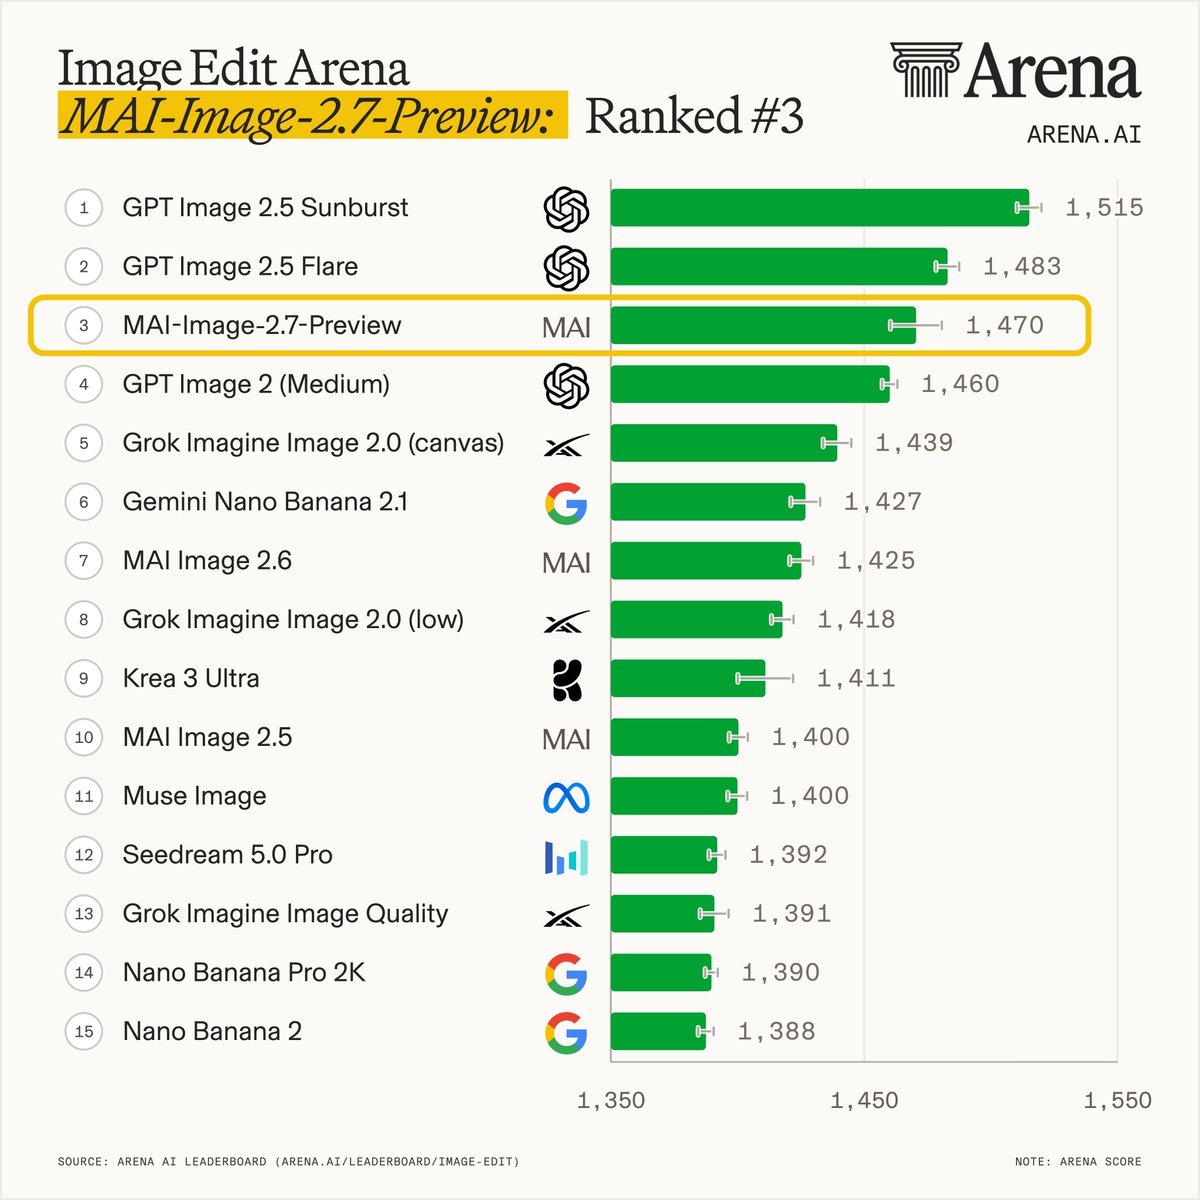
微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

核心要点速览

  • MAI-Image-2.6 和 2.6-Flash 在 Microsoft Foundry 正式 GA,Adobe Firefly 也将「很快」接入 2.6(官方口径)
  • 官方定价:2.6 为文本输入 $5、图像输入 $8、图像输出 $38 / 百万 token;Flash 为 $1.75 / $2.50 / $19
  • 2.6 支持最多 5 张参考图的多图编辑、Bing 联网 grounding、动态宽高比和最高 1.5K 输出
  • Arena 数据:MAI-Image-2.7-Preview 以 1470 分列 Image Edit Arena 总榜第 3,比 2.6(第 7)高 45 分,微软在实验室排名中列第 2
  • Artificial Analysis 数据:2.7-Preview 在 AA-Image-Editing v2.1 排第 2,7 项编辑动作全部超过 2.6,其中 4 项排第 1
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Image-2.6⚡ MAI-Image-2.6-Flash⚡ MAI-Image-2.7-Preview🌐 Microsoft🌐 Microsoft AI

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

Ollama Cloud 全面上线 DeepSeek-V4.1-Flash:美欧托管、零留存,计价对齐 DeepSeek API

Ollama 宣布 DeepSeek-V4.1-Flash 已在其云端全面上线:美欧托管、提示与回复零留存不训练,按 Token 计价对齐 DeepSeek API(含非高峰价);Pro/Max/Team 或按量免费账号可用,并称该模型能力、速度与性价比优于含 V4-Pro 在内的前代 DeepSeek。

核心要点速览

  • DeepSeek-V4.1-Flash 已在 Ollama Cloud 全面可用。
  • 美欧托管;提示/回复零留存、不用于训练。
  • 按 Token 价对齐 DeepSeek API(含非高峰);Pro/Max/Team 或按量可用。
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind:Gemini 上线代理式视频理解,Token 最多省 88%、成本约降 66%

Google DeepMind 宣布在 Gemini 3.7 Flash、3.6 Flash 与 3.5 Flash-Lite 上线代理式视频理解:模型可按目标动态检索画面、音频与字幕,而不是固定帧率吞整段视频。官方称标准评测上最高可减 88% Token、约降 66% 分析成本,并提升最多约 7% 准确率;已通过 Gemini API、Google AI Studio 与 Enterprise Agent Platform 开放,按标准 Token 计价、无额外功能费。

核心要点速览

  • 覆盖 Gemini 3.7 Flash / 3.6 Flash / 3.5 Flash-Lite,API 配置 processing=agentic 即可启用。
  • 长视频分析:Token 最多省 88%,成本约降 66%,准确率最高约 +7%。
  • 支持上传视频与 YouTube;亚秒级片段检索、异常检测与精确计数等能力面向开发者工具链。
阅读全文
AD赞助内容

Ollama 云套餐改按 Token 透明计价:Pro 含 60 美元额度且无隐藏限流

Ollama 宣布 Pro、Max、Team 改为按公开 Token 单价扣费,并内置每月额度池:Pro 20 美元含 60 美元用量、Max 100 美元含 300 美元、Team 500 美元含 1000 美元共享额度且不限席位。新方案对接 Claude Code、Codex 与自建 API,无服务费、无 5 小时或周限额,用完可按同样单价续跑;请求在美欧专属算力上执行(部分 Qwen 走新加坡),零数据留存且不用于训练。旧套餐可继续使用,新注册默认走新价;官方称 GPU 时长计费在 Kimi K3 等超大开源模型上已难以预测。

核心要点速览

  • Pro / Max / Team 分别为 20/100/500 美元,含 60/300/1000 美元每月 Token 额度,Team 不限席位共享额度。
  • 无服务费、无 5 小时或周限额,额度用尽后按同一公开单价继续调用,并兼容 Claude Code 与 Codex。
  • 美欧专属推理、零数据留存且不训练;旧套餐可保留,新用户默认新计价。
阅读全文
关联模型 / 智能体 / 厂商: