

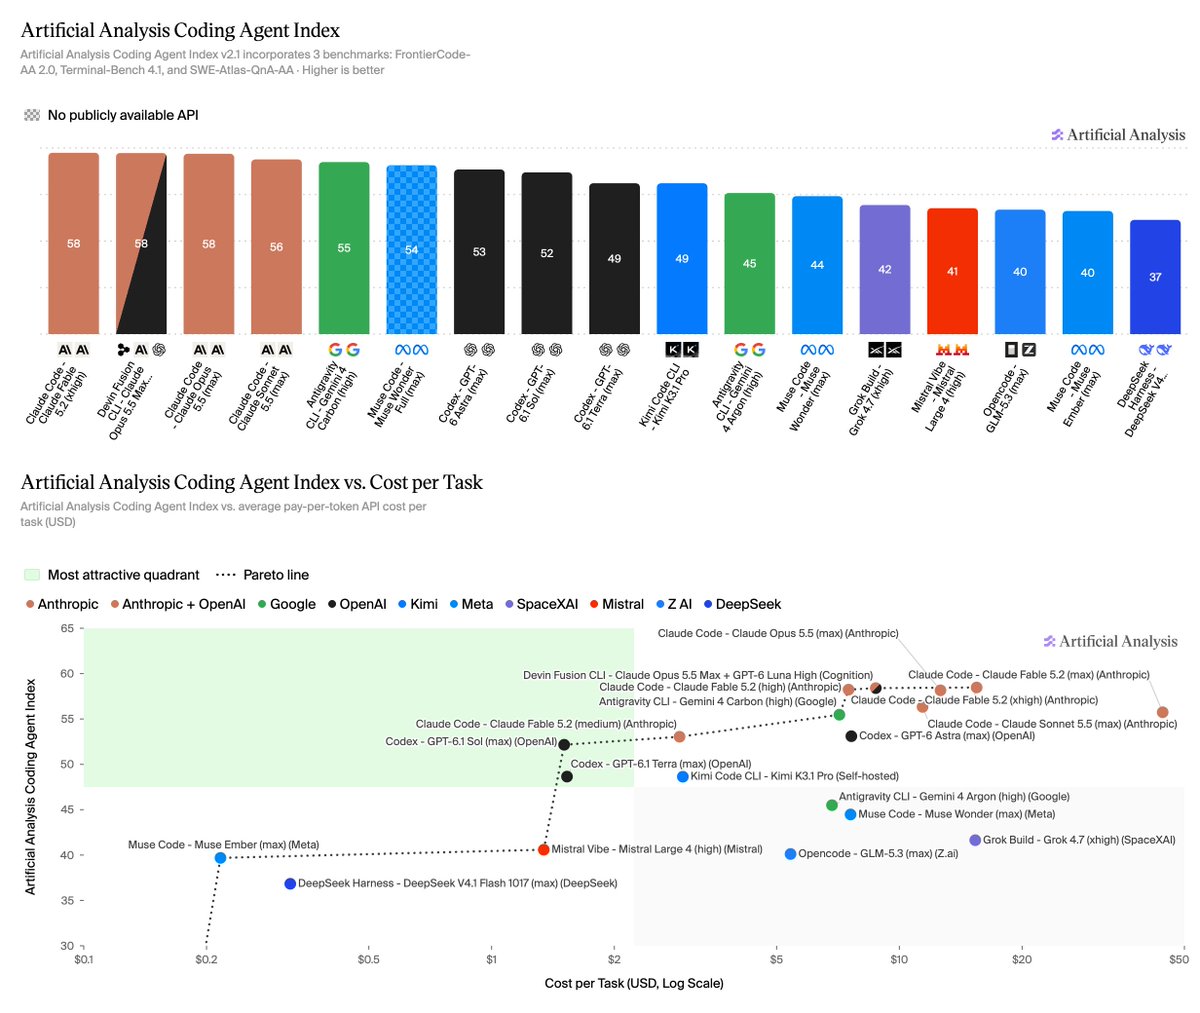
Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。
核心要点速览
- ✓v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
- ✓并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
- ✓23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
- ✓成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
- ✓Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
背景与痛点
编码智能体榜单的价值取决于题目能否反映真实工作。Artificial Analysis 的 Coding Agent Index 测的是「模型 + 智能体外壳」的组合(如 Claude Code、Codex、Devin Fusion CLI),v2.0 在 10 月用 FrontierCode 1.1 替换了 DeepSWE。随着 Cognition 推出更难、更贴近合并标准的 FrontierCode 2.0,旧题已难以拉开头部差距,于是有了 v2.1。
架构亮点与底层机制
v2.1 由三部分组成:FrontierCode-AA 2.0 是 AA 对 Cognition FrontierCode 2.0 的实现,132 个真实任务,按仓库维护者是否会合并智能体的改动评分;Terminal-Bench 4.1 保留 4.0 的 66 题,但更新了验证器,减少误判和奖励投机;SWE-Atlas-QnA-AA 保持不变。
权威 Benchmark 与实测跑分对比
据 AA 官方帖:Claude Fable 5.2 与 Claude Opus 5.5 以 58 分并列第一,但强项不同——Fable 5.2(xhigh)FrontierCode 高 5 分(49% 对 44%),Opus 5.5(max)SWE-Atlas 高 4 分(66% 对 62%)。新版 FrontierCode 让 23 个配置均值从 45% 降到 29%,指数整体平均降 5 分;Codex + GPT-6.1 Terra(max)是唯一没掉分的配置。Terminal-Bench 4.1 上 Kimi Code CLI + Kimi K3.1 Pro 以 68% 领先。
开发者实战落地与开箱指南
选型时别只看总分:Fable 5.2 在 high 档(58 分、每题 7.51 美元)就达到最高分,max 档反而因更多尝试超时只有 56 分、每题 44.22 美元;预算敏感可看 Codex + GPT-6.1 Sol(52 分、1.51 美元)。注意 Claude Code 等外壳遇到安全拒答会切换备用模型,最多约 9% 的尝试并非由标称模型完成。完整结果与方法见 AA 官网。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察