
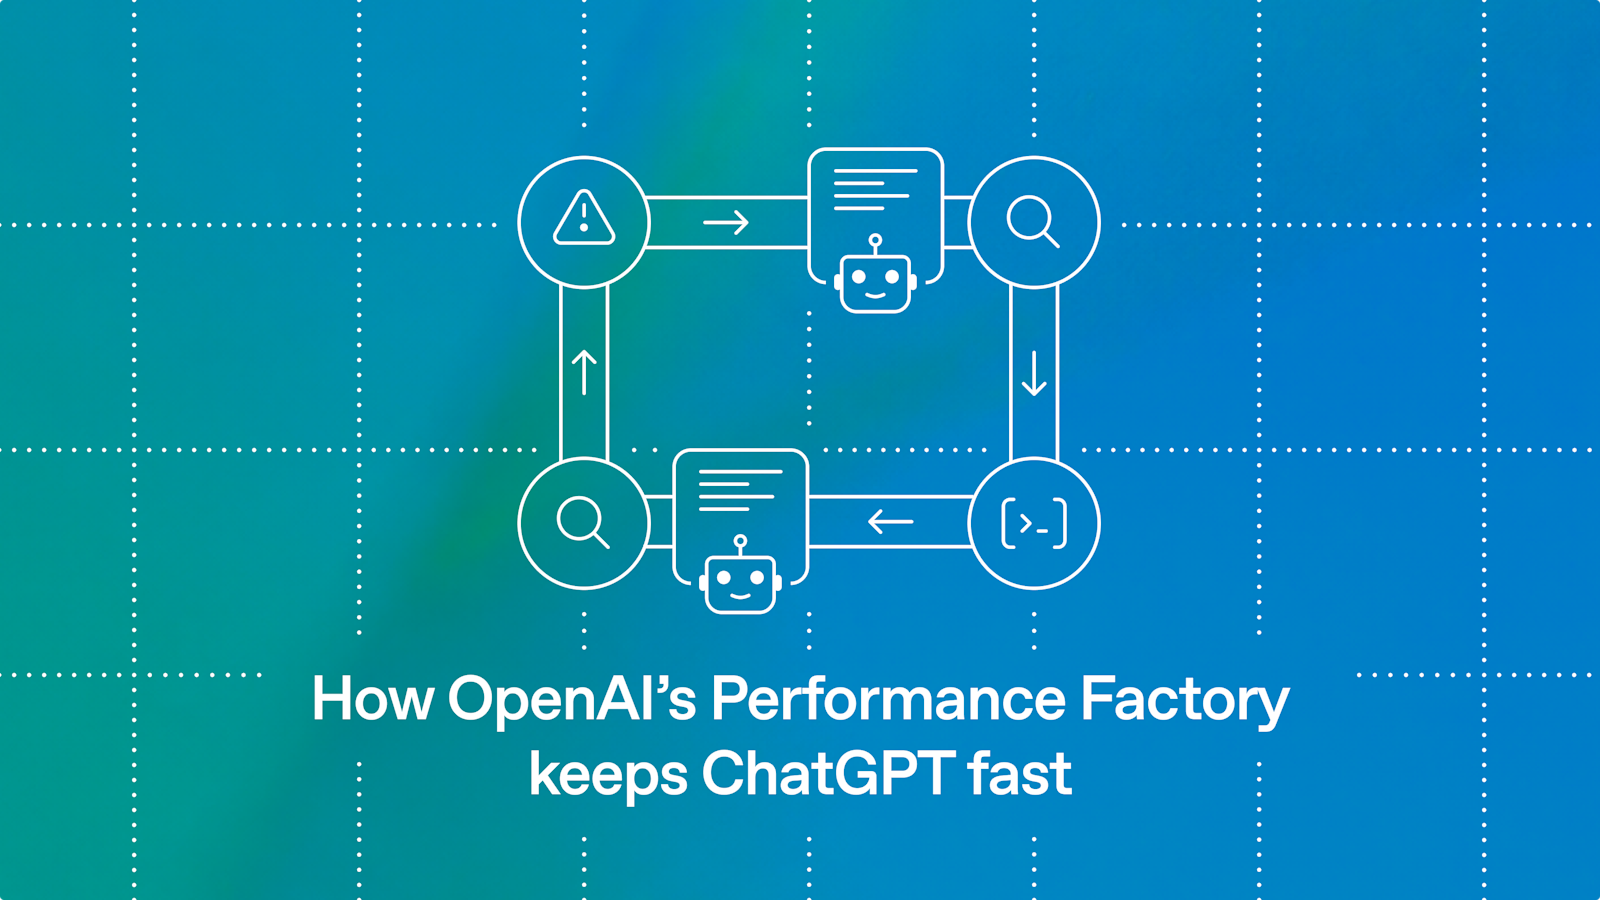
OpenAI 11 月 19 日在官方博客介绍内部系统 Performance Factory:性能告警触发后自动开任务,由 Codex 智能体定位回退原因、经另一个 Codex 会话做对抗式复核、再提交修复 PR 给工程师审核,上线后由智能体确认指标是否恢复。首个工作流 Regression Workflow 三个多月跟踪了 1700 多次调查、定位 600 多个根因,平均每天 17 次;人工抽查 100 条根因结论,70% 被评为准确。
核心要点速览
- ✓官方:OpenAI 博客 11 月 19 日发布,作者为技术人员 Okay Zed 与 Cyrus Forbes,@OpenAIDevs 同步发帖
- ✓架构:四个组件,任务追踪器(可配置工作流)、派发循环、云端运行 Codex 的 API、订阅机制(PR 评论或部署完成时唤醒智能体)
- ✓数据:三个多月 1700 多次调查、600 多个根因,日均 17 次;人工评审 100 条根因建议,70% 准确、30% 需细化或未完全证明因果
- ✓把关:根因和修复都要过独立 Codex 会话的对抗式复核;是否合并 PR 仍由工程师决定
- ✓下一步:用合成性能测试让智能体先自测修复,并探索低风险修复无需人工即可上线
关键决策指标一览
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Codex 让 ChatGPT 的开发速度大幅加快,性能回退也随之变多。过去工程师要手动翻指标、日志、链路追踪和代码,团队为此积累了 30 多个性能工具,但仍跟不上节奏。OpenAI 于是把排查流程做成了自动化的 Performance Factory。
架构亮点与底层机制
系统由四部分组成:带可配置工作流的任务追踪器、定期派发就绪任务的循环、在云端运行 Codex 的 API,以及在 PR 评论或部署完成时唤醒智能体的订阅机制。任务状态和发现记录在任务里,不依赖单个智能体的上下文。排查方法沉淀为 perf-forensics 技能;根因和修复都要再经过一个独立 Codex 会话的对抗式复核。
权威 Benchmark 与实测跑分对比
官方没有公布跑分,只给了运行数据:Regression Workflow 三个多月跟踪 1700 多次调查、定位 600 多个根因,日均 17 次。人工评审 100 条根因建议,70% 准确,30% 需要细化或未完全证明因果。官方也承认修复比定位更难,智能体的修改有时过于复杂或引入新问题。
开发者实战落地与开箱指南
这套模式可以直接借鉴:把团队排查经验写成技能,用任务记录在多个智能体和工程师之间传递状态,等待评审或部署时让智能体挂起、靠事件唤醒,关键结论安排独立会话复核,合并权留给人。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察