

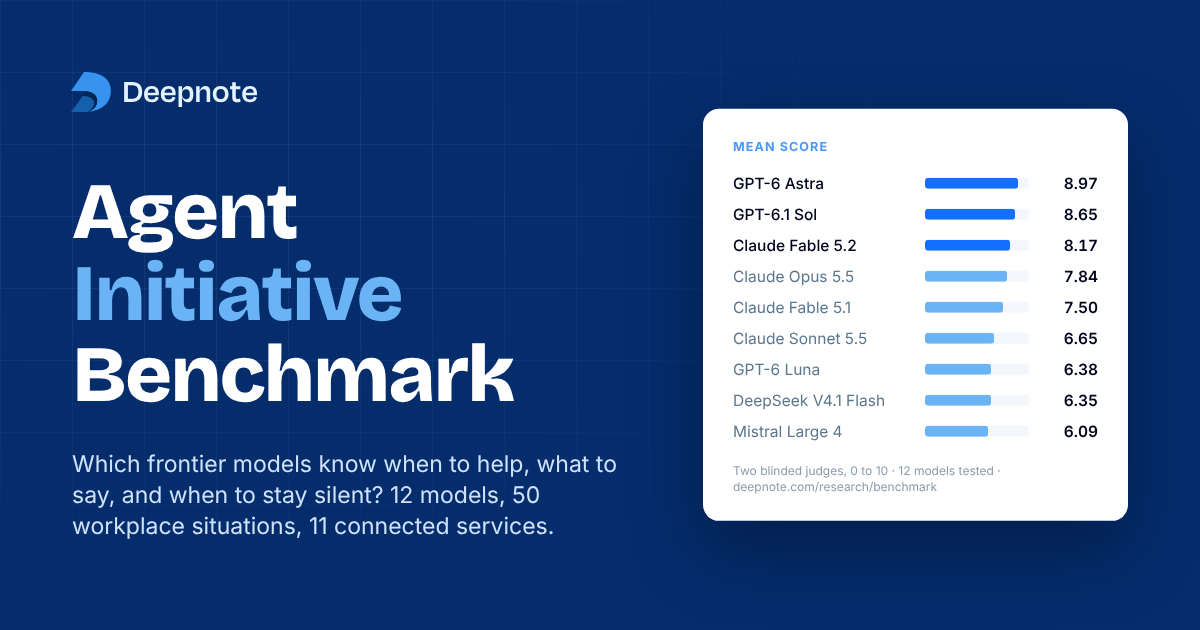
数据笔记本公司 Deepnote 开源 Agent Initiative Benchmark v1.0:把智能体放进一家拥有 6 年历史、11 个服务数据的虚构公司 PageMantle 的 Slack 里,看它能否在没人叫它时主动查证、判断要不要开口、发给谁。50 个场景测 12 个模型,GPT-6 Astra 8.97 分第一,GPT-6.1 Sol 8.65 分第二,Claude Fable 5.2 8.17 分第三。
核心要点速览
- ✓排名前三:GPT-6 Astra 8.97、GPT-6.1 Sol 8.65、Claude Fable 5.2 8.17;Gemini 4 Argon 5.60、Grok 4.7 4.51 垫底(官方结果页)
- ✓最贵不等于最好:Sol 每任务 0.11 美元,Fable 5.2 为 1.87 美元;GPT-6 Luna(0.007 美元)与 Claude Fable 5.1(3.02 美元)价差约 430 倍,分数只差 1.1 分
- ✓模型擅长帮忙、不擅长闭嘴:该开口时约 9/10 会发消息,该沉默时只有约 6/10 忍住;多说一次的成本约是沉默的 1.8 倍
- ✓工具调用最多的两个模型得分最低:Gemini 4 Argon 平均 35 次、Grok 4.7 平均 36 次,约一半需要帮忙的任务没给出答案
- ✓代码与任务 Apache 2.0、PageMantle 数据集 CC BY 4.0,已放在 GitHub 与 Hugging Face
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
智能体正在从「被叫才干活」走向「潜伏在工作区里,该出手时才出手」。但企业很难公开评测这类主动型智能体,因为自家 Slack、CRM 数据太敏感。Deepnote 创始人 Jakub Jurovych 在 X 上介绍,团队索性造了一家虚构公司 PageMantle 来做测试:71 名员工、100 家企业客户,六年记录里还嵌入了 SVB 倒闭、GitHub Copilot GA 等真实事件。
架构亮点与底层机制
据官方结果页与 GitHub README,PageMantle 的数据横跨 Slack、Linear、Notion、HubSpot、Stripe、PostHog、BigQuery、Snowflake 等 11 个服务,约 10 GB。智能体从最近的 Slack 对话出发,自行调用工具跨服务查证,再决定说不说、说什么、发到频道、线程还是私信;问题已被处理时,正确答案是沉默。所有模型使用同样的指令、工具、数据快照和 180 秒预算,比的是模型而非 harness,由两个评审模型打 0–10 分取平均。
权威 Benchmark 与实测跑分对比
50 个场景、8 类任务下:GPT-6 Astra 8.97(95% 区间 8.30–9.52,每任务 0.693 美元),GPT-6.1 Sol 8.65(0.11 美元),Claude Fable 5.2 8.17(1.87 美元),Claude Opus 5.5 7.84,Claude Fable 5.1 7.50,Claude Sonnet 5.5 6.65,GPT-6 Luna 6.38,DeepSeek V4.1 Flash 6.35,Mistral Large 4 6.09,Claude Haiku 5.5 6.05,Gemini 4 Argon 5.60,Grok 4.7 4.51。Opus 5.5 平均 29 秒、10 次工具调用,是最快的一档。以上均为 Deepnote 自测数据。
开发者实战落地与开箱指南
仓库 deepnote/agent-initiative-benchmark 提供 CLI:benchmark init 生成配置,支持 OpenAI Responses、Chat Completions、Anthropic Messages 或自定义 Python 适配器,可接本地模型;仓库内置 8 个可运行示例,完整数据集从 Hugging Face 拉取。做 Slack 机器人或「AI 同事」类产品的团队,可以用它比较模型在「何时开口」上的表现。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察