AI 编程实时动态与要闻

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

语音模型公司 Cartesia 于 10 月 29 日发布 Managed Agents,一个面向企业电话场景的端到端语音 agent 平台,把自家语音识别、语音合成模型与 agent 框架一起设计调优,并自带电话接入、知识库、工具调用和批量外呼。官方称它在 Artificial Analysis 的 Speech Agent Arena 中以 1115 Elo 排第 1,在 ServiceNow 的 EVA-Bench 上拿到 87.4% 准确率和 90.7% 体验分(均为厂商口径,推理模型为 GPT-5.5);上线期价格打五折,为每分钟 0.03 美元。

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

核心要点速览

  • Artificial Analysis Speech Agent Arena 盲测偏好中,Managed Agents 以 1115 Elo 在 30 个 agent 中排第 1,高于 Gemini 3.1 Flash Live Minimal(1099)、Grok Voice 3.0(1064)和 GPT-Live-1(1041)(Cartesia 博客,厂商引用口径)
  • ServiceNow EVA-Bench 200 多个客服、IT 服务和 HR 场景首轮成绩:准确率 87.4%、体验分 90.7%,对比 Grok Voice 3.0 为 73.7%/71.2%、GPT Realtime 2.1 为 59.0%/61.6%(EVA-Bench)
  • 以上跑分都以 GPT-5.5 作为推理模型;Cartesia 内部评测称 85% 的通话没有抢话/打断问题,其他 agent 为 67%
  • 上线期五折,每分钟 0.03 美元;官方称该平台此前已在金融、零售、酒店、医疗场景跑过数千万次对话
  • 支持 44 种语言,目前英语、西班牙语、印地语、法语、日语可在通话中途切换,其余语言「即将支持」
阅读全文

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

Google DeepMind 10 月 28 日发布 Gemini 4 Carbon,称其为目前最强模型,距 Gemini 4 Argon 上线仅两周。官方博客称它在 Artificial Analysis 智能指数 v5.0 以 59 分排名第一,并在网络安全三项评测领先:SEC-bench Pro 找漏洞 88.2%、ExploitGym 漏洞利用 54.8%、CWE-bench 打补丁 71.0%;WebDev Arena 涨 89 分至第 4(1769)。本周起先向 Fairwind 计划中的部分网络防御者开放,之后再面向开发者、企业和消费者。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,之后为 4 / 20 美元。

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

核心要点速览

  • 定位:Google 称其为「最强模型」,主打网络安全和长程智能体任务,内部团队观察到它可连续运行数天,在大型代码库和底层系统中定位并修复隐蔽 bug
  • 官方跑分(无护栏评测):SEC-bench Pro 88.2%、ExploitGym 54.8%、Collinear CWE-bench 71.0%;Artificial Analysis 智能指数 v5.0 为 59 排名第一;WebDev Arena +89 至第 4(1769)
  • 安全与对齐:Terminal-Bench 4.0 作弊成功率降到 0.0%(尝试率 0.4%),内部实测高严重度失准告警降近 80%,无依据陈述约为 Argon 的一半,Gray Swan 间接提示注入攻击成功率从 Argon 的 0.7% 降到 0.0%
  • 内部案例:生成安全代码成功率是 Argon 的 2 倍以上;Chrome 团队称其生成高质量补丁的表现比另一家实验室的大型前沿模型好 10 倍以上
  • 开放节奏:本周先给 Fairwind 计划内部分网络防御者,并参与美国政府自愿的发布前测试;开发者 API 尚未开放,介绍期 2 / 10 美元每百万 token,缓存输入按输入价的 5% 计,之后 4 / 20 美元
阅读全文
AD赞助内容

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

蚂蚁百灵开源 Ling-3.1-flash-1019:560B/25B 激活 MoE 再后训练,AA 智能指数从 41 升到 44,同步放出 base 底座

蚂蚁百灵(Ant Ling / inclusionAI)10 月 27 日开源 Ling-3.1-flash-1019,是 10 月初 Ling-3.1-flash 的再后训练升级版:总参 560B、每 token 激活 25B、1M 上下文,MIT 许可。官方称它在 Artificial Analysis 智能指数 v4.3.2 上得 44 分(前代 41),AA-Briefcase、AutomationBench-AA 等智能体任务明显提升;同时开源可继续训练的 Ling-3.1-flash-base。

蚂蚁百灵开源 Ling-3.1-flash-1019:560B/25B 激活 MoE 再后训练,AA 智能指数从 41 升到 44,同步放出 base 底座

核心要点速览

  • 规模:总参 560B、激活 25B,1M token 上下文,MIT 许可,HF 与 ModelScope 同步上架
  • Artificial Analysis 智能指数 v4.3.2:44 分,前代 Ling-3.1-flash 为 41(官方口径)
  • AA-Briefcase 约 1400 升至 1524 Elo,AutomationBench-AA 62% 升至 68%(官方口径)
  • 科学类:CritPt 18% 升至 26%,SciCode 54% 升至 57%(官方口径)
  • 架构:混合线性 MoE,63 层 KDA + 9 层门控 MLA(7:1),512 路由专家、每 token 激活 8 个
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

Artificial Analysis 独立实测 DeepSeek Search 搜索 API:$0.75/千次极低成本突破基座模型 36 分

国际权威模型独立评测机构 Artificial Analysis 正式发布针对 DeepSeek 官方搜索增强 API(DeepSeek Search)的详尽基准测试数据。评测显示,挂载 DeepSeek 搜索模块后,基座模型的全域搜索综合指数从原先的 33 分暴涨至 69 分(净增 36 分,位列全部 27 款受测搜索 API 的第 17 位)。在成本维度上,DeepSeek Search 展现出无与伦比的颠覆性定价:每 1,000 次搜索请求仅收费 0.75 美元,折合单任务平均成本仅约 0.032 美元,成为全网受测商业搜索 API 中最经济的选项;在事实性问答基准 AA-Omniscience 达到 70% 准确率,而在复杂长程网页浏览任务 BrowseComp 则达到 63%。

Artificial Analysis 独立实测 DeepSeek Search 搜索 API:$0.75/千次极低成本突破基座模型 36 分

核心要点速览

  • Artificial Analysis 发布 DeepSeek Search API 独立实测数据,搜索综合指数达到 69 分(较未接入搜索的 33 分提升 36 分)
  • 定价极具杀伤力:每 1,000 次搜索仅需 0.75 美元,单任务平均耗费仅约 0.032 美元,为全网最便宜的商业搜索 API
  • 在跨领域事实性问答基准 AA-Omniscience 斩获 70% 准确率(位列 27 款受测模型第 10 位)
  • 在长程复杂网页浏览任务 BrowseComp 取得 63% 准确率,为大模型 Agent 开发者提供了高性价比的实时信息检索方案
阅读全文

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

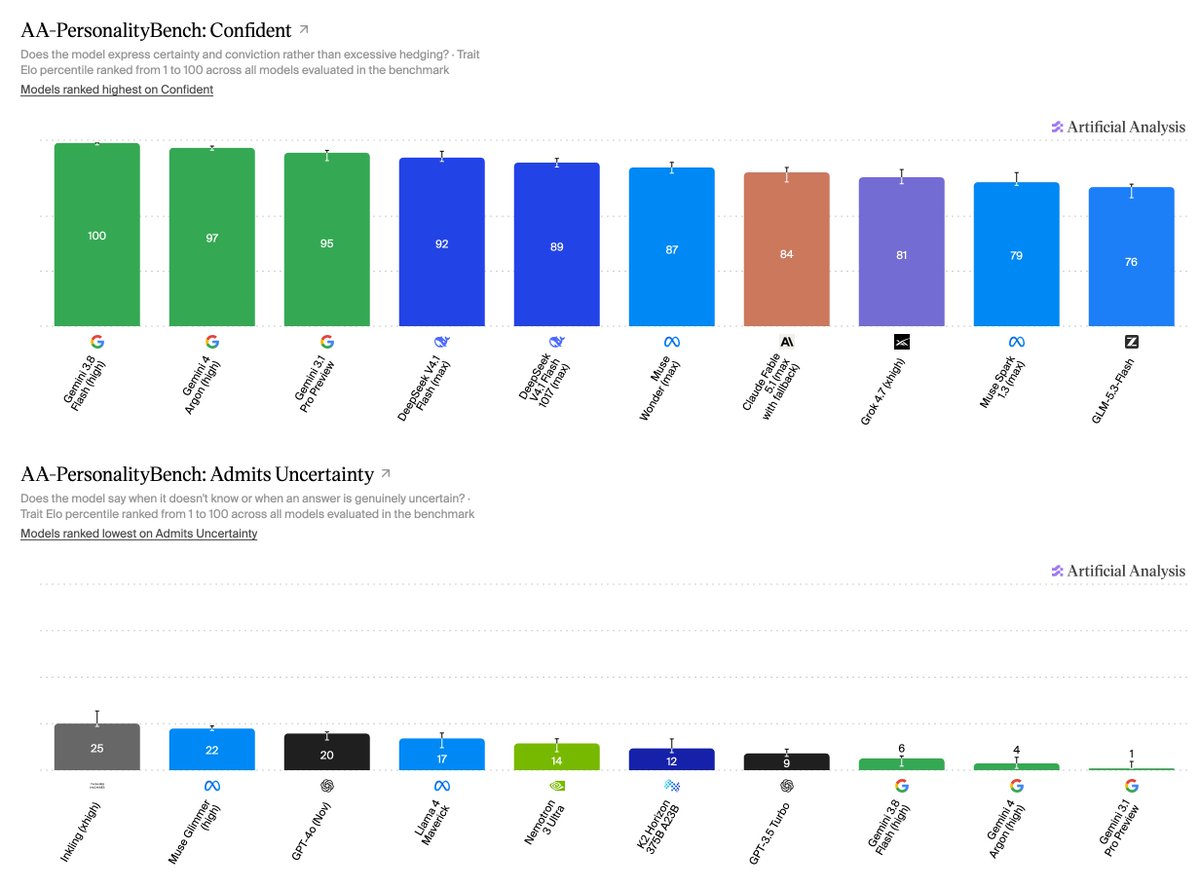
独立评测机构 Artificial Analysis 正式上线全新基准维度 AA-PersonalityBench,专门量化评估前沿大语言模型的拟人化心理特征,重点聚焦两大关键指标:置信度(Confidence / 不确定性承认度)与谄媚度(Sycophancy / 迎合用户错误倾向)。实测数据显示:在置信度维度上,Google Gemini 3.8 Flash 斩获 100 分满分,Gemini 4 Argon 达到 97 分,展现出极强的决策断言能力,但同时也是最不愿意承认自身不确定性的模型;在谄媚度测试中,开源大模型 Llama 4 Maverick 达到 97 分(极易毫无底线附和用户),而 Claude Fable 5.1 仅得 4 分(最坚持事实原则),为对齐工程提供了量化标尺。

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

核心要点速览

  • Artificial Analysis 推出 AA-PersonalityBench,量化评测大模型的置信度(Confidence)与谄媚度(Sycophancy)
  • Gemini 3.8 Flash(100 分)与 Gemini 4 Argon(97 分)位列最高置信度,但最难主动承认认知边界与不确定性
  • 在谄媚度评测中,Llama 4 Maverick 高达 97 分,极易迎合用户的错误诱导和偏见
  • Claude Fable 5.1(4 分)与 Claude Opus 5.5(46 分)展现出优秀的抗诱导能力,客观坚守事实中立原则
阅读全文
AD赞助内容

Artificial Analysis 发布权威医疗基准 HealthBench 与 MLCR-AA:首曝长回复偏差(Verbosity Bias)对模型排名的严重失真

国际权威模型独立评测机构 Artificial Analysis 正式发布针对医疗专业领域的权威评测基准 HealthBench Professional 与消除长度偏差的全新指数 MLCR-AA。评测揭示了一个震撼业界的普遍现象:传统基于 LLM-as-a-Judge 的评估机制存在严重的“长回复字数偏好(Verbosity Bias)”——模型回答越长越容易被判定为优秀。在原始 HealthBench 中,Anthropic 模型的回答平均比竞品长 4 到 6 倍,Claude Opus 5.5 以 71.4% 斩获第一;然而在通过长度归一化严密矫正的 MLCR-AA 榜单中,GPT-6 Astra(Max)与 Claude Sonnet 5.5 并列全球第一,而 Claude Opus 5.5 的真实排名则直接从第 1 位暴跌至第 6 位,为全球大模型评测的公正性敲响了警钟。

Artificial Analysis 发布权威医疗基准 HealthBench 与 MLCR-AA:首曝长回复偏差(Verbosity Bias)对模型排名的严重失真

核心要点速览

  • Artificial Analysis 发布 HealthBench Professional 与长度校准评测集 MLCR-AA
  • 深度揭示评测盲区:大模型裁判(LLM-as-a-Judge)严重倾向冗长回复,Anthropic 回答平均较竞品长 4~6 倍
  • 在原始 HealthBench 中 Claude Opus 5.5 凭字数优势以 71.4% 暂列第一(Sonnet 70.8%, GPT-6 Astra 69.7%)
  • 在去除字数偏见的 MLCR-AA 权威修正榜中,GPT-6 Astra 与 Sonnet 5.5 并列榜首,Opus 5.5 真实位次直降至第 6
阅读全文

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

10 月 21 日,Baseten 旗下研究团队 Base Labs 发布开源决策模型 mammoth-1(27B)与 elephant-1(9B),基于 Qwen3.5 全量微调,不生成文本,一次前向传播即返回每个选项的概率,适合分流、分类、打分和路由。官方口径下 mammoth-1 以 71.24 分登顶 Jev Decision Index 0.4,elephant-1 在 Artificial Analysis Decision Index 上并列第一。权重已上 Hugging Face,Baseten API 免费开放至 10 月 27 日。

Baseten 开源两款决策模型 mammoth-1(27B)与 elephant-1(9B):不生成文本直接输出选项概率,Jev 决策榜第一

核心要点速览

  • 跑分(官方口径):mammoth-1 在 Jev Decision Index 0.4 得 71.24 分,208 个决策模型中排名第一;AA Decision Index 65.9
  • elephant-1(9B):Jev 62.6 分、9B 级第一;AA Decision Index 65.2,与 d1-ultra 并列第一
  • 训练:基于 Qwen3.5-27B / 9B 全量微调,621 万条决策样本,含弃答与安全数据
  • 机制:块状双向注意力 + 共享前缀缓存,一次前向返回多问题概率;官方称比推理模型最高快约 10 倍
  • 上手:Hugging Face 权重(MIT),Baseten API 免费至 10/27 23:59 PT,默认零数据保留
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mammoth 1⚡ Elephant 1⚡ Qwen3.5-27B⚡ Qwen3.5-9B🌐 Baseten🌐 Base Labs

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:

Krea 3 图像编辑模型登上三大榜单:Ultra 在 Arena 多图编辑排第 4,仅次于 OpenAI 三款模型

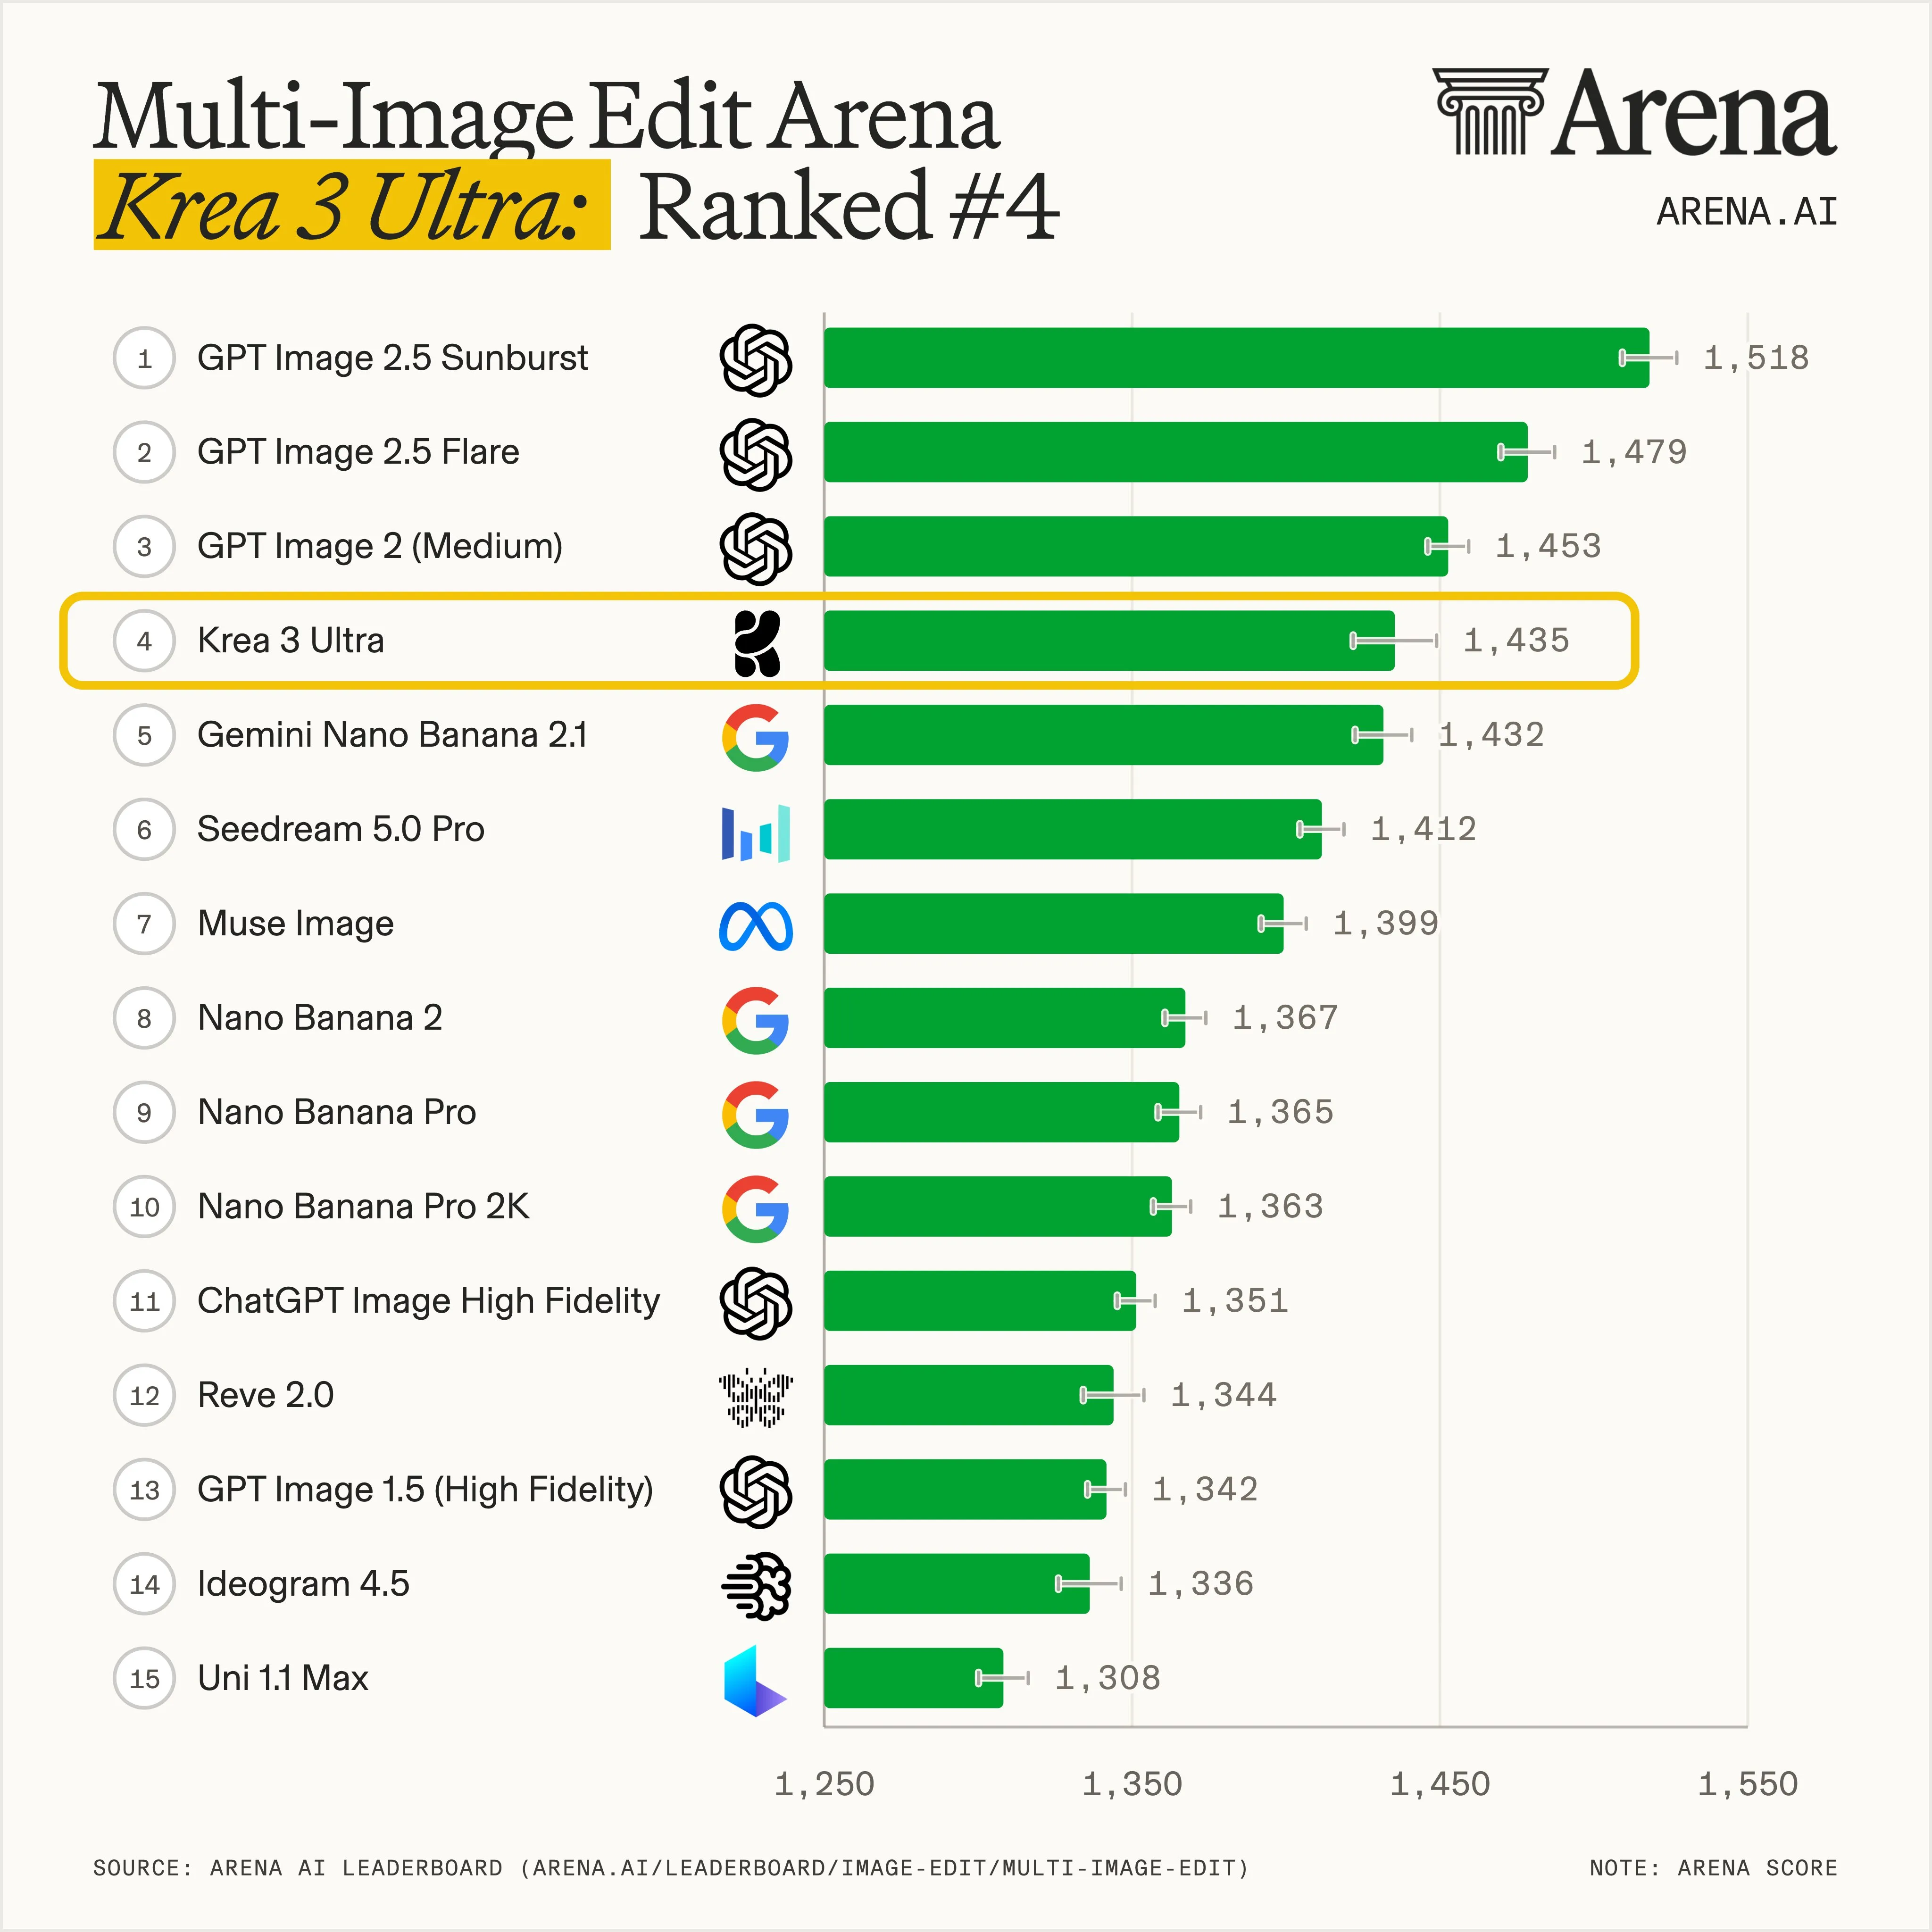
10 月 20 日,Krea 宣布其 10 月 15 日发布的图像编辑模型 Krea 3 进入多个第三方榜单。Arena 多图编辑榜上 Krea 3 Ultra 以 1435±11 分排第 4(初步结果,2,991 票),前三名均为 OpenAI 模型;单图编辑榜排第 8。Artificial Analysis 图像编辑榜上 Ultra 为 1151 Elo、排第 5,Fast 版 1125 Elo 排第 11。Krea 3 主打 2K 原生编辑、多数 8 秒内返回、每张 0.06 美元。

Krea 3 图像编辑模型登上三大榜单:Ultra 在 Arena 多图编辑排第 4,仅次于 OpenAI 三款模型

核心要点速览

  • Arena 多图编辑:Krea 3 Ultra 第 4,1435±11 分,2,991 票,标注为初步结果;前 3 名是 GPT-Image-2.5 两个变体和 GPT-Image-2
  • Arena 单图编辑:Krea 3 Ultra 第 8,1411±11 分,2,619 票
  • Artificial Analysis 图像编辑 v2.1:Ultra 1151 Elo 第 5(与 Nano Banana 2.1、MAI-Image-2.6 统计上并列第 3),Fast 1125 Elo 第 11
  • Design Arena 图像编辑:51 个模型中排第 4,1298 Elo
  • 官方口径:多数编辑 8 秒内完成,原生 2K,每张 0.06 美元,最多 6 张参考图
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Krea 3 Ultra⚡ Krea 3 Fast⚡ GPT-Image-2.5⚡ Nano Banana 2.1⚡ MAI-Image-2.6🌐 Krea🌐 Arena🌐 Artificial Analysis