AI 编程实时动态与要闻

CellType 发布 BioSimBench:前沿大模型预测细胞对药物反应只对一部分,Gemini 4 Argon 居首,自训 27B 模型四项全胜

YC W26 公司 CellType 11 月 4 日发布 BioSimBench 1.0,用真实实验室数据测试大模型能否预测细胞在药物、基因敲低和免疫信号作用后哪些基因上调或下调。12 个前沿模型中,Gemini 4 Argon 以总分 0.184 排第一,Claude Sonnet 5.5(0.160)和 GPT-6 Astra(0.159)随后,而两次实验室重复之间的一致度为 0.462。CellType 用自家 RL 环境 BioSimGym 训练的 27B 模型在四个预测赛道都超过最强前沿模型。
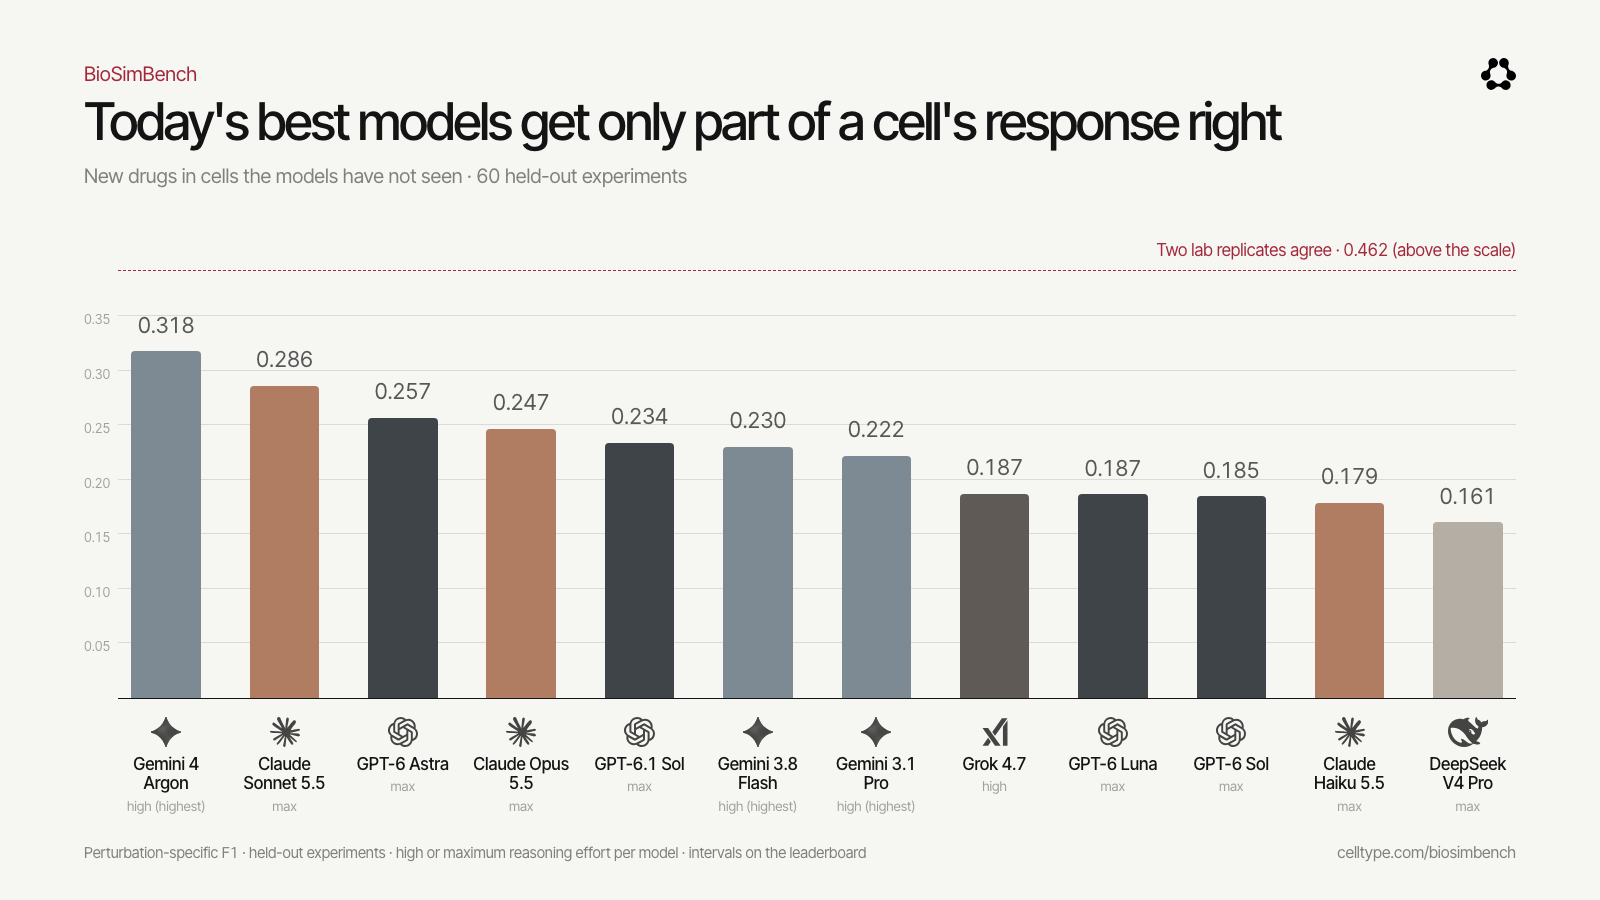
CellType 发布 BioSimBench:前沿大模型预测细胞对药物反应只对一部分,Gemini 4 Argon 居首,自训 27B 模型四项全胜

核心要点速览

  • BioSimBench 1.0 有五个赛道:新药与新细胞、基因敲低、药物反应、免疫信号,以及带工具的研究型 Agent,测试答案不公开。
  • 12 个前沿模型总分在 0.110 到 0.184 之间,Gemini 4 Argon 第一,DeepSeek V4 Pro 最低;两次实验室重复的一致度为 0.462,差距仍大。
  • CellType 27B 在新药与新细胞赛道得 0.366,药物反应赛道 0.203,约为最强前沿模型 0.103 的两倍。
  • 数据处理用 NVIDIA RAPIDS-singlecell,整条流程至少快 4 倍;模型用 NeMo RL 训练,BioSimGym 遵循 NeMo RL 环境接口。
阅读全文

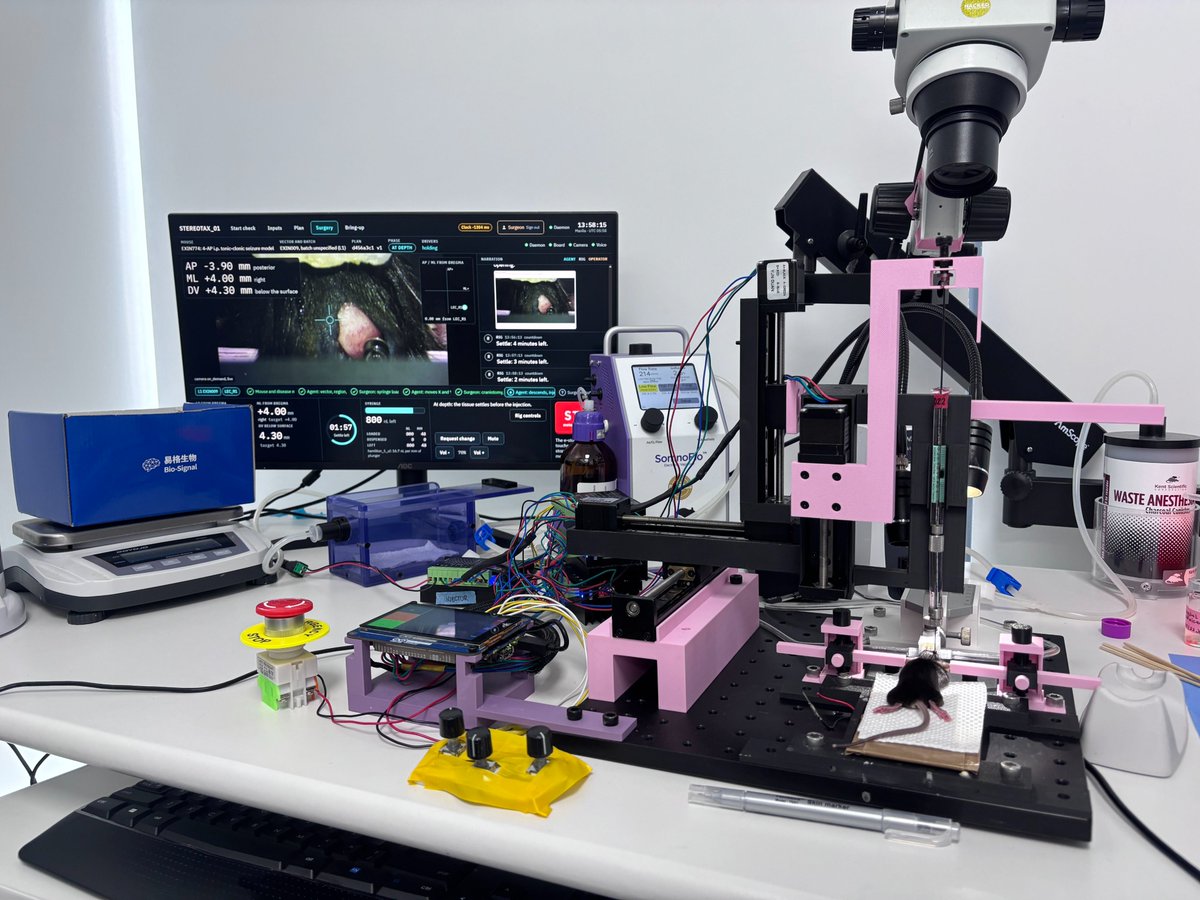
Exin Therapeutics:Claude Sonnet 5 智能体自选基因疗法并操控机械臂完成小鼠脑注射,Opus 5.5 拒绝执行

生物科技初创公司 Exin Therapeutics 联合创始人兼 CEO Gabriel Ocana-Santero 10 月 28 日在 X 上披露:一个 AI 智能体从 19 种基因治疗载体中选药、选脑区、从 3 篇论文推导坐标,并驱动立体定位机械臂向癫痫模型小鼠脑内注射 250 纳升。WIRED 报道称团队先试 Claude Opus 5.5 被拒,改用 Sonnet 5 完成;兽医把关每个不可逆步骤,结果尚未经同行评审。

Exin Therapeutics:Claude Sonnet 5 智能体自选基因疗法并操控机械臂完成小鼠脑注射,Opus 5.5 拒绝执行

核心要点速览

  • 智能体从 19 种基因治疗载体中自选药物、脑区,并从 3 篇论文推导注射坐标(CEO 自述)
  • 实际注射量 250 纳升,术中通过摄像头监看出血;据 The Decoder 转述共做了 32 次观察
  • 据 WIRED:Claude Opus 5.5 拒绝下针,改用 Sonnet 5 完成;手术略超 1 小时(常规约 45 分钟)
  • 设备坐标出错后智能体拒绝绕过安全限制,团队需另行改代码;开颅仍由兽医完成
  • 原帖 9,426 赞、160 万+次浏览;疗效(癫痫发作是否减少)尚待观察,未经同行评审
阅读全文

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

Artificial Analysis 发布权威医疗基准 HealthBench 与 MLCR-AA:首曝长回复偏差(Verbosity Bias)对模型排名的严重失真

国际权威模型独立评测机构 Artificial Analysis 正式发布针对医疗专业领域的权威评测基准 HealthBench Professional 与消除长度偏差的全新指数 MLCR-AA。评测揭示了一个震撼业界的普遍现象:传统基于 LLM-as-a-Judge 的评估机制存在严重的“长回复字数偏好(Verbosity Bias)”——模型回答越长越容易被判定为优秀。在原始 HealthBench 中,Anthropic 模型的回答平均比竞品长 4 到 6 倍,Claude Opus 5.5 以 71.4% 斩获第一;然而在通过长度归一化严密矫正的 MLCR-AA 榜单中,GPT-6 Astra(Max)与 Claude Sonnet 5.5 并列全球第一,而 Claude Opus 5.5 的真实排名则直接从第 1 位暴跌至第 6 位,为全球大模型评测的公正性敲响了警钟。

Artificial Analysis 发布权威医疗基准 HealthBench 与 MLCR-AA:首曝长回复偏差(Verbosity Bias)对模型排名的严重失真

核心要点速览

  • Artificial Analysis 发布 HealthBench Professional 与长度校准评测集 MLCR-AA
  • 深度揭示评测盲区:大模型裁判(LLM-as-a-Judge)严重倾向冗长回复,Anthropic 回答平均较竞品长 4~6 倍
  • 在原始 HealthBench 中 Claude Opus 5.5 凭字数优势以 71.4% 暂列第一(Sonnet 70.8%, GPT-6 Astra 69.7%)
  • 在去除字数偏见的 MLCR-AA 权威修正榜中,GPT-6 Astra 与 Sonnet 5.5 并列榜首,Opus 5.5 真实位次直降至第 6
阅读全文
AD赞助内容

Artificial Analysis 发布 HealthBench 医疗对话基准:长文本惩罚重塑排名,GPT-6 Astra 斩获专业榜第一

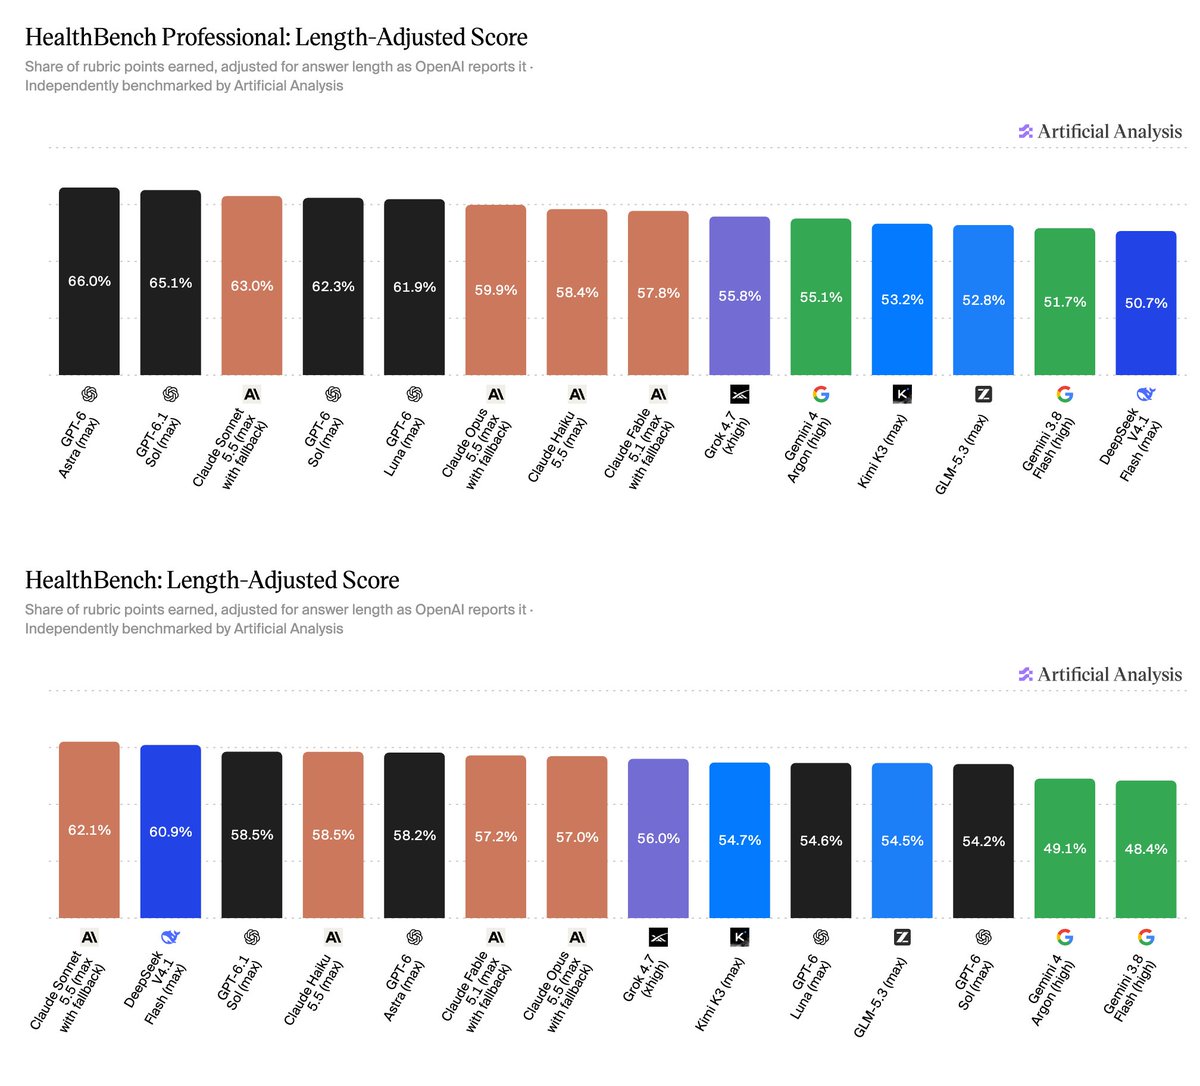
权威独立 AI 测评机构 Artificial Analysis 联合医疗领域研究者发布 HealthBench 与 HealthBench Professional 医疗长对话与临床推理基准榜单。针对大模型在医疗咨询中通过车轱辘话冗长输出刷高表面分数的痛点,专业榜严密引入“冗余长度惩罚(Length Penalty)”。实测显示 GPT-6 Astra(最高算力模式)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,而原始得分高达 71.4% 的 Claude Opus 5.5 因平均输出近 6000 字符严重被扣分至 59.9%。

Artificial Analysis 发布 HealthBench 医疗对话基准:长文本惩罚重塑排名,GPT-6 Astra 斩获专业榜第一

核心要点速览

  • Artificial Analysis 推出医疗长对话基准 HealthBench,专业榜严厉引入冗余长度惩罚(Length Penalty)重塑大模型排名
  • GPT-6 Astra(最高算力)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,Claude Sonnet 5.5 以 63.0% 位列第三
  • Claude Opus 5.5 原始未惩罚分数高达 71.4%,但因单次回答平均长达近 6,000 字符严重被扣分至 59.9% 跌落至第 6 名
  • 标准榜中 DeepSeek V4.1 Flash 以 60.9% 斩获第二名,证实国产轻量级模型在医疗问诊领域的卓越泛化能力
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

独立评测机构 Artificial Analysis 10 月 19 日上线两张医疗对话榜单,评测基于 OpenAI 的 HealthBench(5000 段真实健康对话)和 HealthBench Professional(525 段临床医生对话),由医生编写的评分细则打分,同时公布原始分和 OpenAI 采用的长度调整分。Professional 榜上 GPT-6 Astra(max)长度调整分 66.0% 第一,GPT-6.1 Sol 65.1%,Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分最高(71.4%),但平均约 5900 字符的回答被扣分后跌到第六(59.9%)。HealthBench 榜上 Claude Sonnet 5.5 以 62.1% 第一,DeepSeek V4.1 Flash 60.9% 紧随其后,单任务成本约为前者的 1/16。

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

核心要点速览

  • HealthBench Professional(长度调整分):GPT-6 Astra(max)66.0%、GPT-6.1 Sol(max)65.1%、Claude Sonnet 5.5 63.0%。
  • Claude Opus 5.5 原始分 71.4% 全场最高,但平均回答约 5900 字符(阈值 2000 的近 3 倍),调整后掉到 59.9%、排第六;Claude Fable 5.1 同样被扣超过 11 分。
  • Professional 榜的分数-成本帕累托前沿全是 OpenAI 模型:GPT-6 Luna(max)61.9%、每任务 0.004 美元,不到 GPT-6 Astra(0.27 美元)成本的 2%。
  • HealthBench 榜:Claude Sonnet 5.5 62.1% 第一,DeepSeek V4.1 Flash 60.9%(每任务 0.005 美元),GPT-6.1 Sol 58.5%。
  • 评分沿用 OpenAI 原实现:Professional 由 GPT-5.4(low)判分,HealthBench 由 GPT-4.1 判分。
阅读全文

Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

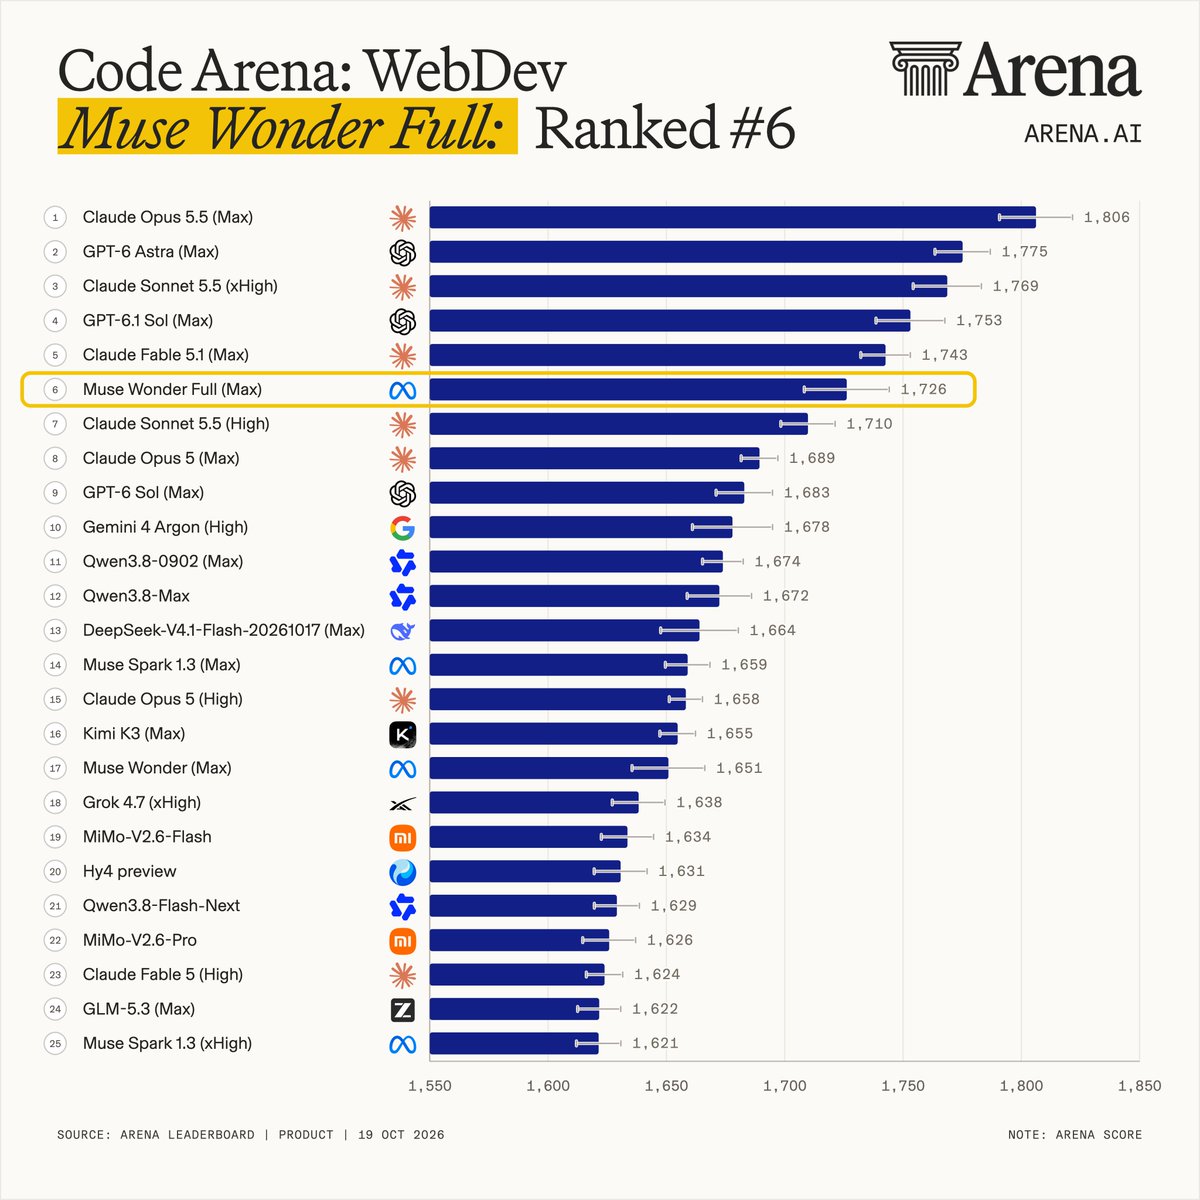
Meta 官方正式披露其位于俄亥俄州新奥尔巴尼的吉瓦级(Gigawatt-Scale)AI 超算中心 Prometheus,拥有数十万张顶尖 GPU,在预训练中实现超 85% 的有效算力率(Goodput),在强化学习(RL)中达到 90% 以上。在此超级算力加持下,Meta 新一代代码与视觉旗舰模型 Muse Wonder Full 在 LMSYS Code Arena: WebDev 中斩获 1726 分跃居全球第 6 名(超越 Claude Sonnet 5.5 与 Gemini 4 Argon),推动 Meta 晋升全球前三大模型实验室。

Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

核心要点速览

  • Meta 披露位于俄亥俄州新奥尔巴尼的 Prometheus 吉瓦级超算集群,拥有数十万张 GPU 并实现 85%+ 预训练有效算力率
  • 强化学习有效算力率达 90%+,在 Muse Wonder 训练期间达成约 47,000 GPU·小时连续无故障运行
  • Muse Wonder Full 在 LMSYS Code Arena: WebDev 斩获 1726 分位列全球第 6,超越 Claude Sonnet 5.5(+16 分)与 Gemini 4 Argon(+48 分)
  • 推动 Meta 跃居全球第 3 大 AI 实验室,并同步推出可在单张消费级 GPU 上 4-bit 本地运行的 Muse Glimmer 30B
阅读全文
关联模型 / 智能体 / 厂商:

GitHub Security Lab 开源 Fuzzing Taskflow:让 Agent 接管 C/C++ 模糊测试全流程,从写 Harness 到出漏洞报告

GitHub Security Lab 基于自家 Taskflow Agent 框架推出 Fuzzing Taskflow(MIT 开源):输入一个 GitHub owner/repo,Agent 自动识别入口函数、分析构建、编写 Harness、运行 AFL++、读覆盖率迭代改进,并对每个去重崩溃生成带根因、可达性和补丁建议的漏洞报告。默认模型为 Claude Sonnet 5,官方提醒须在一次性环境中运行。

GitHub Security Lab 开源 Fuzzing Taskflow:让 Agent 接管 C/C++ 模糊测试全流程,从写 Harness 到出漏洞报告

核心要点速览

  • 一条命令启动:./scripts/fuzzing/run_fuzzing.sh owner/repo,官方推荐直接在 Codespace 里跑
  • 覆盖率迭代预算逐轮翻倍:30s → 60s → … → 960s,单目标约 32 分钟;连续两轮行覆盖增益 < 1% 即判定平台期停止
  • 每个 Harness 双编译:.afl(afl-clang-lto + ASan/UBSan)负责模糊测试,.cov(clang 覆盖率插桩)负责回放出真实行/分支覆盖
  • 崩溃经 afl-tmin 最小化、ASan 回放、栈顶哈希去重,判为 vulnerability / library_hardening / harness_bug / OOM / timeout / assertion_failure / duplicate 七类之一
  • LLM 选择的构建命令直接在宿主机执行、无容器隔离,官方明确要求只在 Codespace 或一次性 VM 中以非特权用户运行
阅读全文

GitHub 开源 ReviewBench:219 个真实 PR 评测 AI 代码审查,Copilot / Devin / Qodo 领跑,Cursor 召回仅 9.6%

GitHub 官方博客 ReviewBench: An open benchmark for AI code review(2026-10-05)发布 AI 代码审查离线基准(research preview)。它从 1.039 亿 个 GitHub PR 的分布中抽样,选出 187 个开源仓库、19 种语言的 219 个 PR,golden set 汇集人类评审、多家前沿 LLM 和静态分析三类来源,由 Claude Sonnet 5 担任评审裁判,资深工程师复核一致率 96.6%。排行榜上 Copilot Code Review Balanced 的 grounded recall 为 26.0%,Devin 23.8%,Qodo 22.1%,Cursor 9.6%。数据集、裁判 prompt 和 runner 以 MIT 协议开源在 GitHub。

GitHub 开源 ReviewBench:219 个真实 PR 评测 AI 代码审查,Copilot / Devin / Qodo 领跑,Cursor 召回仅 9.6%

核心要点速览

  • 规模:219 个 PR,来自 187 个开源仓库、19 种语言,按 1.039 亿个 GitHub PR 的分布抽样,见 官方博客
  • 可信度:资深工程师独立复标所有 golden 真阳性,与基准标签一致率 96.6%;裁判模型为 Claude Sonnet 5
  • 排行榜 grounded recall:Copilot Balanced 26.0%(precision 87.8%)> Devin 23.8% > Qodo 22.1% > Codex GPT-5.6 Sol Ultra 19.9% > Cursor 9.6%
  • 离线与线上一致:多模型集成审查实验中,线上 A/B 结果为 precision +8.0%、recall +13.6%、单次成本 −8.0%;关键评论数离线预测 +227%,线上实测 +262%
  • 提交流程:自带容器镜像和模型 key,先跑 25 PR 测试集,再跑全量 219 PR(3 轮);仓库 review-bench/ReviewBench 为 MIT 协议
阅读全文

无痛升级全能多模态!新加坡国大开源 Omni-IO Skills:声明式图编排七大模态,Claude 与 GPT 输入支持率跃至 100%

随着通用智能体向复杂物理世界与全流程数字化工作流渗透,开发者期望智能体能够无缝处理文本、图像、音频、视频、结构化文档、3D 资产与程序代码等 7 大跨模态资产。然而,直接重新预训练或微调全模态底座模型成本极其高昂且极易损害核心推理能力;而简单外挂零散工具又导致中间资产格式混乱、跨轮次状态修改无法追溯。来自新加坡国立大学(NUS)与 S-Lab 联合团队推出了开源即插即用外壳框架 Omni-IO Skills(arXiv:2609.31847,社区近 300 赞):首创声明式执行图(Declare Execution Graphs)与持久化资产注册表(Asset Registry),打造包含 27 项层次化多模态技能的标准化接口,全方位覆盖 38 项代表性复杂跨模态任务。在权威评测 UniM-90 上,该外壳将 GPT-5.6 Sol 与 Claude Sonnet 5 的全模态输入支持率从原先的 40% 暴力提升至 100%,结构化达标率突破 99.78%,开辟了外壳级多模态能力重组的最高效路径。

无痛升级全能多模态!新加坡国大开源 Omni-IO Skills:声明式图编排七大模态,Claude 与 GPT 输入支持率跃至 100%

核心要点速览

  • 社区狂揽近 300 赞!首创无需改动大模型核心推理权重的外壳级全模态(Omni-Native)即插即用框架
  • 涵盖 27 个层次化 Skills,跨文本/图像/音频/视频/文档/3D/代码 7 大模态深度打通 38 项核心复杂任务
  • 驱动 GPT-5.6 Sol 与 Claude Sonnet 5 全模态输入支持率从约 40% 提升至 100%,语义质量分由 27 暴增至 77+
阅读全文
AD赞助内容

Google Antigravity 模型表正式挂上 Claude Opus/Sonnet 5.5:仅非试用 Pro 与 Ultra;4.6 与 GPT-OSS-120b 将于 11/2 下线

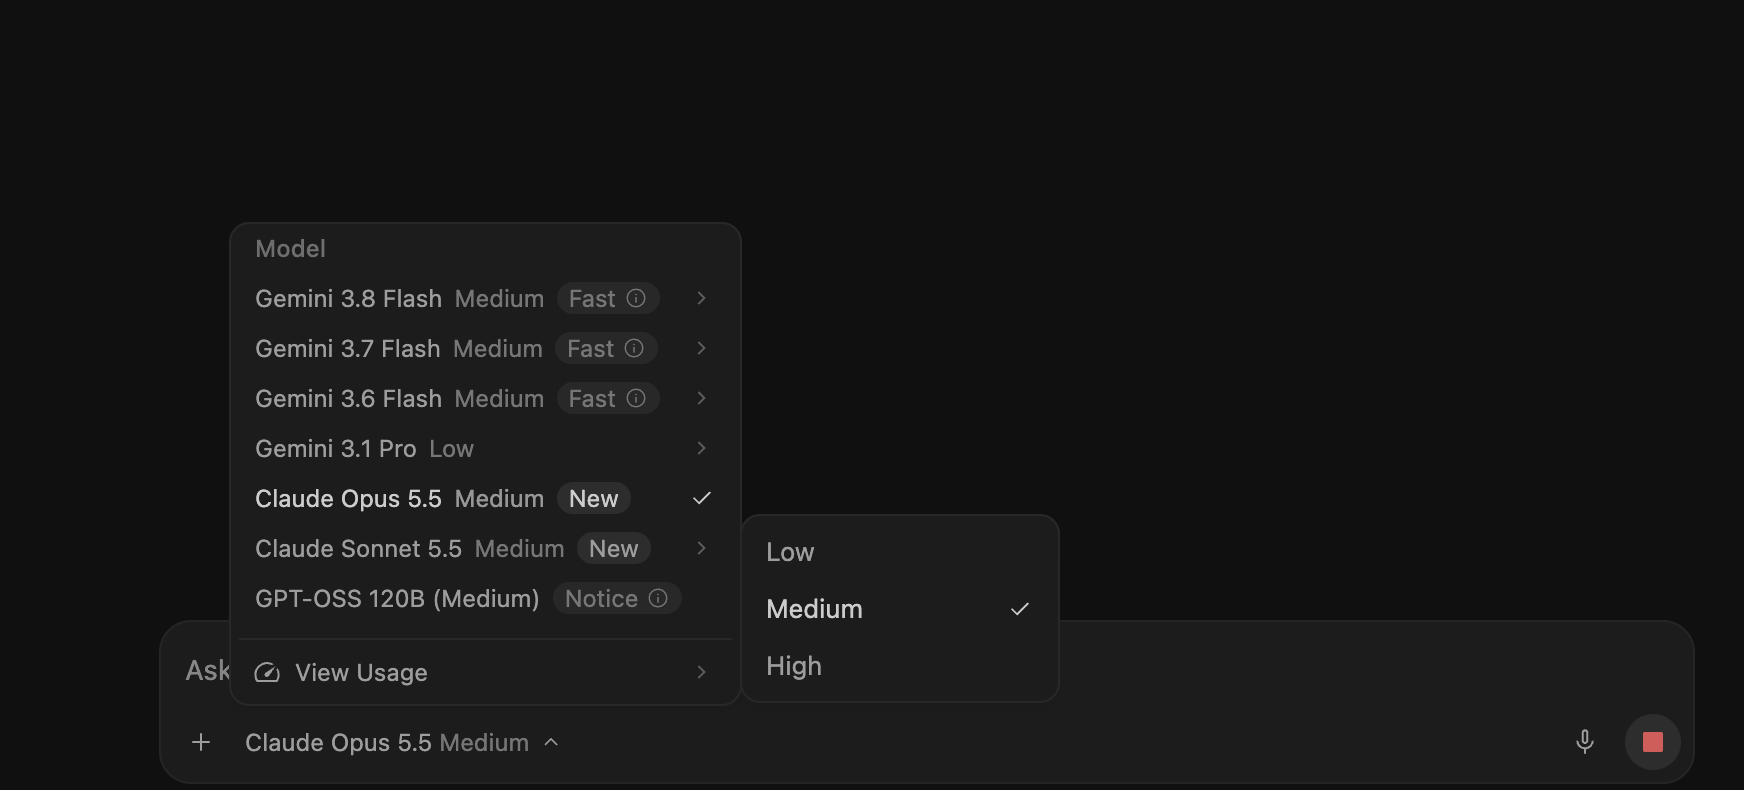
官方 Antigravity Models 表格已列出 Claude Sonnet 5.5 (thinking) 与 Claude Opus 5.5 (thinking):Free / Google AI Plus / Enterprise 为 ❌;Google AI Pro 仅非试用订阅为 ✅,Ultra 为 ✅。同页脚注:Claude Sonnet/Opus 4.6 与 GPT-OSS-120b 将于 2026-11-02 移除。无独立 changelog 公告;以官方文档为准。本篇不臆造 Antigravity 侧 SWE 分数。

Google Antigravity 模型表正式挂上 Claude Opus/Sonnet 5.5:仅非试用 Pro 与 Ultra;4.6 与 GPT-OSS-120b 将于 11/2 下线

核心要点速览

  • 官方源:Models 与 Plans;表内两行 Claude 5.5 (thinking) 已上线
  • 资格:仅 Google AI Ultra 与 非试用 Google AI Pro;Free / Plus / Enterprise / Pro 试用 ❌
  • 下线日历:Claude Sonnet/Opus 4.6 与 GPT-OSS-120b → 2026-11-02 移除(文档脚注 *)
  • 切换时机:对话输入框下模型选择器;Agent 运行中改模型要等本轮结束或取消后才生效
  • 配额:Pro/Ultra 有 5 小时与周限额;超额可用 AI Credits(Never/Always);不支持 BYOK
阅读全文
A
AICoder Editorial@aicoder·
👀80
🔥90

一周内 AI 编程「A vs B」选型热度飙升:Sonnet 5.5、Sol、Argon、Air、Copilot Computer Use 同窗对决

过去约 7 天,Claude Sonnet 5.5、GPT-6.1 Sol、Gemini 4 Argon、JetBrains Air in IDEs EAP、GitHub Copilot Computer Use 同窗落地;开发者检索与 HN 讨论从「单点追新」转向价格带、终端 Agent、IDE 编排与 Computer Use 的成对选型。本稿为元/行业综述,不含 X 推文依赖。

核心要点速览

  • 同窗发布:Sonnet 5.5 入 Copilot(09-28)→ Sol 入 Copilot(09-29)→ Argon Fairwind 预览(09-30)→ Air EAP + Copilot Computer Use(10-01)
  • 高频成对意图:Sonnet↔Opus、Sonnet↔Sol、Argon↔Opus/Astra、Air↔Cursor、Copilot CU↔Claude CU、Codex↔Claude Code、Sol↔Astra(同族升级经济学)
  • 选型轴:价格带(Sol≈Astra 智能力、约 1/5 token 价;Sonnet 日常 vs Opus 复杂判断)× 终端 harness(Codex vs Claude Code)× IDE 编排(Air ACP BYO)× Computer Use(GUI 遗留补位)
  • 合规坑:HN Air 帖讨论 Anthropic 订阅鉴权 ToS;Air 官方称 Claude 订阅可走终端全屏 Tab,聊天面 Claude Agent 仍需 JetBrains AI / API Key
  • Argon 仍非 GA:仅 Fairwind 可信网络防御方 + Google 内部;开发者/企业开放时间表未公布——对比页请标注预览门控
阅读全文

跨越 7 大模态的全能 Agent 运行时!新国大开源 Omni-IO Skills:声明式执行图编排 27 项技能,顶级模型多模态支持率直拉 100%

通用智能体虽具备长程规划与工具调用能力,但在实际工程落地中,其生产力能力依然深度割裂在文本、图像、音频、视频、文档、3D 资产与代码这 7 大异构模态之间。直接微调端到端全模态底座成本极其高昂且极易出现灾难性遗忘,而简单外挂多个专用模型又缺乏跨模态依赖编排、中间产物复用与跨轮次协同能力。新加坡国立大学(NUS)NExT++ 实验室研究团队提出即插即用的全模态智能体底座增强运行时 Omni-IO Skills。该框架构建了层级化技能库、标准化多模态执行接口、依赖感知编排引擎与持久化资产注册表(Asset Registry)。工作流被建模为声明式执行图(Declare Execution Graphs),不仅原生支持无依赖动作并发调度,更能将多步生成的中间产物自动缓存供下游复用。在全新全模态基准 UniM-90 上,该运行时将 GPT-5.6 Sol 与 Claude Sonnet 5 的输入模态支持率从约 40% 直拉至 100%,语义质量综合得分实现近 3 倍爆发式跃升。

跨越 7 大模态的全能 Agent 运行时!新国大开源 Omni-IO Skills:声明式执行图编排 27 项技能,顶级模型多模态支持率直拉 100%

核心要点速览

  • 7 大模态即插即用统一运行时:无需重新训练或微调底座大模型,通过 Harness 级能力编排,无缝打通文本、图像、音频、视频、文档、3D 资产与代码 7 大模态。
  • 声明式执行图与持久资产注册表:以 Declare Execution Graphs 支持无依赖多模态任务并发调度,并通过 Persistent Asset Registry 实现中间多模态生成物跨轮次确定性复用。
  • 顶级商业模型全模态输入支持率直冲 100%:在严苛的 UniM-90 全模态基准上,将 GPT-5.6 Sol 与 Claude Sonnet 5 的输入支持率从不足 40% 彻底拉升至 100%,综合语义质量分暴增近 3 倍。
阅读全文

Pydantic AI 2.52.0:统一 Workspace 跑 Coder/Shell;修 web_fetch HTML DoS;CLAI2 首发

Pydantic AI 于 2026-09-30 发布 v2.52.0(PyPI pydantic-ai==2.52.0):新增 ctx.workspace 统一本地/沙箱文件与命令 API,落地 E2B / Fly.io Sprites / Modal / SSH / Bubblewrap 等后端;pydantic-ai-harness 并入主仓版本跳到 0.52.0;首发 pydantic-clai2(uvx pydantic-clai2)。同步修补本地 web_fetch 对嵌套 HTML 转换的资源耗尽问题(GHSA-v36g-jcw9-x7cw,CVSS 6.5),并支持 Claude Sonnet 5.5 与 GPT-6.1 Sol。

Pydantic AI 2.52.0:统一 Workspace 跑 Coder/Shell;修 web_fetch HTML DoS;CLAI2 首发

核心要点速览

  • 发版:v2.52.0(2026-09-30);相对 v2.51.0...v2.52.0 ahead_by 533 commits
  • 安全:本地 web_fetch HTML→Markdown 嵌套膨胀 DoS 已修(GHSA-v36g-jcw9-x7cw,CVSS 6.5 medium);v1 线补丁 1.107.7;供应商原生抓取不受影响
  • 架构:ctx.workspace 统一 Coder/FileSystem/Shell(#6492);E2B/Sprites/Modal 等沙箱
  • 模型:Claude Sonnet 5.5(#8974);GPT-6.1 Sol(#9305);Anthropic 默认 max_tokens 在 Sonnet 4.5+ 提到 16384(#9025)
  • 开箱:pip install -U 'pydantic-ai==2.52.0';CLI:uvx pydantic-clai2;文档 Workspace / Harness
阅读全文
L
LangChainlangchain-ai·
👀64
🔥94

LangChain Anthropic 1.7.5 / Core 1.6.6:原生兼容 Claude Sonnet 5.5;校验 thinking/tool_choice 与流式元数据

LangChain 于 2026-09-29 发布 langchain-anthropic==1.7.5 与 langchain-core==1.6.6:合并 #40882,为 Claude Sonnet 5.5 加入模型档案与能力发现;拒绝不支持的强制 tool_choice/thinking 组合;支持会话中途更换 system/tool;在流式与 replay 中保留 computer-toolset 命名空间、加密 advisor 块与 refusal 细节。非法 tool call 可按未强制结构化输出回退或显式 method="json_schema"。

LangChain Anthropic 1.7.5 / Core 1.6.6:原生兼容 Claude Sonnet 5.5;校验 thinking/tool_choice 与流式元数据

核心要点速览

阅读全文