AI 编程实时动态与要闻

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

GitHub 10 月 28 日在 Universe 2026 宣布 Copilot Fusion 正式可用(GA)。它把此前研究预览的 Project HydraFusion 多模型编排和 Copilot auto 模型选择合并:用户在模型选择器里选 Copilot Fusion 和努力档位(Standard / High / Max),由系统按任务决定用哪些模型、走 Single、Cascade 还是 Critique 流程。官方称 Fusion Max 在 Artificial Analysis 编码智能体指数得 60 分,比 Claude Code + Opus 5.5 Max 低 2 分,但每任务 API 成本约一半、token 约一半、耗时少约 40%。按所用模型标准价计费,付费用户到 11 月 30 日享 30% 折扣。

GitHub Universe 2026:Copilot Fusion 正式 GA,自动路由与编排多模型,Fusion Max 在 Artificial Analysis 编码智能体指数拿 60 分,成本约为 Claude Code + Opus 5.5 Max 的一半

核心要点速览

  • 跑分(Artificial Analysis 编码智能体指数 v2.0):Fusion Max 60 分,Claude Code + Opus 5.5 Max 62 分;每任务成本 5.59 美元对 11.42 美元,Devin Fusion 组合 62 分、8.00 美元
  • 分项:Terminal-Bench 4.0 得 71 分略领先;FrontierCode 51 分排第三(Claude Code 56、Devin Fusion 54);SWE-Atlas-QnA-AA 57 分偏弱
  • 效率:每任务约 720 万 token,约为 Claude Code + Opus 5.5 的一半,比 Devin Fusion 少 30%;GitHub 称耗时少约 40%
  • 模型池含 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol 等;管理员可单独禁用某模型供 Fusion 使用,并把 Fusion 设为默认
  • 可用范围:所有 Copilot 套餐,VS Code、Copilot app、Copilot CLI 和 JetBrains;原 auto / HydraFusion / HydraFusion Max 设置自动迁移到对应档位
阅读全文

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。

Artificial Analysis 发布 Coding Agent Index v2.0:用 Cognition 的 FrontierCode 替换 DeepSWE,Claude Code + Opus 5.5 以 61.7 分居首

核心要点速览

  • 榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
  • FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
  • 新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
  • 成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
  • SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
阅读全文

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

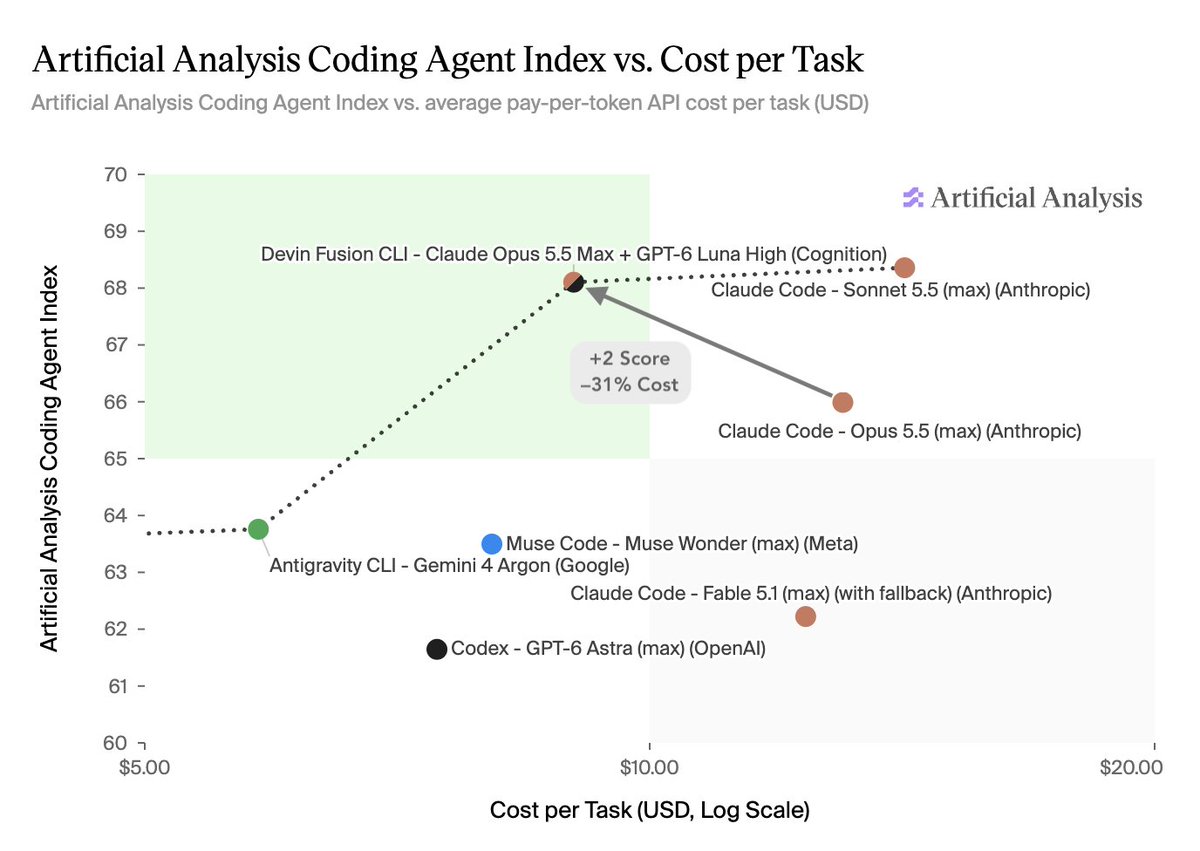
权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

Cognition 10 月 19 日宣布,Devin Fusion 用 Claude Opus 5.5 做主控(lead)、GPT-6 Luna 做执行助手(sidekick)的组合,在 Artificial Analysis Coding Agent Index v1.5 拿到 68.1 分。按 Artificial Analysis 网站当前数据,这一分数位列榜首,但只比第二名 Muse Code + Muse Wonder Full(68.0)高 0.1 分,基本并列;第三名 Antigravity CLI + Gemini 4 Argon 为 63.8。Cognition 称该组合每任务成本比 Claude Code 搭配 Opus 5.5 低 31%(厂商口径)。Fusion 已在 Devin CLI 和桌面版提供。

Devin Fusion 以 Opus 5.5 主控、GPT-6 Luna 执行拿下 Artificial Analysis 编码智能体指数 68.1,官方称每任务成本比 Claude Code + Opus 5.5 低 31%

核心要点速览

  • 总分 68.1:DeepSWE v1.1 72.6、SWE-Atlas-QnA 69.6、Terminal-Bench v4 62.1,三项等权(Artificial Analysis 数据)。
  • 与第二名 Muse Code + Muse Wonder Full(68.0)只差 0.1 分;Antigravity CLI + Gemini 4 Argon 63.8,Codex + GPT-6.1 Sol(xhigh)62.9。
  • 成本:Cognition 称比 Claude Code + Opus 5.5 每任务低 31%(厂商口径)。
  • 此前 Fusion 搭配 Fable 5.1 + SWE-2 在 DeepSWE 1.1 上把单任务成本从 14.63 美元降到 7.88 美元(−46%),得分 64.3→63.1。
  • 官方推荐组合为 Opus 5.5 + GPT-6 Luna,安装 Devin CLI 即可使用。
阅读全文
AD赞助内容

Artificial Analysis:Grok 4.7 + Grok Build Coding Agent Index 56,跻身第四;智能指数 46 进入前四实验室

@ArtificialAnlys 评测 Grok 4.7(xhigh):Intelligence Index 46(较 4.6 +2),SpaceXAI 进入前四实验室;Grok 4.7 + Grok Build 的 Coding Agent Index 为 56(较 4.6 +9),在原生 harness 中排名第四,仅次于 Claude Fable 5.1、GPT-6 Astra 与 Claude Opus 5。定价仍为 $2/$6 per 1M in/out,缓存命中 $0.50,上下文 500k。

Artificial Analysis:Grok 4.7 + Grok Build Coding Agent Index 56,跻身第四;智能指数 46 进入前四实验室

核心要点速览

  • Coding Agent Index:Grok 4.7 + Grok Build 拿下 56 分(+9),原生 harness 中排名第四。
  • Intelligence Index 46(+2),SpaceXAI 进入前四实验室;AA-Briefcase +111 Elo。
  • 定价与 4.6 相同:$2/$6 per 1M,缓存 $0.50;上下文 500k;增益伴随更高 token 用量。
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis:Devin Fusion 首入 Coding Agent Index,Fable 配置得分 62、Astra 配置更便宜更快

Artificial Analysis 独立评测 Devin Fusion:首次将多模型编程智能体纳入 Coding Agent Index。Fable 5.1 (xhigh)+SWE-2 得分 62;GPT-6 Astra (xhigh)+SWE-2 得分 59,成本约低 43%、完成任务约快 31%,同时基本保留前沿表现。

核心要点速览

  • Devin Fusion 成为 Coding Agent Index 首个多模型编程智能体。
  • Fable 5.1+SWE-2 得分 62;Astra+SWE-2 得分 59。
  • Astra 配置约便宜 43%、完成任务约快 31%。
阅读全文

Artificial Analysis:GPT-6 Astra 编码智能体指数追平 Fable 5,单价约为其一半

Artificial Analysis 评测 GPT-6 Astra:Coding Agent Index 在 Codex 上得 67,约等于 Claude Opus 5 / Fable 5(Claude Code)与 Muse Spark 1.3(Muse Code);token 效率相对 GPT-5.6 Sol(max)约提升 70%。API 价升至 $10/$50 per 1M in/out(为 Sol 的 2.5 倍),但单任务成本仍显著低于 Fable 5。Intelligence Index 仍为 61,与 Sol 持平。

核心要点速览

  • Coding Agent Index:Codex 下 67,接近 Opus 5 / Fable 5 / Muse Spark 1.3;Fable 5.1 仍以 70 领先。
  • 相对 GPT-5.6 Sol(max)约省三分之二 token;多种 effort 档位占据 token 效率帕累托前沿。
  • 标价 $10/$50(缓存读仍 90% 折扣),Intelligence Index 61;幻觉率从约 92% 降至约 51%。
阅读全文

Artificial Analysis:Muse Spark 1.3 编码智能体指数 xhigh 达 64、max 预览 68,性价比领先

Artificial Analysis(@ArtificialAnlys)公布 Meta Muse Spark 1.3 在 Coding Agent Index(Muse Code 编排)的成绩:现已开放的 xhigh 变体得分 64(较 1.2 的 62 提升 2 分),单任务约 $1.72,是指数 60 以上智能体中最便宜的;面向合作伙伴的 max 预览变体得分 68,仅次于 Claude Opus 5(xhigh)在 Claude Code 上的 68。Fable 5.1 成绩仍在统计中。

核心要点速览

  • Muse Spark 1.3(xhigh)Coding Agent Index 得分 64(Muse Code),较 1.2 的 62 提升 2 分。
  • 单任务约 $1.72,是指数 60 以上智能体中成本最低;约合 Claude Opus 5(xhigh)在 Claude Code 上 $8.17 的五分之一。
  • 合作伙伴预览的 max 变体得分 68,仅次于 Claude Opus 5(xhigh);Fable 5.1 成绩尚未公布。
阅读全文