AI 编程实时动态与要闻

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文

Mistral 推出 Responses API 公开预览:兼容 OpenAI Responses 格式,答案、推理和工具调用分项返回,专为构建智能体

Mistral AI 10 月 28 日在 X 宣布 Responses API 进入公开预览,定位为在 Mistral 上构建智能体的接口。官方文档说明它采用 OpenAI Responses 格式,每次响应的 output 数组里分别给出模型消息、推理内容和函数调用,比 Chat Completions 更容易逐步处理。预览版是无状态的,对话历史由应用自己保存并回传;支持文本、图片、文件输入,JSON Schema 结构化输出,流式事件,客户端函数调用,reasoning.effort,以及 POST /v1/responses/input_tokens 计数。服务部署在 Mistral AI Cloud Inference 的欧盟和美国区域。同一帖串还宣布在其云上提供 DeepSeek V4.1 Flash(公开预览)和 GLM 5.3 Flash(正式可用)。

核心要点速览

  • Responses API 公开预览,采用 OpenAI Responses 格式,已有 Responses 集成可以较容易迁到 Mistral
  • 每次响应把答案、推理、函数调用分成不同 output 项,便于智能体逐步处理
  • 预览版无状态:应用自己维护对话历史,并把上一轮 output 项连同 function_call_output 回传
  • 支持图片和文件输入、JSON Schema 结构化输出、流式、函数调用(含 namespace)、reasoning.effort,以及 /v1/responses/input_tokens 计数
  • 部署在 Mistral AI Cloud Inference 的欧盟和美国区域;同时新上 DeepSeek V4.1 Flash(预览)和 GLM 5.3 Flash(GA)
阅读全文

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

Cursor 官方 10 月 27 日(SGT)宣布 DeepSeek V4.1 Flash 已在 Cursor 中可用,在 Cursor Settings > Models 打开即可。Cursor 称该模型每一档推理强度都落在 CursorBench 成本前沿上:每任务 $0.60 到 $0.98,在这个价位没有模型得分更高。官方 CursorBench 4.0 榜单显示,DeepSeek V4.1 Flash 1017 Max 档 47.7%($0.98/任务),Medium 46.3%($0.80),High 45.6%($0.77),Low 44.9%($0.60);同榜最高分 Opus 5.5 Max 为 57.8%,但每任务 $13.43。

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

核心要点速览

  • 四档跑分(CursorBench 4.0 官方榜):Max 47.7%/$0.98、Medium 46.3%/$0.80、High 45.6%/$0.77、Low 44.9%/$0.60,Max 档在全榜排第 17
  • 性价比对比:Max 档 47.7% 与 Sonnet 5.5 High(47.8%,$1.20)几乎持平但便宜约 18%;Opus 5.5 Max 高约 10 个百分点,但每任务 $13.43,约是它的 13.7 倍
  • 同价位对手:Haiku 5.5 Max 48.4%/$1.12、Haiku 5.5 Extra High 44.3%/$0.56,DeepSeek 正好卡在两者之间的价格段
  • 代价是 token 和步数:Max 档平均每任务约 53.7 万 token、187 步,Sonnet 5.5 High 只用约 3.7 万 token、41 步,长任务时延要有心理预期
  • 开启方式:Cursor Settings > Models 里打开;有个反直觉细节,Medium 档(46.3%)比 High 档(45.6%)分数略高、价格只贵 $0.03
阅读全文

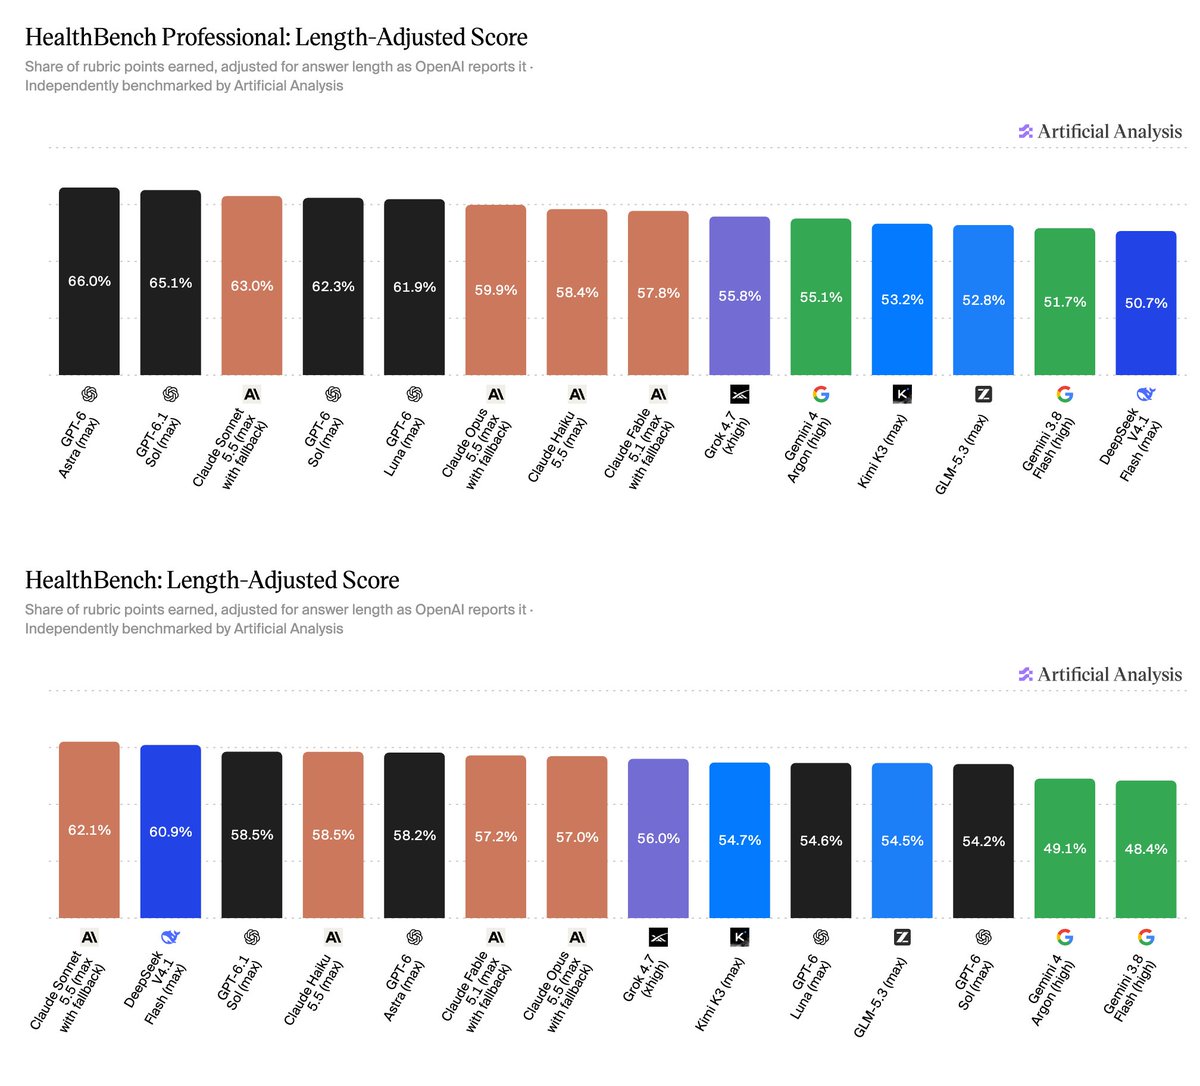
Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

独立评测机构 Artificial Analysis 10 月 19 日上线两张医疗对话榜单,评测基于 OpenAI 的 HealthBench(5000 段真实健康对话)和 HealthBench Professional(525 段临床医生对话),由医生编写的评分细则打分,同时公布原始分和 OpenAI 采用的长度调整分。Professional 榜上 GPT-6 Astra(max)长度调整分 66.0% 第一,GPT-6.1 Sol 65.1%,Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分最高(71.4%),但平均约 5900 字符的回答被扣分后跌到第六(59.9%)。HealthBench 榜上 Claude Sonnet 5.5 以 62.1% 第一,DeepSeek V4.1 Flash 60.9% 紧随其后,单任务成本约为前者的 1/16。

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

核心要点速览

  • HealthBench Professional(长度调整分):GPT-6 Astra(max)66.0%、GPT-6.1 Sol(max)65.1%、Claude Sonnet 5.5 63.0%。
  • Claude Opus 5.5 原始分 71.4% 全场最高,但平均回答约 5900 字符(阈值 2000 的近 3 倍),调整后掉到 59.9%、排第六;Claude Fable 5.1 同样被扣超过 11 分。
  • Professional 榜的分数-成本帕累托前沿全是 OpenAI 模型:GPT-6 Luna(max)61.9%、每任务 0.004 美元,不到 GPT-6 Astra(0.27 美元)成本的 2%。
  • HealthBench 榜:Claude Sonnet 5.5 62.1% 第一,DeepSeek V4.1 Flash 60.9%(每任务 0.005 美元),GPT-6.1 Sol 58.5%。
  • 评分沿用 OpenAI 原实现:Professional 由 GPT-5.4(low)判分,HealthBench 由 GPT-4.1 判分。
阅读全文
AD赞助内容

Freebuff 推出 $8/月 Starter:广告补贴的高用量编码订阅,主打 DeepSeek V4.1 Flash / GLM Flash

@jahooma(Freebuff/Codebuff)宣布 $8/月 Starter:称因内置广告,每日可获约 15 小时 DeepSeek V4.1 Flash 且会话消息不限;官方 plans 页确认 Starter $8/月,可选约 10 小时/日 DeepSeek V4.1 Flash 或约 30 小时/日 GLM 5.3 Flash,并覆盖 Web/Desktop/CLI。

Freebuff 推出 $8/月 Starter:广告补贴的高用量编码订阅,主打 DeepSeek V4.1 Flash / GLM Flash

核心要点速览

  • 创始人宣布 $8/月 Starter:广告补贴、号称每日约 15h DeepSeek V4.1 Flash、消息不限。
  • freebuff.com/plans 现列 Starter $8/月:约 10h/日 DeepSeek V4.1 Flash 或约 30h/日 GLM 5.3 Flash。
  • 订阅贯通 Web / Desktop / CLI,定位低价替代 Claude Code / Cursor / Codex 档位。
阅读全文
关联模型 / 智能体 / 厂商:

Bolt Forge 上线 DeepSeek V4.1 Flash:用量约为 V4 Pro 的 10 倍

boltdotnew 宣布在开源模型周之后继续扩充 Bolt Forge:新增 DeepSeek V4.1 Flash,并称其用量约为 DeepSeek V4 Pro 的 10 倍。官方称 beta 用户反馈该模型更适合做出好看的站点,把更快的开源权重继续推进到前端生成工作流。

核心要点速览

  • DeepSeek V4.1 Flash 已进入 Bolt Forge 模型选择器。
  • 官方称其用量约为 DeepSeek V4 Pro 的约 10 倍。
  • 面向用开源权重做站点/前端生成的 Forge 用户;可经 bolt.new/lite 试用。
阅读全文

OpenRouter:DeepSeek V4.1 Flash 24 小时破 1T tokens,缓存读约占九成、约 $0.006/M

OpenRouter 称 DeepSeek V4.1 Flash 上线后 24 小时处理约 1T tokens,并按当前节奏 48 小时或达约 2.8T,有望成为其付费模型最大首发窗口;其中约 90% 为缓存读取,市场价约 $0.006/M,称比 GLM-5.3 Flash 等可比模型便宜约 5 倍。

核心要点速览

  • V4.1 Flash 在 OpenRouter 24h 约 1T tokens,48h 或冲 2.8T。
  • 约 90% 为缓存读,市场价约 $0.006/M。
  • 称缓存价约为 GLM-5.3 Flash 等可比模型的 1/5。
阅读全文
关联模型 / 智能体 / 厂商: