AI 编程实时动态与要闻

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

2026-10-23(UTC 17:15,SGT 10-24 01:15),Kimi 官方账号 @Kimi_Moonshot 正式发布 Kimi K3.1 Pro,同时推出快 2–3 倍的 K3.1 Pro Highspeed,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,完整权重承诺 2026-11-04 前开放。官方技术博客称它是 K3 的后训练版本(更大规模多领域联合 RL),MoE 总参 2.8T、激活 104B,1M token 上下文,多模态。厂商口径跑分:Terminal-Bench 4.0 65.7%(GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%),BenchCAD 带工具 92.7%。Kimi API 定价页显示 kimi-k3.1-pro 输入 $2、输出 $10、缓存命中 $0.20 每百万 token,低于 K3 的 $3/$15。

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

核心要点速览

  • MoE 总参 2.8T、激活 104B,1M token 上下文,多模态;完整权重承诺 2026-11-04 前开放(官方博客)
  • 厂商口径:Terminal-Bench 4.0 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部 Kimi Code Bench 3.0 长程 61.2%(K3 为 55.95%)
  • API 定价:kimi-k3.1-pro 输入 $2 / 输出 $10 / 缓存命中 $0.20 每百万 token;Highspeed 版 $4 / $20(定价页)
  • 内部幻觉压力测试 Kimi Hallu Bench Hard:声明级幻觉率从 K3 的 23.4% 降到 8.3%(官方注明不代表日常错误率)
  • 开放权重版在中期训练和 RL 阶段移除了网络安全相关数据:xdev-bench-hard pass@3 从未处理版的 90.5% 降到 81.0%
阅读全文
关联模型 / 智能体 / 厂商:

Kimi 官方预告视频露出 Kimi K3.1 型号:Kimi Code 终端显示 K3.1 thinking: high,演示 Three.js 3D 场景生成

2026-10-23(UTC 01:41,SGT 09:41),Kimi 官方账号 @Kimi_Moonshot 发布一段 24 秒、复古 CRT 电脑风格的纯视频帖,没有任何文字。视频开头的 Kimi Code 终端清楚显示「Model: Kimi K3.1」「Version: 2.2.0」,状态栏为「Kimi K3.1 thinking: high」,并提示「Kimi Code Desktop is here」;随后用户输入「Build a complex procedural 3D scene in Three.js.」,模型调用 Write 工具生成 ./scene.js。这是 Kimi K3.1 型号首次由官方素材露出。官方没有文字说明,也没有公布发布日期、跑分、价格或参数,因此它是预告,不等于已发布。

Kimi 官方预告视频露出 Kimi K3.1 型号:Kimi Code 终端显示 K3.1 thinking: high,演示 Three.js 3D 场景生成

核心要点速览

  • 官方预告视频中,Kimi Code 终端显示「Model: Kimi K3.1」,状态栏为「Kimi K3.1 thinking: high」,这是 K3.1 型号首次由官方素材露出
  • 视频同时露出 Kimi Code 2.2.0 版本号,并提示「Kimi Code Desktop is here」,可用 /desktop 命令或访问 kimi.com/code 安装
  • 演示任务是「Build a complex procedural 3D scene in Three.js.」,模型用 Write 工具生成 ./scene.js,全片约 24 秒
  • 官方帖无文字,发布日期、跑分、价格和参数均官方未公布,应视为预告,不是正式发布;截至 SGT 10-23 晚,该帖约 163 万展示、1.75 万点赞(X 公开数据)
阅读全文

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

Arena 官方正式发布 Code Arena: WebDev 最新榜单:深度求索最新推出的 DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分登顶开源模型第一,全面超越 Kimi K3 (Max) 且推理成本降低近 10 倍。该模型位列全榜总榜第 12,超越 Claude Opus 5 (High) 并与顶尖闭源旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分以内,以百万 Token 输入 $0.3 / 输出 $1.2 的极低资费大幅改写 Pareto 前沿。

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

核心要点速览

  • DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分斩获 Arena Code Arena: WebDev 开源模型第一名,超越 Kimi K3 (Max)
  • 位居全榜第 12 名,越级战胜顶尖商业模型 Claude Opus 5 (High),与商业旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分
  • 以百万 Token 输入 $0.3 / 输出 $1.2 的极致费率颠覆性重构 Web 代码生成的 Pareto 效率前沿,成本仅为同等闭源模型的 1/10
  • 相较一个月前的 20260910 版本单月实现 +52 分的性能狂飙
阅读全文
关联模型 / 智能体 / 厂商:

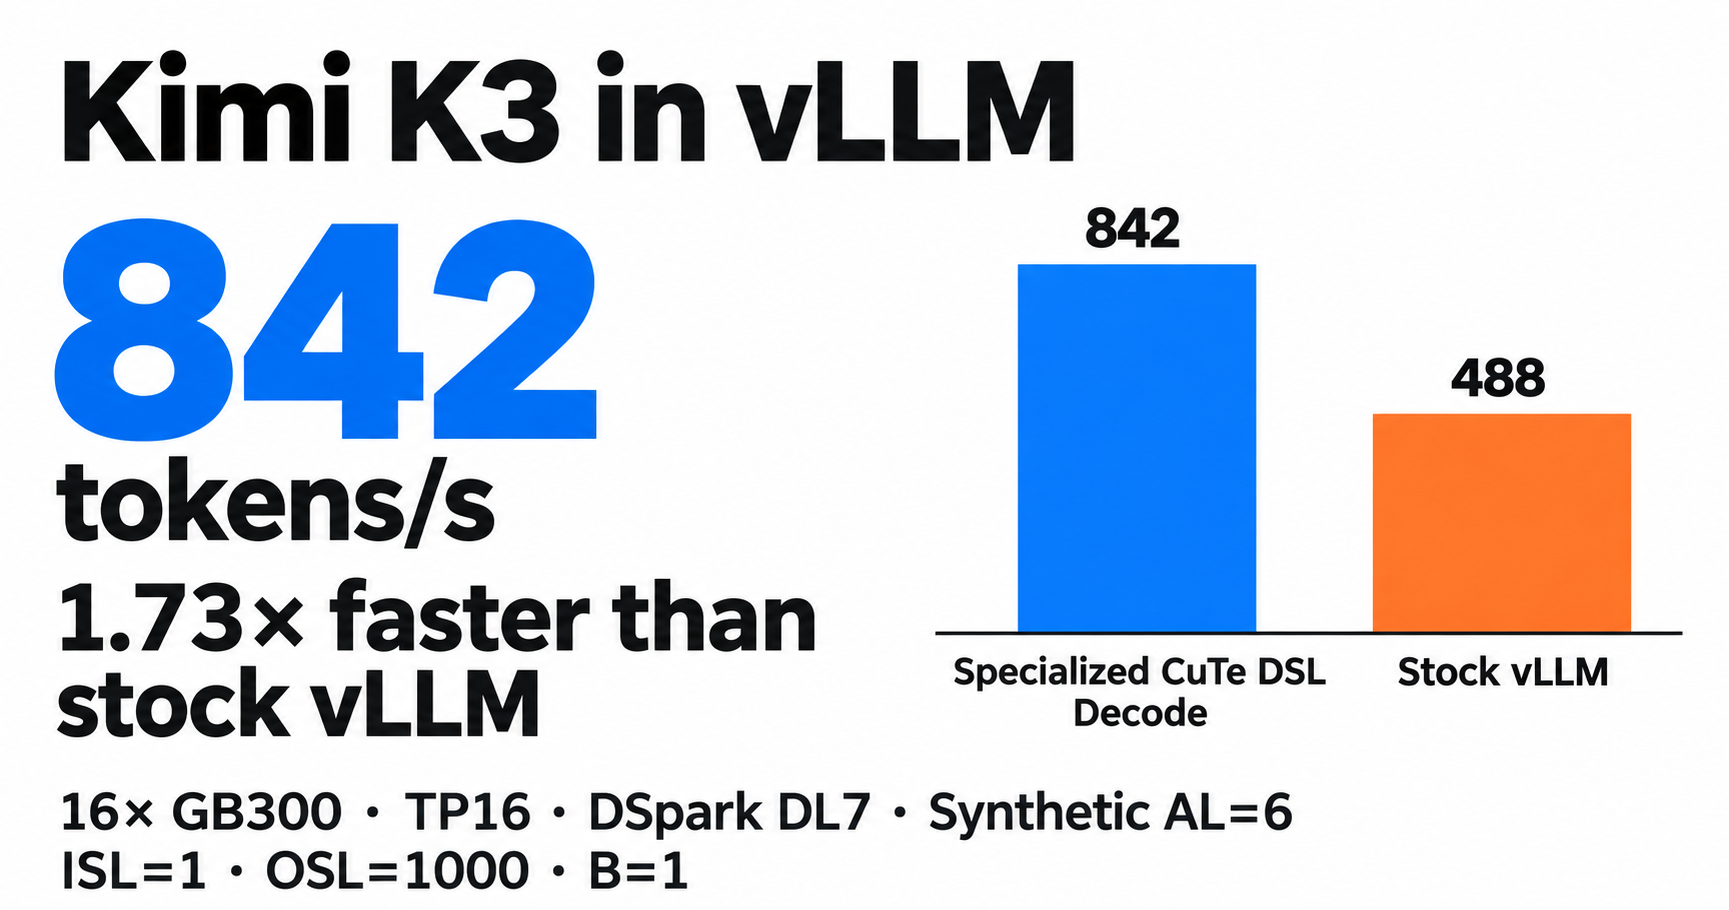
2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

vLLM 联合 NVIDIA 正式发布面向月之暗面旗舰模型 Kimi K3(SemiAnalysis 披露达 2.8 万亿参数)的底层解码巨型内核(Megakernel):由 NVIDIA CentML 工程师采用 CuTe DSL 编写的 1.2 万行代码将注意力、MoE 路由与跨卡通信深度融合,将单层内核启动数从 23 个砍至 13 个、单层耗时从 130 µs 压至 69 µs。在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 的极速输出(提速 1.73 倍),并在 SemiAnalysis AgentX 负载上实现最高 1.8 倍的 P90 单用户交互吞吐提升(突破 403.2~423 tok/s/user),下一步将适配 DeepSeek-V4.1-Flash 与 GLM-5.3。

2.8 万亿参数 Kimi K3 单请求飙至 842 tok/s!NVIDIA 联合 vLLM 开源 1.2 万行 CuTe DSL 巨型融合内核,GB300 NVL72 交互吞吐暴涨 1.8 倍

核心要点速览

  • NVIDIA CentML 联合 vLLM 为 2.8 万亿参数 Kimi K3 打造 1.2 万行 CuTe DSL 解码巨型内核,将单层内核数从 23 个减至 13 个、单层耗时从 130 µs 压至 69 µs
  • 在 16 卡 NVIDIA GB300 NVL72 上配合 DSpark 投机解码实现 Batch=1 高达 842 tok/s 输出(提速 1.73 倍),无投机 Batch=1 达 256.4 tok/s(提速 1.88 倍)
  • 在 SemiAnalysis AgentX 基准上将 P90 单用户交互吞吐提升至最高 403.2~423 tok/s/user(最高 1.8 倍提升),DeepSeek-V4.1-Flash(PR #61868)与 GLM-5.3 支持即将合入
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 联手 NVIDIA 为 Kimi K3 定制 GB300 解码路径:batch 1 达 842 tok/s,无投机解码提速 1.3–1.9 倍

vLLM 官方博客(作者 NVIDIA 的 Benjamin Chislett)披露:借助编码 Agent 辅助开发,团队为 Kimi K3 在 NVIDIA GB300 上重写了一条 CuTe DSL 统一解码路径,把注意力、MoE 与 NVLink 通信融合,单层耗时从 130 微秒/23 个 kernel 降到 69 微秒/13 个。16 卡配合 DSpark 投机解码在 batch 1 达到 842 tok/s,是原版 vLLM 的 1.73 倍;相关 PR #61867 已于 10 月 16 日合入。

vLLM 联手 NVIDIA 为 Kimi K3 定制 GB300 解码路径:batch 1 达 842 tok/s,无投机解码提速 1.3–1.9 倍

核心要点速览

  • 16 卡 GB300 + DSpark(7 个草稿 token、合成接受长度 6)batch 1 解码 842 tok/s,原版 vLLM 为 488,提速 1.73 倍(官方口径)
  • 无投机解码时 TP16 提速 1.62–1.92 倍(batch 64 达 3,606 tok/s),TP8 提速 1.31–1.58 倍
  • 单层 kernel 从 23 个减到 13 个,耗时 130 微秒降至 69 微秒
  • AgentX 编码 Agent 负载下 P90 交互速度 403.2 对 223.7 tok/s/用户(1.8 倍),但对比基线为此前 8 卡结果
  • 同一套「快速通道」方法已扩展到 DeepSeek-V4.1-Flash(PR #61868 待合入),Muse Spark Open 早期结果超 950 tok/s/用户
阅读全文

DigitalOcean 推出 Agent Droplets:Harness + 推理 + 16k 工具一张月费,$50/$200 起

DigitalOcean 于 2026-10-01 为公测中的 Managed Agents 推出 Agent Droplets:Pro $50/月(15% 折扣)与 Team $200/月(20% 折扣),一张账单覆盖微 VM Harness Runtime、托管开源模型推理(含 Kimi K3 / GLM 5.3)、会话存储与 Action Gateway 16,000+ 工具;可接 Claude Code / Codex / OpenCode。另推 Inference and Agents Balance 预付余额。

DigitalOcean 推出 Agent Droplets:Harness + 推理 + 16k 工具一张月费,$50/$200 起

核心要点速览

  • 发版:Agent Droplets 博文(2026-10-01);前置 Managed Agents 公测(2026-09-22)
  • 定价:Pro $50/月 15% 折扣、Team $200/月 20% 折扣;新用户 $5 试用(无需绑卡);无 Agent 数/席位上限
  • 捆绑:微 VM(~1s 启 / ~300ms 恢复)、DO 托管 Kimi K3·GLM 5.3、会话存储、16,000+ 工具;Claude/GPT 等前沿模型另按目录价
  • 续跑:Inference and Agents Balance $5–$500 仅扣 AI 产品;到额可停或按目录价继续,会话可安全暂停留快照
  • 落地:控制台创建 Droplet → 指向 Claude Code/Codex/OpenCode;文档见 Managed Agents;公测不保证生产 SLA
阅读全文

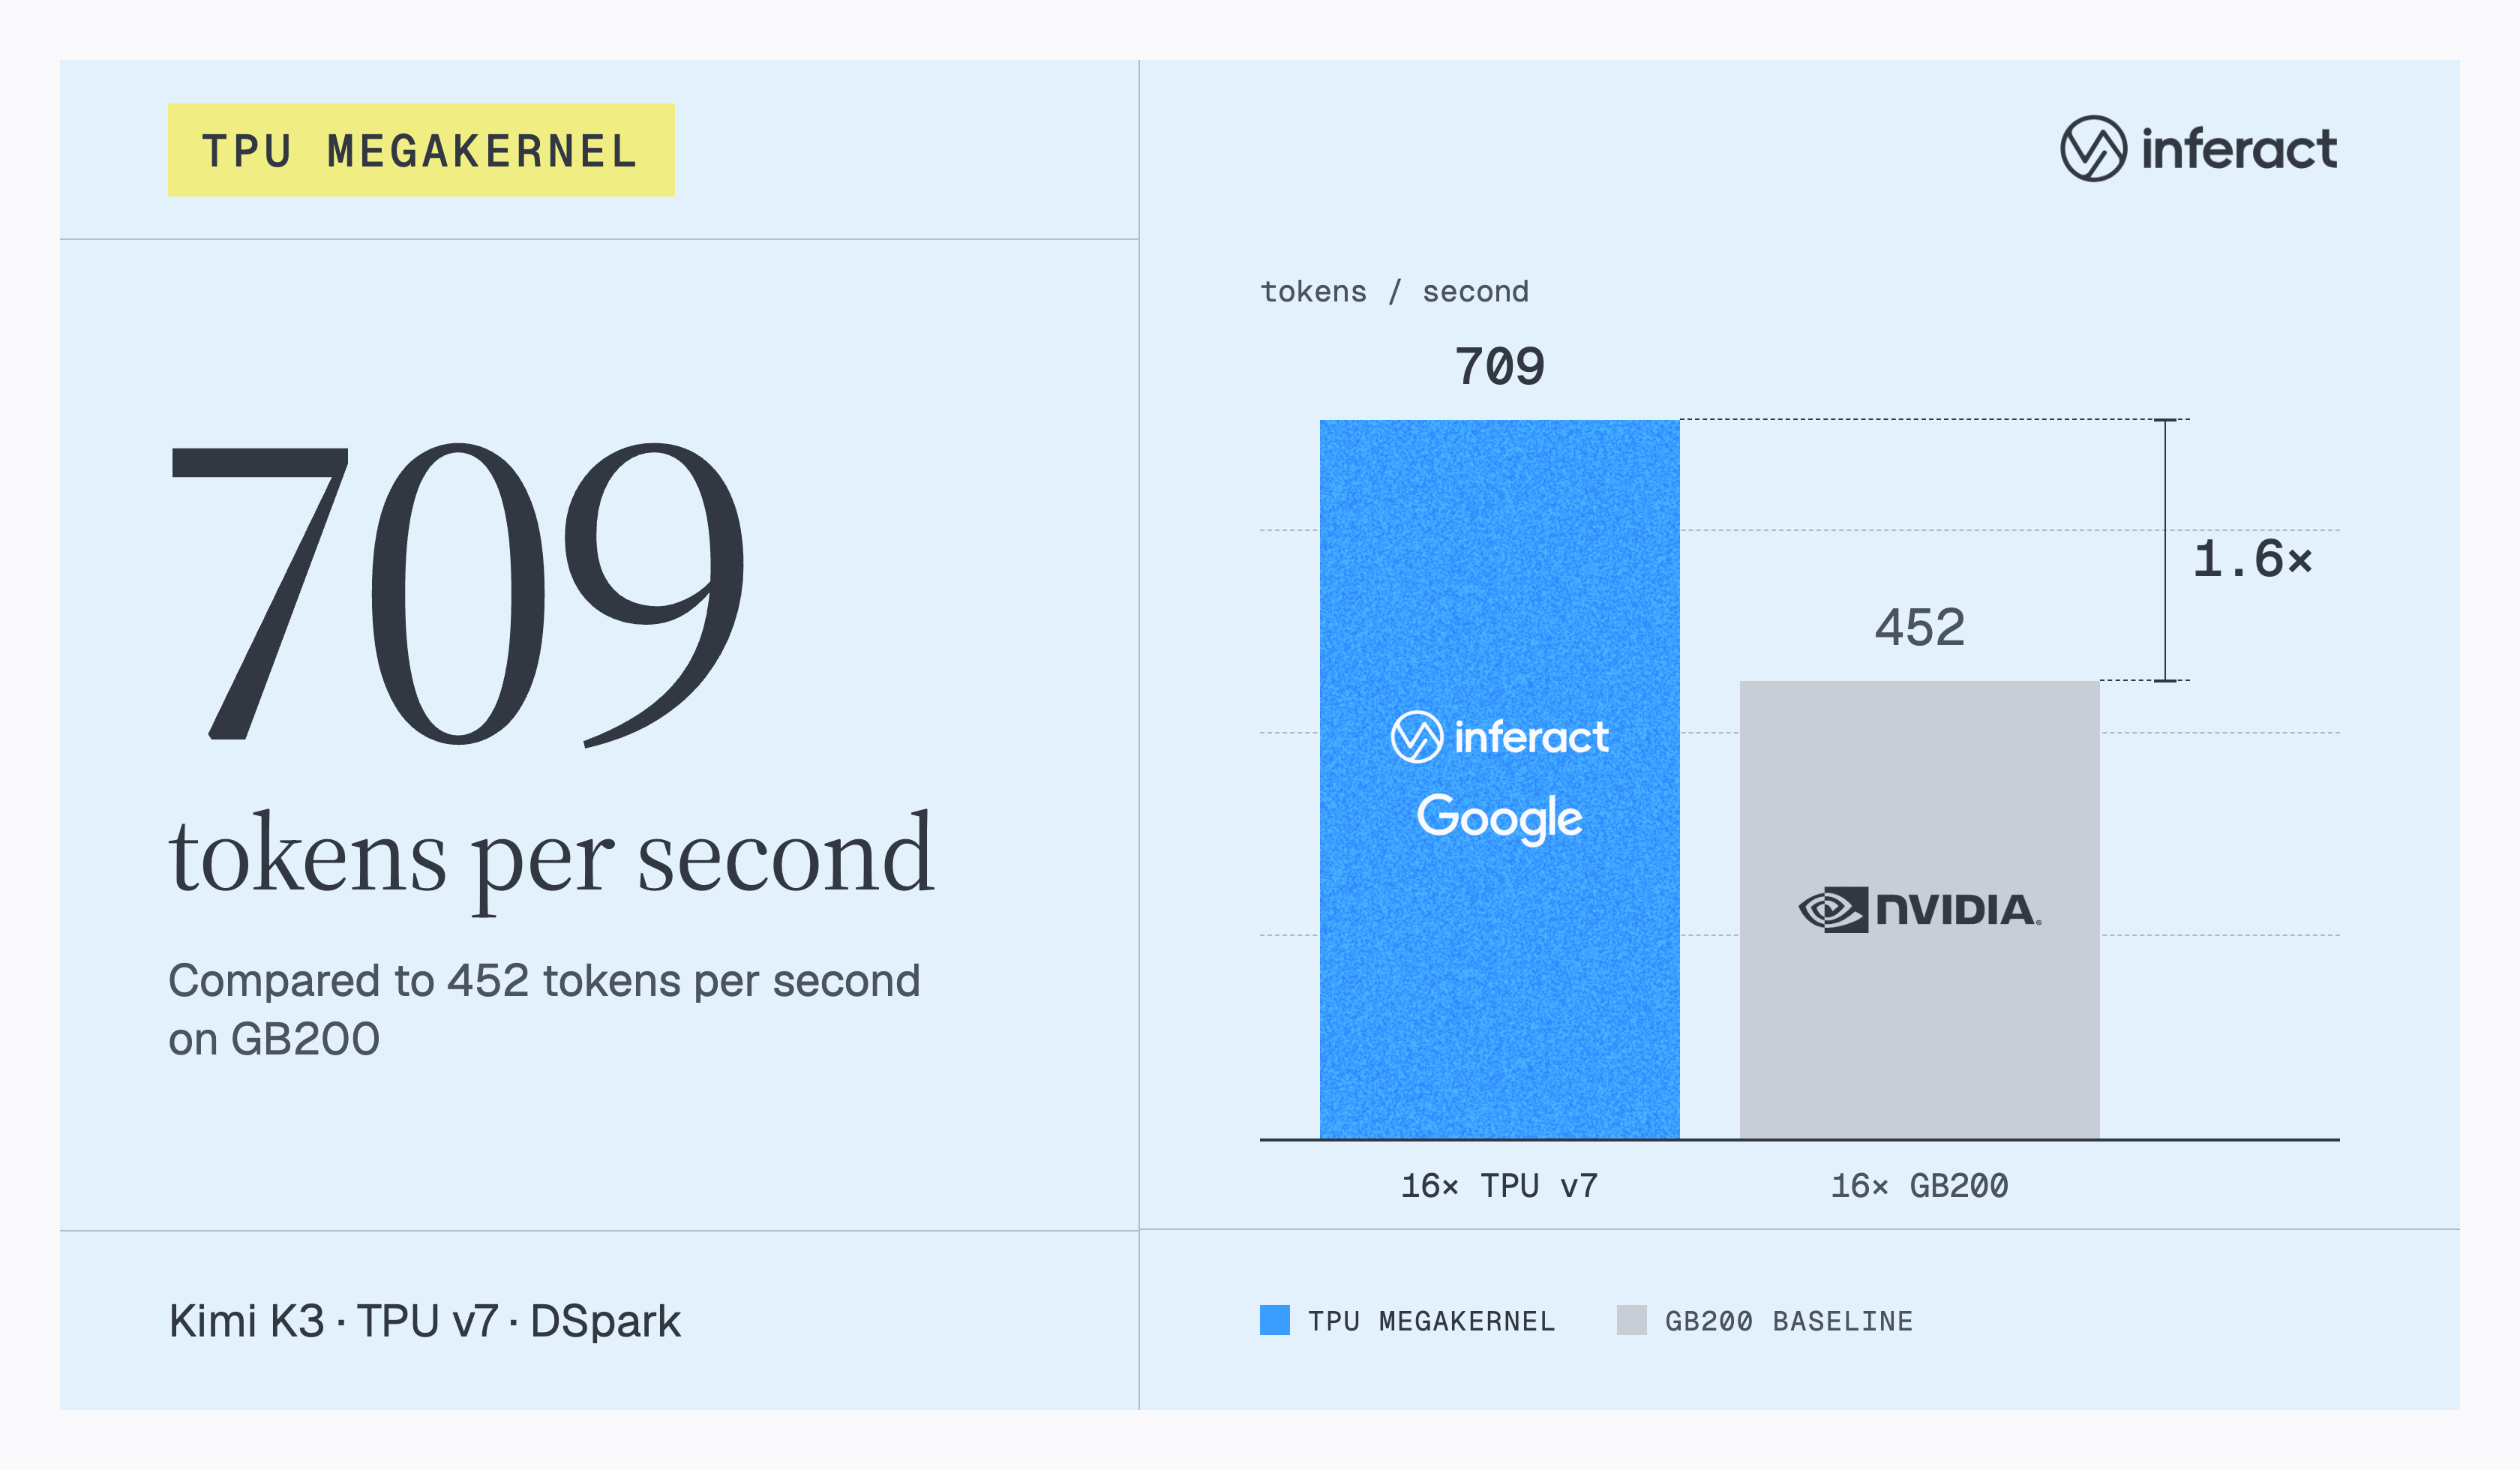
Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

Inferact(vLLM 核心团队衍生公司)于 2026-09-23 发布并开源面向 TPU v7 的推理巨内核仓库 inferact/tpu-megakernels。官方博客显示,在 DSpark 推测解码(acceptance length=6)的低并发设定下,Kimi K3 在 16×TPU v7 Ironwood 上达到 709 tok/s,对照 16×GB200 基线 452 tok/s;关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×。整套 Kimi K3 的 92 层 MoE 解码被收敛进单一 Pallas 内核。

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

核心要点速览

  • 官方数字(Inferact 自测,非第三方复现):Kimi K3 + DSpark 在 16×TPU v7 上 709 tok/s,对照 16×GB200 452 tok/s(acceptance length=6)
  • 关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×;Qwen 3.8 27B 在 4×TPU v7 上报 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)
  • 架构要点:92 层 MoE 装进 单一 Pallas 巨核,跨层 weight prefetch,吃满 TPU 大容量 VMEM
  • 开源仓库:Inferact/tpu-megakernels(Apache-2.0),配套深度文:700 TPS on Kimi K3
阅读全文
关联模型 / 智能体 / 厂商:

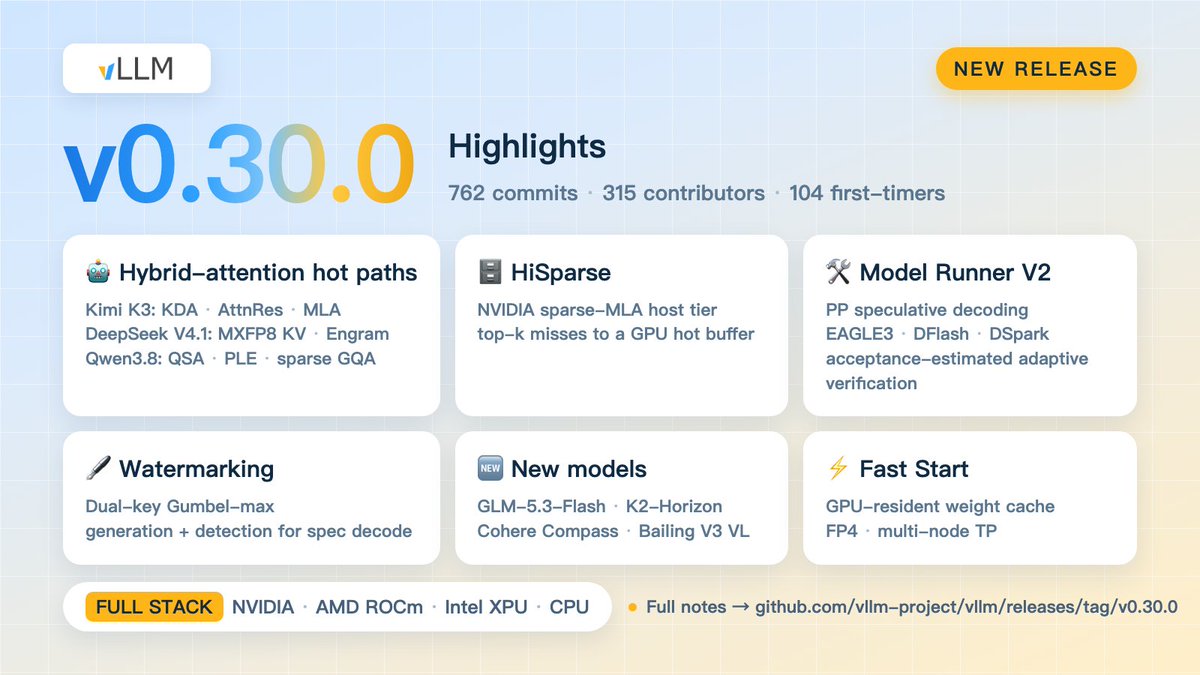
vLLM v0.30.0:762 提交上线,加速 Kimi K3 / DeepSeek-V4.1-Flash / Qwen3.8-Flash-Next

vLLM 项目(@vllm_project)发布 v0.30.0(762 提交、315 贡献者)。亮点包括混合注意力热路径:Kimi K3 精简 KDA/AttnRes/MLA,DeepSeek-V4.1-Flash 加入 MXFP8 KV 与异步 Engram,Qwen3.8-Flash-Next 融合 QSA/PLE 并降低 sparse-GQA 开销;另有 HiSparse 主机层、Model Runner V2 的 EAGLE3 管线并行与自适应校验、双密钥 Gumbel-max 水印,以及 Fast Start(CUDA IPC 权重缓存)与 GLM-5.3-Flash、K2-Horizon、Cohere Compass、Bailing V3 VL 等新模型支持。

vLLM v0.30.0:762 提交上线,加速 Kimi K3 / DeepSeek-V4.1-Flash / Qwen3.8-Flash-Next

核心要点速览

  • 混合注意力热路径覆盖 Kimi K3、DeepSeek-V4.1-Flash、Qwen3.8-Flash-Next 等当前编码常用模型。
  • Model Runner V2 把 EAGLE3 式草稿扩展到流水线并行,并在线估计验收率。
  • Fast Start 用 CUDA IPC 缓存量化分片权重,重启加载更快。
阅读全文
AD赞助内容

Artificial Analysis:StepFun Step 5 Preview Intelligence Index 44,同分约比 Kimi K3 便宜 2.8 倍

@ArtificialAnlys 评测阶跃星辰 Step 5 Preview(600B 总参/27B 激活 MoE):Artificial Analysis Intelligence Index 44,与 Kimi K3 (max) 同分,每任务约 $0.72,约为同分 Kimi K3 的 1/2.8。定价约 $1/$2.70 每百万输入/输出 token,缓存输入 $0.05/M;1M 上下文,计划 10 月 15 日开源权重。智能体评测(GDPval-AA、Terminal-Bench 4.0 等)仍落后同分段对手。

Artificial Analysis:StepFun Step 5 Preview Intelligence Index 44,同分约比 Kimi K3 便宜 2.8 倍

核心要点速览

  • AA Intelligence Index 44,与 Kimi K3 (max) 同分;每任务约 $0.72,约为同分价 1/2.8。
  • 定价约 $1/$2.70 每百万输入/输出 token,缓存输入 $0.05/M;600B/27B MoE,1M 上下文。
  • 计划 10 月 15 日开源权重;GDPval-AA、Terminal-Bench 4.0 等智能体评测仍落后。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Stepfun Step 5 Preview⚡ Kimi K3

月之暗面:Kimi K3 上线 Amazon Bedrock,支持编码与长程智能体工作流及显式 Prompt Caching

@Kimi_Moonshot 宣布 Kimi K3 已登陆 Amazon Bedrock,可用于编码、文档分析与长程智能体工作流,并接入 Bedrock 的访问控制、加密与审计;同时支持显式 Prompt Caching。官方文档指向 AWS Bedrock 模型卡,方便企业在 AWS 栈内直接调用。

月之暗面:Kimi K3 上线 Amazon Bedrock,支持编码与长程智能体工作流及显式 Prompt Caching

核心要点速览

  • Kimi K3 已上线 Amazon Bedrock。
  • 面向编码、文档分析与长程智能体工作流,并带 Bedrock 访问/加密/审计。
  • 支持显式 Prompt Caching;可按 AWS 官方模型卡接入。
阅读全文

Databricks Unity Gateway 登陆 Neon:宣称成 Kimi K3 最快 AI Gateway

Databricks 工程负责人 Yuchen Jin 宣布,正将 Databricks Unity Gateway 开放给 Neon(@neondatabase)上的开发者,并称其为目前面向 Kimi K3 的最快 AI Gateway;帖文同时强调 Databricks 推理侧迭代迅速。对在 Neon 上构建 agent/应用、需要低延迟调用 Moonshot Kimi K3 的团队,这是一条新的托管网关路径。

核心要点速览

  • Unity Gateway 将面向 Neon 开发者开放,官方称其为 Kimi K3 最快 AI Gateway。
  • 面向在 Neon 上跑 agent/应用、需要低延迟调用 Kimi K3 的团队。
  • 来源:@Yuchenj_UW 2026-09-19 推文,同步提及 Databricks 推理加速。
阅读全文

Cline Desktop 限时免费开放 Kimi K3:庆祝新用户涌入并加大探索额度

Cline 宣布在 Cline Desktop 中限时免费提供月之暗面 Kimi K3,用于庆祝新用户增长并给探索者更多 Token。官方表示会尽可能维持开放时长,属于面向开源权重 Desktop 用户的促销额度。

核心要点速览

  • 官方 @cline:Kimi K3 已在 Cline Desktop 限时免费可用。
  • 目的是欢迎新用户并提供更多探索 Token;时长视资源尽量维持。
  • 与 Cline Desktop 开源权重 / ClinePass / BYOK 路线一致,降低试用门槛。
阅读全文

月之暗面 Kimi K3 席卷海外市场,公司估值突破 500 亿美元大关

月之暗面(Moonshot AI)凭借最新一代长程推理模型 Kimi K3 在全球开发者社区的热度飙升,公司估值已突破 500 亿美元大关,成为亚洲估值最高的独立 AI 独角兽企业。多家国际主流顶级主权基金与风投机构积极参与其最新轮次,Kimi 在超长上下文代码重构与科研分析上的留存率创下新高。

核心要点速览

  • Kimi K3 在长程上下文数学计算、跨语言代码重构与深度逻辑链上实现重大飞跃
  • 公司估值突破 500 亿美元,标志着中国独立大模型力量进入全球科技顶级阵营
  • 国际用户与开发者 API 调用量爆发式增长,构建了高粘性的长程智能体生态
阅读全文
关联模型 / 智能体 / 厂商: