AI 编程实时动态与要闻

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商:

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

开源编码智能体 OpenCode 背后的 Anomaly 发布语音输入工具 Hex 3.0 稳定版:按住快捷键说话、松开即粘贴到光标处,语音识别在本机完成,内存占用从约 900MB 降到约 160MB,并新增词汇表、hex 命令行和可选的 OpenCode 改写。

OpenCode 团队发布 Hex 3.0 稳定版:本地语音输入覆盖 Mac、Windows、Linux,可直接口述给编码智能体

核心要点速览

  • Hex v3.0.0 于 10 月 31 日 00:38 UTC 在 GitHub 发布,MIT 协议、Rust 编写,仓库约 1,557 星(发布说明)
  • 官方口径:本地模型内存占用从约 900MB 降到约 160MB;2.3.0 起边说边转写,2 分钟口述松键后约 0.1 秒出字(RTX 5070 Ti)
  • 支持 macOS 15+(Apple 芯片)、Windows x64/ARM64、Linux x64/ARM64,Linux 新增 .deb/.rpm 包
  • 3.0 不自动从 2.3.1 升级,设置、历史和模型需重新下载;语音动作和口令功能被移除
  • @opencode 的发布帖约 2,400 赞、1,600 收藏、10 万+浏览(原帖)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Parakeet⚡ Whisper🤖 OpenCode🤖 Hex🌐 Anomaly

ChatGPT 上线多账号切换:最多同时登录 2 个账号,iOS/Android 逐步推送,桌面端即将支持

10 月 31 日,OpenAI Codex 与 ChatGPT 负责人 Tibo(@thsottiaux)在 X 上发布「28 天连更」第 26 天内容:ChatGPT 移动端可在多个账号之间直接切换,桌面端即将跟进。OpenAI 帮助中心同步更新说明:最多可同时登录 2 个账号,同一时刻只有 1 个处于激活状态;对话、记忆、文件、订阅与账单、工作区彼此隔离,切换不会合并或迁移任何数据。该推文约 1 万点赞、136 万次浏览。

ChatGPT 上线多账号切换:最多同时登录 2 个账号,iOS/Android 逐步推送,桌面端即将支持

核心要点速览

  • 上限:最多同时登录 2 个账号,同一时刻仅 1 个激活;已登满 2 个时需先登出一个才能添加,见 OpenAI 帮助中心
  • 平台:帮助中心称网页版与 iOS/Android 均可用,移动端正在逐步推送(设置 → Switch account);Tibo 称桌面 App 即将支持
  • 隔离:对话、记忆、文件、订阅与账单、工作区互不共享,切换不会迁移聊天或合并账号;新建第二个账号默认是 Free 计划
  • 通知:移动端可同时接收两个账号的通知,点开另一账号的通知会自动切到该账号,粘贴工作内容前应先确认当前账号
  • 热度:Tibo 原帖约 10,120 点赞、136 万次浏览(截至 10-31 12:00 UTC 的 X 公开数据);他还预告接下来两天是「banked」额度重置
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

Stripe 联合创始人 John Collison 的 Cheeky Pint 播客 10 月 29 日上线 Sam Altman 专访。谈到内存短缺时,Altman 说很多人以为开源模型加本地推理就能绕开算力紧张,但从全球配置角度看,让每个人电脑里放着一堆稀缺 DRAM、只有约 5% 的时间在用「相当糟糕」,供给紧张时应追求云端的最大利用率。pubity 转述这段话的帖子获得 2.6 万多点赞、800 多万次浏览,大量用户反驳称 PC 内存并非只为 AI 服务,本地模型还关乎隐私和离线可用。以下按观点讨论整理,不代表已证实结论。

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

核心要点速览

  • 出处:Cheeky Pint 播客 10 月 29 日 Sam Altman 专访,官方文字稿可查,原话含「being used 5% of the time」
  • Altman 的论点:DRAM 供给紧张时,放在个人电脑里的内存利用率低,云端数据中心可持续服务多用户,应追求最大利用率
  • 热度(X API,10 月 31 日 13:06 SGT 读取):pubity 帖 26,124 赞、8,557 条引用、5,210 条回复、约 806 万次浏览
  • 主要反驳:PC 内存还要跑系统、浏览器和游戏;本地模型让数据留在本机;也有人指出这与 OpenAI 的云端商业模式一致
  • 5% 这个数字 Altman 未解释口径,媒体建议当作粗略估计而非测量值
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

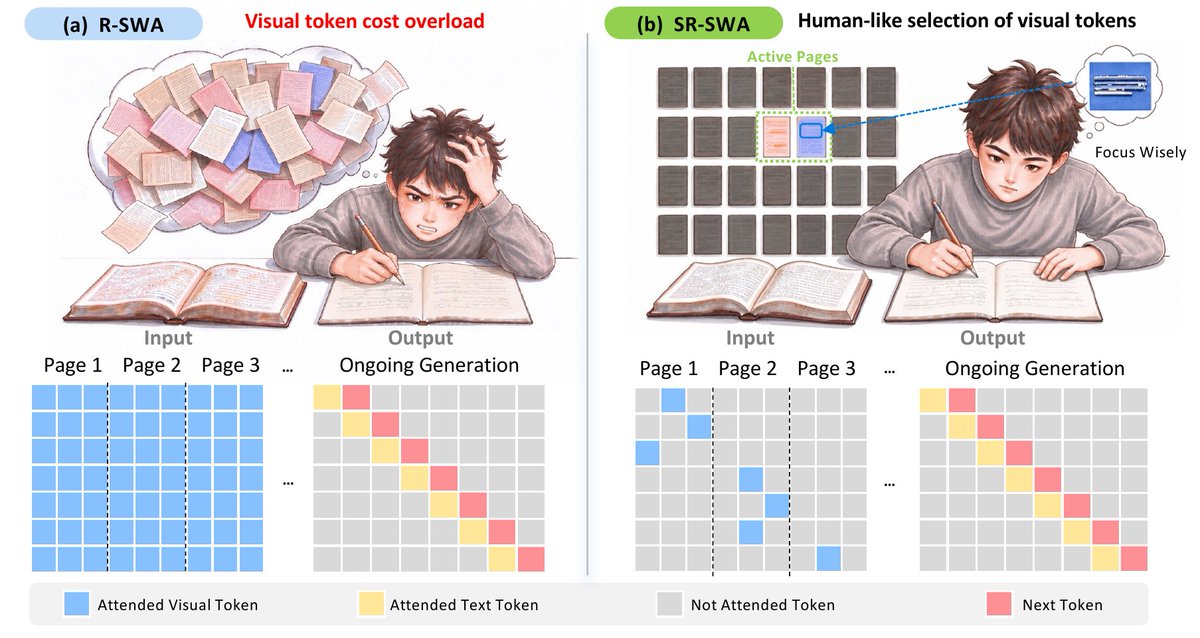
百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

百度官方账号 @Baidu_Inc 10 月 27 日宣布开源 Unlimited OCR 2,以 MIT 协议发布在 Hugging Face。新的 SR-SWA 稀疏参考滑窗注意力把图文注意力压缩到固定大小的参考集合,官方称可在有限上下文内解析任意长度文档,在几十页的 MPDocBench 得 84.6、上百页的 MarathonDocBench 得 77.1,均为厂商自测。

百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

核心要点速览

  • SR-SWA 把超长序列的图文注意力压缩到固定大小的参考集合(如 512 token),官方称每步解码延迟和显存几乎不随页数增长
  • 官方口径:MPDocBench 总分 84.6,比次优的 Qwen3.8-Max(78.3)高 6.3 分
  • 官方口径:MarathonDocBench 总分 77.1,比次优的 Kimi-K3(33.7)高 43.3 分;一代 Unlimited-OCR 在该榜为 0
  • 权重以 MIT 协议发布在 Hugging Face,约 3.3B 参数(按 HF 权重统计),支持 Transformers 和定制版 SGLang 部署
  • 所有跑分均为百度自测,尚无第三方复现
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Unlimited OCR 2⚡ Unlimited-OCR⚡ DeepSeek-OCR🌐 Baidu

前 GitHub CEO Thomas Dohmke 的 Entire 发布面向 Agent 协作的 Git 托管平台:用 Trails 取代 PR,官方称推送比 GitHub 快最多 89 倍

Entire 联合创始人兼 CEO Thomas Dohmke 10 月 26 日在 X 和官方博客宣布 Entire 正式上线,定位是「为 Agent 与人协作打造的 Git 托管平台」。它由三部分组成:用评测分数替代 diff 评审的 Trails、兼容 Git 的分布式托管(可多区域复制,也可从 GitHub 镜像),以及把 Agent 会话存进仓库的 Continuous Memory。CI 首批接入 Buildkite 和 Depot,今天起对所有开发者开放。

前 GitHub CEO Thomas Dohmke 的 Entire 发布面向 Agent 协作的 Git 托管平台:用 Trails 取代 PR,官方称推送比 GitHub 快最多 89 倍

核心要点速览

  • 推送速度(官方/厂商口径,开源基准):每秒推送 Entire 418 次、Cursor Origin 65、Pierre 15、GitLab 10、GitHub 4.7,即比 GitHub 快最多 89 倍、比 Cursor Origin 快 6 倍
  • Trails:每次 push 都由多个评审 Agent 在云沙箱里独立打分(默认有 Security、Slop、Human Review Required 等评测),显示最近 5 次和当前分数,可配置 Gates 要求人工批准和 CI 通过才能合并
  • Continuous Memory:开源、本地优先的 entire-graph 和 entire-brain 两个插件,官方测试中 entire-graph 最多省 71% token
  • 区域:首发支持美国、欧盟、澳大利亚、印度托管,可从 GitHub 镜像并保留 GitHub 为主仓库
  • 价格:博客未公布
阅读全文
关联模型 / 智能体 / 厂商:

Letta 发布 FrontierMemory 1.0:首个按下游任务成绩衡量 Agent 记忆质量的基准,Opus 5.5 与 GLM-5.3 并列 73.3% 居首

10 月 21 日,Letta 发布 FrontierMemory 1.0。它不再考 Agent 记不记得生日、爱好这类事实,而是给 Agent 一批过去的执行轨迹,让它生成记忆或技能,再看这些记忆能让任务 Agent 多解出多少编码和知识工作任务。首版共 15 个任务,改编自 DeepSWE、SkillsBench、APEX-Agents 等公开基准。模型榜(Letta Dream 生成记忆,Letta Code 执行)上 Opus 5.5 与 GLM-5.3 均为 73.3%,Grok 4.7 为 33.3%;Harness 榜上 Letta 自家 Letta Dream 第一。数据为厂商(Letta)口径。

Letta 发布 FrontierMemory 1.0:首个按下游任务成绩衡量 Agent 记忆质量的基准,Opus 5.5 与 GLM-5.3 并列 73.3% 居首

核心要点速览

  • 模型榜(厂商口径,最高推理档):Opus 5.5 73.3%(单任务约 $2.80)、GLM-5.3 73.3%($3.58)、Kimi K3 66.7%、GPT-6.1 Sol 60.0%($0.77,最省)、Gemini 4 Argon 60.0%、Muse Wonder 46.7%、Grok 4.7 33.3%
  • Harness 榜:Letta Dream 73.3%、Prime Agent 60.0%、OpenAI Agents SDK 40.0%、Claude Managed Agents 33.3%、Hermes Agent 26.7%
  • 首版 15 个任务;665 条历史轨迹中只有 219 条与评测任务相关,Agent 需要自己挑出有用经验
  • Letta 称复核时发现保留下来的原始任务中 53% 的判题器有问题并已修复;记忆生成限时 6 小时、禁止联网
  • 记忆分三类:任务约定、用户偏好、环境特性;接受第三方提交模型与 Harness
阅读全文

多智能体世界模型突破:OverSeer 提出辅助流联合预测,破解群体视界盲区与长程一致性

多所顶尖研究机构在 arXiv:2610.28554 中正式发布革命性多智能体世界模型架构 OverSeer。针对现存视频世界模型在扩展至多智能体协同场景时,各 Agent 视界受限(局部可观察性)、传统方案过度依赖外部地图拼接输入,导致多视角画面严重冲突与空间位置漂移的行业痛点,OverSeer 提出“将全局空间辅助流与多智能体第一人称流进行联合预测”的全新机制。在经典开放世界测试环境 Minecraft 的严格基准评测中,OverSeer 在空间定位(Grounding)、长程空间记忆(Memory)与多视角一致性(Consistency)指标上全面超越现有顶级基线,彻底消除了群体智能体在空间盲区下的物理幻觉。

多智能体世界模型突破:OverSeer 提出辅助流联合预测,破解群体视界盲区与长程一致性

核心要点速览

  • 研究团队在 arXiv:2610.28554 中发布 OverSeer 架构,首创面向群体协同交互的多智能体视频世界模型
  • 彻底摒弃依赖外部静态地图输入的落后做法,创新性引入与智能体第一人称流联合端到端预测的辅助空间表征流
  • 在开放世界沙盒 Minecraft 的严密多视角基准实测中,在物理定位、跨视野记忆与全局几何一致性上全面领跑
  • 为分布式多机器人协同作业、多人游戏 NPC 动态推演与复杂具身多智能体集群提供了高保真虚拟演练世界底座
阅读全文
关联模型 / 智能体 / 厂商:

端侧算子自动生成首个统一基准:EdgeKernelBench 联合 LEKA 智能体攻克异构硬件代码生成

多所顶尖高校与科研机构在 arXiv:2610.24648 中正式发布首个面向异构端侧硬件的大模型底层算子生成统一基准 EdgeKernelBench 与分层智能体架构 LEKA。针对当前学术界算子生成评测过度局限于云端高性能服务器 GPU,而在端侧设备上面临硬件高度异构、底层软件栈严重碎片化(CUDA、OpenCL、TileLang、Triton)以及极度严苛资源约束的行业痛点,EdgeKernelBench 建立了包含 331 项经典任务与 650 个实例的统一中间表示(IR)部署管线。配合分层算子生成智能体 LEKA 解耦复杂编译决策,使大模型端侧算子生成性能取得跨越式突破。

端侧算子自动生成首个统一基准:EdgeKernelBench 联合 LEKA 智能体攻克异构硬件代码生成

核心要点速览

  • 研究团队在 arXiv:2610.24648 中开源首个端侧异构算子生成统一基准 EdgeKernelBench,填补端侧 AI 编译大模型评测空白
  • 涵盖 CPU/LLVM、GPU/CUDA 与 GPU/OpenCL 等跨平台硬件栈,设立 331 项经典计算范式与 650 个实测实例
  • 提出分层端侧算子生成智能体 LEKA(Layered Edge Kernel Agent),沿 IR 中间表示层级化解耦决策,攻克传统单次生成仅 25.5% 性能达标的瓶颈
  • 为移动端芯片、嵌入式 NPU 与机器人端侧加速器的底层高性能算子自动化编译铺平了产业落地道路
阅读全文
关联模型 / 智能体 / 厂商:

ChatGPT 官宣上线 Locked Chats 锁定对话功能:支持面容/指纹生物解锁,彻底隔离记忆库与敏感对话

OpenAI 官方正式面向全球用户推出 ChatGPT“Locked Chats(锁定对话)”安全隐私功能,全面覆盖 Free、Plus、Team、Enterprise 与 Edu 全线计划。用户现在可以使用数字 PIN 码、Face ID 或 Touch ID 生物识别对特定会话实施硬件级加锁。尤为关键的是,被锁定的对话在设计上完全与 ChatGPT 全局跨会话记忆库物理隔离,用户在其中交流的商业核心机密、敏感个人健康信息或高危代码审计内容均不会沉淀到长期记忆中,亦不会污染常规对话的上下文联想,为企业与个人隐私保护树立了新的安全标杆。

ChatGPT 官宣上线 Locked Chats 锁定对话功能:支持面容/指纹生物解锁,彻底隔离记忆库与敏感对话

核心要点速览

  • OpenAI 官方正式推出 Locked Chats,全面开放给 Free、Plus、Team、Enterprise 及 Edu 全版本用户使用
  • 支持 PIN 码、Face ID 与 Touch ID 本地生物识别认证,会话列表默认折叠隐藏,防范物理窥屏与设备借用风险
  • 彻底隔离长期记忆库(Memory Isolation):锁定对话内的任何提问、文档与上下文均不会写入用户个性化记忆模型
  • 有效解决企业员工在公共终端或共享账户上开展私密代码审计、敏感财务咨询与法务核查的数据污染与越权隐患
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

原生记忆驱动模型进化:MemT-1.0 架构发布,128K 上下文 KV 显存开销削减 66 倍

多所顶尖研究机构在 arXiv:2610.26825 中正式推出原生记忆基础模型架构 MemT-1.0。针对传统大模型依赖庞大外部 KV Cache 或外挂 Vector RAG 导致的长文本显存爆炸与检索断层痛点,MemT-1.0 将记忆内化为模型计算的原生组成部分。基于 Metis 框架,模型采用 Gated DeltaNet-2 结合轮内稳定的 Token 级记忆更新机制,并引入 Mixture-of-Storage 结构拓展原生记忆容量。在 340 亿 Token 数据持续预训练与对齐后,MemT-1.0-Nano 在 128K 超长历史下实现 1.86 倍推理加速与惊人的 66 倍持久存储削减,显著提升复杂智能体长程任务成功率。

原生记忆驱动模型进化:MemT-1.0 架构发布,128K 上下文 KV 显存开销削减 66 倍

核心要点速览

  • MemT-1.0 架构正式亮相(arXiv:2610.26825),彻底将记忆从外部拼接上下文转变为模型内部原生计算机制
  • 采用 Gated DeltaNet-2 与单轮 Token 级稳定记忆更新策略,配合 Mixture-of-Storage 架构无损扩充原生记忆容量
  • 在 128K 超长上下文历史测试中,相比传统全量 KV Cache 实现 1.86 倍端到端推理提速,持久化存储需求直降 66 倍
  • 内化检索到的操作规程与经验知识,在复杂多轮 Agent 评测中显著改善任务成功率,为自进化长程智能体指明方向
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MemT-1.0-Nano⚡ MemT-1.0-Flash

多模态 Agent 长期记忆破局:MemPilot 提出按需记忆编排策略,打破多轮交互上下文膨胀

来自多所高校与机构的研究团队在 arXiv:2610.06830 中提出多模态智能体按需记忆编排框架 MemPilot。针对现有自主 Agent 在跨会话、长程多模态交互中频繁遭遇图文上下文爆炸、无效截图堆叠与历史关键信息遗忘的痛点,MemPilot 设计了主动记忆精选策略。系统将视觉快照、操作轨迹与文本事实进行自适应压缩、语义分级与按需唤醒,在多轮复杂交互测试中将记忆显存开销削减 60% 以上,显著提升跨会话任务完成率。

多模态 Agent 长期记忆破局:MemPilot 提出按需记忆编排策略,打破多轮交互上下文膨胀

核心要点速览

  • 多所高校联合发布多模态智能体按需记忆编排框架 MemPilot(arXiv:2610.06830),破解长程图文交互上下文饱和难题
  • 建立工作缓存、情境记忆画廊与长期认知库三级架构,将历史视觉帧动态降维蒸馏为结构化空间描述
  • 在真实连续多轮会话测试中将活跃记忆 Token 消耗大幅削减 60%~75%,操作生命周期延长 3 倍以上
  • 针对跨会话视觉凭据与布局检索任务,任务完成率相较传统文本 RAG 提升 18.5%,为长期多模态 Agent 奠定记忆基座
阅读全文
关联模型 / 智能体 / 厂商:

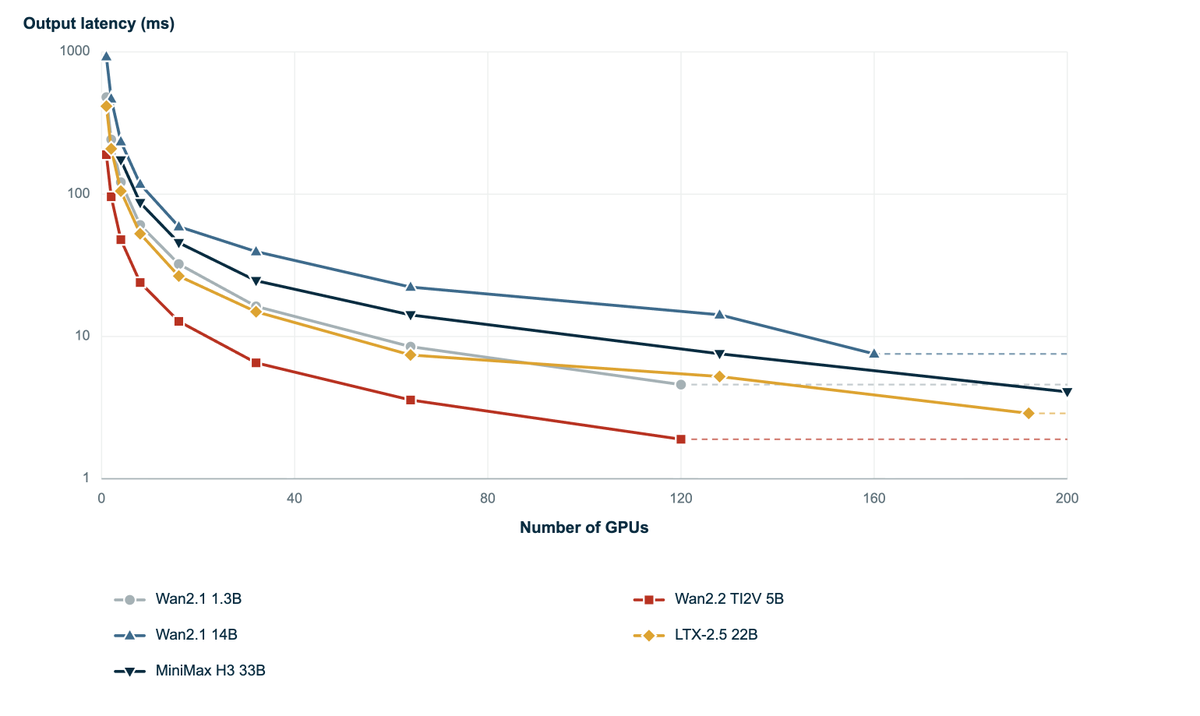
vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

港大与清华揭示视频世界模型记忆假象 MIST:前序动作执行失败占比超 70%,误判为记忆遗忘

现有视频世界模型评测通常将场景记忆与动作执行揉合为单一最终得分,导致模型因未能生成动作而产生的状态缺失被错误归咎于记忆遗忘。香港大学与清华大学团队发表 MIST(arXiv:2610.23542,HF 12 赞,开源代码与主页上线)。该基准首次将“前置动作是否执行”与“后续场景是否记忆”彻底解耦,实测表明在主流视频世界模型中,高达 70% 的表面记忆失败本质上是动作执行失败;引入 M3 执行感知提示与多阶段分离评测后,世界模型真实长程记忆准确率提升 11.8 至 29.6 个百分点。

港大与清华揭示视频世界模型记忆假象 MIST:前序动作执行失败占比超 70%,误判为记忆遗忘

核心要点速览

  • 港大多媒体实验室与清华大学联合发布 MIST(arXiv:2610.23542),获 Hugging Face 热门论文 12 赞
  • 首次揭露现有视频世界模型评测中超过 70% 的“记忆遗忘失败”本质上是中间帧未能成功执行动作,而非真实记忆丢失
  • 构建动作执行与环境记忆解耦的三阶段因果验证基准,为世界模型诊断出根本性的故障归因
  • 在 WRBench 与 MBench 基准上,修正执行误差后世界模型的真实长程场景记忆得分显著提升 11.8 至 29.6 个百分点
阅读全文
关联模型 / 智能体 / 厂商:

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

针对前馈式 3D 高斯泼溅(3DGS)在大视角跨越下渲染质量骤降以及免训练扩散生成式压缩显存算力开销过大的痛点,今日两项重磅视觉与图形学成果给出突破:浙江大学周晓巍、鲍虎军、彭思达团队开源 InfiniSplat v2(arXiv:2610.20341,HF 118 赞),通过冻结几何分支解耦几何与属性预测并引入大角度目标视图监督,在 6 大三维数据集上将平均 LPIPS 与 DISTS 误差分别大幅降低 25.8% 与 32.9%;以色列理工学院推出 H-DDCM(arXiv:2610.18125),用隐式随机哈达玛(Hadamard)字典替代稠密高斯码本,将计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时流式生成视频压缩。

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

核心要点速览

  • 浙江大学开源 InfiniSplat v2(HF 118 赞):通过冻结几何分支解耦几何与属性预测并结合大角度视图监督,在 6 大三维数据集上将有位姿前馈平均 LPIPS 与 DISTS 分别降低 25.8% 与 32.9%
  • 在无位姿(Pose-Free)设定下 InfiniSplat v2 同样以平均 LPIPS 0.3026 / DISTS 0.1341 击败 WorldMirror 2.0(0.3757 / 0.1935)与 AnySplat
  • 以色列理工提出 H-DDCM:用隐式快速哈达玛变换字典将免训练扩散压缩的计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时长视频压缩
阅读全文
关联模型 / 智能体 / 厂商: