AI 编程实时动态与要闻

NVIDIA 开源车端推理模型 Alpamayo 2 Edge:2B 参数 VLA 跑在 DRIVE AGX Thor 上,像素到轨迹延迟 160–190 毫秒,同步开源推理评分模型 AlpaJudge

NVIDIA 11 月 10 日发布开源自动驾驶模型 Alpamayo 2 Edge。这是一个 2B 参数的视觉-语言-动作(VLA)推理模型,专为在车上实时运行设计,部署目标是 NVIDIA DRIVE AGX Thor。它只在需要时才生成「因果链」推理,常规路况直接出轨迹,以节省算力;经 TensorRT 和 DFlash2 优化后,像素到轨迹延迟为 160 到 190 毫秒。NVIDIA 同时在 Hugging Face 开源推理评分模型 AlpaJudge。

NVIDIA 开源车端推理模型 Alpamayo 2 Edge:2B 参数 VLA 跑在 DRIVE AGX Thor 上,像素到轨迹延迟 160–190 毫秒,同步开源推理评分模型 AlpaJudge

核心要点速览

  • 模型:2B 参数推理 VLA,基于 Cosmos 3 Edge 的 Nemotron 推理骨干加扩散动作专家,用 Alpamayo 2 Super 的推理标注做离线蒸馏(NVIDIA 技术博客)
  • 闭环强化学习:在 AlpaGym 中做闭环 RL 后训练,闭环驾驶表现比未经闭环 RL 的最佳检查点提升 48.9%(官方口径)
  • 对比:官方称在 AlpaSim 闭环评测中,两次「本车责任事故」之间的行驶距离约为 4B 参数 Qwen-Drive-1.0 的 40 倍,参数只有对方一半
  • 延迟:按开发者中心部署方案做 FP8 校准和 TensorRT 加速后,在 DRIVE AGX Thor 上像素到轨迹延迟 160–190 毫秒;合作方 Embedl 称 48 小时内跑到 10Hz
  • 开源:权重在 Hugging Face(OpenMDW-1.1 许可),推理评分模型 AlpaJudge 提供有参考和无参考两个版本,加载约需 5GB 显存
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Alpamayo 2 Edge⚡ Alpamayo 2 Super⚡ Cosmos 3 Edge⚡ alpajudge🌐 Nvidia (NIM)

Anthropic 启动 IPO 路演:定价区间每股 70–78 美元,发行 8.25 亿股,英伟达、谷歌等 7 家公司同步认购 260 亿美元私募

Anthropic 于 11 月 10 日(新加坡时间 19:33)宣布启动 IPO 路演,拟发行 8.25 亿股 A 类普通股,其中公司发行约 8.01 亿股,老股东出售约 2365 万股,每股定价区间 70–78 美元,拟以代码 ANT 登陆纳斯达克全球精选市场。同日提交的 S-1 第二号修订稿显示,AMD、博通、谷歌、美光、微软、英伟达和台积电将以 IPO 价格合计认购 260 亿美元 N 类股。按 74 美元中值计算,公司预计净募资约 846 亿美元。

Anthropic 启动 IPO 路演:定价区间每股 70–78 美元,发行 8.25 亿股,英伟达、谷歌等 7 家公司同步认购 260 亿美元私募

核心要点速览

  • 发行规模:8.25 亿股 A 类普通股,公司发行 801,351,354 股,老股东出售 23,648,646 股;承销商另有 30 天内最多 1.2375 亿股超额配售权(官方公告)
  • 定价区间:每股 70–78 美元,代码 ANT,纳斯达克全球精选市场;Goldman Sachs 与 Morgan Stanley 牵头,承销团共 23 家
  • 同步私募 260 亿美元(按 74 美元中值):谷歌、英伟达各约 100 亿,AMD 约 25 亿,博通、美光、微软各约 10 亿,台积电约 5 亿美元,均按 IPO 价格认购 N 类股
  • 募资:按 74 美元中值,IPO 加私募净募资约 846 亿美元,若超额配售全部行使约 937 亿美元;用途包括算力与基础设施投入(S-1/A 口径)
  • 股本:发行及私募后各类股合计约 130.87 亿股;按此粗算,定价区间对应约 9160 亿至 1.02 万亿美元市值(本站推算,非官方估值)
阅读全文

Skild AI 联合 NVIDIA 开源机器人物理求解器 Steel:混合 20 类任务时吞吐达 PhysX 峰值的 13 倍,显存占用少约 62%,已并入 Newton 物理引擎

机器人基础模型公司 Skild AI 11 月 9 日宣布开源内部物理求解器 Steel(Apache 2.0),由其与 NVIDIA 合作开发,作为 GPU 刚体动力学求解器并入开源 Newton 物理引擎,服务 Isaac Lab 机器人训练。官方博客称:20 个单任务基准上几何平均吞吐为 PhysX 的 3.8 倍、MuJoCo Warp 的约 1.3 倍;把 20 类不同机器人任务混在一个批次时,峰值吞吐达 PhysX 的 13 倍,同批次规模下显存约 11 GiB 对 29 GiB。同时开源 WebGPU 版本,可在浏览器里直接体验。

Skild AI 联合 NVIDIA 开源机器人物理求解器 Steel:混合 20 类任务时吞吐达 PhysX 峰值的 13 倍,显存占用少约 62%,已并入 Newton 物理引擎

核心要点速览

  • 官方口径:20 类任务混合批次下 Steel 达 390 万环境步/秒(245,760 个环境),PhysX 峰值为 30 万,约 13 倍
  • 同为 61,440 个环境时 Steel 为 361 万步/秒,是 PhysX 的 12 倍,显存约 11 GiB 对 29 GiB(少约 62%)
  • 20 个单任务基准中 19 个快于 PhysX,几何平均 3.8 倍;约为 MuJoCo Warp 的 1.3 倍;23 关节 Kuka–Allegro 抓取任务达 PhysX 的 6.7 倍
  • Apache 2.0 开源,在 Newton 中以 newton.solvers.SolverSteel 调用;另开源 WebGPU 版本,浏览器内可交互 24 个场景
  • 注意:所有数字仅为物理仿真吞吐,不是端到端策略训练速度,均在单张 RTX PRO 6000 Blackwell 上测得
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

NVIDIA Robotics 官方账号在 CoRL 2026 宣布 GR00T 2,NVIDIA GEAR 实验室负责人 Yuke Zhu 同步发布技术细节。GR00T 2 是基于 Cosmos 的新一代世界动作模型(WAM):一个扩散 Transformer 同时去噪未来视频和动作块,一套模型可驱动平行夹爪、灵巧手和人形机器人。预训练数据包括 40.27 万小时第一视角人类视频、1.02 万小时 UMI 手持夹爪示范和 2.35 万小时机器人遥操作。官方口径下,50 个目标机器人从未练过的任务零样本成功率 40%,每任务 5 条示范(不到 3 分钟机器人数据)在单张 RTX 5090 上 LoRA 微调 30 分钟后升至 95%。推理模型可通过 WAM API 把 GR00T 2 当工具调用。代码 12 月开放,已在 Hugging Face 放出 10 万小时人类视频数据集。

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

核心要点速览

  • 架构:一个扩散 Transformer 同时预测未来视频与动作块,各机器人只需一个小动作头,一套模型覆盖夹爪、灵巧手、人形机器人
  • 数据:40.27 万小时人类第一视角视频 + 1.02 万小时 UMI 示范(2897 个任务)+ 2.35 万小时遥操作;人类视频占比从 0 提到 100%,真机任务进度从 50% 升到 70%(官方口径)
  • 适配:50 个未见任务零样本 40%,1 条示范 71%,5 条示范 95%,单张 RTX 5090 LoRA 微调约 30 分钟
  • Agent 协作:推理模型经 WAM API 调用 GR00T 2,三种玩具连续 100 次组装各成功 97 次以上;在画面上标注抓取点后指令遵循率从 40% 升到 92%
  • GR00T 2 Turbo 为 2B 参数版本,在 Unitree G1 的 Jetson Thor 上单次预测 124 毫秒;代码 12 月开放,10 万小时人类视频已上 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GR00T 2⚡ GR00T 2 Turbo⚡ Cosmos🌐 NVIDIA
AD赞助内容

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

11 月 9 日 08:30 UTC,Omarchy 作者 DHH 发布本地模型引擎 omarchy-local-ai v0.5.0,把本地模型支持扩展到 64 GB 的 NVIDIA GB10 / N1x 级机器,并把 Nemotron 3.5 Bolt 设为这一档的默认推荐(项目方实测:262K 完整上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值内存不到 40 GiB)。约 20 分钟后他在 X 上说,Omarchy 4.6 会为每台机器推荐能跑的最佳模型,并晒出 AMD 送他的 Ryzen AI Max+ 495 机器在 Agents 面板里同时挂着 Claude Code 订阅和本地 Qwen3.8 Flash Next(占用 94 GiB)。这套能力来自 11 月 1 日合并的 PR #17267:一条 omarchy agent local use best 命令按显卡家族和内存档位挑模型,在断网的 rootless Podman 容器里运行,供 OpenCode、pi 等编码 Agent 调用。4.6 的发布日期尚未公布。

Omarchy 本地模型引擎 omarchy-local-ai 0.5.0 发布:64 GB 机器默认推荐 Nemotron 3.5 Bolt,DHH 称 Omarchy 4.6 将按硬件自动推荐最佳本地模型

核心要点速览

  • 发布:omarchy-local-ai v0.5.0 于 11 月 9 日 08:30 UTC 由 DHH 发布;64 GB GB10 / N1x 默认 Nemotron 3.5 Bolt,备选 Qwen3.8 27B(131K 窗口)
  • 实测(项目方口径):Bolt 在 64 GB 上跑满 262K 上下文,短提示 91 tok/s、32K 提示 82 tok/s,峰值 <40 GiB
  • 推荐表 best.toml 目前覆盖 3 档:Strix Halo 128 GB(Flash Next → 27B)、GB10/N1x 128 GB(Flash Next → Bolt → 27B)、GB10/N1x 64 GB(Bolt → 27B)
  • Ryzen AI Max+ 395 / 128 GB 上 Flash Next 在 v0.3.0 达 47.5 tok/s(32K)、代码编辑 105 tok/s;27B 改 4-bit 后 20.7 tok/s、40 GiB
  • 安全边界:模型跑在无外网的 rootless Podman 容器,只读根文件系统、去掉全部 capabilities,API key 用 Podman secret;DHH 原帖约 20 分钟 163 赞、21 条回复
阅读全文

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

11 月 9 日,LG AI Research 在首尔 NVIDIA AI Day 上宣布,通过 EXAONE API 平台(docs.exaone.ai)免费开放 K-EXAONE 2.5 API,开发者、初创公司、企业和研究机构领取 API Key 即可用于服务开发与研究。K-EXAONE 2.5 是在 8 月发布的 K-EXAONE 2.0 基础上加训的技术验证模型:750B 总参数、31B 激活,纯文本,支持韩语和英语,上下文 512K,接口兼容 OpenAI。LG 自测四项 Agent 基准:SWE-Bench Pro 59.2、BrowseComp 78.0、AutomationBench 74.6、Claw-Eval 77.3,整体与 DeepSeek-V4.1-Flash、GLM-5.3 相当,但没有一项全面领先。NVIDIA 表示该模型训练用到了 Nemotron 数据集。官方未公布免费期限和额度,也未开放 2.5 权重。

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

核心要点速览

  • 免费开放:EXAONE API 平台 11 月 9 日上线,目前免费,领 API Key 即可调用;同批上线的还有 21M 参数的表格预测模型 EXAONE Tabular
  • 规格:750B 总参数 / 31B 激活,纯文本,韩语 + 英语,上下文与最大输出均为 512K,知识截止 2026 年 1 月;支持工具调用、结构化输出、代码生成和流式输出
  • 接口:OpenAI 兼容的 POST /v1/chat/completions,模型名 k-exaone_v2.5;推理无法关闭,reasoning_effort 可选 low / high / max,默认 max,推理 token 也计入 max_tokens
  • LG 自测(vs DeepSeek-V4.1-Flash / GLM-5.3):SWE-Bench Pro 59.21 vs 58.41 / 64.03;BrowseComp 78 vs 75.8 / 79;AutomationBench 74.6 vs 74.9 / 71.6;Claw-Eval 77.29 vs 75.78 / 77.64
  • 相比 K-EXAONE 2.0:AutomationBench 从 16.9 升到 74.6,SWE-Bench Pro 从 47.1 升到 59.21;以上均为厂商内部评测,未经独立复现,免费期限、额度和权重开放情况官方均未说明
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 为韩国四大开源模型发布 Dynamo 部署配方:A.X K2、K-EXAONE 2.0、Solar Open 2、Motif-3 一键上 B200,官方称推理性能最高 2 倍

NVIDIA 在首尔 AI Day 上为韩国四个主力开源大模型发布 Dynamo 优化部署配方:SK Telecom 的 A.X K2、LG AI Research 的 K-EXAONE 2.0(750B-A37B)、Upstage 的 Solar Open 2(250B)和 Motif Technologies 的 Motif-3。配方针对 B200,统一使用 NVFP4 权重 + FP8 KV 缓存与 vLLM 后端,提供聚合与预填/解码分离(disaggregated)两套 Kubernetes 清单和基准脚本,官方称开箱最高 2 倍推理性能(未说明对比基线)。按 Dynamo 文档实测:Motif-3 两张 B200 单 GPU 输出约 294 tok/s,K-EXAONE 2.0 四卡首 token 仅 291 毫秒。这也是 NVIDIA 与韩国科技部「AI for All」合作的一部分。

NVIDIA 为韩国四大开源模型发布 Dynamo 部署配方:A.X K2、K-EXAONE 2.0、Solar Open 2、Motif-3 一键上 B200,官方称推理性能最高 2 倍

核心要点速览

  • 覆盖 4 个韩国开源模型:SK Telecom A.X K2、LG K-EXAONE 2.0(750B-A37B)、Upstage Solar Open 2(250B)、Motif-3;配方已在 GitHub ai-dynamo/dynamo 的 recipes/ 目录
  • 官方口径:B200 上开箱最高 2 倍推理性能,但 NVIDIA 未说明与哪种基线比较
  • Dynamo 文档实测(聊天 trace,SLA 为每用户 ≥50 tok/s 且 TTFT p50 <5 秒):Motif-3 2×B200 单 GPU 293.96 tok/s、TTFT 388 ms;Solar Open 2 两副本 216.88 tok/s/GPU、TTFT 308 ms
  • K-EXAONE 2.0 4×B200 聚合:87 tok/s/GPU、每用户 51.4 tok/s、TTFT 291 ms;A.X K2 8×B200 + EAGLE3:76.49 tok/s/GPU、TTFT 0.525 秒,另有 32×H200 方案
  • 注意:Motif-3、A.X K2 跑分用的是合成的投机解码接受长度(约 2.1),不代表真实接受率与输出质量;Solar Open 2 默认高推理强度,GPQA 中位输出约 6,400 tokens,max_tokens 要给足
阅读全文
关联模型 / 智能体 / 厂商:

微软 Foundry Local 接 GitHub Copilot:本地跑 Qwen3.8-27B 做编码 Agent,约 24GB 显存即可,厂商口径 Terminal-Bench 2.1 约 73.0

微软 Foundry 团队于 2026-11-05 发博:Foundry Local CLI ≥0.13.0 可用 ONNX Runtime 在本机跑 4bit Qwen3.8-27B(权重约 18GB),经 Bring Your Own Key 接到 GitHub Copilot。需 NVIDIA ≥24GB 显存(24GB 时上下文约 64K;≥32GB 可达模型上限 262K)。官方引用模型卡口径 Terminal-Bench 2.1 73.0、SWE-bench Pro 61.7;并称在 RTX 5090 / DGX Spark 上生成速度优于同量化的 llama.cpp。Mac/AMD 尚在路线图。

微软 Foundry Local 接 GitHub Copilot:本地跑 Qwen3.8-27B 做编码 Agent,约 24GB 显存即可,厂商口径 Terminal-Bench 2.1 约 73.0

核心要点速览

  • 形态:Foundry Local ≥0.13.0 + 4bit Qwen3.8-27B(约 18GB 权重),经 BYOK 接 GitHub Copilot App
  • 硬件:NVIDIA ≥24GB 显存;24GB→约 64K 上下文,≥32GB→可达 262K;需自装 CUDA/cuDNN
  • 官方引用跑分(模型卡口径,非 4bit 复测):Terminal-Bench 2.1 73.0、SWE-bench Pro 61.7、NL2Repo-Bench 42.3、DeepSWE 1.1 42.2
  • 推理栈:ONNX Runtime + DFlash2 推测解码 + INT4/KV 量化 + 前缀缓存;厂商称长上下文相对 llama.cpp 优势更大
  • 边界:微软承认复杂推理仍宜云端;Mac/AMD 未上线;Copilot CLI 本地模型≠自动离线,需另开 COPILOT_OFFLINE
阅读全文
D
David Abitbol / Revolutai.engineer·
👀22
🔥88

Revolut 演讲披露:约 2000 工程师默认自托管 GLM-5.3(约 56×B200),编码 AI 账单约降到 Anthropic/OpenAI 的 1/10

2026-10-13,Revolut AI 运营负责人 David Abitbol 在 AI Engineer NYC 演讲称:约 2000 名工程师默认使用自托管 GLM-5.3(约 56 张 NVIDIA B200),混合成本约 $0.30/百万 token,相对此前 Anthropic/OpenAI 账单约 1/10;演讲方口径编码时间约改善 60%、lead time 约 70%。Claude Code/Codex 仍作难题例外,视觉走路由。

核心要点速览

  • 来源:Revolut AI 运营负责人 David Abitbol,AI Engineer NYC 2026 演讲(2026-10-13)+ 官方讲稿;The Register 等自 11-03 报道(演讲方口径)
  • 规模:约 2000 名工程师默认走自托管 GLM-5.3,约 56 张 NVIDIA B200;混合成本约 $0.30/百万 token
  • 费用:相对此前 Anthropic/OpenAI 账单约降到 1/10;演讲称编码时间约改善 60%、lead time 约 70%(未单独剥离模型因素)
  • 路由:GLM 文本为主;视觉任务路由 Gemini / GPT 等;Claude Code / Codex 仍作难题例外
  • 运维:同卡数下调优使 TTFT 约 14.3s→1.7s、RPS 约升 76%;沙箱审批与遥测被强调为银行合规配套
阅读全文

Voyager 开源 vork:面向 Agent 的无界面 3D/VFX 引擎,核心 API 约 2500 tokens,研究预览可免费使用

2026-11-06,Voyager / vork 作者 Ravi Parikh(@ravisparikh,GitHub swag)在 X 发帖宣布 vork:面向 AI Agent 的无界面 3D/VFX 引擎(Rust + Slang,Vulkan/Metal)。官方称入门帮助约 2500 tokens;百万只独立轨迹鸟群在单卡 NVIDIA L4 上渲染约 97 秒。GitHub voyager-so/vork 研究预览源码可用,预览期免费。此为作者第一人称发布,非大厂官方产品线。

Voyager 开源 vork:面向 Agent 的无界面 3D/VFX 引擎,核心 API 约 2500 tokens,研究预览可免费使用

核心要点速览

  • 来源:Ravi Parikh(@ravisparikh)2026-11-06 X 原帖 + voyager.so/vork 与 GitHub voyager-so/vork(研究预览)
  • 定位:无 GUI,Agent 用代码写场景/着色器/相机/物理并渲染迭代;入门 help 约 2500 tokens(厂商口径)
  • 性能(官方站点口径):百万鸟群单卡 L4 约 97 秒;相对把成品 flock 交给 Blender EEVEE 的投影对比约 8–11×(不含约 3 分钟 warmup)
  • 作者 X 帖另称最高约 24×、EEVEE 约 31 分钟——以官网更谨慎对比为准,并标注为作者口径
  • 限制:雾/体积未上线;重室内 Mac 可能中止;路径追踪尚慢于 Cycles;预览期源码可用且免费
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Hyperstition 开源 Hyperkernel:递归 megakernel 生成器,厂商口径 DeepSeek v4.1 Flash 低延迟推理多项超 NVIDIA 公布 vLLM

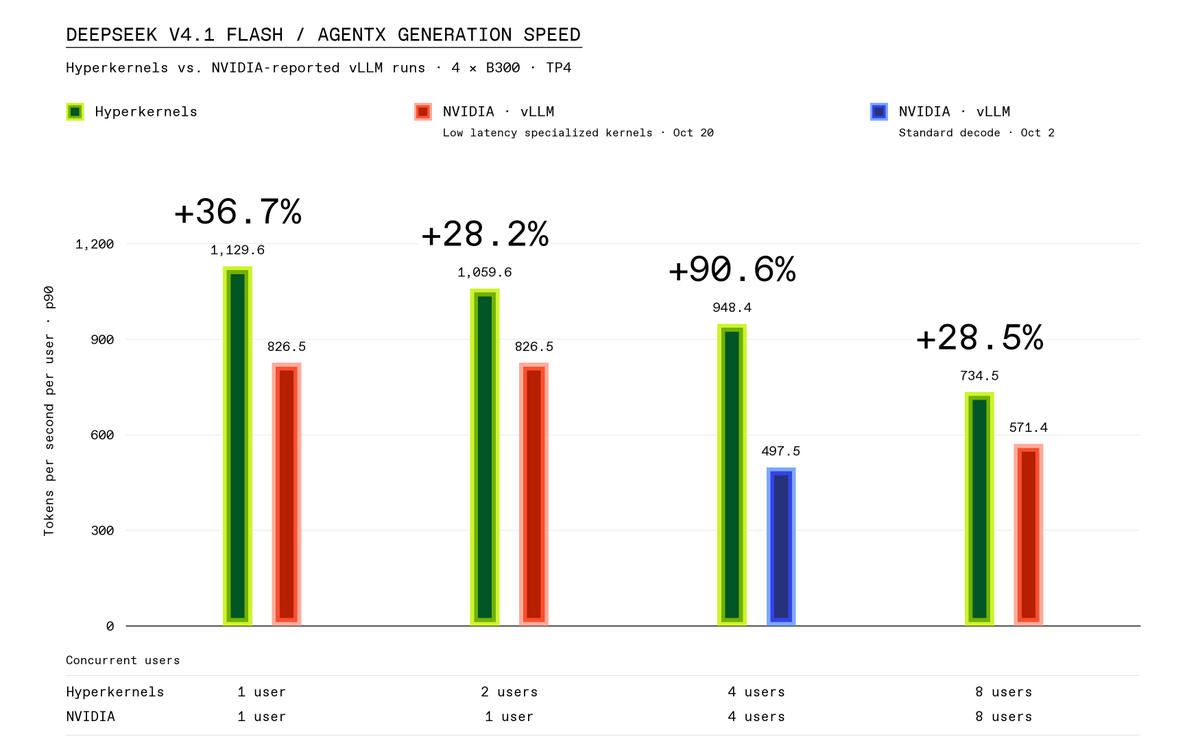
2026-11-05,Hyperstition 开源 Hyperkernel 首批生成 megakernel(Hyperserve):单次 launch 覆盖推理到机器人等场景;官方对照 NVIDIA 公布 vLLM 等给出多项加速,仓库 Alpha、面向 B300。

Hyperstition 开源 Hyperkernel:递归 megakernel 生成器,厂商口径 DeepSeek v4.1 Flash 低延迟推理多项超 NVIDIA 公布 vLLM

核心要点速览

  • 官方:@hyperstition_cc 2026-11-05;GitHub Hyperstitioncc/Hyperkernel(MIT,Alpha)
  • 厂商口径:DeepSeek v4.1 Flash C1 人均生成速度较 NVIDIA 公布 vLLM 高约 36.7%;C4 相对 AgentX 高约 90.6%
  • π₀-FAST 约 94 ms vs 约 243 ms;Matrix-Game 约 37.4 vs 11.6 FPS(约 3.2×)
  • CLI:hyperserve llm|drive|dna|world;需自备权重与 B300/R580+
  • 非独立第三方复测;完整栈与 Kimi/GLM serving 计划数周内开源
阅读全文
关联模型 / 智能体 / 厂商:

BoxWorks 2026:Box 联手 NVIDIA 推出 Box Context Retrieval,用 Nemotron Retriever 给企业智能体做权限感知检索,并发布 Box Architect 与 Box Mount

Box 在 11 月 5 日的 BoxWorks 2026 上宣布与 NVIDIA 扩大合作:新检索引擎 Box Context Retrieval 基于 Nemotron Retriever 嵌入模型,结合关键词与语义搜索,按现有文件权限为 AI 智能体返回最相关段落,预计明年初向 Enterprise Advanced 客户 GA。Box 新闻稿称检索准确率(Recall@5)可提升 20%、token 用量减少 90%、问答快 4 倍。Nemotron 3 Ultra 等开源权重模型即日起进入 Box AI;同时发布描述目标即可设计工作流的 Box Architect、可把 Box 文件夹挂进智能体沙箱并配合 NVIDIA OpenShell 的 Box Mount,以及含 MCP Guardrails 的智能体安全控制。

BoxWorks 2026:Box 联手 NVIDIA 推出 Box Context Retrieval,用 Nemotron Retriever 给企业智能体做权限感知检索,并发布 Box Architect 与 Box Mount

核心要点速览

  • Box Context Retrieval 基于 NVIDIA Nemotron Retriever,混合关键词与语义检索,遵守原有文件权限
  • 厂商口径:Recall@5 准确率 +20%、token 用量 -90%、问答速度 4 倍;明年初对 Enterprise Advanced GA
  • Nemotron 3 Ultra 等开源权重模型即日起可在 Box AI 中使用
  • Box Mount 把 Box 文件夹挂进智能体沙箱,可配合 NVIDIA OpenShell 安全运行时
  • 新增 MCP Guardrails、分级访问策略和审计等智能体安全控制
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3 Ultra⚡ Nemotron Retriever🌐 box🌐 Nvidia (NIM)

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

开源模型推理平台 Fireworks 11 月 3 日在首届 Forge 大会上发布一批新产品:基于 NVIDIA Blackwell 的 Ultra-fast 进入公测,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒,30 轮 Agent 任务从 1 分钟降到 8 秒;可等待任务的 Background Mode 半价;新增多日 Prompt 缓存和更高限流。Nexus Desktop 把开源模型路由带进 Codex app、Claude Desktop 和 OpenCode,Pro 每月 8 美元起;还有 No Eval、LoRA 无服务器推理、Fireworks Sovereign 私有部署等,并宣布 60+ 伙伴的 Frontier Ecosystem。

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

核心要点速览

  • Ultra-fast 公测:基于 NVIDIA Blackwell,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒;官方基准中 30 轮 Agent 任务耗时从 1 分钟降到 8 秒(Fireworks 官方博客)
  • 省钱选项:Background Mode 对可等待任务半价;多日 Prompt 缓存降低反复恢复上下文的成本;更高的 serverless 限流和 Elastic Burst 已正式可用
  • Nexus Desktop 上线:开源与闭源模型按个人路由,可在 Codex app、Claude Desktop、OpenCode 中使用;Pro 每月 8 美元起,Teams 每席每月 10 美元起
  • 训练侧:No Eval 私测,把生产 trace 转成任务评测;LoRA 无服务器推理公测,先支持 GLM 5.3 Flash,按 token 计费、空闲不收费;Muse Glimmer 30B 免费训练至 11 月 30 日
  • 企业侧:Fireworks Sovereign 私测,把推理引擎部署进客户自己的云或机房;官方称已在客户环境管理超过 2.5 万块 GPU;同时宣布 60+ 伙伴的 Frontier Ecosystem
阅读全文

生成式媒体推理平台 fal 宣布 Series E 和 F 合计融资 16.5 亿美元:Sequoia、Bessemer 领投,NVIDIA 继续跟投

托管图像、视频、音频模型推理的 fal 于 11 月 3 日在官方 X 账号和博客宣布,Series E 与 Series F 两轮合计融资 16.5 亿美元:Series E 由 Sequoia Capital 领投(今年早些时候完成),Series F 由 Bessemer Venture Partners 领投,NVIDIA 继续投资。fal 官方未公布估值和各轮金额;据 Bloomberg 报道,Series F 为 13 亿美元、估值 160 亿美元,较 4 月的 80 亿美元翻倍。官方称资金将用于扩充推理算力和团队,支持 2027 年的研究与平台建设。

生成式媒体推理平台 fal 宣布 Series E 和 F 合计融资 16.5 亿美元:Sequoia、Bessemer 领投,NVIDIA 继续跟投

核心要点速览

  • 官方确认:Series E + F 合计 16.5 亿美元,Sequoia 领投 E 轮,Bessemer 领投 F 轮,NVIDIA 继续投资(fal 博客)
  • 官方未公布估值;据 Bloomberg 报道 Series F 为 13 亿美元、估值 160 亿美元,Series E 为 3.5 亿美元、估值 80 亿美元
  • 据 Bloomberg,CEO Burkay Gur 称夏天需求暴涨到不得不对客户限流,这是大额融资的直接原因
  • 资金用于推理算力和团队扩张,以及 2027 年的新研究;fal 平台托管 Seedance、Kling、Veo、FLUX 等大量第三方媒体模型
阅读全文

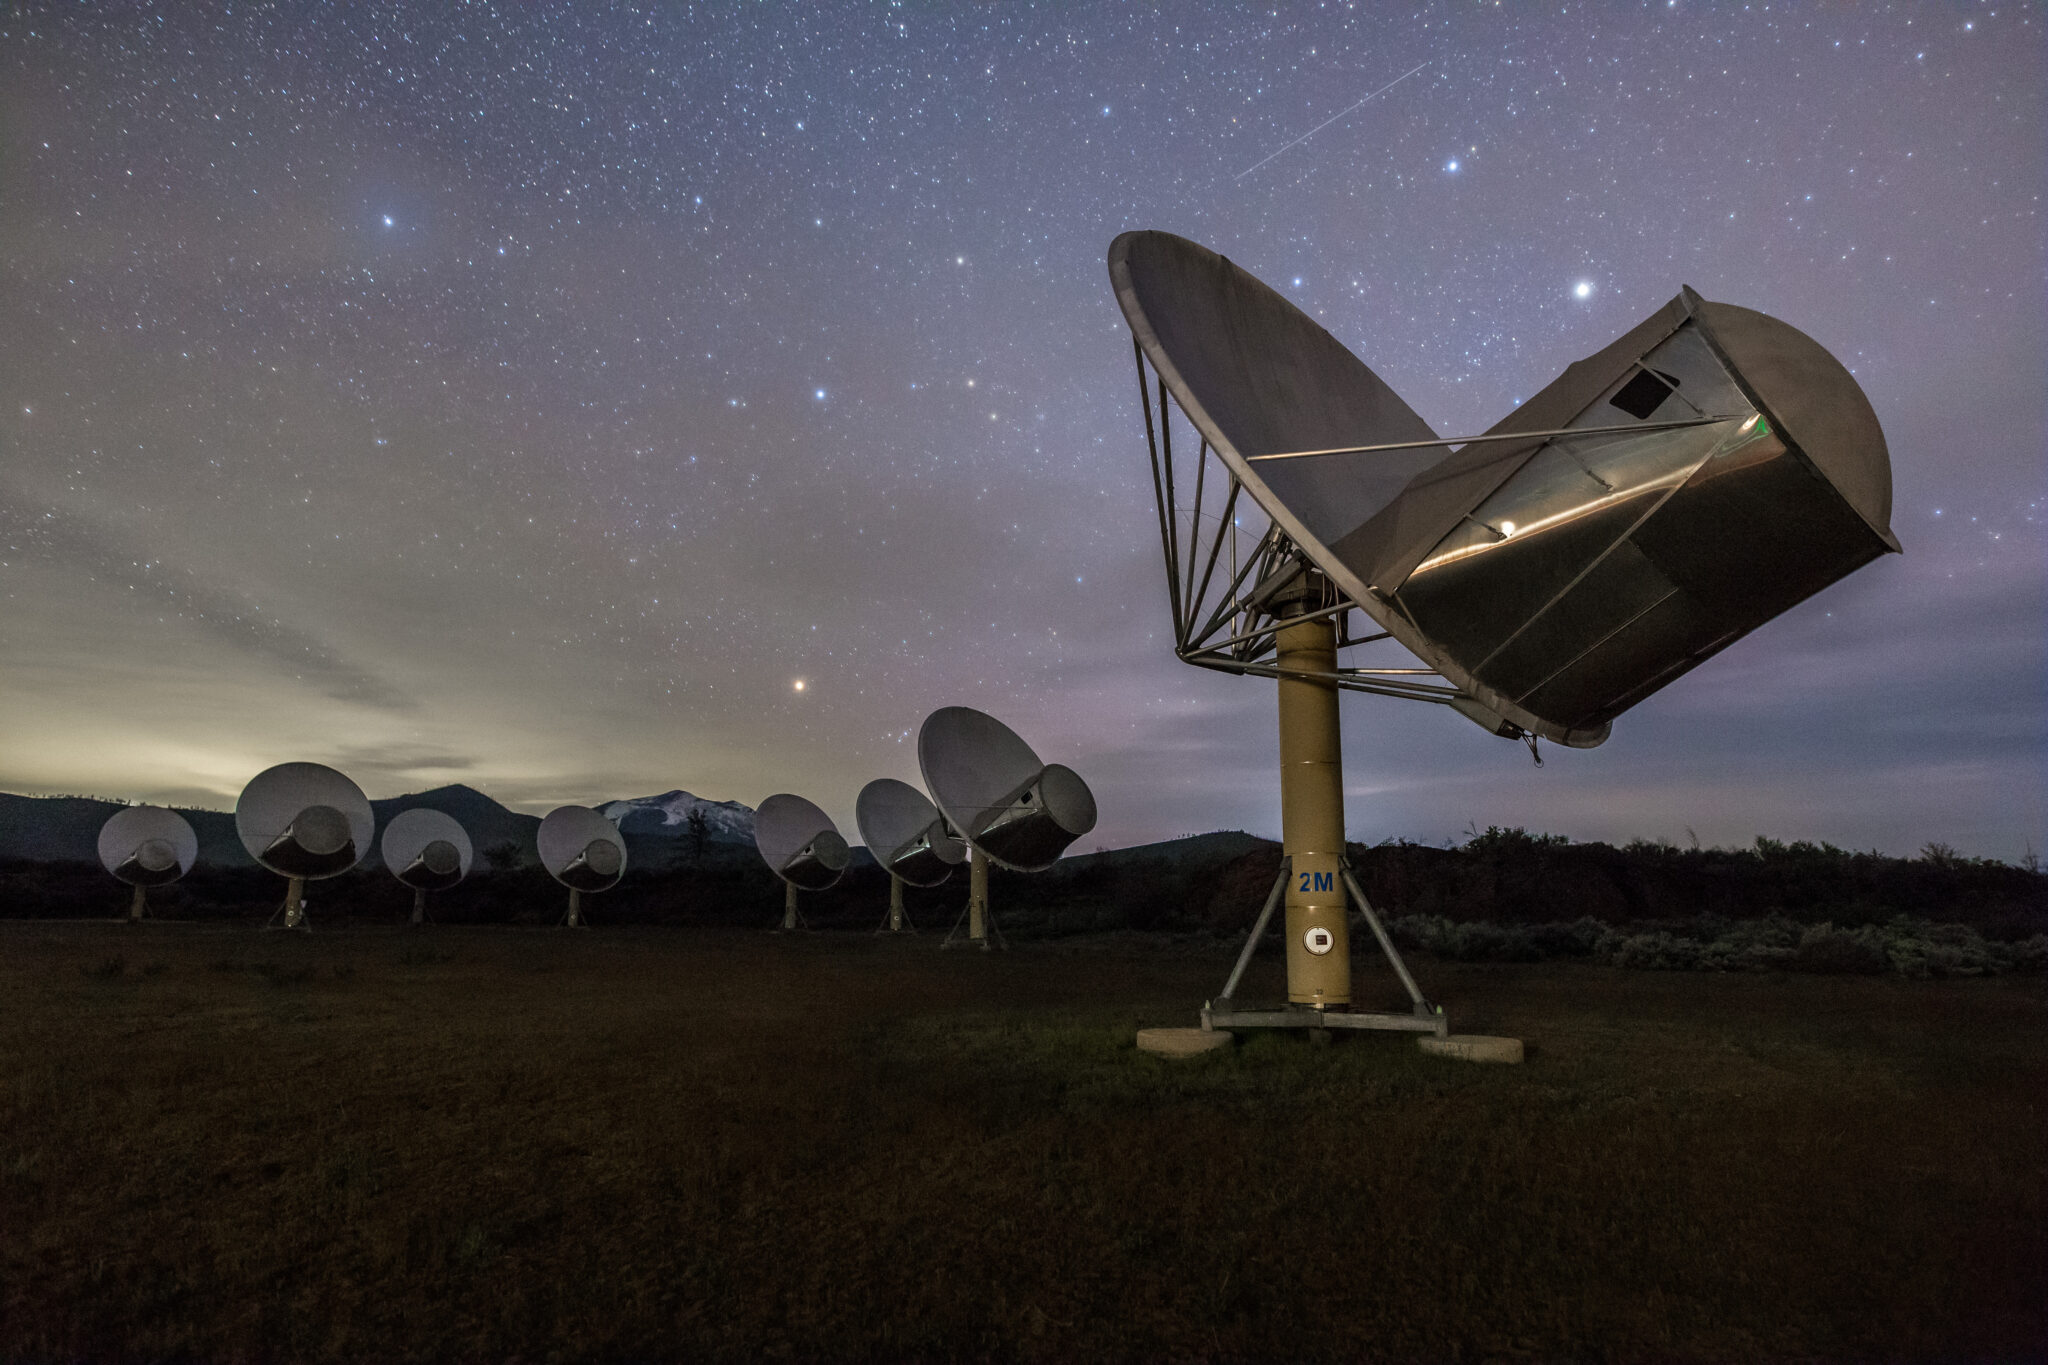
NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商: