百度开源 ERNIE-5.5-Flash-Base:280B 总参 / 14B 激活 MoE,预训练 33.5T,厂商口径 MMLU 93.3
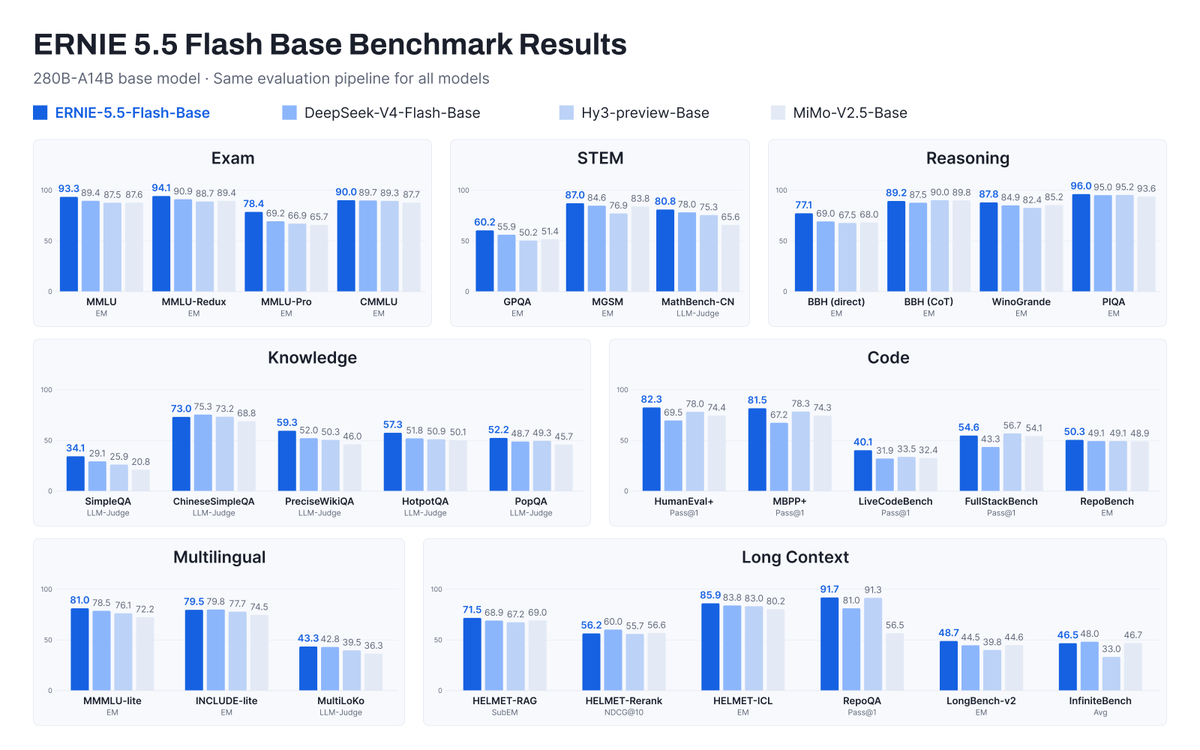
百度 11 月 5 日通过官网与 @BaiduResearch 宣布开源 ERNIE-5.5-Flash-Base:预训练结束点、未经中段/后训练的纯文本 MoE 基座,总参 280B、每 token 激活 14B,预训练 33.5T、训练上下文最长 128K,微调与推理支持 1M。Hugging Face / ModelScope 提供 FP8 与 BF16。官方统一评测口径下 MMLU 93.3、HumanEval+ 82.3、LiveCodeBench 40.1;后训练版 ERNIE 5.5 Flash「随后发布」。许可为自定义协议(排除欧盟/英国/韩国;相关营收超 5000 万美元需另行书面授权)。
核心要点速览
- 11 月 5 日开源预训练结束点基座:280B 总参 / 14B 激活,非对话成品模型
- 预训练 33.5T;训练上下文最长 128K,微调与推理支持 1M 上下文
- 厂商统一评测:MMLU 93.3、HumanEval+ 82.3、LiveCodeBench 40.1(对比 DeepSeek-V4-Flash-Base 等)
- 架构要点:37 层 HCA + 6 层 MLA-DSA、Multi-Router Latent MoE(512 专家 top-10 + 1 共享)
- 许可非 Apache:排除欧盟/英国/韩国;相关年营收超 5000 万美元需百度书面授权
关联模型 / 智能体 / 厂商:
⚡ Ernie 5.5 Flash Base🌐 Baidu (百度文心)