AI 编程实时动态与要闻

X 热议:马斯克称 Grok Bot 服务成本相对收入过高,Replit CEO Amjad Masad 警告「补贴型 AI 订阅要被收割了」

有用户在 X 上抱怨本周期 Grok Bot 额度提前用完,马斯克回复称「Grok Bot 的服务成本相对收入高得不可持续」,该回复获 1.3 万赞、550 万浏览。Replit CEO Amjad Masad 随后转引称「享受补贴型 AI 订阅的人准备好被收割」,引发关于 AI 包月订阅定价是否可持续的讨论。以下为 X 讨论与当事人观点,xAI 未发布正式的定价或额度调整公告。

核心要点速览

  • 起点:用户 @DogecoinNorway 称 Grok Bot 用量已到 100%,距重置还有 4 天,帖子约 124 万浏览。
  • 马斯克回复:Grok Bot 的服务成本相对收入高得不可持续,约 1.32 万赞、551 万浏览、1,900 余次引用。
  • Amjad Masad(Replit CEO)转引称补贴型 AI 订阅将被「rug pull」,约 2,347 赞、14.6 万浏览;他在回复中称 Replit「从未补贴」。
  • xAI 未发布正式的额度或定价调整公告,具体变化以官方说明为准。
阅读全文

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

腾讯混元(Tencent Hy)10 月 26 日开源实时同声传译模型 Hy-SimulMT,支持中英双向语音到语音翻译,边听边译,同时输出译文文本和语音,并可实时克隆说话人音色。Hugging Face 上一次放出 6 个权重(30B-A3B 的纯译文版与带原文的 Interleave 版,各含 BF16、FP8、GGUF),模型卡标注 Apache-2.0;GitHub 同步提供 SimulInfer 推理服务与 SimulTrain 训练工具。官方口径:RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统最低。

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

核心要点速览

  • 规模与形态:30B-A3B MoE(约 3B 激活),共 6 个权重:纯译文版与 Interleave(原文+译文)版,各有 BF16、FP8、GGUF(Hugging Face 合集)
  • 延迟(官方/厂商口径):RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 质量分超过对比的开源模型和 5 个商业 API 中的 4 个
  • 短音频(官方/厂商口径):FLEURS 90.3、CoVoST2 75.5、ACL6060 81.2、RealSI-Sentence 84.7,后者为表中所有系统最高;同表 Qwen3.8-LiveTranslate 为 88.4/82.1/80.5/84.4
  • 真人对比:18 段约 6 分钟的真实中英音频,对比 6 名 CATTI 一级/二级口译员,官方称质量相当、延迟常更低,并注明仅适用于该小规模测试
  • 部署:SimulInfer 一条 deploy.sh 命令拉起 vLLM(需 >=0.31)与 Web/WebSocket 服务,语音输出和音色克隆需另配 TTS;llama.cpp 支持尚未合入上游(SimulInfer 文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy-SimulMT-30B-A3B⚡ Hy-SimulMT-30B-A3B-Interleave⚡ Qwen3.8-LiveTranslate🌐 Tencent

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

来自清华大学和香港中文大学的研究团队在 arXiv:2610.28577 中正式发布划时代论文《Cache Engineering for Agents》,并开源专用服务引擎 AKV(thu-nics/AKV)。针对自主 Agent 在多轮长轨迹交互中,因传统“上下文工程(Context Engineering)”修剪文本导致前缀 KV 缓存彻底失效、引发高昂重预填(Re-prefilling)开销与关键记忆遗忘的痛点,论文提出“显存缓存工程(Cache Engineering)”。通过引入 drop(剔除显存中过期 Token)与 repos(位置编码重对齐)两大底层原语,配合 AKV 状态感知基数树引擎,在保持长程记忆的同时将 Agent 推理成本大幅削减 27.7%,P95 请求延迟提速 1.5 倍,基准测试准确率提升 1.7 分。

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

核心要点速览

  • 清华大学与港中文团队在 arXiv:2610.28577 提出智能体显存工程(Cache Engineering)全新理论体系
  • 指出传统上下文工程(Prompt 截断与摘要)会破坏前缀一致性,导致 KV 缓存失效并产生巨大二次重计算开销
  • 引入 drop(显存局部淘汰)与 repos(旋转位置编码动态平移)两大底层原语,实现显存级无感精准瘦身
  • 开源 AKV 状态感知推理引擎(thu-nics/AKV),实测将 Agent 推理成本降低 27.7%,P95 延迟提速 1.5 倍,基准得分提升 1.7 分
阅读全文

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

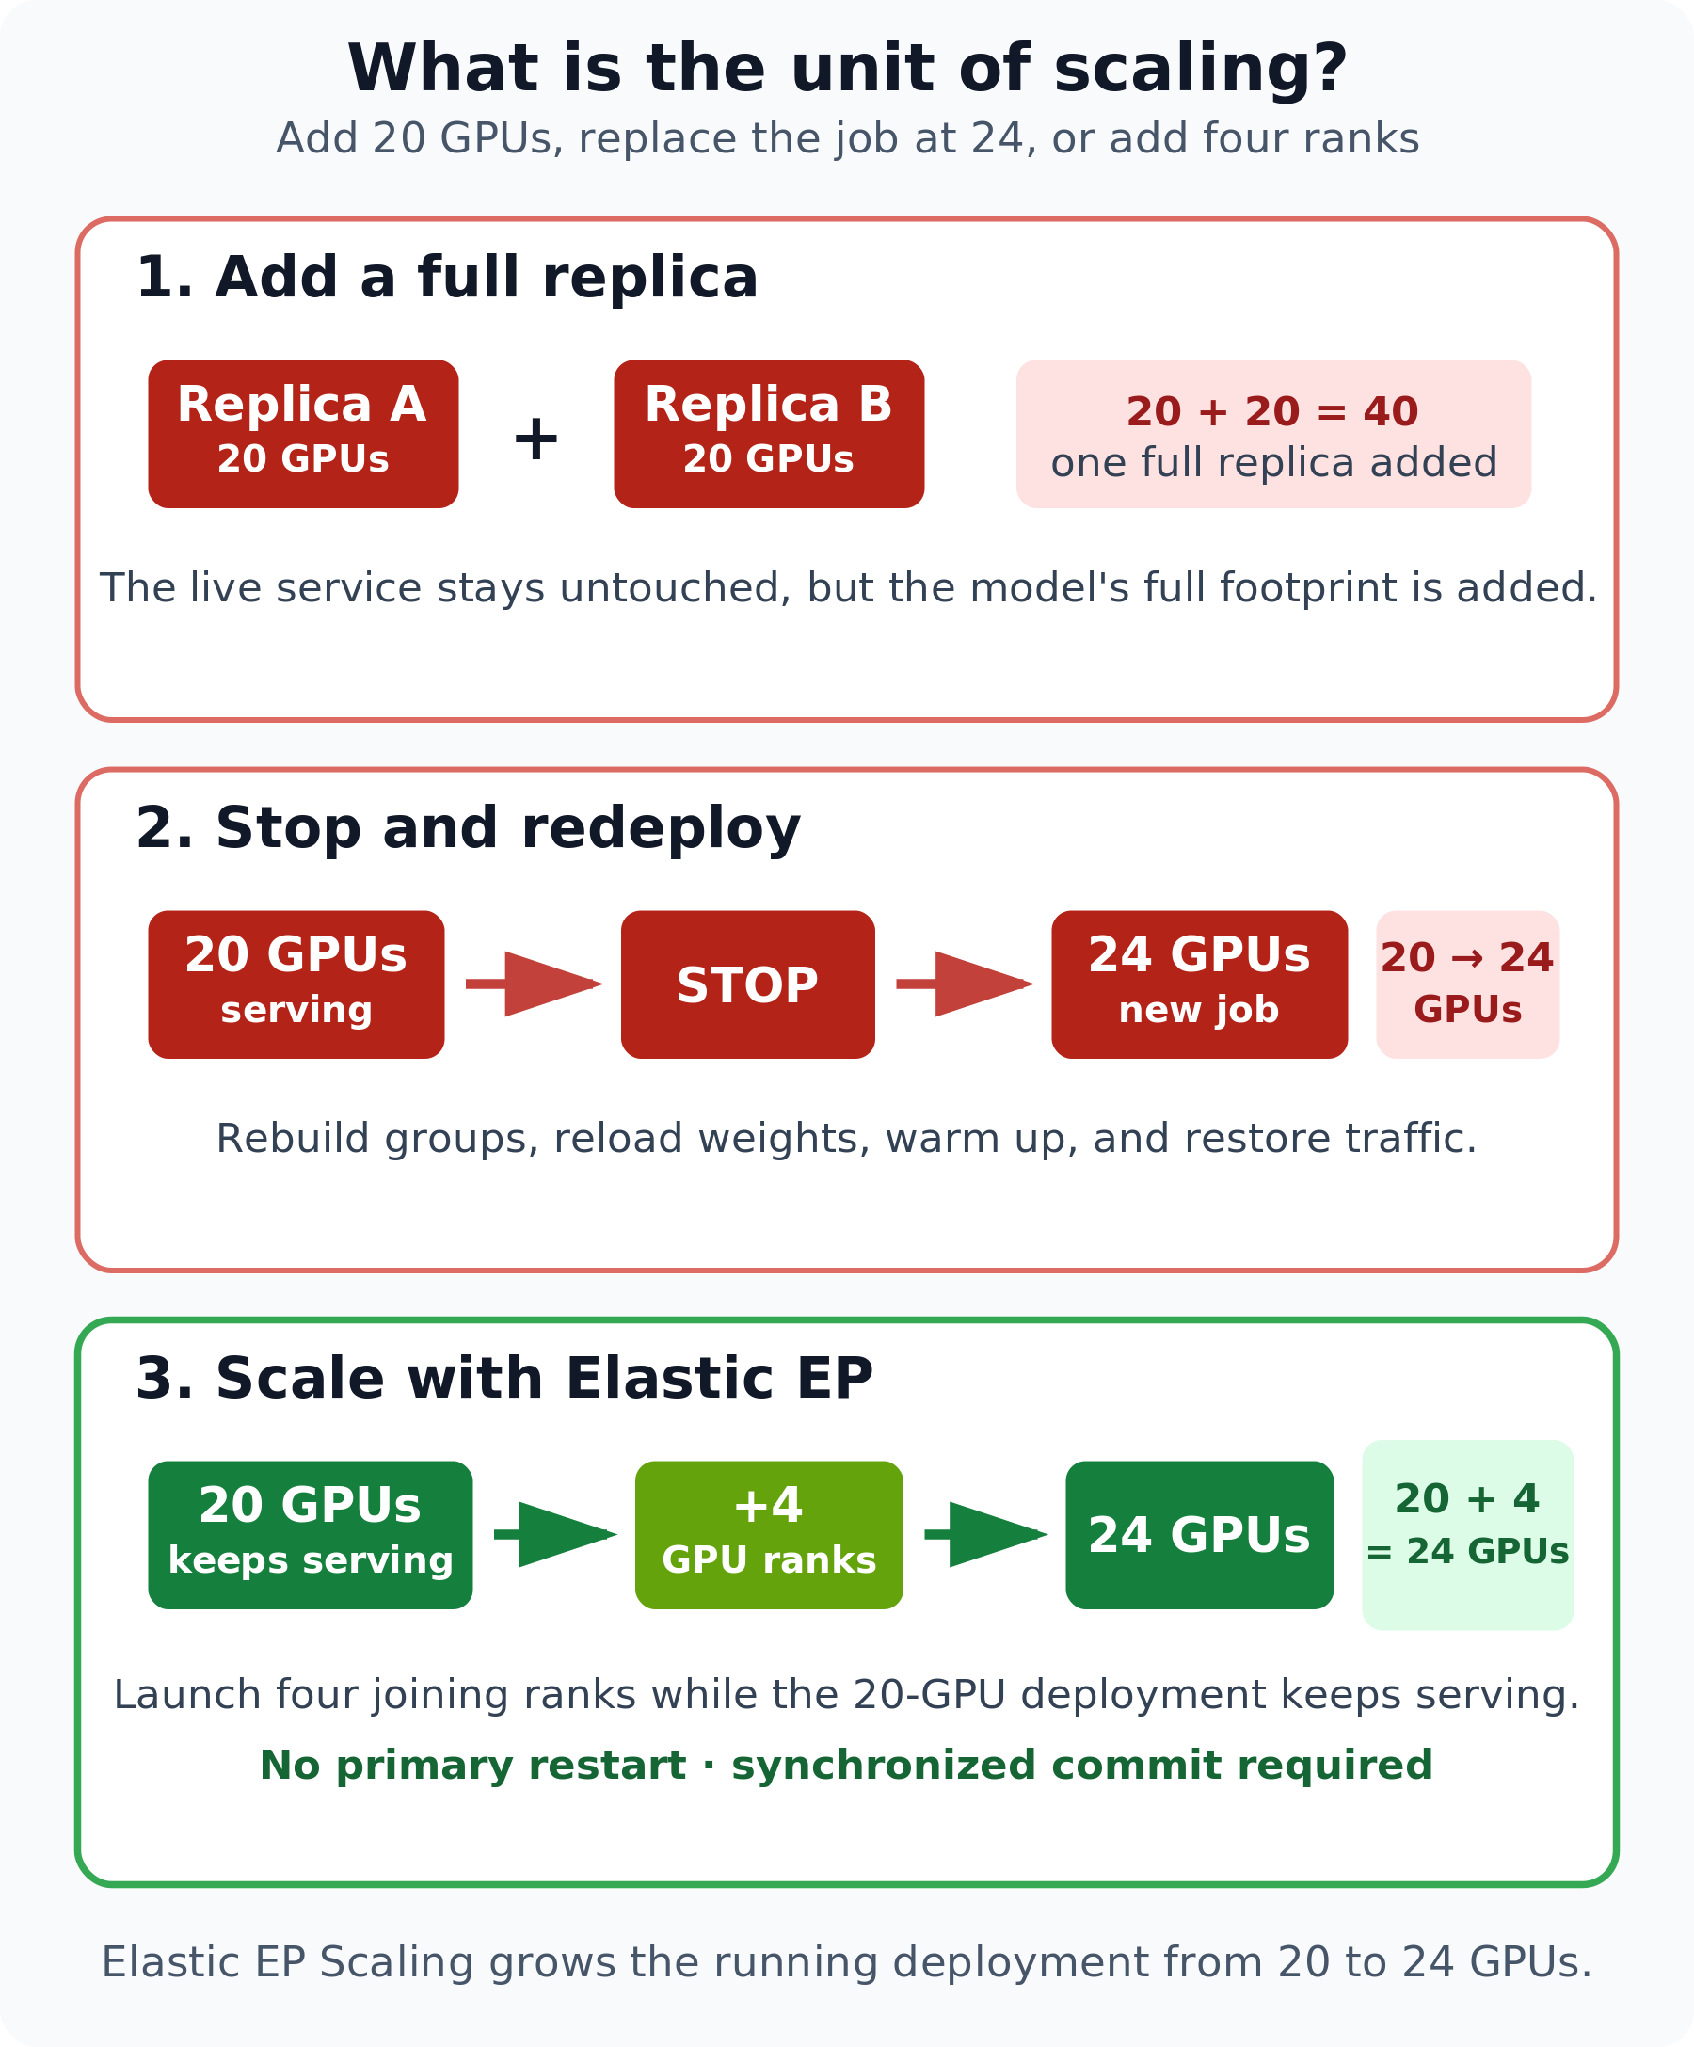
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文
AD赞助内容

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

Google Cloud 官方正式宣布开源 TorchTPU 核心加速框架,首次实现 PyTorch 框架原生、无编译壁垒地直接运行在 Google TPU(TPU v5p 与最新 TPU v6e)芯片之上。传统基于 PyTorch/XLA 的方案因复杂的计算图编译开销和动态形状限制,严重制约了 PyTorch 开发者在 TPU 上的创新步伐。TorchTPU 彻底打通了原生 PyTorch Eager 模式与自定义 Triton/C++ 硬件内核;主流高性能大模型推理引擎 vLLM 与 SGLang 同步官宣提供首发适配。同时,Google Cloud 宣布在其 Model Garden 引入 OpenAI 旗舰模型与 Codex,成为首个集齐全部三大顶级闭源模型的超算云平台。

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

核心要点速览

  • Google Cloud 官方开源 TorchTPU,支持 PyTorch 原生、免转译直接运行在 TPU v5p 与 TPU v6e 芯片
  • 彻底消除 PyTorch/XLA 传统图编译开销,原生支持 PyTorch Eager 动态模式与自定义 Triton/C++ 算子加速
  • vLLM 与 SGLang 同步发布专为 TorchTPU 深度优化的官方版本,实现高并发大模型推理吞吐量翻倍
  • OpenAI 旗舰模型与 Codex 正式登陆 Google Cloud Model Garden,打造最全面的跨厂商大模型生态
阅读全文

OpenAI「Patch the Planet」:GPT-5.6 Sol 协助发现 PHP 两个严重远程代码执行漏洞,PHP 8.5.12/8.4.27/8.3.36/8.2.35 紧急修复

10 月 21 日,PHP 官方发布安全公告,修复两个可被未认证远程代码执行的严重漏洞(CVE-2026-109618、CVE-2026-109619),所有提供 Web 请求的 PHP 部署都受影响,mod_php 风险最高。OpenAI 同日披露:安全公司 Calif 在其 Patch the Planet 计划中用 GPT-5.6 Sol 发现了漏洞,Wiz 也独立发现并报告;OpenAI 牵头约两个月的协同披露,并承诺投入 10 亿美元补贴 Daybreak 给资源有限的防御方。

OpenAI「Patch the Planet」:GPT-5.6 Sol 协助发现 PHP 两个严重远程代码执行漏洞,PHP 8.5.12/8.4.27/8.3.36/8.2.35 紧急修复

核心要点速览

  • 漏洞:CVE-2026-109618(OOM 处理导致内存破坏)与 CVE-2026-109619(请求间残留的全局状态),均可未认证 RCE(PHP 官方)
  • 修复:升级到 PHP 8.5.12、8.4.27、8.3.36 或 8.2.35;官方称没有完整缓解措施,升级是唯一安全选择
  • 范围:PHP-FPM、Apache mod_php、php-cgi、FrankenPHP、LiteSpeed 均受影响,mod_php 已有演示利用
  • AI 角色:Calif 用 GPT-5.6 Sol 发现漏洞,Wiz 独立报告;OpenAI 牵头约 2 个月协同披露(官方口径)
  • 投入:OpenAI 承诺 10 亿美元补贴 Daybreak 访问,并将推出检查 PHP 版本的 Codex skill
阅读全文

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

10 月 20 日 PyTorch Conference 北美站上,CNCF 沙箱项目 llm-d 发布 1.0。它把 vLLM、SGLang 等推理引擎组织成一个统一的服务池,1.0 新增多租户优先级与公平调度(flow control)、路由高可用与零停机滚动升级(DisaggregatedSet)、v1 配置 API,以及面向 Agent 的会话感知路由和 Responses API 状态支持。项目由 Red Hat、IBM、Google Cloud、CoreWeave、NVIDIA 于 2025 年创立,现有 500 多名贡献者;JetBrains、DigitalOcean、Mistral 等已在生产中使用。

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

核心要点速览

  • 规模(Red Hat 新闻稿,厂商口径):在 NVIDIA GPU 上部署约 7,530 亿参数的 GLM 5.2,峰值每分钟输出 660 万 token,同时服务最多 3,000 个编码 Agent 且零抢占,按云租用价算每 token 成本比同等商用 API 低 5–10 倍
  • 缓存复用:IBM 称在 Agent 编码负载中前缀感知路由拿到了 97% 的可复用缓存;IBM Research 量子纠错芯片项目前缀命中约 98%、综合成本约每百万 token 0.11 美元,比全闭源方案低 11.5 倍
  • Google Cloud 口径:Ironwood TPU 上的 Agent 编码负载,前缀感知路由加主机内存卸载让首 token 延迟中位数下降超 85%、吞吐提升 2.4 倍;Gemini 平台前缀缓存命中率从 35% 提到 70%
  • 1.0 新能力:flow control 多租户 QoS、路由热备高可用、DisaggregatedSet 统一管理 prefill/decode 滚动升级、v1 配置 API、Responses API 支持 previous_response_id
  • 生态:500+ 贡献者、25+ 家机构;JetBrains 的免费 Junie Lite、DigitalOcean Serverless Inference、Mistral 商用分级流量已在生产中使用;GitHub v1.0.0 发布说明坦言部分既定目标未完成
阅读全文
AD赞助内容

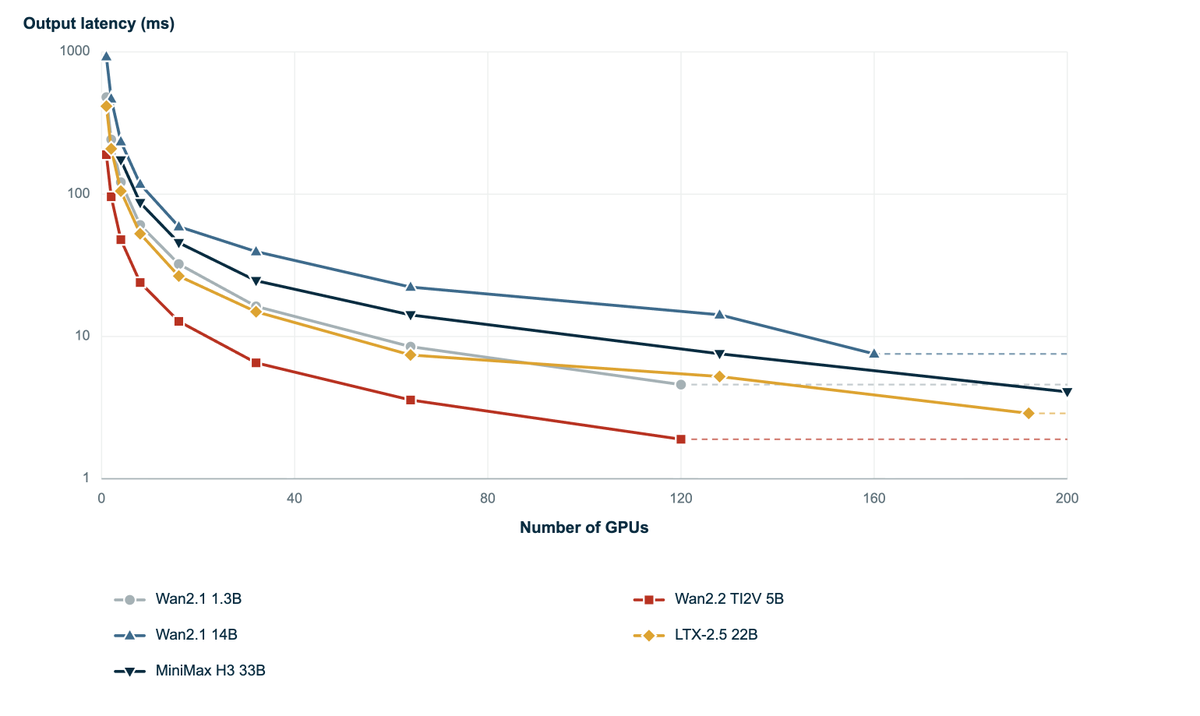
vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

小米 AI 实验室发布细粒度多模态模型 Xiaomi-Lens-0:4B 参数刷新 RefCOCO 语义分割纪录,掩码自监督打通像素级空间定位

针对多模态大模型普遍依赖纯文本监督而欠缺像素级细粒度空间定位能力的瓶颈,小米 AI 实验室(Xiaomi AI Lab)发表技术报告 Xiaomi-Lens-0(arXiv:2610.23279)。该模型基于 Qwen3.5 4B 打造,通过轻量级掩码解码器将视觉编码器 Patch 特征、隐层表征与掩码 Token 状态深度融合,在 RefCOCO/RefCOCO+/RefCOCOg 目标表达理解(REC 达 94.6%/92.1%/92.5%)与表达语义分割(RES cIoU 达 83.4%/79.9%/81.1%)上全面超越 Florence-2 与 LISA,同时保持 69.7% 的通用多模态感知高分。

小米 AI 实验室发布细粒度多模态模型 Xiaomi-Lens-0:4B 参数刷新 RefCOCO 语义分割纪录,掩码自监督打通像素级空间定位

核心要点速览

  • 小米 AI 实验室发布 4B 参数细粒度多模态大模型 Xiaomi-Lens-0(arXiv:2610.23279),以 Qwen3.5 4B 为基座原生输出像素掩码
  • 在 RefCOCO/RefCOCO+/RefCOCOg 目标表达理解(REC)测试中分别斩获 94.6%、92.1% 与 92.5%,全面超越 Florence-2 与 Grounding-DINO-L
  • 在表达语义分割(RES)任务上取得 83.4% / 79.9% / 81.1% 的 cIoU 高分,大幅碾压 7B 级的 LISA 与 GSVA
  • 在 MME-RW-en 真实世界通用评测中取得 69.7%,超越 Qwen2.5-VL 7B,证实细粒度空间监督能够反哺通用多模态理解
阅读全文
关联模型 / 智能体 / 厂商:

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

传统投机解码(Speculative Decoding)依赖目标模型的静态隐层特征,无法适应草稿模型随位置变化的动态上下文需求。香港大学团队发表 ReaDy(arXiv:2610.20503,HF 6 赞)。该框架首次为混合线性注意力模型(Hybrid Linear Attention,结合 Transformer 与 Mamba/RWKV 循环层)设计了以紧凑循环隐状态为动态上下文的投机草稿机制。在 NVIDIA B200 单卡上对 Qwen3.8-27B 展开评测,投机接受长度达 4.53,单卡解码吞吐飙升至 302.78 TPS,较标准自回归提速 2.4 倍。

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

核心要点速览

  • 香港大学提出首个专为混合线性注意力(HLA)架构打造的投机解码方法 ReaDy(arXiv:2610.20503)
  • 创新性地复用 HLA 骨干中的紧凑循环隐状态作为动态上下文,解决传统草稿模型特征静态僵化的问题
  • 在单张 NVIDIA B200 上对 Qwen3.8-27B 展开实测,解码吞吐达到 302.78 TPS,较标准自回归提速 2.4 倍,在 DSpark 基础上再提升 7.97%
  • 仅需 Rank 8 超轻量读取器即可达成最佳性能,投机接受长度达到 4.53 个 Token
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 官方推出预编译字节码镜像与 Decision 3.0 服务:容器冷启动提速 18%,AMD MI325X 决策吞吐达 1.8 倍

vLLM 官方推特宣布两项关键工程突破:在 v0.32.0 官方镜像中引入构建期 Python 字节码预编译(uv compile),使 H100 容器冷启动耗时缩短 14%~18%(省去约 18 秒且启动零重编译);同时正式合入 Decision 3.0(D3)全系列 6 款结构化决策模型(0.6B 至 27B),通过 /v1/systemone 提供极速多模态选择与评分,在 AMD MI325X 单卡上支撑 64 并发的吞吐达原始基准的 1.8 倍。

vLLM 官方推出预编译字节码镜像与 Decision 3.0 服务:容器冷启动提速 18%,AMD MI325X 决策吞吐达 1.8 倍

核心要点速览

  • vLLM 官方在发布镜像中引入构建期 Python 字节码预编译,使 H100 容器冷启动耗时缩短 14%~18%(省去约 18 秒)
  • 正式合入 Decision 3.0(D3)全系列 6 款决策模型(0.6B 至 27B),通过 /v1/systemone 专有接口提供毫秒级多模态结构化判定
  • D3 模型在 Jev Decision Index 0.3.2 榜单上拿下文本 66.3 分与视觉 71.3 分双料第一
  • 在单张 AMD Instinct MI325X 显卡上,面对 64 并发客户请求,D3 27B 的吞吐量达到原始服务的 1.8 倍
阅读全文
关联模型 / 智能体 / 厂商:

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

阿里巴巴淘天集团发表生产级多智能体商业视觉生成系统 CommerceGen-Studio(arXiv:2610.20603,HF 52 赞),通过 PERL-Agent 闭环自进化与 6B 参数 SKU-DiT(RDR 三阶段强化蒸馏),支撑日均数百万张秒级生成,并在真实流量基准 CommerceGen-Bench 上以 9.43/9.45 分击败 20B Qwen-Image-Edit 及闭源 Nano Banana Pro;同期微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),在测试时外置统计采样彻底解决大模型生成同质化(Mode Collapse)。

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

核心要点速览

  • 阿里淘天 CommerceGen-Studio(arXiv:2610.20603)在生产环境支撑日均数百万张商品视觉生成、单图延迟仅数秒
  • 通过 Reinforce-Distill-Reinforce(RDR)训练的 6B 参数 SKU-DiT 在 CommerceGen-Bench 单图/多图任务上斩获 9.43 / 9.45 分,越级击败 20B Qwen-Image-Edit(8.67 / 7.48)与闭源 Nano Banana Pro(9.39 / 9.33)
  • 配合 PERL-Agent(Prompt-Eval-Refine-Loop)自进化闭环与 Layout Thinker Optimization 后,综合得分进一步提升至 9.62 / 9.48
  • 微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),通过从真实语料挖掘分类属性并在测试时显式采样,无需训练即可消除网页 UI 设计、智能体 3D 资产合成等五大场景的模式坍塌
阅读全文
关联模型 / 智能体 / 厂商: